

Логистическая регрессия в машинном обучении с Python

Одна из лучших особенностей библиотеки scikit-learn в Python – это то, что она предоставляет четырехэтапные шаблоны моделирования, которые упрощают для программиста обучение классификатора машинного обучения. В этой статье я буду использовать логистическую регрессию с Python для классификации цифр, основанных на изображениях. После подготовки нашей модели машинного обучения с помощью этой логистической регрессии мы можем использовать ее для прогнозирования изображения, помеченного числами.
Логистическая регрессия цифр с Python
Это означает, что нам нужно загрузить набор данных цифр, и нам не требуется загружать какой-либо набор данных для этой классификации. Теперь загрузим наш набор данных.
from sklearn.datasets import load_digits
digits = load_digits()
Теперь давайте посмотрим на некоторые выводы из набора данных.
# Print to show there are 1797 images (8 by 8 images for a dimensionality of 64)
print("Image Data Shape" , digits.data.shape)
# Print to show there are 1797 labels (integers from 0–9)
print("Label Data Shape", digits.target.shape)
Результат:
Image Data Shape (1797, 64)
Label Data Shape (1797,)
Отображение изображений и меток в наборе данных Digits
А сейчас давайте посмотрим, какие сведения содержат наши данные. Я визуализирую изображения и метки, присутствующие в наборе данных, чтобы знать, с чем мне нужно работать.
import numpy as np
import matplotlib.pyplot as plt
plt.figure(figsize=(20,4))
for index, (image, label) in enumerate(zip(digits.data[0:5], digits.target[0:5])):
  plt.subplot(1, 5, index + 1)
  plt.imshow(np.reshape(image, (8,8)), cmap=plt.cm.gray)
  plt.title('Training: %in' % label, fontsize = 20)

Разделите данные на обучающий и тестовый набор
Теперь я разделю данные на 75 % набор для обучения и 25 % для тестирования. Необходимость разбить данные на наборы для обучения и тестирования заключается в том, чтобы убедиться, что наша модель классификации может правильно соответствовать новым данным.
Scikit-learn 4-шаговый шаблон моделирования (логистическая регрессия)
Шаг первый – импорт модели, которую мы хотим использовать. Поскольку эта статья основана на логистической регрессии, я импортирую модель логистической регрессии из библиотеки scikit-learn в Python.
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(digits.data,
                                                    digits.target, test_size=0.25,
                                                    random_state=0)

from sklearn.linear_model import LogisticRegression
Шаг второй – создать экземпляр модели, а это значит, что нам нужно сохранить модель логистической регрессии в переменной.
logisticRegr = LogisticRegression()
Третий шаг будет заключаться в обучении модели. Для этого нам нужно подобрать данные в нашу модель логистической регрессии.
logisticRegr.fit(x_train, y_train)
Code language: Python (python)
Шаг четвертый – предсказать метки для новых данных. На этом этапе нам нужно использовать информацию, которую мы узнали во время обучения модели.
# Returns a NumPy Array
# Predict for One Observation (image)
logisticRegr.predict(x_test[0].reshape(1,-1))
logisticRegr.predict(x_test[0:10])
predictions = logisticRegr.predict(x_test)
Измерить точность нашей модели логистической регрессии
Я буду измерять точность нашей обученной модели логистической регрессии, где точность определяется как доля правильных прогнозов, которая представляет собой правильные прогнозы/общее количество точек данных.
# Use score method to get accuracy of model
score = logisticRegr.score(x_test, y_test)
print(score)
Таким образом, наша точность дает результат 95,3 процента, что обычно очень хорошо.
Матрица неточностей
Матрица неточностей – это таблица, используемая для описания производительности классификатора, который мы обучили с помощью набора данных. Здесь я буду использовать Matplotlib и Seaborn в Python, чтобы описать производительность нашей обученной модели.
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import metrics
cm = metrics.confusion_matrix(y_test, predictions)
print(cm)
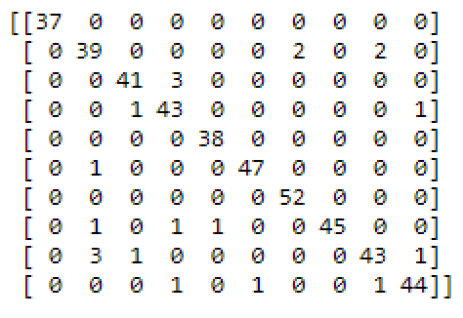
Теперь давайте визуализируем нашу работу с помощью матрицы неточностей. Сначала я визуализирую матрицу смещения, используя библиотеку Seaborn на Python.
plt.figure(figsize=(9,9))
sns.heatmap(cm, annot=True, fmt=".3f", linewidths=.5, square = True, cmap = 'Blues_r');
plt.ylabel('Actual label');
plt.xlabel('Predicted label');
all_sample_title = 'Accuracy Score: {0}'.format(score)
plt.title(all_sample_title, size = 15)
plt.show()

Теперь давайте визуализируем производительность нашей модели логистической регрессии с помощью матрицы смещения, используя библиотеку matplotlib в Python.
plt.figure(figsize=(9,9))
plt.imshow(cm, interpolation='nearest', cmap='Pastel1')
plt.title('Confusion matrix', size = 15)
plt.colorbar()
tick_marks = np.arange(10)
plt.xticks(tick_marks, ["0", "1", "2", "3", "4", "5", "6", "7", "8", "9"], rotation=45, size = 10)
plt.yticks(tick_marks, ["0", "1", "2", "3", "4", "5", "6", "7", "8", "9"], size = 10)
plt.tight_layout()
plt.ylabel('Actual label', size = 15)
plt.xlabel('Predicted label', size = 15)
width, height = cm.shape
for x in xrange(width):
  for y in xrange(height):
    plt.annotate(str(cm[x][y]), xy=(y, x),
    horizontalalignment='center',
    verticalalignment='center')

Логистическая регрессия (MNIST)
Модель логистической регрессии, которую вы видели выше, дала вам представление о том, как этот классификатор работает с Python для обучения модели машинного обучения. Теперь давайте подготовим модель логистической регрессии для реального примера, используя более важные данные для соответствия нашей модели.
Загрузите набор данных MNIST
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata('MNIST original')
Теперь, после загрузки набора данных MNIST, давайте взглянем на данные.
# These are the images
# There are 70,000 images (28 by 28 images for a dimensionality of 784)
print(mnist.data.shape)
# These are the labels
print(mnist.target.shape)
В результате вы увидите 70000 изображений и 70000 меток в этом наборе данных, что довольно сложно для реальной задачи.
Разделите данные на обучение и тестирование
Теперь давайте разделим данные на наборы для обучения и тестирования. Здесь я разделю набор данных на 60000 изображений в качестве обучающего набора и 10000 изображений в качестве тестового набора.
Визуализируйте данные
Как я уже говорил вам ранее, нам нужно будет просмотреть данные, прежде чем двигаться вперед, чтобы увидеть, с чем нам нужно будет работать. Здесь я визуализирую данные, используя библиотеку matplotlib в python.
from sklearn.model_selection import train_test_split
train_img, test_img, train_lbl, test_lbl = train_test_split(
 mnist.data, mnist.target, test_size=1/7.0, random_state=0)
Code language: Python (python)
import numpy as np
import matplotlib.pyplot as plt
plt.figure(figsize=(20,4))
for index, (image, label) in enumerate(zip(train_img[0:5], train_lbl[0:5])):
  plt.subplot(1, 5, index + 1)
  plt.imshow(np.reshape(image, (28,28)), cmap=plt.cm.gray)
  plt.title('Training: %in' % label, fontsize = 20)
  plt.show()

Шаблон моделирования Scikit-Learn
Теперь давайте проследим за шаблоном моделирования scikit-learn, как я делал ранее в приведенном выше примере.
from sklearn.linear_model import LogisticRegression

# all parameters not specified are set to their defaults
# default solver is incredibly slow thats why we change it
logisticRegr = LogisticRegression(solver = 'lbfgs')

logisticRegr.fit(train_img, train_lbl)
# Returns a NumPy Array
# Predict for One Observation (image)
logisticRegr.predict(test_img[0].reshape(1,-1))
logisticRegr.predict(test_img[0:10])
predictions = logisticRegr.predict(test_img)
Итак, вот как вы можете эффективно обучить модель машинного обучения. Если вы подготовите модель на Python с помощью Scikit-learn, вы никогда не столкнетесь с трудностями. Надеюсь, эта статья вам поможет.


