

Интеграция с BI и аналитическими пайплайнами
Стратегия производительной аналитики требует тесной связи между StarRocks, инструментами бизнес-аналитики и конвейерами данных. В этой главе рассмотрены архитектурные паттерны, форматы обмена, принципы моделирования данных и практики внедрения интеграций, обеспечивающих минимальные задержки, согласованность информации и управляемость на уровне организации. Особое внимание уделено выбору подходящих механизмов загрузки данных, оптимизации BI-запросов и поддержке устойчивых пайплайнов в условиях роста объема данных и требований к соответствию регламентам.
BI-инструменты и аналитические пайплайны выступают точкой входа для пользователей и систем мониторинга, поэтому архитектура интеграции должна быть понятной, воспроизводимой и адаптивной к изменениям источников данных, режимам обновления и требованиям безопасности. В рамках подходов hybrid мы сочетали архитектурные решения, методологии интеграции и практики организационного управления данными, чтобы читатель получил целостную картину возможностей StarRocks в контексте реального производственного окружения.
- Архитектура интеграции и паттерны взаимодействия BI и StarRocks
- Форматы данных, схемы хранения и согласованность данных для аналитики
- Пайплайны данных: ETL/ELT, оркестрация и качество данных
- Производительность BI-запросов и лучший стиль разработки
- Безопасность, мониторинг и управление качеством данных
Архитектура интеграции с BI и аналитическими пайплайнами
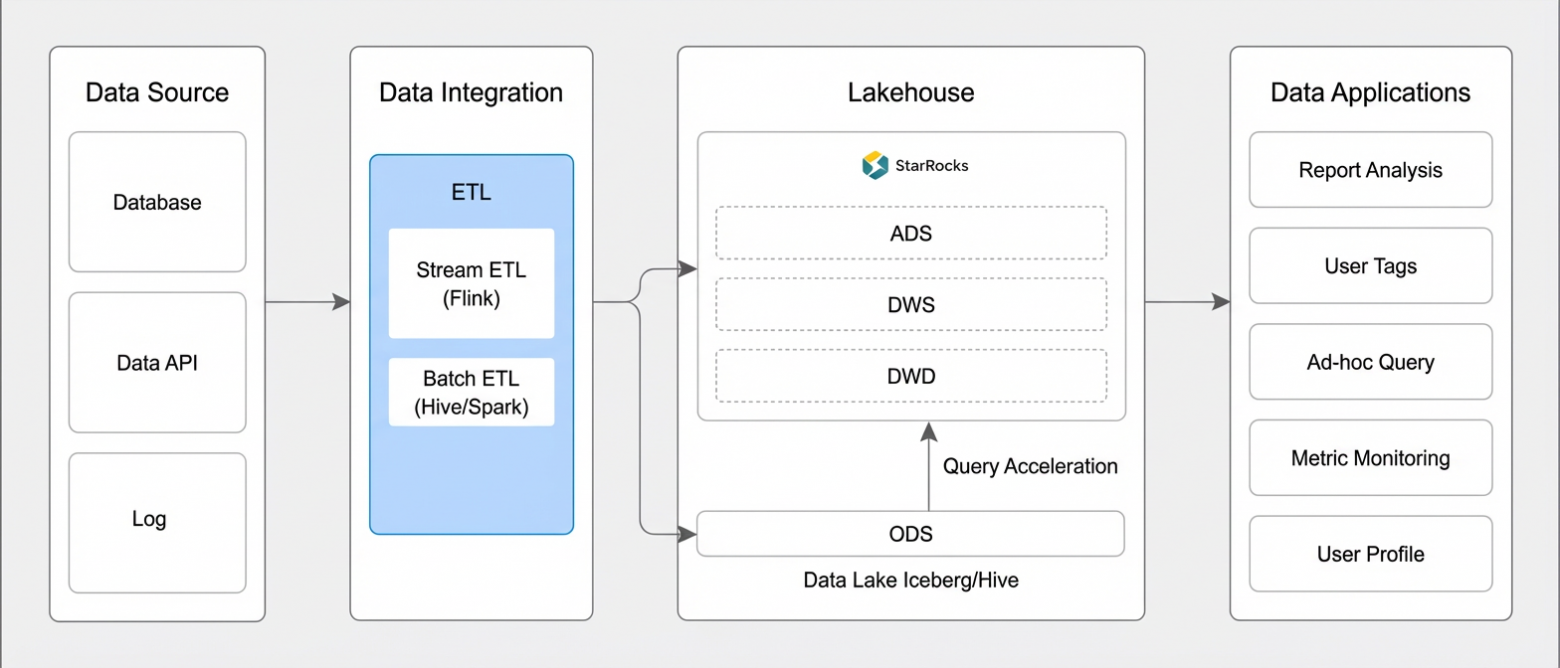
Интеграция StarRocks с BI-средами опирается на несколько взаимодополняющих слоев: источник данных, конвейеры загрузки, центральный аналитический хранилище StarRocks и слой потребления - BI-инструменты и аналитические пайплайны. Основной посыл - обеспечить прозрачную схему данных, минимальные задержки между обновлением источников и доступностью информации для dashboards, а также единый контроль качества и безопасности.
Ключевые компоненты архитектуры включают:
- Источники данных и их загрузка. Для реального времени и ближнего к реальному времени используются паттерны потоковой загрузки (StreamLoad, публикация в брокеры и конвейеры типа Kafka/Pulsar) и пакетная загрузка через Broker Load из хранилищ (OSS, HDFS, S3). Такой дуализм позволяет BI-пользователям видеть обновления почти мгновенно и при этом сохранять полноту и консистентность исторических данных.
- Центральный аналитический слой StarRocks. Это хранилище, оптимизированное под аналитические запросы: колоночный формат, сжатие и параллелизм на уровне воркеров. В рамках интеграций особую роль играет возможность создания материаловидных представлений (materialized views) и предагрегированных таблиц, которые ускоряют дорогостоящие BI-запросы.
- Инструменты потребления. BI-системы (Tableau, Power BI, Looker и др.) подключаются через универсальные интерфейсы JDBC/ODBC или через REST-слой, если он поддерживается конкретной платформой. В идеале - единый слой метаданных, который отражает фактический слой StarRocks и обеспечивает единый словарь измерений и фактов.
- Слои управления данными и безопасность. Реализация RBAC/SSO, управление доступом на уровне строк и столбцов, аудит изменений и централизованный каталог метаданных позволяют соответствовать требованиям регуляторики и корпоративной политики.
- Оркестрация и качество данных. Интеграционные пайплайны связывают загрузку данных, оркестрацию задач, валидацию схем и контроль версий данных. В качестве оркестраторов часто применяются Airflow, Dagster или аналогичные системы, которые обеспечивают повторяемость и контроль версий ETL/ELT-процессов.
Обоснование такой архитектуры состоит в минимизации задержек на каждом слое и соблюдении принципа разделения ответственностей: BI-команды работают с готовыми представлениями и рекомендованными правилами доступа, инженеры по данным - с механизмами загрузки и проверки целостности, а регуляторы - с аудитом и политиками безопасности. В реальном внедрении следует придерживаться следующих практик:
- заранее определить минимально необходимые наборы данных и частоту обновления для каждого набора информации, что позволяет планировать ресурсы StarRocks и максимизировать кеширование на уровне BI.
- проектировать схему хранения вокруг бизнес-мерностей и фактов, используя звездную схему (star schema) или адаптацию под нужды конкретного домена, чтобы упрощать агрегации и подстановку фильтров.
- внедрить версионность схем и данных, чтобы возвращаться к конкретным состояниям источников и обеспечивать воспроизводимость dashboards при изменении источников данных.
-- Пример сценария загрузки: потоковая загрузка через StreamLoad
-- 1) источник гружен в брокер-слой, 2) StarRocks принимает поток, 3) обновляется аналитический набор
PATCH STREAMLOAD CONFIG
{
  "type": "stream",
  "source": "kafka",
  "topic": "sales.events",
  "target_table": "staging_sales"
}
Форматы данных, схемы хранения и согласованность данных
Эффективная аналитика начинается с согласованной и предсказуемой структуры данных. В контексте BI и пайплайнов StarRocks выступает как платформа, оптимизированная под аналитические запросы, поэтому важна совместимость форматов данных, разумная детализация схем и управление изменениями в модели данных.
- Форматы данных. Для загрузки в StarRocks предпочтение отдаётся колонно‑ориентированным форматам: Parquet, ORC, JSON или CSV в зависимости от источника и требований к компрессии. Parquet и ORC позволяют эффективно считывать столбцы, подходить для частичных выборок и быстрых агрегаций. JSON может применяться для полуструктурированных источников, но требует дополнительной нормализации на этапе загрузки.
- Моделирование данных. В BI чаще всего применяются звездная (star) и снежинка (snowflake) схемы. Взвешенным подходом является использование суррогатных ключей для измерений и явной роли фактов в секциях, связанных с бизнес-процессами. Denormalized объединения часто ускоряют чтение, но требуют аккуратной миграции при изменении источников.
- Связь с данными и согласованность. В BI критична консистентность между фактами и измерениями. Рекомендуется использовать единую «каталоговую» схему, где все столбцы имеют фиксированные значения типов, а обновления относятся через атомарные операции. Для изменения данных в уже обработанных периодах применяются подходы SCD (Slowly Changing Dimensions), чтобы сохранить историческую точность и возможность аудита.
- Версионность и управляемость. Вводится версия схемы или дата‑первичного состояния (effective_date) для таблиц измерений, чтобы BI-слой мог правильно обрабатывать временные метрики и корректно рассчитывать квантили и тренды. Это особенно важно в условиях частых изменений источников и требований к данным.
Материальные представления и индексы в StarRocks - мощный инструмент для ускорения BI-операций. Предварительная агрегация и предвычисление часто являются основой для dashboards с высоким пользовательским спросом. Применение материализованных представлений (MV) и локальных агрегатов позволяет существенно сократить время отклика на типовые запросы. Однако MV требуют планирования обновления и мониторинга, чтобы не отставать от источников данных.
- Пример MV. Создание MV для недельных продаж с предагрегированными метриками позволяет BI получать данные без повторной агрегации на каждом запросе.
- Простой подход к данным. Стратегия должна предусматривать детализацию по измерениям и границам времени, вдобавок к частоте обновления MV и их падению при обновлениях источников.
CREATE MATERIALIZED VIEW mv_weekly_sales
## AS SELECT
  date_trunc('week', order_date) AS week_start,
  SUM(total_amount) AS weekly_total,
  COUNT(*) AS orders
FROM sales
GROUP BY week_start;
Пайплайны данных: ETL/ELT и оркестрация
Эффективная интеграция BI и StarRocks требует выстроенных конвейеров данных, которые обеспечивают достоверность данных в нужном формате и с минимальной задержкой. Разделение задач загрузки и переработки данных на ETL (extraction, трансформация, загрузка) и ELT (извлечение, загрузка, преобразование) позволяет выбрать оптимальные точки контроля и ресурсы для обработки.
- ETL против ELT. В случае BI и StarRocks часто предпочтительно ELT-подход: данные загружаются «как есть», затем в StarRocks выполняются преобразования и агрегации. Это снижает риск дублирования бизнес-логики в внешнем процессе и позволяет быстрее адаптировать схему под новые требования аналитики.
- Оркестрация. Инструменты типа Apache Airflow или Dagster отвечают за координацию загрузки, проверку схем и качество данных. Важны: идемпотентность задач, контроль версий схем и детализированные metadata‑контрольные точки.
- Контроль качества и мониторинг. Применяйте сигналы качества: согласование количества записей между источником и целевой таблицей, контроль уникальности ключей, проверку валидности значений, аудит изменений. В BI‑сценариях особенно важна возможность отката и воспроизведения данных в случае ошибок.
- Управление изменениями схем. При эволюции источников следует внедрять миграции схем и регистрировать изменения в каталоге метаданных. Это позволяет BI-командами адаптироваться к новым полям и формам данных без сбоев в dashboards.
Оркестрация также должна учитывать частоты обновления для разных доменов. Не все данные требуют молниеносной доставки: оперативные метрики могут обновляться чаще, тогда как архивные исторические наборы - реже. Разделение рабочих нагрузок между оперативной сверкой и долговременным хранением обеспечивает баланс между скоростью и экономикой ресурсов.
Производительность BI-запросов и лучший стиль разработки
BI-пользователи часто работают с обширными временными диапазонами, скрытыми в сложных условиях фильтрации. Производительность запросов в StarRocks достигается за счет сочетания стратегий моделирования данных, механизмов кэширования и умной агрегации.
- Выбор ключей распределения и сортировки. Оптимальные распределение (distribution) и сортировка (sort) обеспечивают эффективное параллелизм и минимизацию конфликтов на уровне объединений. В общем случае для фактов выбирают hash-дистрибуцию по ключам измерений; для больших измерений - range-partitioning по дате и городу/региону.
- Предагрегированные и MV‑слои. MV и предагрегированные таблицы позволяют перескочить крупные агрегации на лету. В BI сценариях они особенно полезны для топ‑N отчётов, оконных функций и периодических сводок.
- Применение фильтров и предикатов. Прямой пушдаун предикатов позволяет сократить объем обрабатываемых данных на раннем этапе выполнения запроса. BI‑пьюр-слой должен формировать запросы с точными фильтрами по времени, географии и сегментам.
- Избегание перегрузок по столбцам. В BI-запросах целесообразно выбирать лишь те столбцы, которые реально необходимы. Это снижает входной объем и ускоряет сканирование.
- Мониторинг и профилирование. Встроенные средства StarRocks (EXPLAIN, профили исполнителей, метрики задержек) позволяют выявлять узкие места. Регулярная ревизия схем, индексов и MV‑слоев на основе реальных рабочих нагрузок обеспечивает стабильность.
- Архитектурная устойчивость к росту нагрузки. При росте числа пользователей и запросов следует рассмотреть горизонтальное масштабирование и перераспределение ресурсов между CPU, RAM и сетевыми каналами, а также миграцию некоторых диаграмм в MV или предагрегированные таблицы.
-- Пример запроса к одному из MV, ускоряющему BI-дашборд
SELECT week_start, SUM(weekly_total) AS total_sales
FROM mv_weekly_sales
WHERE week_start >= '2024-01-01'
GROUP BY week_start
ORDER BY week_start;
Безопасность, мониторинг и управление качеством данных
Безопасность и соответствие регуляторным требованиям занимают первостепенное место в любой корпоративной аналитике. Интеграция BI и StarRocks требует продуманной политики доступа, аудита и управления данными на протяжении всего цикла - от загрузки до потребления.
- Управление доступом. Введите роль‑based access control (RBAC) и поддержку единого входа (SSO) через корпоративные директории. Реализуйте политику доступа на уровне строк и столбцов там, где BI-доступ требует ограничений по данным. Это особенно важно для финансовых и персональных данных.
- Аудит и трассируемость. Включите механизмы аудита запросов и изменений в данных, чтобы можно было восстановить ситуацию до ошибок и показать соответствие требованиям аудита. Регулярно экспортируйте логи в хранилища для долгосрочного хранения.
- Безопасность данных. Применяйте шифрование на уровне хранения и канала передачи, контроль версий и управление жизненным циклом метаданных. Masking и tokenization полезны для чувствительных данных на уровнях представлений BI, не распаковывая их в слоях обработки.
- Мониторинг экосистемы. Интегрируйте сбор метрик StarRocks (QPS, latency, error rate, MV refresh cadence) с системами мониторинга (Prometheus, Grafana). Это позволяет быстро обнаруживать непредвиденные задержки, сбои конвейеров и деградацию качества данных.
- Управление качеством данных. Введите набор чек‑пойнтов: корректность источников, консистентность между факторами и измерениями, полнота заполнения ключевых полей. Включите автоматические проверки качества при загрузке и после обновления MV.
Key takeaways
- Интеграция BI с StarRocks строится на разделении ролей между источниками данных, конвейерами загрузки, хранилищем StarRocks и BI‑слоем; ключевые паттерны - ELT, потоковая загрузка и MV‑слои.
- Выбор форматов данных и проектирование схем должны учитывать требования BI: скорость агрегаций, историческую корректность и простоту поддержки.
- Эффективность BI-запросов достигается за счет правильной архитектуры хранения, предагрегированных представлений и пушдауна предикатов.
- Пайплайны данных требуют идемпотентности и контроля версий, чтобы обеспечить воспроизводимость и устойчивость к ошибкам.
- Безопасность и мониторинг должны быть встроены на ранних этапах проектирования: RBAC, аудит, шифрование и интеграция с системами наблюдения.
- Взаимодействие BI и StarRocks требует единых стандартов метаданных и строгого контроля качества данных, чтобы dashboards всегда отражали корректную данность.
- Архитектура должна быть гибкой: возможность добавления новых источников, изменений в схемах и адаптации к новым потребностям бизнеса без прерывания аналитических сервисов.
FAQ
- Какие основные паттерны интеграции с BI подходят для StarRocks?
- Наилучшие результаты достигаются при сочетании ELT‑парадигмы и MV‑слоев. Источники загружаются в StarRocks, где выполняются преобразования и агрегации, после чего BI‑слой обращается к готовым представлениям или к детализированным фактам. Это уменьшает задержки и упрощает контроль версий данных. В качестве практических рекомендаций - четко определить частоты обновления MV, поддерживать чистые схемы измерений и использовать буферизацию через объектные хранилища для пакетной загрузки.
- Какие форматы данных обеспечивают наилучшую производительность загрузки и запросов?
- Parquet и ORC в большинстве случаев обеспечивают наилучшую производительность за счет колоночного хранения и эффективной компрессии. JSON допустим для полуструктурированных источников, но требует дополнительных трансформаций на этапе загрузки. В BI важно держать чистую схему и минимизацию преобразований во время выполнения запросов.
- Как организовать процесс загрузки данных в StarRocks из разных источников?
- Предпочтителен ELT‑подход: данные загружаются «как есть», после чего операции трансформации выполняются внутри StarRocks или в близких к нему слоях. Важно определить единый источник истины для ключей измерений и поддерживать версионность схем. Используйте StreamLoad для реального времени и Broker Load для пакетной загрузки из S3/HDFS.
- Как снизить задержку BI‑запросов и ускорить dashboards?
- Оптимизируйте распределение и сортировку данных, применяйте MV и предагрегированные таблицы, используйте пушдаун предикатов и избегайте SELECT *. Регулярно профилируйте запросы с помощью EXPLAIN и мониторинга задержек. Включение MV для часто запрашиваемых показателей может резко снизить латентность.
- Какие частые ошибки встречаются при интеграции StarRocks с BI?
- Непоследовательность в схеме измерений между источниками и BI; отсутствие версии схемы; перегруженные MV, которые устаревают и требуют ручного обслуживания; игнорирование контроля качества и аудита. Чтобы уменьшить риски, держите единый каталог метаданных, автоматические проверки целостности и регламенты обновления MV.
- Как обеспечить безопасность доступа к данным в BI‑контексте?
- Реализуйте RBAC и SSO, применяйте политику доступа на уровне строк/столбцов, ведите аудит запросов и изменений. Для чувствительных данных используйте маскирование и минимальный набор прав, применяемый в конкретном BI‑пользователе. Убедитесь, что политика доступа синхронизирована с каталогом метаданных.
- Какие подходы к мониторингу данных и качества наиболее эффективны?
- Собирайте метрики производительности StarRocks (latency, Throughput, MV refresh cadence) и интегрируйте их в общую панель мониторинга. Применяйте автоматические проверки качества данных на каждом этапе пайплайна и при обновлениях DC/ETL. Вариативные проверки и сигнализация позволяют быстро обнаруживать отклонения и корректировать пайплайны.
- Как выбрать архитектуру хранения и пайплайна при масштабе?
- Начинайте с звездной схемы, ориентированной на домены бизнеса, и по мере роста добавляйте MV и распределение по датам. В условиях роста подключайте дополнительные ноды StarRocks и расширяйте конвейеры загрузки. Убедитесь в поддержке идемпотентности задач и планирования ресурсов, чтобы не допускать перегрузок и конфликтов при параллельной загрузке.
- Какиеopen‑source инструменты стоит рассмотреть в качестве дополнения к StarRocks?
- Metabase как простой слой визуализации и тестирования, Tableau/Power BI как визуальные инструменты и Looker как платформа моделирования данных. Важно выбирать инструменты, которые поддерживают JDBC/ODBC и позволяют работать с вашим каталогом метаданных и политиками доступа. В рамках российского контекста можно рассмотреть локальные решения по каталогам и организациям данных, если они соответствуют требованиям регуляторов.
- Какие шаги можно предпринять в первые 90 дней после внедрения?
- Определить набор критических BI‑пользователей и их потребности, сформировать единый словарь измерений, настроить базовые MV; внедрить процесс ELT‑партнерства и автоматическую валидацию схем. Организовать мониторинг качества данных, базовую метрику доступности и SLA, а также начать тестовые дашборды на реальных сценариях. В итоге вы получите базовую архитектуру, которую можно масштабировать и углублять.
Готовность к внедрению во многом определяется ясностью бизнес‑потребностей, дисциплиной по управлению данными и устойчивостью конвейеров загрузки. Важно помнить: интеграция BI и StarRocks - это не одноразовый проект, а постоянная работа по поддержке прозрачности данных, скорости принятия решений и соблюдению норм управления качеством и безопасностью.


