

Перспективы и будущее развития Kafka и потоковой интеграции данных
Потоковая обработка данных стала ядром современных аналитических платформ: от реального времени операций и мониторинга до сложной аналитики и моделирования. Apache Kafka остаётся краеугольным камнем этой экосистемы, а его эволюция напрямую влияет на архитектуры, процессы и бизнес-решения в организациях. В данной главе рассматриваются ключевые векторы будущего развития Kafka и потоковой интеграции данных, их обоснование, практические последствия и ориентиры для внедрения на уровне предприятий и аналитических платформ.
Ключ к успешной трансформации - не только понимание того, какие новые возможности появляются, но и почему они необходимы в контексте стратегий цифровой трансформации: ускорение времени получения инсайтов, повышение надёжности данных и снижение операционных издержек за счёт унификации потоков и управляемой эволюции инфраструктуры.
- Глазами методолога и инженера: какие архитектурные коррективы и протоколы приближают Kafka к будущим требованиям многокластерности, регламентированного управления данными и масштабируемых аналитических сценариев.
- Глазами архитектора платформ: как интеграция новых компонентов, версионирование схем и управление метаданными влияют на устойчивость и гибкость аналитических пайплайнов.
- Глазами бизнес-менеджера: какие организационные изменения и практики подготовки команд нужны для успешной реализации потоковых возможностей.
Краткое содержание главы
- Архитектурные векторы будущего Kafka: переход на KRaft, Tiered Storage и новые механизмы согласованности.
- Безопасность, совместимость и протоколы: эволюция аутентификации, авторизации и управления версиями протокола.
- Экосистема и интеграции для аналитических платформ: роль Schema Registry, ksqlDB и взаимодействие с потоковыми обработчиками.
- Масштабирование, регионализация и управление данными: межкластерная репликация, multi-tenant подходы и облачные развертывания.
- Стратегии внедрения и управленческие аспекты: дорожная карта, управление изменениями, риск-менеджмент и планирование компетенций.
Архитектурные векторы будущего Kafka
Одной из центральных тем является переход к управляемой инфраструктуре безZooKeeper и переход к Raft-совместимому управлению метаданными - проект KRaft. Этот ход несёт ряд принципиальных преимуществ: упрощение управления, улучшенную отказоустойчивость и предсказуемость задержек в больших кластерах, упрощённую безопасность и более тесную интеграцию с облачными средами. В рамках такого перехода архитектура Kafka ориентируется на:
- единый механизм управления метаданными и топиками без внешних сервисов;
- горизонтальное масштабирование метаданных и эффективную координацию между брокерами;
- упрощение эксплуатации и мониторинга за счёт единых моделей управления;
- улучшение поддержки multi-tenant и ресурсного изоляционного взаимодействия между клиентами.
Параллельно развиваются и другие архитектурные направления, которые существенно влияют на производительность и стоимость владения:
- Tiered Storage: перенос активных сегментов на быстропроизвольные носители и долговременное хранение архивных сегментов в экономичных складах. Это позволяет снизить затраты на хранение без потери скорости доступа к свежим данным и снижает требования к подвижной памяти в кластере.
- Улучшение Exactly Once Semantics (EOS): сочетание idempotent producers и снабжение транзакционных гарантий на уровне топиков и разделов. В сочетании с кросс-региональными сценариями это важно для консистентности аналитических пайплайнов, где данные проходят через несколько стадий обработки.
- Расширение возможностей мониторинга и многокластерного управления: новые подходы к глобальному мониторингу, согласованию политик QoS и распределённому планированию ресурсов между кластерами в разных регионах.
Эти направления открывают возможности для устойчивой поддержки растущего объёма данных и усложняющихся сценариев анализа, где аналитика требует как низкой задержки в реальном времени, так и надёжной долговременной истории изменений. В контексте аналитических платформ это означает более предсказуемые пайплайны, упрощённую миграцию между средами и более тесную интеграцию с хранилищами данных, такими как data lake или data lakehouse.
Углубляясь в детали, следует отметить, что архитектурные изменения не являются merely техническими прихотями. Они соответствуют требованиям бизнеса к гибкости, масштабируемости и ускорению времени получения инсайтов. При этом важно сохранять баланс между инновациями и устойчивостью операционной деятельности: новые возможности должны дополнять существующие пайплайны без риска прерывания критических процессов.
Безопасность и управляемость на новом уровне
С ростом масштаба и количества потребителей становится критическим вопросом управления доступом и аудита. Вектор развития связан с переходом к более строгим моделям аутентификации и авторизации:
- расширение наборов SASL/ACL и внедрение современных механизмов аутентификации (TLS mutual, OAuth, возможные расширения Kerberos) для упрощения интеграций в крупных корпоративных сетях;
- усиление контроля над политиками доступа на уровне топиков, групп, потребителей и продюсеров с поддержкой аудита изменений;
- обеспечение совместимости между версиями протокола и кросс-кластерной поставкой обновлений без прерываний.
Эти элементы служат основой для надёжного и прозрачного поточного обмена данными между различными подразделениями и системами аналитики, включая регламентированные данные и данные с повышенными требованиями к конфиденциальности.
Протоколы и совместимость
Развитие протокольной части Kafka направлено на более эффективное использование сетевых ресурсов и лёгкость интеграции с внешними системами. Вектор включает:
- улучшение форматов сериализации и поддержки схем (например, эволюция схем в Schema Registry, поддержка обратно- и вперёд-совместимости);
- усиление режимов защиты каналов передачи и безопасной аутентификации;
- ясные и предсказуемые контракты между продюсерами, брокерами и консьюмерами, минимизирующие задержки и перерасход ресурсов.
Эволюция протоколов способствует снижению задержек и повышению устойчивости систем, особенно в сценариях с большим количеством микро-потребителей, облачных развёртываний и региональных реплик.
Экосистема и интеграции для аналитических платформ
Для аналитических платформ ключевыми остаются инструменты вокруг ядра Kafka, которые позволяют строить устойчивые пайплайны, внедрять схемы данных и выполнять потоковую обработку на читаемом уровне бизнес-логики.
- Schema Registry обеспечивает управление схемами и их эволюцию без потери совместимости. Это особенно важно для аналитических пайплайнов, где изменения форматов данных должны быть прозрачны потребителям без прерываний обработки.
- ksqlDB предоставляет возможность исполнения поточных SQL-запросов над данными прямо в потоке. Это позволяет аналитическим командам формировать оперативные дашборды и агрегированные показатели без необходимости писать сложные поточные программы на Java/Scala.
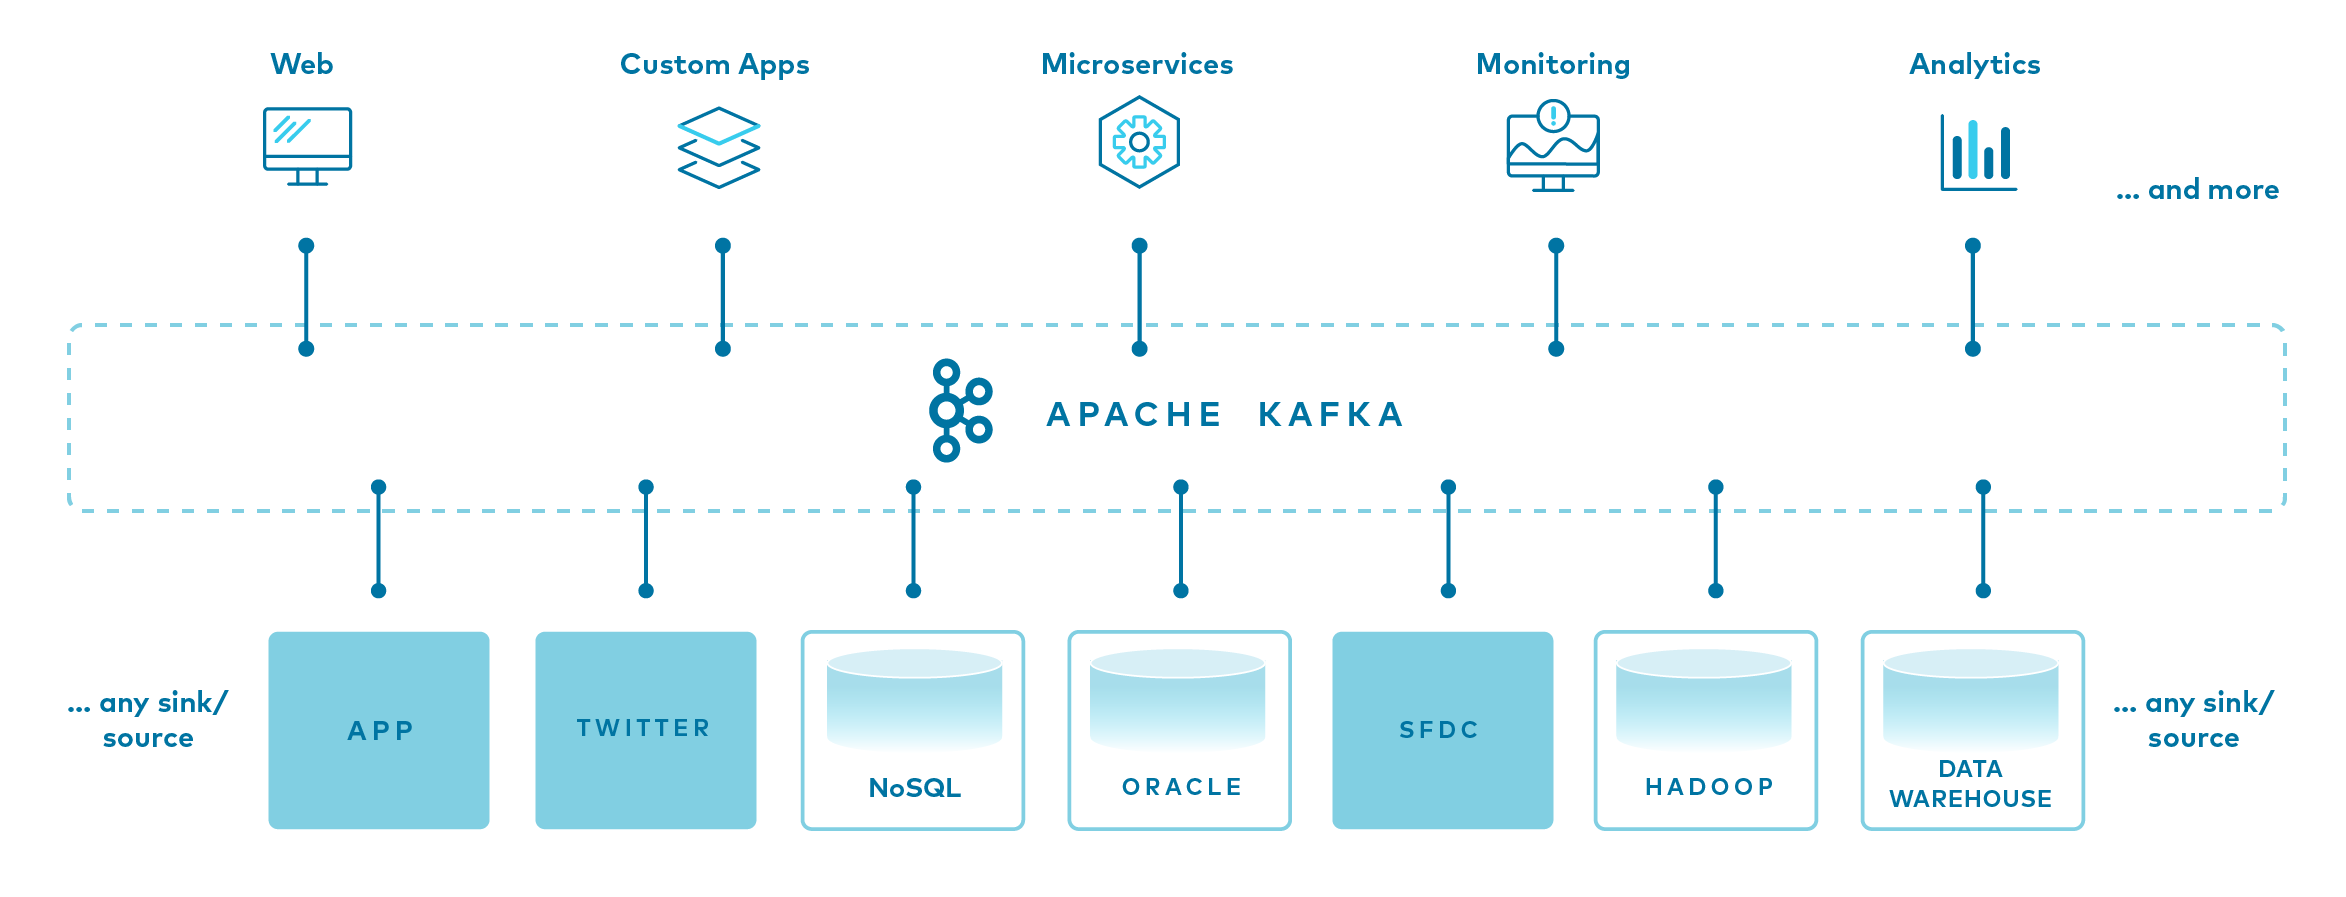
- Коннекторы в Kafka Connect облегчают интеграцию источников и получателей данных: базы данных, облачные хранилища, файловые системы и другие системы. Они повсеместно применяются для организации потоков между системами и для миграций.
- Взаимодействие с аналитическими движками (например, для обработки в реальном времени) обеспечивает плавный переход между потоковым анализом и пакетной обработкой, интегрируя данные Kafka в экосистемы data lakehouse или конечную аналитику.
С учётом ограниченности упоминаний, следует выделить две опорные связки: Schema Registry и ksqlDB как принципиально важные компоненты для организаций, намеренно выстраивающих архитектуру на основе потоков данных. Они позволяют управлять качеством данных и прямо формулировать бизнес-логики в рамках потока, что особенно ценно для аналитических сценариев и скоринга в реальном времени.
Наряду с этим важно помнить о роли обработки данных на этапе потоковой агрегации и миграции: интеграция с аналитическими платформами не ограничивается чистым потоком. Она включает планирование обработки, согласование форматов и эволюцию схем, обеспечение надёжности конвейеров и минимизацию времени доступа к данным для потребителей.
Архитектурные решения для масштабирования и регионализации
С расширением географии использования и необходимостью поддержки локальных регуляторных требований возникает потребность в масштабируемых и регионализируемых архитектурах.
- Межкластерная репликация: MirrorMaker2 и аналогичные подходы позволяют организовать синхронное или асинхронное копирование данных между кластерами в разных регионах. Это обеспечивает отказоустойчивость и локализацию задержек доступа, а также упрощает соблюдение локальных требований к хранению данных.
- Multi-tenant управление: изоляция ресурсов и квотирование позволяют нескольким бизнес-единицам использовать одну инфраструктуру Kafka без риска взаимного влияния. Важна чёткая политика разделения потоков, мониторинга и лимитирования.
- Облачные развёртывания и Kubernetes: архитектура становится более «cloud-native» за счёт контейнеризации и оркестрации. Это повышает гибкость развёртываний, ускоряет масштабирование и упрощает управление конфигурациями при изменении спроса.
- Tiered Storage в продвинутой реализации: переход к долговременному хранению архивных сегментов в доступной инфраструктуре, снижая стоимость хранения при сохранении возможности доступа к данным для аналитики.
Эти решения позволяют организациям эффективно сочетать требования к задержке, объему данных и стоимости хранения, а также обеспечивают гибкость в условиях меняющегося спроса и регуляторной среды.
Практические подходы к реализации
- Разделение рабочих нагрузок: выделение отдельных кластеров под потоковую вставку, обработку и аналитическую выборку. Это снижает конкуренцию за ресурсы и упрощает управление качеством сервиса.
- Управление консистентностью и согласованностью между регионами: четкие соглашения об обработке ошибок, задержках и допустимом временном окне задержки между кластерами, чтобы обеспечить предсказуемость пайплайнов.
- Управление данными и качество: политика эволюции схем и мониторинг качества данных, включая отслеживание изменений, пропусков и дубликатов, чтобы сохранить высокое качество данных на протяжении всего цикла жизни пайплайна.
Будущее развитие и стратегические сценарии внедрения
На горизонте стоят несколько стратегических направлений, которые формируют дорожную карту для организаций:
- Глубокая интеграция с данными и управлением метаданными: повышение уровня автоматизации в управлении схемами, версиями топиков и контрактами между компонентами пайплайна. Это снижает риск несовместимостей и упрощает регуляторное соответствие.
- Эволюция конфигураций безопасности и аудита: усиление контроля доступа на уровне операций, расширение возможностей аудита и управление политиками в рамках глобальной инфраструктуры.
- Укрепление архитектурной совместимости и миграций: упрощение миграций между версиями Kafka, а также между разными средами (on-prem, облако, гибрид) без прерываний бизнес-процессов.
- Data mesh и потоковая аналитика: продвинутые сценарии распределённой аналитики, где потоковые данные становятся первым классом для предоставления бизнес-ориентированных сервисов и продуктов.
- Внедрение и операционная зрелость: развитие методик организации команд, процессов DevOps/DevSecOps для потоковой передачи данных, практик автоматизированного тестирования и мониторинга.
Эти направления не являются самостоятельными целями; они дополняют друг друга и формируют основу для устойчивой цифровой трансформации. Реализация предполагает не только приобретение технологий, но и преобразование организационных процессов: роли, методы разработки, процессы аудита и управления изменениями должны быть адаптированы под новый режим работы потоковых платформ.
Практические сценарии внедрения на аналитических платформах
- Потоковая трансформация и интеграция в data lakehouse: данные приходят в Kafka, применяются лёгкие функции преобразования и затем попадают в хранилище данных для пакетной аналитики и оперативного доступа. Это позволяет снизить задержку между событием и бизнес-решением.
- Реализация мониторинга в реальном времени: данные о событиях и KPI попадают в пайплайн, где Kafka выступает как единый источник для мониторинговых панелей и алертинг-систем. Это ускоряет обнаружение отклонений и позволяет бизнесу реагировать быстрее.
- Модульность и лояльность к бизнес-объектам: потоковые данные структурируются вокруг бизнес-объектов, что улучшает управляемость и повторное использование конвейеров между проектами.
- Миграции и эволюции: планирование обновлений кластера и переход на новые возможности без потери совместимости и без прерываний в работе критических сервисов.
Key takeaways
- Kafka продолжает эволюцию в направлении управления метаданными и упрощения эксплуатации через переход на KRaft, улучшение tiers хранения и расширение возможностей для многокластерной архитектуры.
- Безопасность и управляемость остаются критическими точками роста: расширение аудита, доступов и соответствия регуляторным требованиям становится нормой в крупных организациях.
- Экосистема вокруг Kafka (Schema Registry, ksqlDB, коннекторы) остаётся ключевым драйвером для построения аналитических пайплайнов и упрощения интеграций.
- Архитектурные решения для масштабирования и регионализации требуют чёткого планирования межкластерной репликации, изоляции нагрузок и облачных стратегий развёртывания.
- Будущие стратегии внедрения предполагают сочетание data mesh-подходов, управляемой эволюции схем и автоматизации операционных процессов вокруг потоковой инфраструктуры.
- Важной задачей остаётся баланс между инновациями и устойчивостью. Новые функции должны быть внедряемыми без прерываний и с минимизацией рисков.
- Архитектура и процессы должны быть адаптированы под бизнес-цели: скорость времени реакции, качество данных и эффективность затрат на инфраструктуру.
FAQ
- Что значит переход Kafka на KRaft и зачем он нужен?
- KRaft - это переход к Raft-основанному управлению метаданными внутри Kafka, который устраняет зависимость от ZooKeeper. Это упрощает развёртывание, повышает надёжность и ускоряет масштабирование. В будущих версиях это позволит единообразно управлять кластерами в облаке и локально, снизит операционные риски и улучшит согласованность между сервисами.
- Какие преимущества даёт Tiered Storage в Kafka?
- Tiered Storage позволяет хранить активные данные в быстром носителе, а архивные - на экономичных, долговременных складах. Это снижает общую стоимость владения, упрощает управляемость больших объёмов данных и сохраняет возможность быстрого доступа к свежим данным. В аналитике это особенно важно для сценариев с долгосрочной ретенцией и глобальными пайплайнами.
- Как обеспечить безопасный доступ и аудит в условиях растущих пайплайнов?
- Важна комбинация TLS/mTLS, расширенных механизмов аутентификации (SASL, OAuth), а также детализированных политик доступа (ACL) и мониторинга действий. Регулярный аудит, версия контроля политик и интеграция с SIEM-решениями позволят обеспечить соответствие регуляторным требованиям и снизить риск нарушения конфиденциальности.
- Какие вызовы связаны с миграцией с ZooKeeper на KRaft?
- Основные сложности заключаются в планировании перехода без простоев, синхронизации конфигураций, миграции данных метаданных и обеспечения совместимости потребителей и производителей во время миграции. Практически это требует поэтапного перехода, тестирования в песочнице и наличия планов отката.
- Какие варианты репликации и как выбрать между ними?
- Межкластерная репликация обеспечивает доступность и локализацию задержек, но влечёт за собой дополнительную операционную нагрузку. MirrorMaker2 - распространённый выбор для синхронизации между кластерами в разных регионах. Необходимо определить допустимую задержку, требования к консистентности и бюджет на сеть и хранение.
- Как Kafka интегрируется в data lakehouse и аналитическую экосистему?
- Kafka выступает как единый поток данных для событийного обмена между источниками и аналитическим хранилищем. Schema Registry обеспечивает эволюцию форматов, ksqlDB - трансформацию и быстрые аналитические запросы, коннекторы - интеграцию с источниками и получателями. В сочетании это образует устойчивый, управляемый поток данных от источника до хранилища и конечной аналитики.
- Какие риски сопутствуют масштабированию Kafka и как их минимизировать?
- Основные риски: задержки из-за перегрузки сети, конкуренция потоков за ресурсы, сложности мониторинга, проблемы совместимости схем и версий. Минимизировать можно через чёткое разделение нагрузок на кластеры, инфраструктурные лимиты и квоты, автоматизированный мониторинг, прогрессивную миграцию версий и планирование тестирования в условиях близких к боевым сценариям.
- Какие роли и процессы необходимы для стабильной потоковой трансформации?
- Важны команды DevOps/Platform Engineering, Data Engineering и Security, а также бизнес-аналитики, работающие с требованиями к данным. Рекомендуется внедрять практики CI/CD для конфигураций, тестирование пайплайнов, инцидент-менеджмент и регулярное обучение сотрудников в области потоковой архитектуры.
- Как планировать дорожную карту внедрения Kafka в крупной организации?
- Необходимо определить целевые сценарии: скорость доставки, требования к задержке, объем данных и регулятивные рамки. Затем формируется дорожная карта с фазами миграции, внедрением новых компонентов (например, Tiered Storage, KRaft), а также планами по безопасной миграции, обучению персонала и управлению изменениями.
- Какие алгоритмы и протоколы обеспечивают Exactly Once Semantics?
- EOS достигается через сочетание идемпотентных продюсеров, транзакционных записей и надёжной координации между продюсерами и брокерами. В контексте мультирегиональных пайплайнов это требует аккуратной настройки временных окон, границ транзакций и согласованных стратегий повторной отправки. Важно помнить, что EOS - это договорённости на уровне пайплайна: каждый компонент должен поддерживать согласованность и корректную обработку ошибок.
Завершая, важным остаётся понимание того, что будущее Kafka лежит на стыке архитектурной эволюции, углубления управления данными и улучшения интеграций с аналитическими платформами. Правильное сочетание перехода на новые механизмы, осознанного внедрения и зрелого управления изменениями позволяет организациям быстро и надёжно реализовывать сценарии потоковой аналитики, снижая риски и обеспечивая устойчивый операционный эффект.


