

Архитектура Spark: движки, API и жизненный цикл задач
Spark выступает как многокомпонентная платформа, в которой разделение ответственности между движками обработки, интерфейсами программирования и механизмами планирования обеспечивает гибкость и масштабируемость обработки больших данных. В аналитических хранилищах требование часто состоит не только в скорости обработки, но и в предсказуемости задержек, управляемости затратами и возможности безболезненно менять источники данных. Глава раскрывает архитектуру Spark как системы, в которой каждый слой выполняет специфическую роль и тесно интегрируется с остальными слоями через четко определенные контракты.
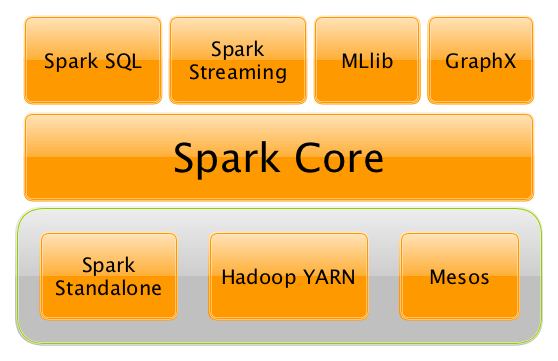
Spark характеризуется четко разделенными слоями: исполнительный движок (Core), аналитический движок (Spark SQL, DataFrame/Dataset API, Catalyst/Tungsten), и инфраструктура ввода-вывода/хранения данных. Взаимодействие между слоями реализуется через последовательный набор этапов: от представления запроса в виде логического плана, его преобразования в физический план, распределения работы по кластеру и исполнения на кластере с последующим возвратом результатов. Эта структура обеспечивает инициацию задач на уровне драйвера, управление их выполнением на исполнителях и оптимизацию исполнения за счет продуманного выбора физических планов и технологий исполнения.
Ключевые принципы, которыми следует руководствоваться при разработке и эксплуатации решений на Spark в рамках аналитических хранилищ:
- модульность и взаимосвязь между API и движками: DataFrame/Dataset и Spark SQL предоставляют более высокий уровень абстракции по сравнению с RDD, при этом внутренние механизмы опираются на Catalyst и Tungsten для оптимизации;
- разделение логики планирования и исполнения: DAG Scheduler обеспечивает разбиение графа задач на стадии и задачи, а Task Scheduler отвечает за эффективное размещение задач на executors;
- эффективная обработка больших данных через стратегию Shuffle, сериализацию и управление памятью, включая корректное использование unified memory;
- интеграция с хранилищами и форматами данных через DataSource API, параллельное чтение столбцов и предикат-пушдаун в формате Parquet/ORC;
- возможность адаптивной замены стратегий исполнения на этапе выполнения через механизмы, такие как Whole-Stage Codegen и адаптивное планирование.
Архитектура Spark: уровни, движки и API
Архитектура Spark строится вокруг трёх взаимосвязанных слоёв: Core-движок, аналитический двигатель Spark SQL (на базе DataFrame и Dataset) и слой ввода-вывода, который обеспечивает доступ к данным в распределенном окружении. В рамках Core осуществляются базовые принципы распределенного вычисления: планирование задач, управление ресурсами, обработки ошибок, сериализация и коммуникации между узлами. Аналитический движок добавляет на этом основании мощь оптимизации запросов и удобство работы с неструктурированными и структурированными данными через DataFrame и SQL интерфейсы. Взаимодействие между слоями реализуется через унифицированные механизмы передачи данных, в частности через DataFrame/DS API, а также через промежуточные представления в виде логических и физических планов.
- Spark Core: базовый двигатель обработки, отвечающий за расписание задач, управление памятью, шедулеры и обмен сообщениями между узлами. В его рамках реализованы DAG Scheduler и Task Scheduler, механизм блоков и кэширования, Shuffle-Service и устойчивые интерфейсы к различным кластерным менеджерам (Standalone, YARN, Mesos, Kubernetes). Основная роль Core - обеспечить надежное и масштабируемое выполнение любой задачи, будь то простой Transform или сложная аналитическая конвейерная цепочка.
- Spark SQL и DataFrame/Dataset: поверх Core реализованы API уровня SQL, DataFrame и Dataset. Это обеспечивает единый путь обработки для структурированных данных, независимо от источника данных. Внутренний механизм Catalyst отвечает за преобразование логического плана запроса в оптимальный физический план, применяя правила преобразования и оптимизации. Tungsten обеспечивает эффективную реализацию вычислений за счет неконсервативной механики памяти и генерации кода.
- Катализатор и Tungsten: Catalyst** - это оптимизатор и компоновщик физических планов. Он выполняет анализ схемы, разрешение имен, нормализацию выражений и применение правил оптимизации. Tungsten отвечает за низкоуровневое представление данных и эффективное выполнение с точки зрения памяти и CPU, включая векторизацию чтения, уплотнение алгебраических операций, а также генерацию специализированного байткода на лету (Whole-Stage Codegen).
- Речевые данные и блоки: BlockManager обеспечивает хранение и доступ к данным внутри кластера. Он координирует кэширование и обмен данными между узлами, включая управление памятью и spill на диск в случае нехватки памяти.
- Распределение нагрузки и кластерные менеджеры: Standalone, YARN, Mesos и Kubernetes - разные реализации управления ресурсами и запуском приложений Spark. Архитектура Spark позволяет гибко выбирать подходящий менеджер в зависимости от инфраструктуры и требований к управлению ресурсами.
Схема обработки данных в Spark складывается из последовательности этапов: чтение данных из источника, преобразование в представление DataFrame/Dataset, применение трансформаций, планирование и выполнение на executors с использованием DAG и задач, а затем запись результатов обратно в хранилище. В этом процессе основную роль играет разделение логического и физического планов, что позволяет Spark независимо решать задачу оптимизации и техническую реализацию исполнения.
API-уровни и их роль
- RDD API: низкоуровневый интерфейс для управления распределенными коллекциями. Используется в редких случаях, когда требуется прямой контроль над обработкой и отсутствуют преимущества от оптимизаций Catalyst.
- DataFrame API: упрощает работу со структурированными данными за счет схемы и оптимизирующих правил Spark SQL. Привносит предикат-пушдаун, кеширование на уровне DataFrame и интеграцию с источниками форматов Parquet, ORC и т. п.
- Dataset API: типизированная версия DataFrame, которая сохраняет удобство DataFrame и обеспечивает безопасность типов в компиляции.
Ключевая идея: архитектура Spark ориентирована на разделение ответственности между подготовкой и исполнением, где высокий уровень API обеспечивает продуктивность, а низкоуровневые механизмы исполнения и оптимизации позволяют достигать высокой производительности.
Жизненный цикл задачи: планирование, выполнение и обработка ошибок
Процесс выполнения задачи в Spark начинается с подачи работы через драйвер, который формирует граф задач (DAG) и делит его на стадии. Каждый этап графа завершается после обработки соответствующего набора данных и передачи результата или промежуточной агрегации между стадиями по мере необходимости. В контексте аналитических хранилищ жизненный цикл задачи опирается на предикаты зависимостей и возможности переработки данных на стороне узлов кластера.
- Планирование и разбор запроса. Драйвер получает запрос и строит логический план на основе DataFrame/Spark SQL. Анализатор разрешает ссылки на столбцы и типы данных, нормализует выражения и применяет базовые оптимизации на уровне логического плана.
- Преобразование в физический план. Catalyst применяет набор правил оптимизации, включая предикат-пушдаун, constant folding, сортировку и перестройки соединений. В результате формируется один или несколько физических планов, из которых выбирается наиболее эффективный на основе стоимости вычисления.
- Распределение задач. DAG Scheduler разбивает физический план на стадии, учитывая точки разнесения на shuffle-операции. Каждая стадия затем делится на задачи, которые могут выполняться параллельно на разных executors.
- Выполнение. Task Scheduler отправляет задачи выполнителям на узлах кластера. Каждый таск работает на локальных частях данных (из BlockManager) или читает данные из источников, осуществляя необходимые преобразования и вычисления.
- Шаффл и обмен данными. При необходимости промежуточные результаты передаются между стадиями через Shuffle. В современных конфигурациях используется эффективная реализация Shuffle, включая sort-based shuffle и оптимизации памяти.
- Завершение и возвращение результата. По завершении ступеней данные собираются и возвращаются драйверу, после чего задача помечается как завершенная.
- Ошибки и повторные попытки. В случае сбоев Spark применяет повторные попытки для неуспешных задач. При достаточном количестве неудач задачи могут быть отменены, а граф задач - перерасчитан заново. Поддерживаются такие механизмы, как speculative execution для устранения «узких мест» и динамическая адаптация числа executors.
Понимание жизненного цикла критично для оптимизации и контроля эксплуатационных рисков. Например, с точки зрения хранения и доступа к данным, важно понимать, как данные синхронно и асинхронно проходят через BlockManager и Shuffle-сервисы, чтобы минимизировать сетевой трафик и задержки.
Таблица: Жизненный цикл задачи Spark
| Этап | Что происходит | Ключевые параметры |
|---|---|---|
| Job | Драйвер принимает запрос и строит DAG | spark.job.id, план выполнения |
| Stage | Разделение по зависимостям, создание наборов задач | stageId, shuffleDependencies |
| Task | Выполнение задач на executors | taskId, locality, attempts |
| Shuffle | Передача промежуточных данных между стадиями | shuffleId, shufflePartitions |
| Result | Сбор результатов и возврат драйверу | resultSize, collectTimeout |
Катализатор, выполнение и оптимизация запросов: DataFrame, Dataset и Spark SQL
Катализатор является ядром оптимизации в Spark SQL. Он выполняет последовательности преобразований: анализ схемы, разрешение имен и привязку типов, упрощение выражений и вычисление предикатов, а затем генерацию физического плана. В своей работе Catalyst учитывает источник данных, статистику и особенности выполнения, чтобы выбрать наиболее эффективную стратегию.
- Логический план и анализ. На этом этапе схемы приводятся к единому виду, приводятся выражения к canonical forms, а отсутствующие столбцы резолвируются через таблицу схем или метаданные. Это обеспечивает корректность запросов и подготовку к оптимизации.
- Правила оптимизации. Catalyst применяет правила преобразований, такие как pushing predicates к источнику данных, упрощение выражений, удаление лишних проекций и объединение операций фильтрации. Эти шаги существенно сокращают объем обрабатываемых данных до реального исполнения.
- Физический план. В этом шаге Catalyst формирует набор физических планов, выбирая конкретные реализации соединений, агрегаций и сортировок. Используется стоимость-ориентированное планирование (Cost-Based Optimizer), которое учитывает статистику и конфигурацию кластера.
- Whole-Stage Codegen. Важная технология, позволяющая компилировать «популярные» последовательности операций в единый фрагмент байткода на JVM. Это снижает накладные расходы на вызовы функций и улучшает сетевую и CPU-эффективность.
- Оптимизация исполнения. В зависимости от кеширования, режимов выполнения и характеристик данных Spark может выбирать различные стратегии соединения (broadcast, sort-merge, shuffle hash join) и варианты агрегаций.
Дальше следует связь между API и реализацией: DataFrame и Dataset позволяют писать запросы единым стилем, а Catalyst и Tungsten обеспечивают их эффективное исполнение. В контексте аналитических хранилищ это особенно важно: predicate pushdown и эффективное чтение столбцов заметно снижают IO и ускоряют выполнение конвейеров обработки.
Взаимодействие с форматы данных и датастилями
- Parquet и ORC. Эти форматы поддерживают колоночное чтение, векторизацию и predicate pushdown, что значительно сокращает объем читаемых данных. Spark SQL может автоматически использовать такие оптимизации, если схема и данные соответствуют требованиям.
- DataSource API. Позволяет единообразно читать и писать данные в разных источниках (HDFS, S3, локальные файловые системы), сохранять схемы и обеспечивать гибкую интеграцию форматов.
- Schema-on-read и адаптация к изменениям схем. Spark поддерживает эволюцию схем и обеспечивает совместимость между источниками данных и аналитическими конвейерами.
Оптимизация исполнения в аналитических хранилищ требует внимания к деталям: выбор типа соединения, использование Broadcast Joins для маленьких таблиц, агрегации и фильтры на ранних стадиях выполнения. Важно помнить, что архитектура Spark ориентирована на компромисс между временем подготовки данных и coût вычислительных ресурсов: иногда предикат-пушдаун ускоряет исполнение, но в некоторых случаях он может привести к сложной виртуализации и ухудшению планирования.
Управление ресурсами и среда исполнения
Управление ресурсами является критичным для аналитических хранилищ, где несколько задач выполняются параллельно, конкурируя за CPU, память и диск. Spark поддерживает разнообразные кластерные менеджеры (Standalone, YARN, Mesos и Kubernetes), что позволяет адаптировать окружение под существующую инфраструктуру и требования к инцидентному управлению.
- Динамическое выделение ресурсов. Dynamic Allocation позволяет добавлять или удалять executors в процессе выполнения приложения, максимально используя доступные ресурсы и уменьшая задержки из-за простаивания.
- Память и JVM-модель. Unified Memory Management разделяет память между хранением и вычислениями. Конфигурации spark.memory.fraction и spark.memory.storageFraction позволяют контролировать пропорции между памятью для кэширования и выполнения. При необходимости включают off-heap memory (spark.memory.offHeap.enabled) для снижения давления на JVM.
- Модели исполнения. Режимы локального и распределенного выполнения, режим Standalone и интеграция с кластерами через YARN/Mesos/Kubernetes. В продакшн-средах актуальна настройка параметров spark.executor.memory, spark.executor.cores, spark.active.available.resources и соответствующая конфигурация scheduler pools для разделения приоритетов между конвейерами.
- Тюнинг и предикаты. Важной является настройка распараллеливания задач (spark.task.cpus), уровня параллелизма (spark.sql.shuffle.partitions) и лимитов сети. Оптимизация проводится с учетом профиля данных, размера файлов, форматов, распределения по ключам и схемы доступа к данным.
Управление ресурсами тесно связано с жизненным циклом задач: динамическое масштабирование executor-ов влияет на скорость обработки стадий, аMemoryManager - на частоту spill-ов и стоимость чтения/записи. В реальном проекте эксплуатационная стратегия должна сочетать предсказуемость задержек и способность обрабатывать волатильные нагрузки, сохраняя баланс между ресурсами и стоимостью.
Интеграции с хранилищами данных и форматы
Analytical warehouses часто требуют подключения к разнообразным источникам данных: файловые системы (HDFS, S3), реляционные источники и потоковые каналы. Spark предлагает унифицированный DataSource API, который упрощает чтение и запись данных в формате Parquet, ORC, JSON, CSV и др. В контексте аналитических хранилищ особенно важно освоить:
- Predicates pushdown. Spark может передавать фильтры на уровне источника, что позволяет считывать только нужные столбцы и соответствующие диапазоны значений.
- Форматы колоночные и векторизация. Parquet/ORC поддерживают векторизацию чтения, что существенно ускоряет обработку больших наборов столбцов.
- Интеграция с облачными хранилищами. S3, ADLS и другие облачные сервисы являются популярными источниками. Spark умеет работать с ними через DataSource API и настраиваемые провайдеры доступа, включая механизмы аутентификации и контроля доступа.
- Эволюция схем. В аналитических сценариях схемы часто подвергаются изменениям. Spark поддерживает безопасное эволюционирование схем через явное указание типа столбца, преобразования и миграции в рамках конвейеров.
Проектирование конвейеров чтения/записи в аналитических хранилищ требует учета задержек на уровне сети и диска, размеров файлов и распределения данных. Эффективная интеграция с форматом данных и источниками способствует более предсказуемым срокам выполнения и улучшает качество сервиса.
Мониторинг, диагностика и продакшн-практики
Для гарантированной работоспособности и соблюдения SLA в аналитических конвейерах Spark необходима грамотная инструментальная база. В стандартной экосистеме Spark ключевые точки мониторинга включают:
- Spark UI и History Server. Предоставляют видимость по этапам, задачам, времени выполнения, ресурсам и статистике Shuffle. Специализированные вкладки по SQL-запросам позволяют анализировать планы исполнения и время на чтение/запись.
- Метрики и логи. Встроенные метрики Spark в JVM-метрике и внешнее логирование позволяют детектировать узкие места, анализировать распределение времени между стадиями и оценивать влияние изменения конфигурационных параметров.
- Журналы событий. Выдерживать историю событий, включая создание планов, запуск задач и ошибки, что важно для ретроспективной диагностики и регрессионного тестирования.
- Инструменты внешнего мониторинга. На практике интеграция со системами мониторинга и алертинга (Prometheus, Grafana, ELK/EF) обеспечивает раннее оповещение и долговременную аналитику производительности конвейеров.
Эти практики особенно важны в контексте аналитических хранилищ, где задержки и простои напрямую влияют на доступность данных и стоимость владения. Правильная постановка мониторинга позволяет быстро выявлять «узкие места» и проводить целенаправленные оптимизации на уровне шага, стадии или источника данных.
Таблица: Жизненный цикл задачи
(См. раздел выше.)
Key takeaways
- Архитектура Spark разделяет слои обработки, API и инфраструктуру до единого интерфейса, что обеспечивает гибкость и масштабируемость для аналитических конвейеров.
- Катализатор и Tungsten являются движущими силами оптимизации: первый формирует и оптимизирует планы, второй управляет памятью и производительностью вычислений.
- Жизненный цикл задачи - от планирования до исполнения и повторных попыток - критически важен для понимания задержек и возможностей оптимизации.
- Управление ресурсами и настройка памяти напрямую влияют на скорость выполнения и устойчивость к волатильности нагрузки.
- Интеграция с форматом данных и источниками через DataSource API позволяет достигать предикат-пушдауна и эффективной загрузки данных.
- Мониторинг, журналы и история выполнения необходимы для продакшн-оптимизации и контроля доступности данных и SLA.
- Продвинутые техники, такие как Whole-Stage Codegen и адаптивное выполнение, позволяют существенно снизить накладные расходы и ускорить исполнение больших конвейеров.
FAQ
- Какие движки отвечают за исполнение задач в Spark и как они взаимодействуют?
- Основной движок - Spark Core, который реализует планирование задач, управление ресурсами и обмен данными. Аналитическая часть реализована через Spark SQL/DataFrame/Dataset и Catalyst/Tungsten, которые формируют и оптимизируют планы исполнения. DAG SchedulerBreakdown и Task Scheduler взаимодействуют для распределения работы между executors, а BlockManager и Shuffle-сервисы обеспечивают хранение и обмен промежуточными данными.
- Что такое Catalyst, и зачем он нужен в Spark SQL?
- Catalyst - это оптимизатор запросов в Spark SQL. Он выполняет анализ логических планов, разрешение имен и типов, применяет правила оптимизации и формирует физические планы. Он позволяет Spark выбирать эффективные стратегии выполнения и, в сочетании с Whole-Stage Codegen, значительно ускорять обработку.
- Что означает Whole-Stage Codegen и какие преимущества он приносит?
- Whole-Stage Codegen - это технология динамической генерации байткода для конвейера операций над данными, сокращающая накладные расходы на вызовы функций и упрощающая выполнение. Это приводит к снижению overhead и улучшению производительности при больших объемах данных и сложных конвейерах.
- Какова роль памяти в исполнении Spark, и какие параметры управляют ей?
- Память разделяется между хранением данных (cache) и вычислениями. Unified Memory Management обеспечивает динамическое перераспределение памяти между этими задачами. Параметры как spark.memory.fraction и spark.memory.storageFraction управляют пропорциями. Включение off-heap памяти (spark.memory.offHeap.enabled) может снизить давление на JVM и увеличить стабильность под нагрузкой.
- Какие форматы данных особенно полезны для Spark в аналитических конвейерах?
- Parquet и ORC - колоночные форматы, поддерживающие векторизацию и predicate pushdown, что существенно ускоряет чтение больших наборов данных. Они хорошо сочетаются с DataSource API Spark и обеспечивают эффективную аналитическую обработку.
- Как организовать мониторинг и диагностику в продакшн-окружении Spark?
- Использовать Spark UI и History Server для анализа этапов и задач; настраивать внешние метрики и логи для интеграции с системе мониторинга; собирать данные по времени выполнения, shuffle-операциям и памяти. Это позволяет выявлять узкие места и оперативно реагировать на изменения нагрузки.
- Какие практики следует применять для устойчивого продакшна в аналитических конвейерах?
- Определить целевые SLA и требования к задержке; применить динамическое выделение ресурсов и настройку памяти; использовать предикат-пушдаун и оптимизированные форматы данных; обеспечивать мониторинг и журналирование; тестировать конвейеры на разных сценариях данных и нагрузок.
- Какие примеры реализаций кластерных менеджеров поддерживает Spark?
- Standalone, YARN, Mesos и Kubernetes. Выбор менеджера зависит от инфраструктуры и требований к управлению ресурсами. Kubernetes часто применяется для гибкой оркестрации и масштабирования контейнеризованных приложений Spark.
- Каковы ключевые различия между RDD и DataFrame/Dataset API?
- RDD предоставляет низкоуровневый контроль над обработкой, но требует больше ручной оптимизации и не обеспечивает автоматическую оптимизацию. DataFrame/Dataset - высокоуровневый интерфейс с встроенной оптимизацией через Catalyst и удобными API, что обычно приводит к лучшей производительности и простоте поддержки.
- Что важно помнить при интеграции Spark в аналитическое хранилище?
- Важно организовать конвейер вокруг DataSource API, обеспечить предикат-пушдаун, выбирать Columnar-форматы, настраивать планировщик и память, а также внедрять мониторинг и устойчивость к нагрузкам. Эффективное сочетание этих факторов обеспечивает предсказуемую производительность и гибкость аналитических конвейеров.


