

Тестирование и качество данных: unit-тесты, интеграционные тесты, Deequ, Great Expectations
Тестирование данных в контексте аналитических хранилищ на базе Apache Spark накладывает особые требования к методикам верификации не только корректности трансформаций, но и полноты, согласованности и пригодности данных к бизнес-контексту. Эффективная архитектура тестирования должна сочетать быстрые unit-тесты для отдельных трансформаций, надежные интеграционные тесты для пайплайнов и мощные инструменты проверки качества данных, такие как Deequ и Great Expectations, которые позволяют формализовать бизнес-ограничения и автоматически отслеживать их исполнение в рамках CI/CD и операционных процессов.
В этой главе рассматриваются архитектурные принципы построения тестирования данных в Spark, практики разработки unit- и интеграционных тестов, а также детально разбираются две ведущие технологии проверки качества данных - Deequ и Great Expectations. Предлагаются паттерны внедрения, способы интеграции с существующими пайплайнами и примеры реализации, ориентированные на реальные сценарии аналитического хранилища.
- Архитектура тестирования данных в Spark: уровни тестирования, контракты данных и схема данных для тестов.
- Практики unit-тестирования и интеграционных тестов: структуры тестов, мокирование данных, формирование репрезентативных тестовых наборов.
- Deequ: концепции анализа данных, валидации и автоматизации контроля качества на уровне Spark.
- Great Expectations: контрактное тестирование, интеграция с Spark DataFrame и оркестрация проверок.
- Интеграция тестов в пайплайны аналитического стека: CI/CD, мониторинг качества и управление данными.
- Практические сценарии: почему и как сочетать подходы для устойчивых аналитических хранилищ.
Архитектура тестирования данных в Spark
Методологически тестирование данных следует рассматривать как часть архитектуры аналитического стека. Применение тестового пирамидального подхода позволяет минимизировать стоимость исполнения тестов в производственных условиях, сохранив при этом высокую надежность поставляемого качества данных.
- Unit-тесты для трансформаций: тестируют конкретные функции и выражения, которые применяются к колонкам DataFrame, без зависимости от внешних источников данных.
- Интеграционные тесты для пайплайнов: проверяют набор преобразований в рамках одной ступени пайплайна, включая входные и выходные схемы, ожидаемые количества записей и распределение значений.
- End-to-end тесты: симулируют реальный поток данных от индикации входа до загрузки в аналитическое хранилище, обеспечивая корректность всего конвейера.
- Контракты и качество данных: бизнес-ограничения в виде контрактов на полноту, уникальность, валидность значений и согласованность между полями, которые должны выполняться на этапе входа и на промежуточных стадиях пайплайна.
- Управление тестовыми данными: использование стабильных тестовых наборов, повторяемых генераторов данных и изоляции между тестами, чтобы не происходило «затирания» тестовой среды.
Ключевые принципы включают автономность каждого слоя тестирования, детерминированность тестовых данных и воспроизводимость результатов. Для Spark это означает выполнение тестов на локальном кластере или в контейнеризированной среде с минимальной конфигурацией, параллельной обработкой и портированием на продакшн-окружение через переносимые конфигурации.
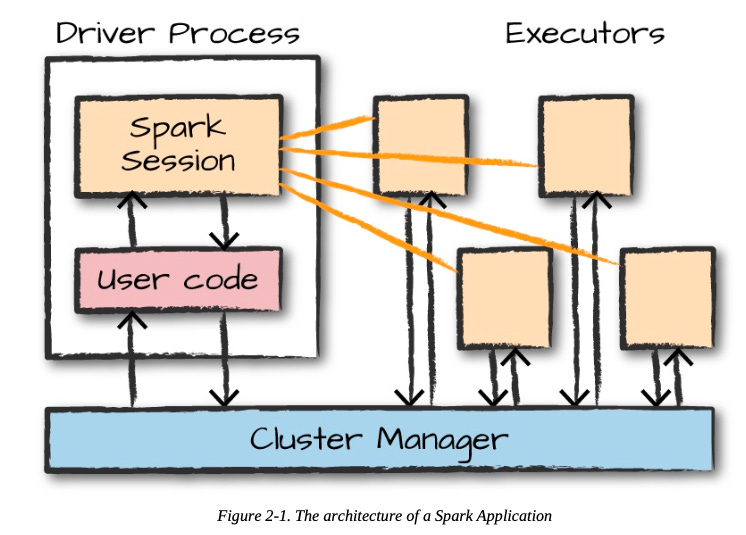
Unit-тесты и интеграционные тесты для Spark
Unit-тестирование в Spark-экосистеме ориентировано на трансформации и функции, которые применяются к DataFrame. Основная идея - изолировать логику и проверить её на стабильной маленькой выборке с детерминированными данными. Интеграционные тесты расширяют рамки unit-тестов и охватывают взаимодействия между несколькими стадиями пайплайна, включая чтение/запись в хранилище, взаимодействие с внешними системами и корректность синхронности данных.
- Инструменты и окружение: для Python-пайплайнов часто применяют pytest вместе со SparkSession, для Java/Scala - стандартные тестовые фреймворки JUnit/ScalaTest. Важно обеспечить повторяемость тестового окружения: фиксированные версии Spark, зависимостей и тестовых данных.
- Стратегии: тестирование обычно начинается с функций, которые выполняют бизнес-логики на уровне колонок и выражений (например, преобразование форматов, агрегации, условия отбора). Затем переходят к тестированию шага трансформации целиком (проверка DataFrame на уровне схемы, типов и ограничений).
- Генерация тестовых данных: создаются DataFrame с детерминированными наборами значений, фиксируются seed-значения и используют минимальные, но репрезентативные примеры данных, чтобы проверить поведение функций в крайних случаях (пустые значения, дубликаты, неверные типы данных).
Пример: unit-тест на PySpark с использованием pytest
from pyspark.sql import SparkSession

def test_uppercase_transformation():
    spark = SparkSession.builder.master("local[*]").appName("unit-test").getOrCreate()
    input_df = spark.createDataFrame([("alice",), ("bob",)], ["name"])
    transformed = input_df.selectExpr("upper(name) as name_upper")

    rows = transformed.collect()
    assert rows[0]["name_upper"] == "ALICE"
    assert rows[1]["name_upper"] == "BOB"

    spark.stop()
Пример: интеграционный тест последовательности трансформаций
from pyspark.sql import SparkSession

def test_pipeline_sequence():
    spark = SparkSession.builder.master("local[*]").appName("integration-test").getOrCreate()
    df_in = spark.createDataFrame([(1, "a"), (2, None), (3, "c")], ["id", "val"])
    ## Шаг 1: очистка пропусков
    df_clean = df_in.dropna(subset=["val"])
    ## Шаг 2: преобразование
    df_out = df_clean.withColumn("val_len", F.length(df_clean["val"]))

    assert df_out.count() == 2
    assert "val_len" in df_out.columns

    spark.stop()
Поддержка повторяемости тестов достигается за счет использования фикстур в тестовом фреймворке, которые инициализируют SparkSession единообразно для набора тестов и освобождают ресурсы после завершения. В продакшен-проектах целесообразно извлекать общие утилиты: генераторы тестовых данных, фабрики DataFrame, инструменты для чистки и аннулирования временных данных.
Deequ: автоматизация проверки качества данных
Deequ представляет собой библиотеку, разработанную для автоматического анализа качества данных в Spark и создания контрактов. Она позволяет формализовать требования к данным через набор анализаторов и ограничений (constraints), а также агрегировать результаты проверки в единый отчет. Архитектурно Deequ выполняется локально на Spark-драйвере, анализируя DataFrame с помощью анализа и верификации, что особенно полезно на этапе загрузки и индуктивной проверки данных в слое детального качества.
- Анализаторы (Analyzers): оценивают различные аспекты данных, такие как полнота, уникальность, схемность, диапазон значений и распределения.
- Верификационные проверки (Checks): объединение набора ограничений, создаваемых для конкретной таблицы или полей.
- VerificationSuite: конфигурация набора проверок и запуск на данных, с выдачей состояния (Success, Warning, Failed) и детализированными результатами.
Пример минимального использования Deequ на Scala
/* Пример упрощенный и иллюстративный */
import com.amazon.deequ.VerificationResult
import com.amazon.deequ.VerificationSuite
import com.amazon.deequ.checks.Check
import org.apache.spark.sql.SparkSession

val spark = SparkSession.builder().appName("deequ-example").getOrCreate()
import spark.implicits._
val df = Seq((1, "A"), (2, null), (3, "C")).toDF("id", "value")

val check = Check(CheckLevel.Error, "Data quality checks")
  .isComplete("value")
  .isUnique("id")

val result: VerificationResult = VerificationSuite()
  .onData(df)
  .addCheck(check)
  .run()

println(result.status) // Success/Failure
Достоинства Deequ заключаются в том, что можно задавать контракты на этапе загрузки и встраивать проверки прямо в пайплайны Spark-процессинга. Однако Deequ больше ориентирован на JVM-экосистему и Scala/Java. В случае потребности в Python-экосистеме можно использовать PyDeequ - Python-обертку над Deequ, которая позволяет интегрировать в PySpark-пайплайны аналогичные проверки с сохранением результатов.
- Когда использовать Deequ: когда требуется детализированная статистика качества, аналитика по столбцам и строгая верификация контрактов на стадии загрузки или пост-обработки.
- Ограничения: прямые реализации на Python чаще требуют оберток или межъязыковых мостов; сложная интеграция в уже существующие пайплайны может потребовать дополнительных слоев абстракций.
Great Expectations: гибкая валидность данных для Spark
Great Expectations (GE) предоставляет контрактно-ориентированную модель тестирования данных, позволяя разработчикам задавать ожидания относительно структуры и значений данных и затем автоматически валидировать данные в пайплайнах Spark. GE поддерживает работу с DataContext, набор проектов и интегрируется с различными хранилищами артефактов, что облегчает мониторинг качества данных и создание читаемой документации по данным (Data Docs).
- Архитектура GE: DataContext хранит набор конфигураций и путей к данным, Expectation Suites содержат набор ожиданий, которые применяются к конкретным наборам данных, результаты валидации сохраняются в журнал и могут быть опубликованы в виде документации.
- Примеры ожиданий: существование столбца, типы значений, диапазоны значений, уникальность и периодические зависимости между столбцами.
- Интеграция с Spark: GE может читать данные как Spark DataFrame, применять ожидания через SparkDataFrameAdapter и возвращать результаты в формате, пригодном для мониторинга и уведомлений.
Python-пример, демонстрирующий базовую интеграцию GE с Spark
from pyspark.sql import SparkSession
from great_expectations.dataset import SparkDFDataset

spark = SparkSession.builder.master("local[*]").getOrCreate()
df = spark.createDataFrame([(1, "Alice"), (2, "Bob"), (3, None)], ["id", "name"])

class MyGE(SparkDFDataset):
    pass

ge_df = MyGE(df)
ge_df.expect_column_to_exist("id")
ge_df.expect_column_values_to_be_of_type("id", "integer")
ge_df.expect_column_values_to_be_non_null("name")

validation = ge_df.validate()
print("Validation success:", validation["success"])
print("Details:", validation["results"])
Для производственных пайплайнов GE обычно интегрируется через этапы конвейера, где значения ожиданий формируются в рамках Expectation Suites и валидируются над частями данных в рамках тестов и в процессе загрузки в хранилище. GE обеспечивает возможность ведения контрактов в живой документированной форме и упрощает сообщаемость между данными и бизнес-заинтересованными лицами.
- Выбор между Deequ и GE: Deequ хорошо подходит для детальных оценок качества на уровне столбцов и наборов метрик, когда влияние данных измеряется на уровне Spark-анализов. GE же удобен для контрактного тестирования, документирования и мониторинга качества данных через понятные ожидания и Data Docs.
- Комбинирование подходов: многие проекты используют Deequ для быстрых локальных проверок на стадии загрузки и GE - для контрактов, мониторинга и документирования качества в дашбордах.
Интеграция в пайплайны аналитического хранилища
Эффективная система тестирования не ограничивается единичнами тестами внутри отдельных задач Spark. Необходимость интеграции тестов в CI/CD, оркестрацию пайплайнов и мониторинг качества данных становится критичной для устойчивости аналитического стека.
- CI/CD: тесты должны выполняться на каждом коммите и в пайплайне сборки. Включение unit- и интеграционных тестов в пайплайны обеспечивает раннюю фиксацию ошибок и возможность локализации дефектов до продакшн. В случае неудачи тестов пайплайн должен останавливаться, а результаты - регистрироваться в системе мониторинга.
- Контракты по данным: внедрение контрактов на уровне входа в Data Lake/ warehouse помогает предотвратить загрузку некорректных данных. Контракты в виде ожиданий GE или ограничений Deequ могут служить воротами: данные с нарушениями не проходят в целевые хранилища.
- Мониторинг и аудит: сохранение результатов проверок, создание дашбордов и отчётов по качеству данных, хранение истории изменений и версий ограничений позволяют отслеживать динамику качества данных и быстро реагировать на инциденты.
- Управление тестовыми данными: создание задач по генерации тестовых наборов данных, поддержка версионирования и повторного воспроизведения тестов, а также обеспечение изоляции между средами (dev, test, prod) - ключ к устойчивой практике.
Интеграционные паттерны включают: запуск тестов на этапе сборки, интеграцию с инструментами оркестрации (например, Apache Airflow) для автоматического выполнения тестов при смене данных, и хранение артефактов тестирования (логов, отчетов GE/Deequ) в корпоративном артефакт-репозитории.
Практические сценарии реализации
- Сценарий 1: загрузка данных через файловый источник с проверкой качества на входе.
- unit-тесты для функций трансформаций входных файлов.
- Deequ-аналитика на стадии загрузки, чтобы проверить полноту и уникальность ключевых столбцов.
- GE-правила для контрактов на поля и распределения значений, с выводом Data Docs.
- Сценарий 2: преобразование данных в витрине.
- модульные тесты отдельных трансформаций.
- интеграционные тесты для конвейера преобразований, проверки схем и размеров.
- мониторинг результатов тестов через CI/CD и дашборды качества.
- Сценарий 3: end-to-end тестирование пайплайна.
- эмуляция реального потока данных, включая загрузку в аналитическое хранилище.
- проверка целостности данных и соответствия контрактам через Deequ и GE.
- регламентированные проверки на продакшн окружении с использованием Data Docs и отчётов.
Эти сценарии подчеркивают необходимость балансирования между скоростью разработки и качеством данных. Архитектура тестирования должна обеспечивать быструю проверку изменений, минимизируя риск регрессий в аналитической системе.
Key takeaways
- Тестирование данных в Spark должно быть структурировано по пирамиде: unit, интеграционные и end-to-end тесты, дополняемые контрактами качества.
- Deequ обеспечивает детальный анализ и контрактную верификацию на уровне Spark-данных, что особенно полезно на стадиях загрузки и обработки.
- Great Expectations фокусируется на контрактном тестировании, документации и мониторинге качества, полезен для прозрачности и прозрачной коммуникации бизнес-ограничений.
- Интеграция тестов в CI/CD и мониторинг результатов устойчиво повышает качество данных в аналитических хранилищах и ускоряет доставку данных бизнес-пользователям.
- В реальных пайплайнах целесообразно сочетать подходы: Deequ для быстрых и точных проверок в трансформациях и GE для контрактного тестирования и мониторинга.
- Важную роль играет управление тестовыми данными: создание детерминированных тестовых наборов, изоляция окружений и повторяемость тестов.
- Архитектура тестирования должна быть тесно связана с политиками управления данными, включая контракты, аудит изменений и возможность восстановления после сбоев.
FAQ
- Что такое контракт в контексте тестирования данных и зачем он нужен?
Контракт в тестировании данных - это формализованное соглашение между источниками данных и потребителями, описывающее ожидаемые свойства данных: структуру схемы, допустимые диапазоны значений, уникальность ключей и т. п. Контракты позволяют автоматически валидировать данные на входе и в ходе пайплайна, предотвращая загрузку некорректных данных и упрощая аудит качества.
- В чем разница между Deequ и Great Expectations и когда предпочтительнее использовать каждую из технологий?
Deequ ориентирован на анализ и проверку качества на уровне Spark DataFrame с детальной статистикой по столбцам и набору ограничений; он хорошо подходит для автоматической регламентированной проверки при загрузке и пост-обработке. Great Expectations - более гибкая платформа контрактного тестирования, ориентированная на создание понятной документации по данным (Data Docs) и мониторинг качества в рамках бизнес-логики. В реальных проектах часто используют оба инструмента: Deequ для быстрого и структурированного анализа, GE - для контрактов, мониторинга и коммуникации с бизнес-пользователями.
- Какие архитектурные паттерны применяются для тестирования Spark-пайплайнов?
Рекомендуется использовать пирамидальный подход: unit-тесты для функций трансформаций, интеграционные тесты для цепочек преобразований, end-to-end тесты для всего пайплайна. Включайте контракты на входных данных и на промежуточных стадиях, применяйте фикстуры для воспроизводимости тестов, и организуйте тестовые данные так, чтобы они не влияли на продакшн-среду.
- Какой подход выбрать для CI/CD и почему?
Необходимо интегрировать тесты в конвейер сборки: запуск unit- и интеграционных тестов на каждом коммите, а также ограниченно выполнять end-to-end тесты в рамках ночного цикла или выборочно по расписанию. Валидации на уровне данных должны блокировать продакшн-выгрузку до тех пор, пока данные не проходят контракты и правила качества.
- Какие реальные сложности возникают при внедрении тестирования данных в больших данных?
Основные сложности: масштабируемость тестов (эффективное выполнение больших наборов тестов), создание детерминированных тестовых данных в условиях большого объема данных, совместимость между версиями инструментов (Deequ, GE, Spark) и интеграция с существующими пайплайнами и оркестраторами. Решения включают использование локального тестового окружения для unit-тестов, фикстуры и генераторы данных, а также инфраструктурную политику по управлению зависимостями и совместимостями версий.
- Могут ли тесты остановить загрузку данных в продакшн-систему?
Да. При корректном проектировании тестов, особенно контрактов на входе данных и проверок качества, нарушения могут приводить к остановке загрузки (gate-keeping) до устранения проблем. Это обеспечивает высокую надёжность данных в аналитическом хранилище, однако требует хорошо продуманной политики обработки ошибок и уведомлений.
- Как выбирать между локальным тестированием и тестированием в кластере Spark?
Локальное тестирование обеспечивает быструю итерацию и детерминированные результаты, подходящее для unit и небольших интеграционных тестов. Тестирование в кластере необходимо для реальной оценки поведения при больших объемах данных, сложной конфигурации и для тестирования взаимодействия с внешними системами. Обычно используют гибридный подход: локальные тесты для разработки и ранних проверок, кластерные тесты - для финальной проверки в условиях приближенных к продакшн.
- Как документировать результаты тестов и отслеживать качество данных?
Необходимо сохранять логи выполнения тестов, результаты GE и Deequ, а также состояние контрактов. Визуализация в виде дашбордов и Data Docs GE, журналы тестов и уведомления в системы оповещений позволяют быстро выявлять тенденции и регрессии. В идеальном случае результаты сохраняются в централизованном репозитории артефактов и связываются с изменениями кода и данными.
- Какие примеры практических паттернов можно перенести в реальный проект?
- Ввод строгих контрактов на входе данных через GE для основных источников.
- Добавление анализаторов и ограничений Deequ на стадии загрузки для быстрой ранней идентификации проблем.
- Интеграция тестирования данных в CI/CD с фиксацией версий тестовых данных и повторяемостью окружения.
- Мониторинг качества данных в продакшн через Data Docs и регулярные отчеты.
- Как обеспечить баланс между скоростью разработки и качеством данных?
Ключевым является правильное распределение тестов по слоям, автономность тестирования и изоляция окружений, понятные контракты и автоматическая регламентная проверка. Делая тестовую среду предсказуемой и воспроизводимой, можно сохранить скорость разработки без ущерба для качества данных в аналитическом хранилище.
Эта глава охватывает не только теоретические принципы, но и практические подходы к внедрению тестирования и контроля качества данных в рамках Spark-пайплайнов для аналитческих хранилищ. В сочетании Deequ и Great Expectations формируются мощные механизмы контроля: Deequ обеспечивает автоматическую статистическую верификацию и строгие контракты, GE - документируемый, мониторируемый и бизнес-дружественный уровень проверки.
Если вы планируете внедрять подобную систему в реальном проекте, начните с определения бизнес-контрактов на входе и в промежуточных стадиях данных, затем настройте CI/CD для автоматического выполнения тестов и мониторинга результатов. Постепенно расширяйте покрытие unit- и интеграционных тестов, добавляйте end-to-end проверки и обеспечьте согласованность между тестами и демонстрацией качества через документацию GE Data Docs. Такой подход позволит обеспечить устойчивость аналитического стека, снизить риск ошибок данных и повысить доверие к аналитическим результатам.


