

Логи изменений и транзакционные границы: как Debezium детектирует и транслирует изменения
Изменения в бизнес-данных происходят в транзакциях, где несколько операций могут быть закодированы в рамках одного логического или физических изменений. Debezium, реализуя Change Data Capture на основе логов изменений, обеспечивает точную и упорядоченную потоковую передачу этих изменений в инфраструктуру данных. В этой главе рассматриваются принципы детекции логов изменений, механизм формирования границ транзакций и способы транслирования изменений в виде событий в потоках, пригодных для потребления аналитическими приложениями и хранилищами данных.
Краткое введение
Debezium опирается на принцип log-based CDC: мониторинг и обработка записей лога изменений базы данных до того, как они применяются в собственном репозитории приложений. Это позволяет получить минимальную задержку, сохранить порядок изменений внутри транзакций и обеспечить детерминированность разнотипных операций (insert, update, delete). Однако реальное соответствие между множеством изменений внутри одной транзакции и их последовательной передачи в поток требует внимательной работы с механизмами транзакционных границ, верификацией консистентности данных и корректной интерпретацией событий на стороне потребителя. Глава углубляется в архитектуру Debezium, форматы событий, алгоритмы детекции границ транзакций для различных СУБД и практические решения по конфигурации и мониторингу.
- Архитектура Debezium как основа детекции изменений и формирования событий.
- Алгоритмы определения границ транзакций на примере основных СУБД (MySQL, PostgreSQL, SQL Server, Oracle, MongoDB).
- Форматы сообщений Debezium: как читаются, сериализуются и интерпретируются поля before/after, op, source, ts_ms и транзакционные маркеры.
- Практические аспекты интеграции: управление оффсетами, история схем, гарантий доставки и обработка ошибок.
Краткое содержание главы
- Принципы лог-ориентированного CDC и роль транзакционных границ в Debezium.
- Архитектура Debezium и структура событий: connectors, источники, история схем и потоки данных.
- Детекция транзакций для основных СУБД: MySQL, PostgreSQL, SQL Server, Oracle, MongoDB.
- Управление изменениями схемы данных и обработка DDL-операций.
- Практические настройки и режимы эксплуатации: оффсеты, гарантийность, мониторинг и диагностика.
- Взаимодействие потребителей и обеспечение идемпотентности на потребительском уровне.
Архитектура Debezium и модель данных
Debezium реализуется как набор коннекторов в составе Kafka Connect, ориентированных на конкретные источники данных: MySQL, PostgreSQL, SQL Server, Oracle, MongoDB и др. Каждый коннектор действует как агент чтения лога изменений соответствующей СУБД и публикует события в Kafka в виде структурированных сообщений. Основные компоненты архитектуры:
- Коннектор источника (Source Connector): подключение к базе, чтение лога изменений и преобразование его в унифицированную схему Debezium.
- Преобразователь и обрамление событий (Envelope): каждое изменение оборачивается в сообщение, содержащее поля before/after, op и source, а также дополнительную метаинформацию.
- История схем (Schema History): хранение информации о эволюции схемы для корректной десериализации изменений после DDL-событий.
- Хранилище оффсетов (Offsets): хранение позиции чтения лога, чтобы обеспечить повторное чтение после сбоев и стойкость.
- Потоки и потребители (Topics): каждое изменение публикуется в Kafka-topic, организованный по таблицам и базам данных, с поддержкой ключей на уровне первичного ключа.
Структура типичного события Debezium включает поля, позволяющие реконструировать последовательность изменений и границы транзакций. В упрощённой форме событие содержит:
-
before и after: снимки строк до и после изменений.
-
op: операция изменения (c - create/insert, u - update, d - delete, r - read/unknown для некоторых источников).
-
source: контекст источника (база, таблица, версия коннектора, временные метки, идентификаторы транзакции и пр.).
-
ts_ms: временная метка опубликования события.
-
транзакционные маркеры: идентификатор транзакции и/или Commit-метки, позволяющие агрегировать события внутри одной транзакции.
{
  "schema": { "type": "struct", "fields": [...] },
  "payload": {
    "before": { "id": 101, "name": "Иван", "balance": 200 },
    "after":  { "id": 101, "name": "Иван", "balance": 250 },
    "source": {
      "version": "1.8.0.Final",
      "name": "dbserver1",
      "db": "payments",
      "table": "accounts",
      "ts_ms": 1617973123000,
      "xid": 34567,
      "txn_commit": true
    },
    "op": "u",
    "ts_ms": 1617973123010
  }
}
Этот упрощённый пример иллюстрирует, как данные могут быть переданы потребителю: операция обновления, поля before/after демонстрируют изменение значения, а объект source содержит контекст и идентификатор транзакции. Реальная структура событий может различаться между коннекторами и версиями Debezium, но базовые принципы остаются одинаковыми: сохранение последовательности операций внутри транзакции и корректная реконструкция состояния по ключу.
-
Kafka Connect как инфраструктура обмена сообщениями и управление состоянием оффсетов.
-
Schema History как механизм адаптации к DDL без потери воспроизводимости изменений.
-
Транзакционные маркеры внутри источников и их влияние на гарантии доставки.
Глубоко в архитектуру важно погружаться с акцентом на то, как Debezium обеспечивает согласованность между несколькими изменениями внутри одной транзакции и темпом потока в общем паблишинг-пуш. В частности, понимание того, как Debezium распознаёт границы транзакций и как эти границы отображаются в выходных сообщениях, критично для проектирования консьюмеров и обеспечения целостности данных на фоне сбоев и рестартов.
Детекция транзакционных границ в логах изменений
Детекция транзакционных границ - ключевой элемент обеспечения консистентной потоковой репликации. В Debezium границы транзакций определяются через механизмы конкретной СУБД и встроенные в лог изменений сигналы о начале и завершении транзакций. Рассмотрим основные подходы на примерах наиболее распространённых платформ.
-
MySQL (binlog): Debezium читает бинарный лог (binlog). В MySQL транзакции помечаются через сигнальные события, такие как Xid и GTID. Debezium группирует изменения, относящиеся к одной транзакции, по идентификатору транзакции и времени коммита, чтобы затем выпустить единый набор изменений, относящийся к этой транзакции. Это позволяет потребителю увидеть консистентную последовательность операций, происходивших в рамках одного коммита.
-
PostgreSQL (WAL с логическим декодированием): здесь используется логическое декодирование WAL через плагины вроде pgoutput или wal2json. В этом режиме каждый коммит транзакции сопровождается метаданными, в которых зафиксирован идентификатор транзакции (xid) и commit_time. Debezium агрегирует события в рамках одного xid и публикует их в соответствующем порядке. При этом DDL-операции, которые меняют схему, также отражаются в Schema History и могут сопровождать транзакцию, в зависимости от реализации плагина.
-
SQL Server (loga-ридер): системный журнал SQL Server читает операции и их комбинации в рамках транзакций. Debezium принимает события логирования, группирует их по транзакции, часто опираясь на commit LSN или аналогичные маркеры, и выдаёт изменённые строки вместе с контекстом транзакции. Это обеспечивает согласованность на уровне транзакции, даже если в рамках одной транзакции происходят множество операций.
-
Oracle (redo/archived redo logs): Debezium может использовать красные логи и зарядку изменений через фильтры изменений. В случае Oracle для определения границ транзакции применяются сигналы commit и rollback, которые агрегируют изменения в рамках одной транзакции и публикуются как единый набор событий по завершении транзакции.
-
MongoDB (oplog): для MongoDB, особенно при использовании реплики через oplog, Debezium считает границы транзакций по операции oplog в контексте multi-document transactions, поддерживаемых с версии MongoDB 4.x. Здесь Debezium группирует события внутри одной транзакции и публикует их в рамках одного набора изменений.
Эти принципы важны не только для корректной передачи данных, но и для корректной работы инсайдера потоков обработки, который делает выводы о целостности, уверенности в последовательности и синхронизации между источниками и целями. В реальной эксплуатации различия между СУБД по деталям реализации транзакционных границ приводят к необходимости настройки специфических параметров коннектора и аккуратного подхода к потребителям, которые должны обрабатывать события в нужной последовательности.
- Важно помнить: Debezium может выпускать как отдельные события по каждой строке, так и группировать их в рамках транзакций, если соответствующая транзакционная метаинформация доступна и корректно интерпретируется коннектором.
- Порядок внутри транзакции сохраняется в рамках одного партитона и обеспечивает воспроизводимость изменений даже в условиях повторной публикации событий в случае сбоев.
- В зависимости от СУБД и конфигурации, события с DDL могут идти в отдельном потоке или вместе с данными транзакции, что влияет на решение по обработке схемы потребителем.
Практическое значение этих механизмов заключается в возможности строить идемпотентные консьюмеры и корректные гид-слои на базе Kafka Streams, Spark или собственных пайплайнов. Важно также учитывать особенности гарантий доставки: Debezium обычно обеспечивает at-least-once семантику на уровне самих изменений, поэтому потребителю следует реализовать повторную идемпотентную обработку или использовать ключи на уровне первичного ключа для корректной агрегации и обновления целевых систем.
Управление схемой изменений и история DDL
Динамическая эволюция схемы базы данных требует, чтобы потребители изменений сохраняли корректную десериализацию при изменениях столбцов, типов данных или добавлении/delition таблиц. Debezium решает эту задачу двумя взаимодополняющими механизмами:
- Schema History: локальная и/или централизованная история схем, обычно хранится в специальной теме Kafka (dbhistory.topic) или в файле, чтобы коннектор мог корректно интерпретировать поля before/after и типы данных даже после изменений в схеме.
- DDL-операции: когда база данных выполняет DDL-команды, Debezium публикует события, которые отражают новую схему. Эти события позволяют потребителям обновлять свои внутренние структуры и корректно обрабатывать последующие CHANGE-операции.
Эти механизмы позволяют снизить риск рассинхронизации между источниками и потребителями, особенно в сценариях долгосрочного потока изменений, когда схема может меняться в течение жизни приложения. В продакшн-сценариях Schema History особенно важна для ETL-процессов и консолидированных хранилищ данных, где любая несогласованность между структурой записей и их обработкой может привести к некорректной агрегации и потере данных.
- При проектировании архитектуры CDC-слоя полезно включать стратегию управления схемами: включение/исключение полей, контроль версий и тестирование на развёртываниях с миграциями.
- Некоторые коннекторы поддерживают автоматическую настройку преобразований схемы на стороне потребителя (например, через конструирование схемы в Kafka Connect); другие требуют явной адаптации потребителя к новой карте полей.
{
  "schema": { "type": "struct", "fields": [ { "name": "id", "type": "int32" }, { "name": "name", "type": "string" } , { "name": "balance", "type": "int32" } ] },
  "payload": {
    "before": null,
    "after": { "id": 102, "name": "Мария", "balance": 1000 },
    "source": { "db": "payments", "table": "accounts", "txId": 78910, "ts_ms": 1620000000000 },
    "op": "c",
    "ts_ms": 1620000000100
  }
}
Этот пример демонстрирует сценарий добавления новой записи с обновлением схемы в процессе изменений: после добавления таблицы/колонки или изменения типа данных, Schema History обеспечивает корректную адаптацию консьюмеров к новой карте полей. В реальном мире DDL-операции могут сопровождаться специализированными событиями в Kafka и потребовать отдельной логики их обработки.
Интеграция и форматы сообщений: правила и протоколы
-
Протокол передачи: Debezium публикует события в Kafka с использованием стандартной сериализации (обычно JSON) или Avro/Envelope-форматов через конвертеры. Формат сообщений фиксирован по смыслу: каждый change- event содержит Before/After, Op, Source и транзакционную информацию.
-
Уникальные ключи и идемпотентность: ключом события часто выступает составной ключ, основанный на первичном ключе записи. Это позволяет потребителям выполнять идемпотентную обработку и упрощает обновление целевых систем.
-
Гарантии доставки: Debezium как часть Kafka Connect, чаще всего реализует at-least-once delivery. Для критических сценариев рекомендуется строить идемпотентные потребители и устойчивые к повторным вставкам механизмы обработки.
-
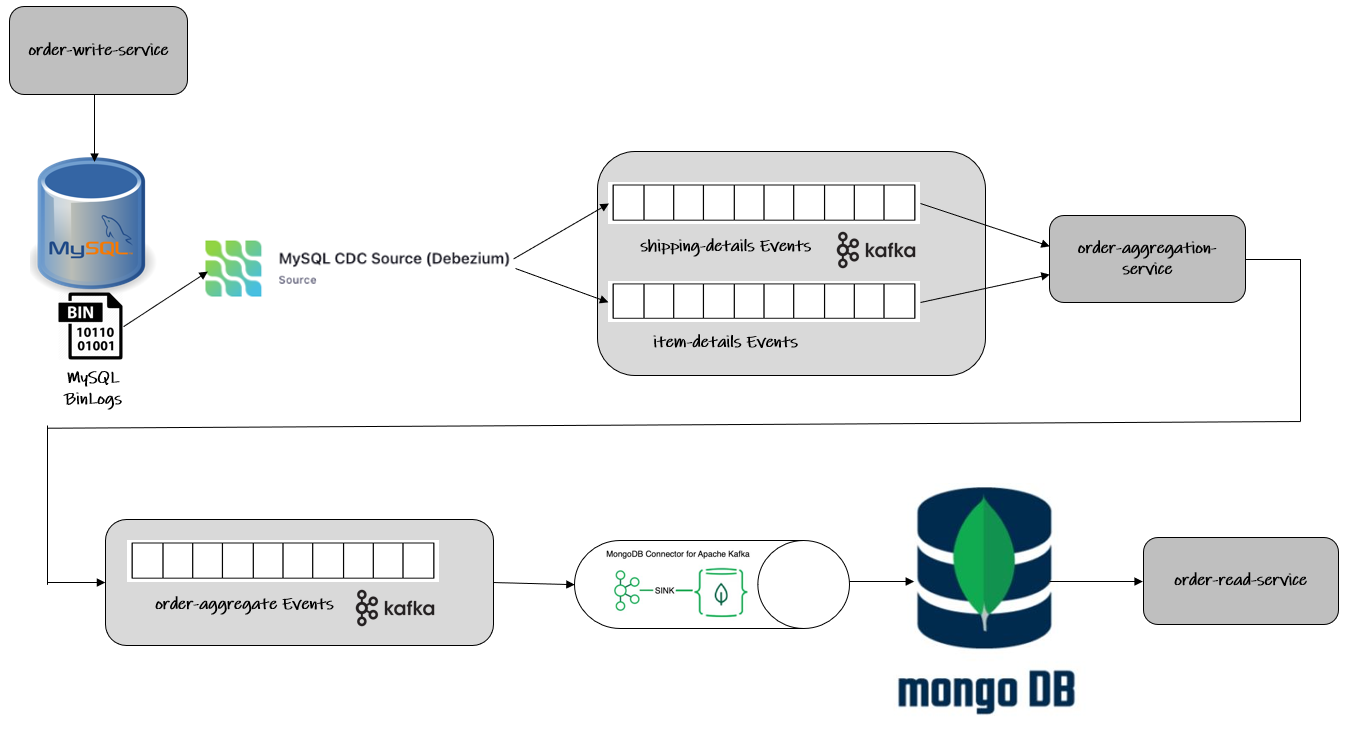
Роль потребителей: консьюмеры могут использовать данные для моментального инкрементного обновления аналитических моделей, загрузки данных в Data Lake, обмена событиями между микросервисами. Важной частью является корректная обработка транзакционных границ и сохранение консистентности данных.
-
Потребители должны учитывать возможность повторной обработки тех же самых изменений и правильно обрабатывать уникальные ключи, чтобы избежать дублирования записей.
-
В сценариях Stream-Processing важно соблюдать порядок изменений внутри транзакций и не полагаться на глобальный порядок между различными транзакциями без дополнительной логики синхронизации.
Практические настройки и сценарии внедрения
Внедрение Debezium требует внимания к конфигурации коннекторов, уровня консистентности и требований к задержке. Ниже приведены ключевые аспекты, которые стоит учесть при проектировании CDC-слоя.
-
Хранилище оффсетов и история схемы: настройка offset.storage.topic и database.history.kafka.bootstrap.servers обеспечивает устойчивость к сбоям и позволяет безопасно восстанавливать чтение после перезапуска коннектора. Для продакшн-сценариев рекомендуется использовать распределённое хранилище оффсетов и историю схем.
-
Репликация схем и обработка DDL: включение Schema History обеспечивает корректную десериализацию в связи с изменениями схем. В некоторых сценариях полезно изолировать DDL-операции в отдельном потоке или топике, чтобы потребители могли обновлять схемы независимо от данных транзакций.
-
Фильтрация и маршрутизация изменений: трансформации Kafka Connect позволяют фильтровать ненужные столбцы, переименовывать поля, маршрутизировать события по топикам и дополнительно обрамлять данные. Это облегчает последующую обработку на стороне потребителя и снижает сетевую нагрузку.
-
Мониторинг и диагностика: отслеживание задержек (latency), throughput, rejection rates и ошибок десериализации - критично для стабильной работы CDC-потока. Инструменты мониторинга Kafka, Connect и Debezium помогают быстро идентифицировать узкие места.
-
Важно тестировать коннектор в условиях близких к боевым: миграции схем, пиковые нагрузки лога изменений, задержки репликации и сбои узлов.
-
При выборе коннектора учитывайте особенности вашей СУБД, версию и доступность плагинов логического декодирования, уровни доступа и требования к SECURITY.
Мониторинг, производительность и операционные ограничения
Понимание ограничений и особенностей производительности CDC-потока позволяет обеспечить баланс между задержкой, пропускной способностью и консистентностью. Основные параметры and практики:
-
Задержка vs. пропускная способность: чем выше скорость чтения лога изменений и чем выше размер батча, тем ниже задержка, но рискует возрастать нагрузка на СУБД и сеть. Настройка batch.size, poll.interval, и throughput limits помогает найти компромисс.
-
Роль транзакционных границ в производительности: агрегация изменений внутри транзакций может добавлять небольшой накладной вес, но обеспечивает целостность. В ряде ситуаций можно ограничить глубину агрегации, чтобы повысить латентность, но это может повлиять на консистентность на стороне потребителя.
-
Мониторинг непрерывности: следите за индексами log-репликаций, Lag-метриками и уровнем ошибок. Оценка задержки между публикацией изменений и их потреблением позволяет принять решение о масштабировании коннекторов или переработке архитектуры.
-
Безопасность и доступ: настройте минимальные привилегии и разделение ролей на уровне коннектора, чтобы снизить риски утечки данных или злоупотребления доступом к логам изменений.
-
Введите стратегию аварийного восстановления: регламентируйте процесс восстановления оффсетов и схем после сбоев и обновлений.
-
Планируйте миграции: при обновлениях коннекторов и баз данных тестируйте совместимость форматов и поведения транзакций.
Key takeaways
- Debezium реализует CDC посредством чтения логов изменений СУБД и формирования унифицированных событий, сохраняющих контекст транзакции.
- Детекция границ транзакций основана на сигналах начала/окончания транзакций в логе изменений: это обеспечивает согласованность между операциями внутри одной транзакции и позволяет потребителям корректно реконструировать изменение состояния.
- Архитектура Debezium включает коннекторы, Schema History, оффсеты и публикацию событий в Kafka; каждый элемент играет роль в устойчивости и воспроизводимости потоков.
- Поддержка DDL через Schema History и событий DDL позволяет безопасно эволюционировать схемы без потери воспроизводимости изменений.
- Важны практические аспекты: правильная настройка оффсетов, маршрутизации изменений, идемпотентных потребителей и мониторинга операций CDC.
- Итоговая цель: обеспечить точную, упорядоченную и прозрачную потоковую репликацию изменений в реальном времени для аналитических и операционных потребителей.
FAQ
- Что такое Change Data Capture и зачем Debezium использует логи изменений?
- Change Data Capture - это подход к отслеживанию и извлечению изменений из базы данных. Debezium использует логи изменений, потому что они содержат все операции (insert/update/delete) в точном порядке, отражая фактические изменения данных, и позволяют минимизировать задержку по сравнению с триггерами или периодическим сканированием.
- Как Debezium обеспечивает согласованность изменений внутри транзакции?
- Согласованность достигается за счёт детекции границ транзакций в логе изменений. Debezium группирует изменения, относящиеся к одной транзакции, и публикует их как последовательность событий, связанных общим транзакционным идентификатором. Это позволяет потребителям видеть целостную картину изменений, происходивших в рамках одного коммита.
- Какие проблемы возникают при изменении схемы и как Debezium их решает?
- При изменении схемы структуру изменений нужно корректно десериализовать на стороне потребителя. Debezium хранит Schema History, чтобы помнить, как интерпретировать поля before/after и типы данных при эволюции схемы. DDL-операции публикуются в отдельном контексте, что позволяет потребителям адаптировать обработку к новой схеме без потери данных.
- Какие СУБД поддерживаются и чем они отличаются в части детекции транзакций?
- Основные поддерживаемые СУБД: MySQL, PostgreSQL, SQL Server, Oracle, MongoDB. Различия выражаются в сигналах начала/конца транзакции в логах изменений: binlog/Xid в MySQL, xid и commit_time в PostgreSQL, commit/Lsn в SQL Server, redo-logs в Oracle и oplog в MongoDB. Этим определяется способ агрегации изменений внутри одной транзакции и порядок их публикации.
- Как реализуется идемпотентность на стороне потребителя?
- Ключом сообщения часто является составной ключ, основанный на первичном ключе строки. Потребители должны обрабатывать повторные события корректно, используя upsert-логики или хранение последнего состояния, чтобы избежать дублирования. В некоторых сценариях полезно реализовать детерминированную обработку внутри оконной агрегации.
- Что значит exactly-once semantics в контексте Debezium и Kafka?
- Debezium и Kafka в целом обеспечивают на уровне доставки events at-least-once. Для достижения более строгой идемпотентности потребителям требуется дополнительная логика на стороне потребителя и/или использование совместимой конфигурации коннектора и топологий Kafka (идентификационные ключи, точные методы обработки повторных сообщений, правильная обработка ошибок).
- Какие настройки конфигурации критичны для корректности и производительности?
- Важные параметры: оффсеты (offset storage topic), история схемы (dbhistory topic), режим сериализации (JSON vs Avro), фильтрация полей, маршрутизация событий и управление автозагрузкой DDL-операций. Включение и настройка трансформаций Kafka Connect позволяет минимизировать объем передаваемой информации и адаптировать форматы под целевые системы.
- Каковы типовые сценарии внедрения Debezium в корпоративной среде?
- Типичные сценарии: миграция данных в Data Lake, непрерывная интеграция и загрузка в Data Warehouse, реальное время обновления кэш-слоёв, совместная обработка изменений между микросервисами. Важно обеспечить устойчивое хранение оффсетов, корректную обработку DDL и согласованный порядок событий между различными коннекторами.
- Какие ограничения стоит учитывать при выборе коннектора?
- Выбор зависит от СУБД, версии, доступности плагинов логического декодирования, требований к последовательности и скорости, уровня привилегий и инфраструктуры. Некоторые СУБД требуют дополнительных плагинов или настроек репликации, что может влиять на сложность развёртывания и поддержку.
- Какие шаги помогут минимизировать риски при эксплуатации CDC-потока?
- Прежде всего, тестирование в условиях близких к продакшн: миграции, пиковые нагрузки, сбои. Важно обеспечить корректное управление схемами, стабильность оффсетов, идемпотентность потребителей и мониторинг задержек. Также полезно определить границы согласованности и поставить оповещения на критические события (DDL, транзакционная задержка, ошибки десериализации).
Эта глава охватывает ключевые аспекты детекции изменений и транзакционных границ Debezium в контексте потоковой репликации в реальном времени. В следующих главах можно углубиться в специфику конкретных коннекторов (MySQL, PostgreSQL, MongoDB) и привести детальные руководства по конфигурациям, оптимизациям и стратегиям тестирования.


