

Хранилище данных и дата-слои: data lake, data warehouse, слои стандартизации
Глава раскрывает архитектуру дата-слоев вокруг процессов формирования и оценки метрик прогноза спроса. Речь идёт о том, как данные проходят путь от первичных источников до готовых для анализа и принятия решений метрик MAPE, Bias и Forecast Accuracy, и почему выбор моделей хранения данных влияет на воспроизводимость, точность и интерпретацию результатов.
Эффективная работа с метриками требует исчерпывающего контекстного наполнения: корректные временные ряды, согласованные измерения по продуктам и регионам, единицы измерения и календарные константы. Именно дата-слои определяют, какие именно данные будут считаться в расчётах, как будут обрезаться пропуски, как будут обрабатываться аномалии и как будет обеспечена повторяемость расчётов на разных версиях моделей и наборов данных.
- Краткое содержание главы
- Архитектура дата-слоев и роль data lake, data warehouse и слоёв стандартизации
- Источники данных для расчётов метрик и требования к качеству
- Интеграция вычислений метрик в конвейеры данных: ETL/ELT, контроль версий и воспроизводимость
- Интерпретация метрик в контексте структуры данных и бизнес-сценариев
- Управление качеством, регламентами и аудитом метрик
Архитектура дата-слоев и роль data lake, data warehouse и слоёв стандартизации
Современная архитектура прогнозирования спроса основывается на трёх взаимодополняющих слоях: data lake (или data lakehouse в рамках единого концепта), data warehouse и слои стандартизации данных. Каждый из них выполняет специфическую роль в цепочке подготовки метрик.
Data lake служит распаханной площадкой для первоначального сбора больших объёмов данных из разных источников: POS-терминалы, ERP-системы, веб-аналитика, внешние очереди спроса, запасы и цены, календарные признаки и т. п. Здесь хранятся как структурированные, так и неструктурированные данные в их «сырых» представлениях. Преимущество такого слоя - гибкость и масштабируемость, возможность быстро добавлять новые источники. Главный риск - отсутствие единых конвенций качества, неоднозначности смысловых полей и проблемы с управлением данными в дальнейшем.
Data warehouse выступает средством для организации данных в структурированные, интегрированные и управляемые коллекции, оптимизированные под аналитические запросы и расчёты метрик. В этом слое применяются схемы звезды или снеговика, уделяется внимание качеству данных, консистентности измерений и времени. Преимущества: высокая скорость агрегаций, целостность и строгая типизация, поддержка сложных аналитических операций. Риск - дороговизна изменений схем и менее гибкие механизмы подстраивания под новые источники без сопровождения.
Слои стандартизации данных - промежуточный и критически важный элемент, который связывает «сырьё» data lake и структурированную плоскость data warehouse. Они включают стадии raw/staging, curated и gold (или trusted), а также работу с метаданными, качеством данных и управлением версиями. В рамках этих слоёв обеспечиваются единые единицы измерения, единицы времени, согласование единиц валют, кодов регионов, продуктовых идентификаторов и согласование календарей (рабочие/грешки, праздники, сезонности). Именно здесь закладываются принципы валидности расчётов: пропуски в данных, ноль в реальных измерениях, противоречивость между системами - всё приводится к теле- или семантическим константам.
Таблица
- Обзор слоёв дата-слоев и ключевых функций
| Слой | Основная функция | Преимущества | Вызовы |
|---|---|---|---|
| Data Lake | Хранение исходных данных из различных источников, в том числе структурированных и неструктурированных | Гибкость, масштабируемость, быстрый вход новых источников | Управление качеством, отсутствие единых контрактов на данные, риск «шпильки» содержания |
| Data Warehouse | Интегрированные, очищенные и структурированные данные для аналитики | Быстрые OLAP-запросы, консистентность, поддержка бизнес-логики | Изменение схемы, дороговизна миграций, ограниченная гибкость |
| Слои стандартизации | Нормализация и конвергенция данных: raw → curated → gold | Единые стандарты, воспроизводимость расчётов, качественные трансформации | Комплексность управления схемами, задержки в цепочке изменений |
Понимание различий и функций этих слоёв критично для корректной интерпретации метрик. В контексте прогноза спроса, данные протекают через этапы: сбор и нормализация событий продаж, привязка к календарям и регулировка по единицам измерения, объединение по продукту, месту продажи и другим измерениям. Затем данные подготавливаются для расчёта метрик и хранения их в «метриковом» измерении, чтобы обеспечить повторяемость на протяжении времени и между командами.
Роли архитектурных решений в расчётах MAPE, Bias и Forecast Accuracy особенно важны. Например, выбор использования schema-on-read в data lake может снизить время входа данных в расчёт на старте проекта, но потребует строгого слоя стандартизации на верхнем уровне для корректного сопоставления фактов. С другой стороны, data warehouse обеспечивает строгую схему и постоянство ключей измерения (product_id, region_id, channel_id, date), что снижает риск рассогласований в периодах, когда метрики пересчитываются или ретроспективно обновляются.
Важно помнить, что метрики зависят от точности и согласованности временных индексов. В рамках дата-слоев целесообразно закрепить единый календарь, учитывать часовые пояса и переносы времени, согласовывать период измерения по горизонтам (day, week, month) и устойчиво управлять временными зонами. В противном случае MAPE может показывать контекстно зависимый искажённый характер ошибок, особенно при сезонности и асимметричных распределениях спроса.
Источники данных для расчётов метрик и требования к качеству
Для корректного расчёта MAPE, Bias и Forecast Accuracy необходима детализированная подготовка исходных наборов данных. Ниже приведены ключевые принципы, которые определяют качество входной информации и минимальные требования к данным на этапах подготовки.
- Совпадение источников по уровням агрегации. Для расчётов метрик требуется согласованность по продукту, локации, времени, а также по единицам измерения. Причины расхождений чаще всего вызывают неверную интерпретацию ошибок: например, если в одних источниках указывается единица продаж «шт.» при в других - «кг» или «литр», метрики потребуют корректировок.
- Временная согласованность. Для каждого элемента расчётов необходимо наличие как фактического значения (actual), так и прогноза (forecast) за одинаковые даты и горизонты. Проблемы с задержками обновления, часовыми поясами и пропусками приводят к искусственным аномалиям в MAPE и Bias.
- Нормализация и единицы. Приведение всех величин к единой шкале (например, единицам продаж на день) критично. В случаях финансовых данных это может потребовать конвертации валют, учёта сезонности и ценовых изменений.
- Контроль пропусков и аномалий. Пропуски в actual или forecast должны обрабатываться явно: исключение, импутация или специальная маркировка, с учётом того, как они влияют на расчёты метрик. Аномалии - скачки спроса, не связанные с бизнес-событиями - требуют детального анализа и, возможно, фильтрации или расчета альтернативных сценариев.
- Версионирование и воспроизводимость. Для аудита и ретроспективной оценки полезно хранить версии наборов данных, параметров трансформаций и параметров расчёта метрик. Это предотвращает «размывание» результатов в связи с изменениями источников или методик расчёта.
- Контракты качества и метаданные. Наличие метаданных о происхождении данных, частоте обновления, методах агрегации и обработке пропусков позволяет аналитикам корректно интерпретировать результаты и повторять расчёты в будущем.
- Безопасность и приватность. В рамках источников данных следует соблюдать требования к персональным данным, доступ к данным и аудит изменений. Метрики не должны раскрываться там, где это нарушает политику доступа.
В контексте модуля MAPE и Bias важно помнить следующую вещь: MAPE чувствителен к значениям actual, особенно при близких к нулю величинах. При нулевых actual метрики требуют особой обработки (например, использования smoothed или альтернативных метрик). Bias, как средняя разница между actual и forecast, может скрывать систематическую переоценку или недооценку спроса, если данные агрегированы по крупным сегментам. Чтобы корректно интерпретировать эти метрики, необходима прозрачная связь между данными и их источниками, а также понимание того, как именно данные были подготовлены в рамках слоёв стандартизации.
Интеграция вычислений метрик в дата-слой
Расчёт метрик прогноза спроса должен быть встроен в конвейеры данных таким образом, чтобы обеспечить воспроизводимость, трактовку и прозрачность. Ниже описана типовая архитектура и принципы реализации без привязки к конкретной системе анализа.
- Ингestion и нормализация данных. В рамках data lake собираются фактические данные и прогнозы из разных систем: платёжные POS-терминалы, ERP, системы планирования спроса, аналитика продаж. В слое стандартизации данные приводят к общим типам, единицам измерения, календарям и ключам размерности (date, product_id, region_id, channel_id). Важна фиксация времени обновления и версии набора данных.
- Сведение и выравнивание по временам. Прогноз и actual должны соответствовать по датам и горизонтам. Стадии свертывания должны фиксировать методики распределения прогноза по уровням агрегации (например, плановая категория vs полный ассортимент).
- Вычислительный слой. В рамках data warehouse или вычислительных кластеров выполняются расчёты метрик для каждого сочетания измерений. В типичном подходе расчёт MAPE, Bias и Forecast Accuracy выполняются для каждого временного шага в рамках размерности времени и по дополнительным размерностям (продукт, регион, канал). В результате формируются таблицы метрик (мэп, бэйс, accuracy) и соответствующие дашборды.
- Временные версии и репликация. Результаты расчётов хранятся в «метриковом» дата-мартe или в слое gold, с привязкой к версии набора данных и параметрам расчётов (например, выбор máscara пропусков, метод для обработки нулей, используемая база тестирования). Это обеспечивает возможность повторного расчёта и сравнения между версиями.
- Контроль качества и аудита. На этапе вычислений выполняются проверки на согласованность между actual и forecast, проверяются пропуски и аномалии, фиксируются отклонения между версиями, регистрируются источники данных и трассируемость изменений.
Инструменты и практики, которые помогают реализовать данные принципы:
- Использование ACID-совместимых форматов в data lake (например, Delta Lake, Apache Iceberg) для обеспечения целостности и поддержки версиирования во времени при работе с большими объёмами данных.
- Внедрение семантического слоя или слойной модели (semantic layer) для описания бизнес-логики расчётов, чтобы прогноз и метрики трактовались одинаково командами аналитиков и бизнес-пользователями.
- Применение контрактов на данные (data contracts) между источниками и потребителями данных: какие поля, форматы, частота обновления и дедлайны поставки данных необходимы для корректного расчёта метрик.
- Непрерывная интеграция и тестирование трансформаций данных: автоматические проверки консistency, пропусков, корректности значений и соответствия календарям.
Разделение рассчетных задач между слоями даёт баланс между гибкостью и надежностью. Гибкость обеспечивают data lake и схемы schema-on-read, где можно быстро добавлять новые источники и коррекции в трансформации. Надежность обеспечивает data warehouse и curated/gold слои с фиксированной схемой и строгим контролем качества. В контексте метрик это означает: быстрое включение новых источников для аналитики спроса, стабильное хранение готовых показателей и воспроизводимость расчётов в долгосрочной перспективе.
Интерпретация метрик в контексте структуры данных и бизнес-сценариев
Метрики MAPE, Bias и Forecast Accuracy не являются абстрактными числами сами по себе; их смысл определяется тем, как устроено хранилище данных и какие данные используются для расчётов.
- MAPE как индекс полноты и устойчивости. MAPE выражает среднюю относительную ошибку; однако он подвержен искажениям, когда реальные значения близки к нулю. В дата-слое это означает, что данные должны быть очищены от аномальных точек, а также иметь возможность отдельно расчитать MAPE по сегментам (например, по регионам или по линейкам продукции). В больших ассортиментных структурах MAPE может быть более информативен в относительных сегментах, где измерение имеет устойчивую шкалу.
- Bias как индикатор систематического смещения. Bias показывает среднюю разницу между actual и forecast. В корректно организованном дата-слое Bias чаще всего рассчитывается на уровне агрегирования, но может быть полезно рассматривать и по уровням детализации: по продукту, по каналу и по региону. Дифференциация по сегментам помогает выявлять конкретные области, где модель систематически недооценивает/переоценивает спрос.
- Forecast Accuracy как комплексное представление. Часто трактуется как 1 - MAPE (или 100 - MAPE в процентах). Однако это упрощение, и в практике полезно рассматривать Forecast Accuracy в контексте гибких наборов: различать Accuracy на разных горизонтах прогноза, разрезы по сегментам и сезонности. В больших дата-слоях целесообразно хранить несколько определений Accuracy (например, по горизонту 1-7 дней, 8-28 дней) и согласовать их семантику через семантический слой.
Интерпретация результатов требует связки с бизнес-контекстом. Высокий MAPE может соответствовать некритичным ситуациям, когда объем спроса мал и колебания не влияют на планирование. Низкий Bias может маскировать ухудшение точности на наиболее значимом горизонте прогноза. Неполная интерпретация часто приводит к неверным решениям в цепочке планирования запасов, ценообразования и рекламных кампаний. Поэтому в рамках дата-слоев целесообразно реализовать аналитику по сегментам и по горизонтам, а также обеспечивать доступ к контекстной информации о бизнес-событиях (праздники, акции, промо-мероприятия), которые могут объяснить аномальные значения.
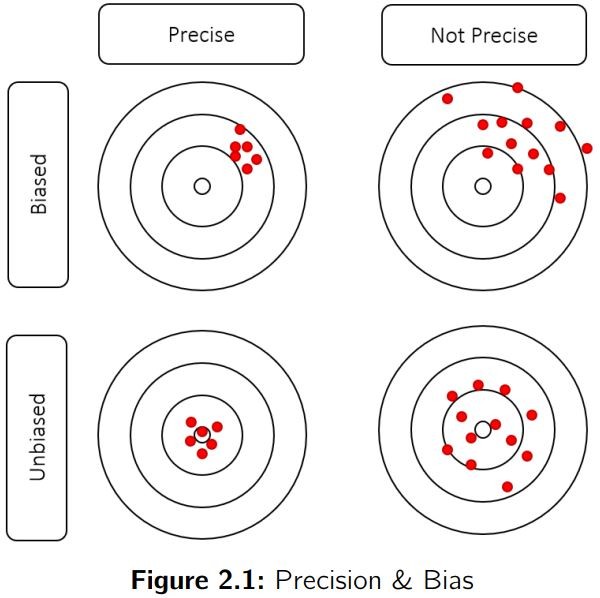
Валидация и практические сценарии
- На уровне данных. Верифицируйте источники: совпадают ли идентфикаторы продукта, локаций и календарей между фактом прогноза и фактом продаж. Поддерживайте версии и логи трансформаций, чтобы можно было отследить, почему конкретная точка расчёта оказалась изменённой после ретроспективной переработки.
- На уровне расчётов. Применяйте корректную обработку нулевых actual и обсуждайте альтернативы MAPE в таких случаях. Разделяйте расчёты по горизонту и сегменту, чтобы выявлять области с наибольшими ошибками и влиянием на бизнес.
- На уровне интерпретации. Встраивайте метрики в управленческие процессы через дашборды, отчеты и периодические ревизии методик прогноза. Не ограничивайтесь одним числом: комбинируйте MAPE, Bias и Forecast Accuracy с дополнительными индексами (MASE, sMAPE) для более глубокой картины.
Управление качеством, регламенты и аудит
Эффективное управление дата-слоями и метриками требует четких регламентов и механизмов аудита:
- Регламенты обработки данных. Определяют, какие источники допускаются, какие поля требуют конвертации и какие методы обработки пропусков. Важно документировать все этапы трансформаций, чтобы повторно воспроизвести расчёт метрик в будущем.
- Контроль версий и прозрачность изменений. Каждая версия набора данных и конфигурации расчётов должна быть закреплена, а изменения - объяснены и доступны для аудита. Это обеспечивает возможность волосить ретроспективно расчёт в любую дату.
- Управление доступом и безопасность. Метрики могут иметь отношение к бизнес-инсайтам: доступ к данным и расчётам должен контролироваться посредством ролей и политик. Отчётные режимы и ограничение доступов помогают защитить конфиденциальные данные.
- Метаданные и каталогизация. Наличие описательных метаданных по каждому набору данных, полям и расчетам облегчает понимание бизнес-логики и воспроизводимость. Каталог данных должен отражать слои стандартизации, версии и владельцев данных.
- Эксплуатационная устойчивость. Архитектура должна быть спроектирована так, чтобы выдерживать нагрузку и обеспечивать безопасность данных. Примеры практик: резервное копирование, мониторинг качества данных, обработка ошибок в конвейерах и уведомления об инцидентах.
Key takeaways
- Дата-слои data lake, data warehouse и слои стандартизации являются основой воспроизводимых и качественных метрик прогноза спроса.
- Грамотная архитектура позволяет отделить «сырые» данные от бизнес-совмещённых представлений и обеспечить единые конверсии единиц измерения, календарей и идентификаторов.
- Множество источников данных требует единых контрактов качества, версий наборов данных и семантического слоя для корректной интерпретации метрик.
- Метрики MAPE, Bias и Forecast Accuracy должны рассчитываться в рамках строгих конвейеров с учётом горизонтов и сегментов, чтобы не искажать бизнес-инсайты.
- Валидация и аудит данных, а также управление версиями и доступом являются критическими для надёжности прогнозной аналитики.
- Таблица метрик должна поддерживать сегментирование по продукту, региону и каналу и хранить версии для ретроспективного анализа.
- Использование современных технологий хранения (Delta Lake, Iceberg) и практик data contracts повышает качество, управляемость и доверие к расчетам.
FAQ
- Что такое MAPE и как он рассчитывается в контексте дата-слоев?
MAPE (Mean Absolute Percentage Error) - средняя абсолютная относительная ошибка между actual и forecast. В контексте дата-слоев MAPE рассчитывается для каждого сочетания измерений (продукт, регион, канал) и временного индикатора (день, неделя, месяц) в рамках согласованных синхронизированных наборов данных. Внутри конвейера данные приводят к единым единицам измерения и календарю, затем вычисляется среднее по всем точкам. Важно обрабатывать нулевые actual корректно и рассматривать сегментные MAPE, чтобы избежать искажений.
- Как определить Bias и зачем он нужен?
Bias - средняя разница между actual и forecast. Он показывает систематическое смещение прогноза в положительную или отрицательную сторону. Bias помогает выявлять недооценку или переоценку спроса и может быть индикатором недоучёта сезонности, промо-эффектов или изменений в ассортименте. В рамках дата-слоев Bias часто вычисляется на уровне агрегирования по сегментам, чтобы локализовать источники смещения.
- Что такое Forecast Accuracy и как его интерпретировать?
Forecast Accuracy часто трактуется как 1 − MAPE (или как 100 − MAPE в процентах). Это универсальный показатель того, насколько близки прогнозы к реальным значениям. Однако данный подход требует ясности по горизонту и сегментам. В практике полезно строить несколько версий Accuracy по разным горизонтам и сегментам, чтобы понять, где модель работает лучше, а где - хуже.
- Какие архитектурные паттерны лучше применить для расчётов метрик?
Лучше использовать три слоя: data lake (для входных данных), слои стандартизации (staging/curated/gold) и data warehouse или столбецно-ориентированный хранилище для анализа. Обеспечьте единые ключи (date, product_id, location_id и т. п.), единицы измерения и календарь. Важно поддерживать версионирование наборов данных и расчётов, чтобы можно было воспроизвести любые расчёты в будущем.
- Какие примеры инструментов и технологий уместны для реализации?
Уместна архитектура, включающая Delta Lake или Apache Iceberg как форматы для data lake с поддержкой ACID и версионирования. Для аналитики и расчётов - CLoud-based data warehouses (например, Snowflake, Google BigQuery) или локальные решения, в зависимости от контекста. В качестве примера открытых продуктов можно упомянуть Delta Lake для слоя данных и ClickHouse для высокопроизводительной аналитики в российском контексте. Важно избегать избыточной зависимости от одного инструмента и сохранять совместимость между слоями.
- Как обеспечить воспроизводимость расчётов?
Необходимо фиксировать версии наборов данных, параметры предиктивной модели, правила обработки пропусков и методики расчётов. В идеале - хранить все эти параметры в контрольной системе и связывать их с конкретной версией вычислений метрик. Это позволяет в ретроспективе повторить расчёты и сравнить новые результаты с прошлым состоянием данных.
- Что делать с пропусками и аномалиями в данных?
Пропуски должны обрабатываться явно в рамках слоёв стандартизации: исключение, импутация или пометка. Аномалии следует анализировать отдельно и, по возможности, сегментировать данные по причинам аномалий. Эффективно использовать тесты качества данных и автоматизированные проверки, чтобы обнаруживать и уведомлять о проблемах в данных перед расчётом метрик.
- Как учитывать сезонность и праздники в расчётах метрик?
Сезонность и события (праздники, промо-акции) должны быть отражены в календаре и в рамках идентификаторов измерений. Это позволяет расчётам не «затирать» или не искажаться сезонно обусловленными паттернами. В слое стандартизации рекомендуется хранить дополнительные признаки аспектов сезонности и события, которые могут объяснить различия между actual и forecast.
- Какой подход к документированию и обучению персонала по работе с метриками?
Необходимо создать единый набор defined standards и документацию по каждому этапу расчёта: от источников данных до методов расчётов и интерпретаций. Обеспечьте регулярное обучение аналитиков и пользователей бизнес-аналитики, чтобы понимать ограничения MAPE и Bias, а также принципы интерпретации результатов. Поддерживайте доступ к семантическому слою и каталогу данных, чтобы пользователи могли ориентироваться в структуре данных и зависимостях.
- Какие риски следует учитывать при внедрении в рамках дата-слоев?
Ключевые риски включают несовпадение по идентификаторам и календарям между источниками, некорректную обработку нулевых значений, сложности с управлением версиями и изменениями схем, а также проблемы с безопасностью и доступом к данным. Управление этими рисками требует четких контрактов на данные, контроля версий, аудита изменений и грамотной организации доступа.
Глава завершается призывом к системной настройке процессов и архитектуры: данные должны быть не просто собраны, а системно подготовлены к расчёту метрик и их информированию бизнеса. Архитектурная дисциплина на стыке дата-слоев и методологии оценки качества прогноза спроса является залогом устойчивой цифровой трансформации, где метрики служат не только измерениями эффективности, но и руководящими индикаторами для оптимизации запасов, ценообразования и планирования продаж.


