

Интеграции данных: ETL/ELT, потоковые источники, данные в реальном времени
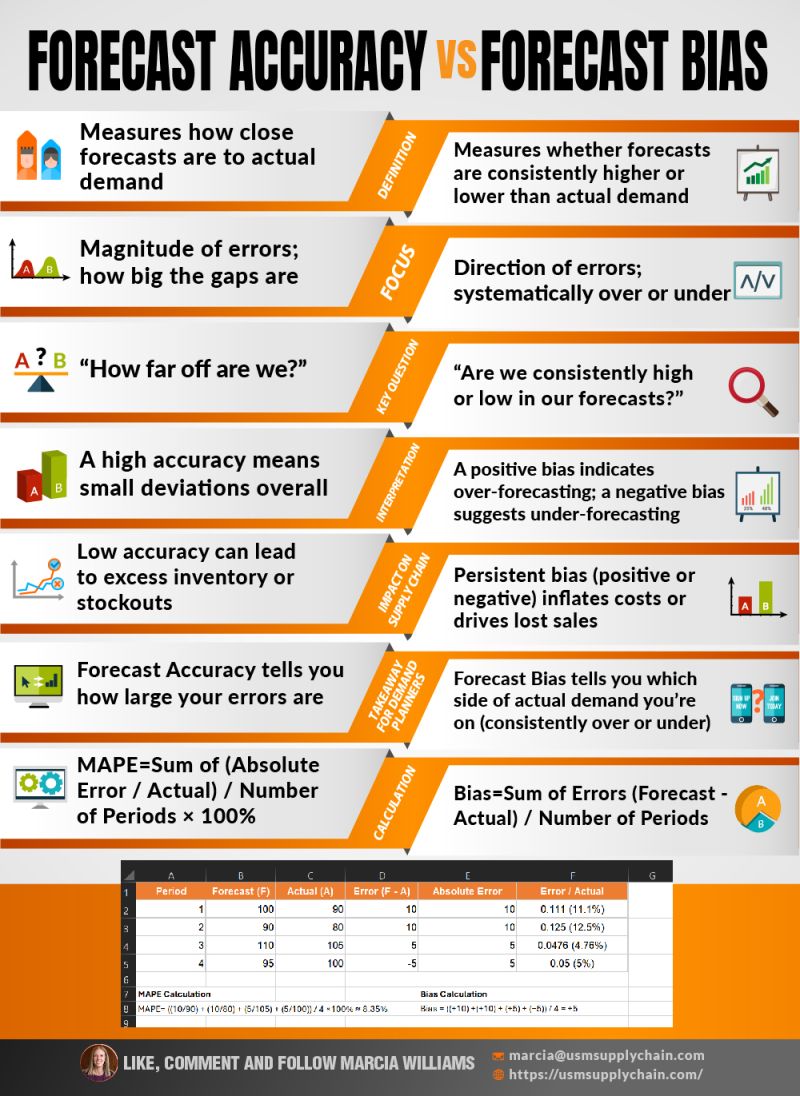
Современные системы прогнозирования спроса строятся на непрерывной синергии источников данных, трансформаций и доставки информации в аналитические и моделирующие среды. Эффективная интеграция данных - краеугольный камень качественных метрик прогноза: MAPE, Bias и показатель Forecast Accuracy. Чем выше надежность и скорость синхронизации между прогнозами и фактическими данными, тем точнее и оперативнее принимаются управленческие решения, тем менее чувствительны бизнес-подразделения к шуму в данных и промо-эффектам. В данной главе рассматриваются архитектурные принципы, выбор подхода ETL/ELT, работа потоков и обработка данных в реальном времени, а также практики обеспечения качества данных и мониторинга метрик прогноза.
Понимание регуляторов данных и их влияния на интерпретацию метрик прогноза является основой для корректной оценки точности. Оптимальная интеграционная архитектура должна обеспечивать: согласование времени между прогнозами и фактическими значениями, прослеживаемость данных, устойчивость к повторной обработке и задержкам, а также возможность оперативного выявления аномалий в метриках качества. В этом контексте архитектура данных выступает не просто средством хранения: она задаёт рамки для воспроизводимости, аудита и управляемой эволюции моделей спроса.
- Архитектура интеграций данных для прогноза спроса: принципы слоенности, источники и целевые хранилища.
- Выбор между ETL и ELT и их влияние на качество и своевременность метрик прогнозов.
- Потоковые источники, обработка в реальном времени и вопросы временных зон и порядка событий.
- Управление качеством данных, мониторинг MAPE, Bias и других индикаторов точности.
- Практические паттерны реализации и критерии безопасности, управляемости и аудита.
Краткое содержание главы
- Архитектурные принципы интеграций для прогнозов спроса и роль ETL/ELT.
- Разделение пакетной обработки и потоков, выбор подхода под бизнес-цели и частоту обновления.
- Работа с потоковыми источниками: Kafka, обработка в режиме реального времени, event-time и watermark.
- Управление временем и качеством данных, синхронизацией прогнозов и фактов.
- Мониторинг и качество данных: вычисление MAPE и Bias, постановка порогов, алерты.
- Реализация архитектурных паттернов: данные в слое озер/складов, репозитории метрик, аудит и безопасность.
Архитектурные принципы интеграций данных для прогнозов спроса
Современная архитектура интеграции данных должна объединять источники внешних и внутренних данных, данные о продажах и спросе, промо-активности, ценовую политику, погодные и социально-экономические факторы. Основной концепт - разделение обязанностей между слоями: источник данных, платформа интеграции, слой хранения данных, слой подготовки и слой аналитики. В техническом плане это означает:
- Источники данных: POS-системы, веб-магазины, ERP/CRM, логистика, Promo/пресс-релизы, внешние источники. Важна не только полнота, но и временная точность: времена покупки и времени фиксации фактов.
- Ингест-слой: прием данных с минимальными задержками, поддержка повторной обработки (idempotence), гарантии доставки (at-least-once, exactly-once там, где возможно).
- Хранилище данных: data lake, data warehouse или их гибрид (Delta Lake, Apache Iceberg) для поддержки схематичности и версионности, а также эффективного агрегирования и исторического анализа.
- Слой подготовки и метрик: трансформации, расчеты MAPE, Bias, Forecast Accuracy, проверка качества данных, прослеживаемость и регламентированная обработка ошибок.
- Потребители: модели прогноза, дашборды, репозитории метрик и системы оповещений.
Ключевым техническим требованием являются: согласование времени, обработка больших объемов данных с минимальной задержкой, поддержка изменений схем (schema evolution) и воспроизводимость процессов. Архитектура должна поддерживать как пакетную обработку по ночным окнами, так и потоковую обработку для near-real-time обновлений. В этом контексте выбор между ETL и ELT тесно связан с целями бизнеса: для быстрых обновлений и малого времени цикла может быть предпочтительно ELT с хранением «сырых» данных и последующими трансформациями в warehouse, тогда как для контроля качества и управляемости лучше ETL с трансформациями на входе.
- idempotence и exactly-once semantics в потоках;
- версия схемы и миграции данных без прерываний;
- прозрачность lineage и аудита на уровне источника до метрик;
- мониторинг задержек и задержания данных между источниками и хранилищем.
-- Пример: концептуальная схема расчета MAPE и Bias на уровне дневной агрегации
-- data_sources.forecasts и data_sources.actuals содержат поля: date, forecast, actual
WITH daily AS (
  SELECT date,
         SUM(forecast) AS forecast_sum,
         SUM(actual) AS actual_sum
## FROM data_sources.actuals AS a
  JOIN data_sources.forecasts AS f USING (date)
  GROUP BY date
)
## SELECT date,
       (SUM(ABS(actual_sum - forecast_sum)) / NULLIF(SUM(actual_sum), 0)) AS MAPE,
       SUM(actual_sum - forecast_sum) AS Bias
FROM daily
GROUP BY date
ORDER BY date;
import pandas as pd ## Пример расчета MAPE и Bias для пакетной обработки df = pd.DataFrame({'date':['2024-01-01','2024-01-02'], 'forecast':[100, 120], 'actual':[110, 115]}) df['abs_error'] = (df['actual'] - df['forecast']).abs() df['ape'] = df['abs_error'] / df['actual'] mape = df['ape'].mean() bias = (df['actual'] - df['forecast']).sum() print('MAPE:', mape, 'Bias:', bias)Стратегии обработки данных: ETL vs ELT, пакетная обработка и потоки
ETL и ELT представляют две альтернативные парадигмы подготовки данных к аналитике и моделированию. В контексте прогноза спроса их выбор определяется скоростью обновления данных, требованиями к качеству и доступностью вычислительных ресурсов.
- ETL - извлечение, трансформация и загрузка. Трансформации выполняются до загрузки в целевые хранилища. Преимущества: очистка и нормализация данных на входе, меньшая нагрузка на аналитическую нагрузку и более предсказуемые схемы. Недостатки: жесткая нелика в эволюции схем, меньшая гибкость для анализа «сырых» источников и более длительный цикл обновления.
- ELT - извлечение, загрузка и трансформация уже в хранилище. Трансформации выполняются после загрузки в хранилище, что позволяет использовать мощь систем аналитики и адаптироваться к изменениям требований без повторной загрузки данных. Преимущества: гибкость, более быстрая загрузка, простота добавления новых источников. Недостатки: необходимость высокой мощности хранилища, возможная сложность контроля качества «сырых» данных.
Выбор подхода должен опираться на требования к задержке, доступность вычислительных ресурсов и необходимость данными в процессе моделирования. Хорошей практикой является гибридный подход: критически важные данные проходят через ETL-подход для обеспечения консистентности, а менее критичные, более разнообразные наборы источников - ELT-потоками с поздними трансформациями внутри хранилища.
- В пакетной обработке важны планирование обновлений и согласование версий данных, особенно если фактические значения и прогнозы пришли с различной задержкой.
- Для потоков и near real-time обновлений критично управлять задержкой источников и временем «взаимосогласования» (time alignment) между прогнозом и фактом.
Потоковые источники и обработка данных в реальном времени
Потоковые источники позволяют предлагать обновления метрик в окнах времени, что важно для мониторинга точности прогноза в реальном времени. Основными стековыми решениями являются распределенные системы обмена сообщениями (Kafka, Kinesis) и обработчики потоковых данных (Flink, Spark Structured Streaming). В контексте прогноза спроса это позволяет:
- прием и корреляцию данных прогнозов и фактов почти в реальном времени;
- поддержание событийного времени и корректного порядка обработки;
- применение оконных функций для расчета метрик по дневным, недельным или кастомным интервалам;
- управление состоянием и рестартами, а также повторной обработкой в случае ошибок.
Ключевые принципы потоковой обработки:
- event-time processing и watermarking: обработка событий по времени события (а не прихода в систему) требует механизма водяных отметок и задержек. Это позволяет корректно учитывать поздно приходящие данные и избегать искажений в метриках.
- exactly-once semantics vs at-least-once: в идеале для финансовых и коммерческих решений требуется exactly-once, однако это сложнее реализовать. В части архитектуры применяют idempotentные операции и детерминированные ключи для повторной обработки.
- stateful processing: хранение состояния между окнами и событиями для корректного агрегационного расчета и коррекции ошибок.
- задержки и backpressure: система должна gracefully справляться с пиками нагрузки и не приводить к задержкам в поставке метрик.
Пример типичной архитектуры потоков:
- источники: POS-терминалы, онлайн-каналы, ERP и промо-данные.
- ингьест-слой: Kafka topics для forecast и actual data, поддержка схемной версии и схем-егейшен.
- обработчик потока: Flink или Spark Structured Streaming - агрегации по окнам, расчеты MAPE/Bias на уровне дневных окон, публикация результатов в метрик-слой.
- хранилище: data warehouse/iceberg-таблицы для долговременной аналитики, а также fast-path для дашбордов.
- потребители: BI/аналитика, модели прогноза, система алертов.
-- Пример простой конвейера: расчета MAPE в окне по дням в Flink (псевдокод)
-- вход: два потока: forecasts и actuals, по полям date, value
-- памятка: event-time обработка и watermark
Согласование времени и качество данных
Одной из самых сложных задач в интеграции данных для прогноза спроса является синхронизация времени между прогнозами и фактами. Неправильная привязка временных меток приводит к искусственным отклонениям в MAPE и Bias искажает выводы о точности.
- event-time vs processing-time: используйте event-time для расчета метрик, а processing-time - для мониторинга задержек и операций управления конвейером.
- временные зоны и кросс-датчики: унифицируйте временные метки в единой временной зоне, учитывайте сезонность и летнее время, применяйте простой конверсионный слой для унификации источников.
- поздно приходящие данные: предусмотривайте политки задержки, окна ожидания и методику повторной обработки. Late data должны корректировать ранее рассчитанные метрики, но без двойного учета.
- коррекция ошибок: когда факт приходит позже прогноза, показатели ошибок должны пересчитываться без дублирования. Стратегии включают хранение истории версий и лейблов событий.
Ключевой задачей является обеспечение согласованного времени между прогнозами и фактами, чтобы метрики отражали реальную точность, а не задержку обработки. В продвинутых кейсах применяют концепцию кросс-дат-пути: каждый источник данных имеет собственный timestamp и quality tag, затем данные приводят к единой временной оси и нормализованной схеме.
Гарантии качества данных и мониторинг метрик
Качество данных - критический фактор для корректной интерпретации MAPE, Bias и других метрик прогнозирования. Элементы контроля включают:
- валидацию схем и типов данных на входе в интаграционные конвейеры;
- проверку уникальности ключей, отсутствия дубликатов и пропусков в критических полях;
- контроль версий схемы и совместимости потребителей;
- мониторинг задержек отбора и задержек обработки.
Для метрик прогноза целевые практики:
- вычисление MAPE и Bias в окнах времени (например, суточные, недельные) с поддержкой ретроспективного обновления при появлении поздно пришедших фактов;
- хранение исторических значений метрик для трендового анализа и аудита;
- использование алертов: если MAPE превышает порог, уведомлять команду данных и бизнес-аналитиков;
- визуализация и дашборды, показывающие динамику точности прогноза по сегментам, каналам продаж, регионам и промо-активностям;
- аналитические проверки: корреляции между точностью и параметрами конкретных источников (канал, промо), чтобы выявлять системные проблемы.
Практический подход к реализации заключается в создании единого репозитория метрик, разделяемого между командами данных, бизнес-аналитиками и моделями прогноза. В этой схеме метрики MAPE и Bias не являются изолированными числами: они отражают качество входных данных, корректность временной привязки и устойчивость конвейера к задержкам и повторной обработке. В результате, мониторинг становится средством раннего предупреждения и основой для принятия архитектурных изменений, например, введения дополнительного источника данных, регулирования частоты обновлений или изменения политики обработки поздно приходящих данных.
-- Пример SQL-запроса для расчета дневной MAPE и Bias по окну суток
WITH daily AS (
  SELECT date,
         SUM(forecast) AS forecast_sum,
         SUM(actual) AS actual_sum
  FROM forecasts f
  JOIN actuals a ON f.date = a.date
  GROUP BY date
)
## SELECT date,
       AVG(ABS(actual_sum - forecast_sum) / NULLIF(actual_sum, 0)) AS MAPE,
       SUM(actual_sum - forecast_sum) AS Bias
FROM daily
GROUP BY date
ORDER BY date;
Реализация интеграционных паттернов и практическая архитектура
Сложные сценарии требуют четкой архитектурной дисциплины и повторяемых паттернов реализации. Рекомендованные принципы:
- легитимность источников: прослеживаемость, идентификация источника и версионирование схем;
- репозитории и слои: data lake для «сырых» данных и степенная обработка данных в warehouse или lakehouse;
- конвейеры и оркестрация: Airflow, Dagster или иной оркестратор, обеспечивающий контроль версий, зависимостей и повторяемость;
- управление изменениями: стратегия миграций схем, обратная совместимость, тестовая среда для новых источников;
- безопасность и доступ: минимальные привилегии, аудит доступа и шифрование; соответствие локальным и отраслевым нормам.
Пример типового контура реализации:
- сбор данных: источники продаж, мерчандайзинг, промо, внешние факторы;
- ингьест: потоковые брокеры (Kafka) и пакетное извлечение вечером;
- хранение: hive-таблицы или Iceberg-схемы, версионирование Raw/Processed;
- трансформации: ETL для критически важных данных и ELT для пост-обработки;
- метрики: расчет MAPE, Bias и других KPI прогноза;
- мониторинг и алертинг: дашборды, уведомления в слак/электронную почту по аномалиям.
Имея в руках архитектуру, важно обеспечить одну существенную вещь: согласованность контекстов между источниками и метриками. Это позволяет не только корректно рассчитывать MAPE и Bias, но и разбирать, какие источники данных дают наилучшую точность, какие сегменты бизнеса требуют улучшения и какие изменения в моделях прогноза могут быть эффективны.
Примеры архитектурных схем
Опишем два типовых кейса интеграции для прогноза спроса:
- кейс 1: пакетная загрузка с потоком дешевого обновления. Источники: POS-данные и промо. Ингест в Kafka, пакетная обработка ночью через ELT-подход, хранение в Iceberg. Метрики рассчитываются в слое аналитики на основе дневных данных. Этот сценарий обеспечивает устойчивость к временным задержкам и позволяет моделям прогноза обновляться на утренних батчах.
- кейс 2: полная потоковая обработка. Источники: онлайн-платежи, веб-сеансы, погодные данные. Ингест в Kafka, обработка через Flink с оконной агрегацией и event-time. Расчет MAPE/Bias выполняется в реальном времени и обновляется в BI-панелях почти мгновенно, что полезно для оперативного реагирования на промо-акции и изменяющиеся условия спроса.
В обоих случаях ключевыми являются: точная привязка времени, управление задержками и возможность ретроспективного пересчета метрик. В реальности чаще всего применяется гибридная архитектура: частично пакетная загрузка для устойчивой базы данных и частично потоковая обработка для критических оперативных задач.
Key takeaways
- Точная интеграция данных - фундамент для корректной интерпретации метрик прогноза: MAPE, Bias и Forecast Accuracy.
- Выбор между ETL и ELT определяется требованиями к задержке, гибкости и качеству данных; гибридные решения часто наиболее эффективны.
- Потоковая обработка с event-time и watermarking критична для реального времени и корректной агрегации метрик.
- Время и согласование временных меток между прогнозами и фактами - залог корректной интерпретации точности.
- Контроль качества данных и lineage являются основой аудита и устойчивого развития моделей.
- Мониторинг метрик по сегментам и алертинг позволяют оперативно реагировать на деградацию точности.
- Архитектура должна обеспечивать безопасность, управление версиями схем и повторяемость конвейеров.
FAQ
- В чем ключевое различие ETL и ELT в контексте интеграции данных для прогноза спроса?
- ETL предполагает выполнение трансформаций до загрузки в хранилище, что обеспечивает чистые и унифицированные данные на входе. Это полезно, когда источники жестко структурированы и требуется предсказать порядок обработки. ELT переносит трансформации в хранилище, что обеспечивает большую гибкость и скорость загрузки, позволяя моделям и аналитикам работать с “сырыми” данными и осуществлять трансформации по мере необходимости. В практике сочетание часто предпочтительно: критически важные данные обрабатываются на входе (ETL) для стабильности, остальное - ELT с поздними трансформациями.
- Как обеспечить корректное согласование времени между прогнозами и фактами в потоковой среде?
- Необходимо внедрить единый механизм временных меток, перевод в единую временную зону и использование event-time processing. Вводят watermark и управление задержками, чтобы поздно пришедшие данные могли корректировать метрики без нарушения последовательности. В случае поздних фактов следует применить стратегии ретраверса и версии данных.
- Какие паттерны помогает применить для обеспечения воспроизводимости конвейеров?
- Idempotent-операции, детерминированные ключи, версионирование схем и событий, хранение истории изменений, тестовые среды для миграций, а также хранение репозитория метрик и логов исполнения для аудита.
- Какие меры контроля качества данных особенно важны для метрик прогноза?
- Валидации схем, проверка полноты и уникальности ключевых полей, контроль за пропусками и дубликатами, тестирование новых источников данных в тестовой среде, а также мониторинг задержек и ошибок обработки.
- Как выбрать параметры мониторинга для MAPE и Bias в реальном времени?
- Определить окно агрегации (день, неделя), выбрать методику обновления (реальное время на окно vs патч-обновления в конце окна), задать пороги тревог и хранить историю изменений для анализа трендов и причин изменений в точности.
- Какие существуют ограничения в потоковой обработке для точности метрик?
- Точность в потоках может быть ограничена задержками и неточностью данных в источниках. Необходимо обеспечить согласование времени, устойчивость к повторной обработке и устойчивость к задержкам в источниках. Exactly-once семантика может быть сложна, поэтому часто применяют idempotent-операции и детерминированную агрегацию.
- Какие базовые практики обеспечения безопасности и аудита в интеграциях данных?
- Принцип наименьших привилегий, шифрование в состоянии и при передаче, аудит доступа к данным и журналирование событий. Управление версиями схем и изменений, контроль версий конвейеров и обновления в тестовой среде перед развёртыванием.
- Какие open-source решения чаще всего применяют для потока данных и аналитики?
- Apache Kafka как брокер сообщений и Apache Flink или Spark Structured Streaming для обработки потоков. В качестве инструментов для моделирования и миграций - dbt для трансформаций в warehouse и Git как источник версий. В контексте интеграций эти инструменты часто сочетаются в гибридной архитектуре.
- Как выстраивать архитектуру, чтобы можно было ретроспективно проверить расчеты метрик?
- Нужно хранить версии входных данных, версию схемы и хранить логи расчета метрик и результаты по каждому окну времени. Это обеспечивает возможность пересчета и аудита в случае обнаружения аномалий.
- Какие подходы применяются для обработки больших объемов исторических данных без потери оперативности?
- Разделение слоев на Raw/Processed, использование ленивой загрузки и параллельной агрегации, хранение исторических данных в формате столбцового хранения и использование оптимизированных форматов (Parquet/ORC). Это позволяет параллельно обрабатывать запросы по метрикам и обновлять модели прогнозирования без блокирования текущих операций.
Глава подчеркивает, что интеграции данных - не просто технический модуль. Это фундаментальная платформа для достоверной интерпретации метрик прогноза спроса, поддерживающая прозрачность, воспроизводимость и оперативность бизнес-решений.


