

Демонстрация настройки и срабатывания оповещений в StarRocks
Оповещения в рамках архитектуры StarRocks служат связующим звеном между техническим состоянием системы и оперативной реакцией команды. Правильная реализация уведомлений позволяет ранне обнаруживать деградацию производительности, сбои нод, нехватку ресурсов и аномалии в workload. В данной главе представлен практический путь-from архитектурного проектирования до реализации и эксплуатации-как выстроить эффективную схему оповещений для кластеров StarRocks, с акцентом на интеграцию с внешними системами мониторинга и непрерывную проверку работоспособности.
Ниже изложены принципы, которые лежат в основе демонстрации: как StarRocks экспонирует метрики, какие пороги разумно устанавливать для SLA/SLO, какие каналы уведомлений применяются и какие процедуры тестирования и эксплуатации следует выстроить в рамках команды.
- Обзор архитектуры оповещений в StarRocks и внешних системах мониторинга
- Выбор порогов и формулировка правил на основе SLA/SLO/SLI
- Интеграция с Prometheus, Alertmanager и сторонними уведомлениями
- Практическая настройка: включение метрик, развёртывание инструментов мониторинга, создание правил
- Валидация, эксплуатация и управление изменениями правил уведомлений
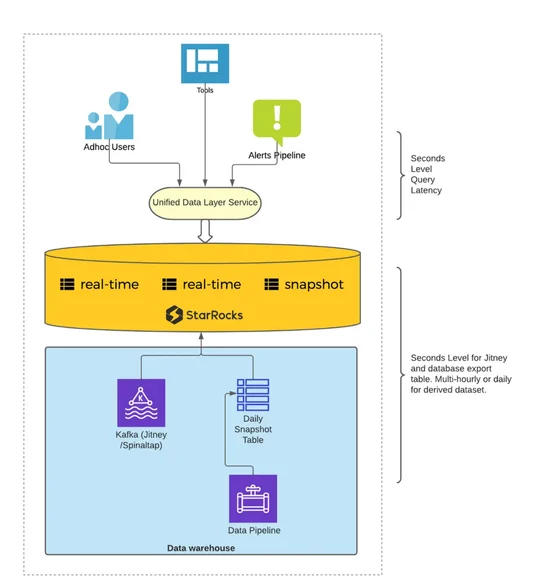
Архитектура оповещений в StarRocks
StarRocks экспонирует метрики на двух уровнях: на уровне FE (Frontend) и BE (Backend). FE отвечает за метрики, связанные с планированием запросов, распределением нагрузки и глобальным состоянием кластера, тогда как BE добавляет метрики за выполнение сквозных операций, чтение/запись данных, задержки на уровне секций данных и состояния копирования/репликации. Совокупность метрик позволяет получить картину производительности всей системы: latency по запросам, throughput, доступность нод, состояние реплик и использование ресурсов.
Для интеграции с системами мониторинга наиболее практична схема, в которой StarRocks экспортирует метрики через стандартный эндпоинт Prometheus (обычно это набор HTTP-эндпоинтов вида /metrics на FE и BE). Эти метрики суммируются в единый источник наблюдаемости, который затем потребляется Prometheus. Prometheus знает, как агрегировать и хранить данные, а далее через Alertmanager формируются уведомления и маршрутизируются в соответствующие каналы связи.
Архитектура можно представить как последовательность слоев:
- источники метрик на FE/BE;
- слой сбора: Prometheus агрегирует и хранит временные ряды;
- слой правил: Prometheus Rules и/или внешний редактор правил (GRAFANA Loki или другие слои) определяют пороги и условия;
- слой уведомлений: Alertmanager маршрутизирует сигналы в каналы связи (Slack, Teams, email, Webhook, PagerDuty и др.);
- слой восстанавливающих действий: операционная команда получает уведомления и выполняет предписанные runbook’ы.
Важно подчеркнуть, что оповещения должны быть адаптированы под характер workloads StarRocks: пикные нагрузки при загрузке новых наборов данных, латентности по долго выполняемым запросам, сбои реплик, нехватку места на диске и перегрузку сетевых каналов. Корреляция сигналов и устранение ложных срабатываний достигаются через правильное сочетание порогов, окон времени и уровней важности.
Пример архитектурного потока
- Метрики экспонируются FE/BE;
- Prometheus собирает данные и хранит их;
- Правила оповещений формируются с учётом SLA/SLO;
- Alertmanager распределяет уведомления по каналам;
- Операционная команда реагирует согласно runbook’ам.
Выбор и формулировка порогов
Ключевую роль в эффективной системе оповещений играет формулировка порогов: они должны отражать реальные бизнес-цепочки, а не создавать шум. В рамках StarRocks целесообразно использовать сочетание SLA, SLO и SLI, где SLA - обязателен для направления реагирования, SLO - целевое требование по функционированию, а SLI - измеряемый показатель, по которому оценивается соответствие SLO.
Основные направления для порогов:
- latency и latency distribution: 95-й и 99-й перцентили времени выполнения запросов; допустимая доля запросов выше порога;
- error rate: доля неудачных запросов или ошибок выполнения;
- throughput и queueing: скорость обработки запросов и очереди, особенно в пиковые окна;
- реплики и доступность: задержка реплик, отставание между нодами, состояние узлов;
- ресурсное потребление: использование CPU, памяти, дискового пространства, IOPS;
- стабилизация кластерных операций: длительное выполнение операций админ- и DDL-задач.
Практический подход: после начального развёртывания определить базовые пороги на стабилизированной рабочей нагрузке, затем провести стресс-тесты и корректировку порогов под реальные сценарии. Важна нормализация порогов между разными нодами и секциями кластера, чтобы исключить ложные срабатывания из-за логикой шардинга или локальных аномалий.
Типовые метрики, которым полезно придать внимание:
- starrocks_query_latency_seconds_bucket и/или starrocks_query_latency_ms_metric;
- starrocks_failed_queries_total или аналогичный счётчик ошибок;
- starrocks_replica_lag_seconds или схема задержек реплик;
- starrocks_disk_usage_percent и варианты, отражающие заполнение дискового пространства;
- starrocks_cluster_cpu_utilization, starrocks_memory_usage_bytes - для перегревов и утечек памяти.
Важно: при формулировке правил исключайте избыточный шум через ввод ограничений по времени (for), группировку по кластерам/существующим рольям и этапам выполнения. Это позволяет детектировать именно события, требующие реакции, а не периодические колебания нагрузки.
Интеграция с внешними системами уведомлений
Для оперативного реагирования используются два стандартных стека: Prometheus + Alertmanager и вебхуки, интегрированные со сторонними коммуникационными каналами.
-
Prometheus и Alertmanager: Prometheus собирает метрики, Alertmanager управляет маршрутизацией уведомлений, группировкой и подавлением повторной отправки. В рамках StarRocks практично разделять правила по группам: кластер, конкретная база данных, отдельная нода. Это позволяет оперативно определить источник сигнала и применить корректные runbooks.
-
Внешние каналы уведомлений: Slack, Microsoft Teams, email, PagerDuty, сервисы по обработке инцидентов. Webhook-каналы можно использовать для интеграции с внутренними служебными системами и сервис-деск.
-
Безопасность и надёжность: шифрование TLS/HTTPS, аутентификация при подключении к внешним сервисам, ограничение прав доступа на режим только мониторинга, журналирование действий.
Практический принцип: избегайте монолинейных уведомлений. Настройте маршруты Alertmanager так, чтобы критичные сигналы попадали в первичные каналы, а менее критичные - в резервные каналы или в бэклог runbook’ов. Грамотная корреляция позволяет снизить шум и ускорить время реагирования.
Практическая настройка
Шаг
- Включение и сбор метрик StarRocks
- Обновите конфигурацию StarRocks FE и BE так, чтобы они экспонировали метрики в формате Prometheus. Обычно это делается через включение экспортёра метрик и указание адреса/портов. После изменений следует перезапустить ноды.
- Убедитесь, что метрики появляются в эндпоинтах, доступных для Prometheus.
Шаг 2. Развёртывание Prometheus
- Разверните Prometheus в вашем кластере и настройте файрволлы так, чтобы Prometheus мог обращаться к FE и BE по их метрикам.
- Добавьте скрейпер конфигурацию для StarRocks, чтобы Prometheus собирал нужные метрики на регулярной основе.
Шаг 3. Конфигурация Alertmanager
- НастройтеAlertmanager с маршрутами уведомлений к Slack/Teams/Webhook и резервными каналами.
- Определите правила подавления дубликатов и временные окна, чтобы снизить шум.
Шаг
4. Определение и внедрение правил оповещений
- Создайте базовые правила для критических сценариев: высокий latency, высокий процент ошибок, потеря доступности реплик, перегрев узлов, нехватка дискового пространства.
- Разверните правила в виде конфигурации Prometheus или в виде готовых YAML-файлов Alertmanager, в зависимости от вашего стека мониторинга.
Пример правила в формате Prometheus Alertmanager (примерно, лексика может варьироваться в зависимости от версии и конвенций):
groups:
- **name**: starrocks.alerts
  rules:
  - **alert**: StarRocksHighQueryLatency
    expr: histogram_quantile(0.95, rate(starrocks_query_latency_seconds_bucket[5m])) > 0.5
    for: 10m
    labels:
      severity: critical
      cluster: prod
    annotations:
      summary: "StarRocks: превосходящий порог 95-го перцентиля задержки запросов"
      description: "В кластере {{ $labels.cluster }} 95-й перцентиль latency превышает 0.5 секунды за последние 10 минут."
  - **alert**: StarRocksReplicaLag
    expr: starrocks_replica_lag_seconds > 60
    for: 5m
    labels:
      severity: important
      cluster: prod
    annotations:
      summary: "StarRocks: задержка реплик выше порога"
      description: "Задержка реплик на узле {{ $labels.node }} превышает 60 секунд."
Шаг 5. Тестирование и валидация
- Проведите тестовые сценарии: искусственно увеличьте latency, отключите одну из реплик, заполните диск до порога. Убедитесь, что уведомления приходят в заданные каналы и содержат нужную информацию.
- Проведите имитацию инцидента: задокументируйте runbook и проверьте, что эскалация достигает ответственных команд.
Шаг
6. Управление изменениями и документацией
- Вводите новые правила через процесс изменения (change management) с соответствующей документацией и учётом обратной совместимости.
- Регулярно просматривайте правила на предмет избыточности, устаревших каналов и ложных срабатываний.
Валидация и эксплуатация
После внедрения важно поддерживать концепцию устойчивого мониторинга. Регламентируйте периодические аудиты метрик и правил: какие события освещаются, когда вносились изменения, какие пики workload были учтены. Регулярно прогоняйте обучающие сценарии инцидентов и обновляйте runbooks на основе опыта оперативной команды. В условиях высокой динамики архитектуры StarRocks следует поддерживать способность к быстрой эволюции схем оповещений: добавление новых параметров, адаптация порогов к обновлениям версии, расширение каналов уведомлений по мере роста команды и изменений в инфраструктуре.
Не менее важно обеспечить прозрачность для команды: храните документацию по правилам оповещений, схемам маршрутизации и тестовым сценариям в доступном репозитории. Это упрощает onboarding новых участников и снижает риск потерь знаний при смене состава команды.
Key takeaways
- Правильная архитектура уведомлений объединяет StarRocks FE/BE, Prometheus и Alertmanager в единую цепочку наблюдаемости и реагирования.
- Формулировка порогов требует баланса между ранним обнаружением и избежанием шума; используйте SLA/SLO/SLI как основу для целей оповещений.
- Интеграция с внешними каналами уведомлений должна быть многоуровневой: критичные сигналы в первичные каналы, другие - в резервные или в runbooks.
- Практическая настройка требует пошагового подхода: включение метрик, развёртывание мониторинга, создание и тестирование правил.
- Регулярная валидация и обновление правил уведомлений необходимы для сохранения эффективности в условиях эволюции кластера StarRocks.
- Контроль версий правил и документирование изменений улучшают управляемость и снижает риск регрессионных инцидентов.
- Эффективное оповещение способствует снижению MTTR и повышению устойчивости аналитической инфраструктуры.
FAQ
- Какие метрики наиболее важны для начала настройки оповещений в StarRocks?
- В начале целесообразно сосредоточиться на latency-дисиприках и проценте ошибок запросов (например, latency percentile и error_rate), состоянии реплик и нагрузке на дисковую подсистему. По мере зрелости мониторинга добавляйте показатели CPU/memory usage и специфичные для workload метрики.
- Как избежать множества ложных срабатываний?
- Применяйте временные окна (for), дробное пороговое разделение (distinguish между cluster и node), группируйте правила по кластерам и используйте подавления (silences) и эвристики Alertmanager, чтобы коррелировать сигналы и устранять шум.
- Какие каналы уведомлений следует предусмотреть в первую очередь?
- В типичной среде - Slack или Teams для оперативной коммуникации, Webhook’и для интеграции в сервис-деск, а также электронная почта и PagerDuty для эскалации в ночное время. Важно обеспечить дублирование и резервные каналы на случай недоступности некоторых систем.
- Каковы практические шаги по тестированию правил оповещений?
- Реализуйте тестовые сценарии: симуляцию задержки запросов, отключение ноды, переполнение дискового пространства. Проверяйте, что уведомления приходят в заданные каналы и что их содержание помогает оператору начать реакцию без лишних шагов.
- Какие риски следует учитывать при внедрении оповещений?
- Риск шума, ложных уведомлений, неправильной эскалации и пропуска инцидентов. Эти риски снижаются через тщательную калибровку порогов, корреляцию сигналов, управление изменениями и регулярную валидацию runbooks.
- Как обеспечить согласованность правил между командами (DevOps, SRE, аналитики)?
- Введите единый репозиторий правил, процессы ревью изменений и документированные runbooks. Регулярные синхронизационные встречи помогут держать правила в актуальном состоянии и учитывать новые сценарии эксплуатации.
- Можно ли использовать готовые шаблоны оповещений для StarRocks?
- Да, частично можно опираться на общие шаблоны мониторинга для распределённых систем и адаптировать их под особенности StarRocks. Важно сохранить уникальные показатели и пороги, целевые для вашей рабочей нагрузки.
- Какие параметры безопасности важны при интеграции Alertmanager с внешними каналами?
- Используйте TLS для всех соединений, аутентификацию и ограничение доступа к конфигурационным файлам. Включайте аудит действий и храните конфиденциальные данные (токены, webhook-URL) в защищённом хранилище и с ограниченными правами.
- Как управлять изменениями правил уведомлений?
- Автоматизируйте процесс изменения через систему контроля версий, применяйте процессы ревью, тестируйте новые правила в staging-среде перед развёртыванием в продакшн, фиксируйте результаты тестирования.
- Как поддерживать актуальность оповещений в условиях роста кластера?
- Регулярно переоценивайте пороги на основе новых данных, расширяйте набор метрик по мере появления новых сервисов и рабочих сценариев, внедряйте автоматические проверки валидности правил и проводите плановые аудиты конфигураций мониторинга.
В заключение, демонстрация настройки и срабатывания оповещений в StarRocks - это не одноразовая задача, а непрерывный процесс эволюции мониторинга. В балансе архитектуры, процессов и практической реализации лежит способность быстро идентифицировать инциденты, минимизировать MTTR и гарантировать устойчивость аналитической инфраструктуры к изменяющимся условиям нагрузки и инфраструктуры.


