

Практические кейсы внедрения sandbox-архитектуры в DWH и ML аналитике
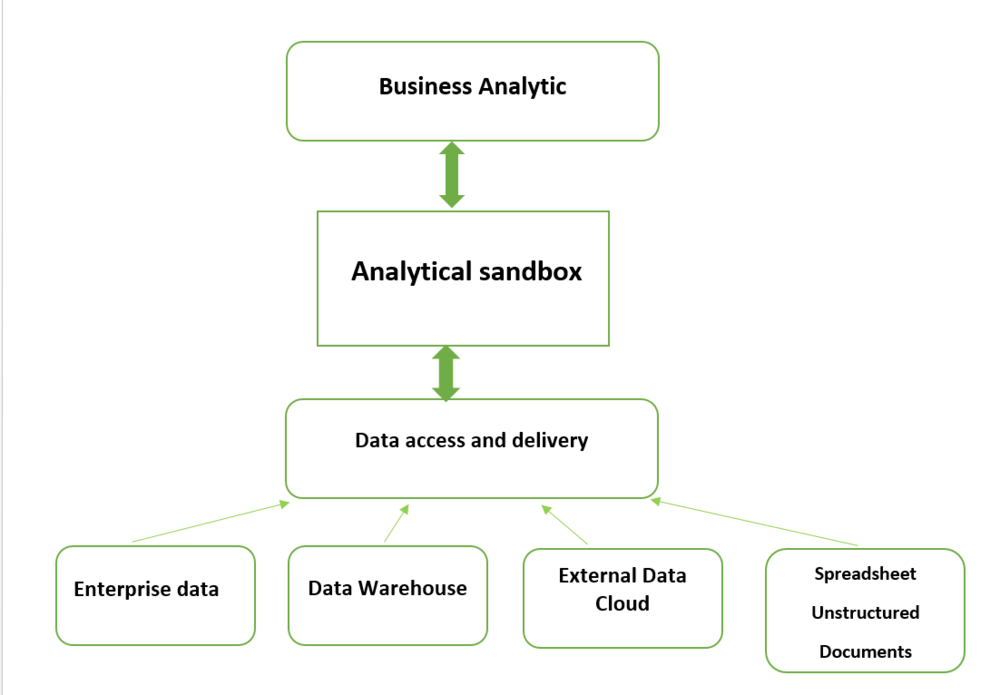
Sandbox-архитектура в контексте DWH и ML аналитики выступает как системный подход к изоляции, воспроизводимости и управляемости экспериментов. Она позволяет командам данных проводить тестирование гипотез, разворачивать новые алгоритмы и проверки качества без риска для боевых данных и производственных процессов. В данной главе рассматриваются принципы проектирования зон пессимистической и оптимистичной изоляции, инфраструктурные паттерны, а также реальные кейсы внедрения, где sandbox служит связующим мостом между данными, моделями и эксплуатацией. Особое внимание уделяется управлению затратами, соблюдению регуляторных требований и методикам перехода от экспериментов к промышленной эксплуатации.
Sandbox-архитектура применяется как на стыке бизнес-аналитики и Data Science, так и в рамках ML-операций. В примерах будут иллюстрированы подходы к разделению сред, использованию контрактов данных, управлению версиями таблиц и моделей, а также организации жизненного цикла sandboxes через инфраструктуру как код и автоматизированные пайплайны. В конце главы представлены практические выводы и набор паттернов для внедрения в типовой корпоративной среде с учетом ограничений регуляторов, бюджета и рисков безопасности.
- Архитектурные принципы sandbox в контексте DWH и ML аналитики
- Инфраструктура, интеграции и lifecycle sandboxes
- Практические кейсы внедрения sandbox: кейс по ML-экспериментам и кейс по пайплайнам данных
- Безопасность, комплаенс, мониторинг и управление затратами
Архитектурные принципы sandbox в DWH и ML
Эффективная sandbox-архитектура строится на четко определённых границах между средами, четких правилах доступа и управлении версиями. Центральной идеей является изоляция, которая обеспечивает безопасность данных и воспроизводимость экспериментов без влияния на продакшн-сценарии.
Первый принцип - разделение по уровням изоляции. Данные в sandbox-хранилищах дублируются в виде реплик с ограничениями доступа, а верифицируемые контрактами форматы позволяют сохранить согласованность между версиями таблиц и моделями. В DWH это достигается через выделение отдельных схем или баз данных для экспериментальных нагрузок, использование маскинга и анонимизации на входе и на выходе. Для ML-аналитики важна изоляция вычислений: отдельные namespace в Kubernetes или выделенные кластеры Spark позволяют параллельно разворачивать модели без contend за ресурсы.
Второй принцип - управляемость жизненного цикла sandboxes. Каждый sandbox имеет «roid» - жизненный цикл: создание, конфигурацию, тестовый прогон, эволюцию и безопасное удаление. Управление версиями данных и моделей достигается контрактами данных (data contracts) и схемами, которые регистрируются в репозитории схем или в схематическом реестре. Этот подход обеспечивает совместимость между экспериментами и продактом и упрощает регресс-тестирование.
Третий принцип - строгие политики доступа и аудит. RBAC/ABAC, сегментация ролей и политика минимального необходимого доступа позволяют ограничить видимость чувствительных данных. Применение автоматических политик на уровне API и пайплайнов обеспечивает соответствие требованиям регуляторов и внутренним стандартам. В некоторых сценариях целесообразно внедрять OPA (Open Policy Agent) как единую точку принятия решений о доступе.
Четвёртый принцип - управление затратами и качеством данных. Эффективное использование вычислений достигается через ephemeral compute, квоты на память и процессорное время, автоматическую очистку ресурсов по завершении задач, а также тегирование затрат для прозрачной калькуляции себестоимости экспериментов. Важным элементом является мониторинг качества данных и моделей: тесты на целостность данных, контроль версий, тесты на деградацию метрик.
Пятый принцип - архитектура с обоснованием для тестирования гипотез. Sandbox выступает как среда, где можно безопасно внедрять новые признаки, алгоритмы и параметры, проверять устойчивость к различным аномалиям, оценивать влияние на результаты бизнес-показателей и проводить A/B-тестирование в условиях ограниченной доступности к боевым данным.
В качестве практической иллюстрации можно рассмотреть сочетание технологий: Delta Lake или Apache Iceberg как форматы хранения, которые обеспечивают ACID-операции и схему эволюцию; Apache Spark как движок обработки для больших данных; Kubernetes для изоляции вычислений; и схему повторяемости через Git-репозитории конфигураций и пайплайнов. В рамках этого раздела следует помнить о балансе: слишком детальная кастомизация sandbox может усложнить поддержку; слишком простая архитектура - снизит качество контроля и воспроизводимости.
- Изоляция данных через отдельные схемы/базы и маскирование входных данных
- Контракты данных и регистры схем для контроля совместимости
- Жизненный цикл sandbox: создание, тестирование, развёртывание, удаление
- Инфраструктура как код и политика доступа для единообразной эксплуатации
- Мониторинг затрат, качества данных и производительности
Инфраструктура, интеграции и lifecycle sandboxes
Эффективная реализация sandbox требует связки между инструментами для обработки данных и инструментами для ML. Основные элементы инфраструктуры включают построение среды, которая обеспечивает автоматизированное разворачивание песочниц, изоляцию вычислительных ресурсов и контроль доступа.
Первый элемент - оркестрация и управление жизненным циклом. Инструменты оркестрации (например, Apache Airflow, Dagster) управляют созданием отдельных рабочих пространств и запуском пайплайнов в изолированных контекстах. Важна автоматизация: созданиеsandbox-представлений, копирование перечня источников данных и подготовка тестовых наборов, внедрение миграций схем в рамках sandbox. При этом ключевым является возможность быстрого удаления окружения по завершении эксперимента без риска затронуть другие среды.
Второй элемент - хранилище данных и формат таблиц. Для DWH-слоя sandbox может использовать Delta Lake или Apache Iceberg, которые обеспечивают ACID-операции и гибкость в эволюции схем. Это поддерживает консистентность версий и упрощает откат изменений. В ML-пайплайнах важна связка с Feature Store, например Feast, для стабильного доступа к признакам в разных sandboxes и средах.
Третий элемент - вычислительная платформа. Выбор между Kubernetes и локальными кластерами зависит от объёма задач и политики безопасности. Kubernetes обеспечивает изоляцию вычислений через namespace, ресурсы и quotas, а также упрощает масштабирование. В ряде случаев целесообразно использовать контейнеризованные сервисы для завершения этапов предварительной обработки, тестирования моделей и обучения, чтобы отделить среду разработки от продакшна.
Четвёртый элемент - интеграции и качество данных. В рамках sandbox необходимы инструменты для каталогизации данных (data catalog), мониторинга качества и тестирования в пайплайнах. Контракты API и данных, в сочетании с проверками совместимости схем, позволяют быстро обнаруживать несовместимости между экспериментами и продактом.
Пятый элемент - безопасность и комплаенс. Политики доступа, аудит и шифрование должны быть встроены в процесс provisioning. В качестве примера можно упомянуть использование Open Policy Agent (OPA) для централизованного управления доступом и журналирования. Также полезна практика маскирования чувствительных полей на входе в sandbox и хранение обезличенных копий данных.
Шестой элемент - практики тестирования и воспроизводимости. Автоматизированные проверки данных на предмет полноты, точности, отсутствия дубликатов и согласованности метаданных обязательны. В ML-пайплайнах критически важно фиксировать версии моделей, гиперпараметры, окружения и наборы данных, чтобы можно было повторно воспроизвести эксперимент и сравнить его с предыдущей итерацией.
- Оркестрация пайплайнов и lifecycle sandboxes
- Хранилища данных: Delta Lake / Iceberg и связь с Feature Store
- Вычислительные платформы: Kubernetes Namespace и управляемые окружения
- Каталогизация, качество данных и тестирование
- Безопасность, аудит и контроль затрат
Практические кейсы внедрения
Данная секция включает два иллюстративных кейса, демонстрирующих практическое применение sandbox-архитектуры в DWH и ML аналитике. Оба кейса опираются на принципы, описанные ранее, и подчеркивают важность последовательности действий, от проектирования до эксплуатации.
Кейс 1: Разделение экспериментальных сред для ML-моделей на DWH-слое
Цель кейса - позволить data science-командам тестировать новые признаки и алгоритмы в изолированной среде, не затрагивая боевые данные и пайплайны. Архитектура включает: выделение sandbox-подсистем на Kubernetes, копирование необходимых наборов данных с обезличиванием и маскированием, использование схем Delta Lake для хранения версий данных и контроль доступа через RBAC и политики. В качестве примера инструментов применяются Apache Airflow для оркестрации и Feast в качестве хранилища признаков. Контроль версий данных обеспечивается через схему-реестр и ядро политики доступа, которое отсекает доступ к чувствительным полям.
Этапы внедрения включали:
- определение диапазонов данных, которые допускаются в sandbox, и маскирование персональных полей;
- создание шаблонов sandbox-окружения с преднастроенными пайплайнами;
- внедрение контроля версий для таблиц и признаков;
- настройку автоматического удаления sandbox после завершения эксперимента.
Результаты кейса подтверждают, что команда может быстрее проводить эксперименты по признакам, снижая задержку между идеей и проверкой гипотез. Важным фактором успеха стало внедрение контрактов данных и регламентов миграции схем, что позволило признакам и моделям быть совместимыми между sandbox и продактом. В рамках эксперимента был достигнут дефицит риска за счёт маскирования и ограниченного доступа к исходным данным.
Кейс 2: Эксперименты с feature engineering и deployment-валидацией
Этот кейс фокусируется на цикла циклов разработки признаков и внедрения моделей в sandbox с целью валидировать гипотезы на наиболее близких к боевым данных режимах. Архитектура включает sandbox-подсистему для подготовки признаков, интеграцию с Data Catalog и CI/CD-пайплайнами для данных и моделей. В частности, в рамках кейса применялись паттерны разделения материалов: raw sandbox для загрузки данных, processing sandbox для трансформации и feature engineering, и model sandbox - для обучения и валидации моделей. Обеспечивалась синхронизация признаков через Feature Store, что позволяло избежать дублирования вычислений и поддерживать консистентность между наборами данных.
Ключевые этапы внедрения:
- проектирование схем и контрактов для признаков, чтобы новые признаки не ломали существующие пайплайны;
- внедрение автоматических проверок качества данных и устойчивости моделей к изменениям распределений;
- настройка мониторинга показателей по каждому sandbox в реальном времени и автоматический триггер на откат при ухудшении метрик;
- создание протоколов деплоя: от тестирования в sandbox к постепенному развертыванию в продакшн.
Результат: команда получила более предсказуемую доставку новых признаков и моделей, минимизировав риски регрессионного тестирования. Функциональные требования к sandbox были расширены: поддержка нескольких версий признаков, отсечка доступа к чувствительным данным и возможность повторного воспроизведения каждого шага пайплайна.
Эволюционная дорожная карта внедрения
После первых успехов целесообразно выстроить эволюционную дорожную карту, которая включает:
- расширение набора sandbox-подсистем за счёт новых источников данных и моделируемых окружений;
- усиление механизмов мониторинга и аудита по всем средам;
- внедрение централизованной политики управления изоляцией и доступом на уровне инфраструктуры;
- упрощение управления затратами через автоматическую очистку устаревших sandbox и квотирование вычислительных ресурсов;
- расширение применения паттернов «data contracts» и схемной регистрации на уровне всего DWH-слоя.
Безопасность, комплаенс, мониторинг и управление затратами
Безопасность данных становится критическим фактором при использовании sandbox-сред. В рамках данного раздела рассматриваются подходы к защите информации, обеспечению соответствия регуляторным требованиям и управлению рисками.
Во-первых, контроль доступа и аудит. Включение RBAC/ABAC, разделение ролей, а также политика минимального доступа позволяют ограничить видимость данных. В дополнение применяют централизованные политики доступа через OPA. Аудит действий пользователей и пайплайнов должен быть полной записью и возможностью ретроспективного анализа.
Во-вторых, маскирование и обезличивание данных. В sandbox допускаются копии данных с обезличиванием персональных характеристик на входе в процесс анализа. Это не только снижает риск, но и упрощает тестирование гипотез без нарушения приватности. В случаях, когда требуется полная идентифицируемая информация, доступ ограничивается на уровне роли и времени, с расширенным аудитом.
В-третьих, мониторинг и регуляторные требования. Непрерывный мониторинг затрат, производительности и качества данных позволяет своевременно выявлять аномалии - например, резкое увеличение потребления ресурсов при тестировании новой модели. Регистрация процессов обработки и хранения, включая источники, трассировку изменений и версии данных, необходима для аудита и регуляторной готовности.
В-четвёртых, управление затратами. Sandbox должен быть экономически управляемым: ephemeral compute, автоматическое удаление окружений, бюджетирование и тегирование ресурсов. В крупных организациях возможно внедрять управляемые политики «приоритетов» для разных направлений исследований и балансы между скоростью экспериментов и стоимостью вычислений.
- RBAC/ABAC и OPA для контроля доступа
- маскирование данных и обезличивание
- аудит и трассировка изменений
- мониторинг затрат и производительности
- регуляторная готовность и соответствие внутренним политикам
Архитектурные паттерны и готовые решения
Для повторяемости и масштабирования sandbox-архитектура использует несколько паттернов. Первый - разделение сред на несколько кластеров или пространств имен: dev, test, sandbox, sandbox-prod-pretend с ограничениями и правилами перехода. Второй - паттерн data contracts: набор обязательных полей, типов, ограничений, которые должны соблюдаться при любом изменении данных. Третий - паттерн схемной эволюции: поддержка версий схем и миграций без разрушения совместимости. Четвертый - паттерн «sandbox as code»: описания окружения и пайплайнов в инфраструктурном коде, что обеспечивает повторяемость и контроль изменений.
В качестве примеров технологий и продуктов, которые часто применяются в рамках sandbox, можно отметить следующие: Delta Lake как надёжный формат хранения с поддержкой ACID и схемной эволюции; Apache Iceberg как альтернатива с аналогичной функциональностью; Apache Airflow как инструмент оркестрации пайплайнов; Dagster как современная альтернатива с концепцией «runtime-ink» и встроенной поддержкой тестирования. В ML-области упоминаются Kubernetes для изоляции вычислений и возможности масштабирования, а также Feast как открытое решение для Feature Store. Важно ограничиться 1-2 примерами на раздел, чтобы избежать перегрузки текстом и сохранить фокус на конкретных задачах.
- Pattern A: отдельные sandbox-окружения в кластере
- Pattern B: общий sandbox с изоляцией через политики доступа и виртуальные окружения
- Pattern C: sandbox как часть CI/CD-пайплайна для данных и моделей
Key takeaways
- Sandbox обеспечивает безопасную и воспроизводимую среду для экспериментов в DWH и ML аналитике.
- Эффективная изоляция требует разделения по уровням данных, вычислений и доступа, а также контрактов данных.
- Инфраструктура должна поддерживать lifecycle sandbox: создание, конфигурацию, тестирование и удаление.
- Инструменты оркестрации, хранилища данных и политики доступа играют ключевые роли в устойчивой эксплуатации.
- Управление затратами и мониторинг являются критическими для масштабирования sandbox в рамках крупной организации.
- Контракты данных и регистры схем упрощают совместимость между экспериментами и продактом.
- Безопасность, аудит и соответствие требованиям регуляторов должны быть встроены в архитектуру с самого старта.
FAQ
- Что такое sandbox в контексте DWH и ML аналитики?
Sandbox - это изолированная среда, где данные, вычисления и пайплайны могут безопасно использоваться для тестирования гипотез, разработки моделей и проверки новых признаков без риска влияния на боевые данные и производственные процессы. Обычно sandbox поддерживает ограничение доступа к чувствительным данным, копирование наборов данных с маскированием и автономное выполнение вычислений, чтобы избежать конкуренции за ресурсы и ошибок в продакшне.
- Как выбрать уровень изоляции и какие зоны должны быть в sandbox?
Уровень изоляции определяется рисками и требованиями к данным. Часто применяют три слоя: data sandbox (копии данных с обезличиванием), compute sandbox (вычислительные ресурсы для моделей и трансформаций) и governance sandbox (контракты, политики доступа, аудит). Рекомендовано иметь dev/test sandbox для разработок и отдельный sandbox-подкласс для экспериментов в ML, чтобы отделить постановку задач от продвинутой валидации.
- Какие технологии чаще всего применяются для sandbox в DWH и ML?
Наиболее распространённые паттерны включают использование Delta Lake или Apache Iceberg для хранения версий данных, Apache Airflow или Dagster для оркестрации пайплайнов, Kubernetes для изоляции вычислений, и Feast как средство управления признаками в рамках нескольких sandboxes. В проектах с сильной регуляторной нагрузкой может применяться Open Policy Agent (OPA) для реализации политик доступа и соответствия.
- Какие метрики и процессы обеспечивают воспроизводимость экспериментов?
Необходимо фиксировать версии данных, моделей, окружения и гиперпараметров. Метрики должны включать качество данных, стабильность признаков, показатели модели (точность, ROC-AUC и т.д.), а также время исполнения пайплайна. Воспроизводимость достигается хранением конфигураций в системе контроля версий, журналированием всех изменений и созданием повторяемых пайплайнов с неизменяемыми артефактами.
- Что важно учитывать при управлении безопасностью в sandbox?
Важны ограничения доступа, надёжный аудит и маскирование персональных данных. Политики доступа должны применяться на уровне API и пайплайнов, а данные чувствительные - обезличиваться. Регулярные аудиты и тесты на проникновение помогают выявлять слабые стороны. В рамках регуляторных требований полезно внедрять централизованный мониторинг доступа и политик, а также хранить логи в неизменяемом формате.
- Как предотвратить утечку данных при работе в sandbox?
Ключевые меры - минимизация копирования чувствительных данных, маскирование входов, изоляция вычислений и строгий контроль доступа. Необходимо внедрить политики жизненного цикла для копий данных, автоматическую очистку устаревших окружений и регулярные проверки соответствия. Также полезно внедрять контроль версий и аудит для всех операций с данными.
- Как оценивать стоимость sandbox и управлять бюджетом?
Необходимо устанавливать quotas и бюджеты на вычисления, использовать ephemeral compute и автоматическое удаление окружений после завершения экспериментов. Мониторинг затрат по sandbox-объектам и тегирование ресурсов позволяют распределять расходы между командами и направлениями исследований, а также оптимизировать использование ресурсов.
- Как sandbox интегрируется с MLOps и пайплайнами данных?
Sandbox служит базовой площадкой для разработки и тестирования признаков и моделей, после чего переходят в пайплайны MLOps для развёртывания в продакшн. Включение Feature Store, совместимых версий данных и моделей, а также регламентаций в пайплайнах обеспечивает плавный переход от эксперимента к эксплуатации. Важно обеспечить прозрачность между sandbox и продактом, чтобы не возникало расхождений в версиях и зависимостях.
- Какие риски характерны для внедрения sandbox и как их снижать?
Основные риски - избыточная сложность инфраструктуры, несоответствие политик доступа, задержки в развёртывании изменений и потенциальное дублирование копий данных. Снижение рисков достигается через четкое определение границ sandbox, применение инфраструктуры как кода, автоматизацию тестирования и регламентов миграций схем. Кроме того, ключевые политики должны быть внедрены с самого начала проекта.
- Какие метрики успеха можно использовать для оценки эффективности sandbox?
Эффективность можно оценивать по скорости вывода гипотез, количеству параллельно запущенных экспериментов, времени до повторяемости результатов, качеству данных, устойчивости моделей и степени исключения влияния экспериментальных изменений на продакшен. Также важны экономические показатели: общий рейтинг затрат на sandbox-окружения и экономия времени команды на проведение экспериментов.
sandbox-архитектура в DWH и ML аналитике представляет собой комплексный подход, совмещающий архитектурные принципы, инфраструктурные паттерны и управляемую дисциплину процессов. Реальные кейсы показывают, что целостное решение в виде изолированных сред, контрактов данных и управляемых пайплайнов позволяет ускорить инновации, снизить операционные риски и обеспечить соблюдение регуляторных требований без компромиссов в качестве данных и моделей.


