

Контекст: роль Data Mart в BI и self-service
В современных архитектурах данных Data Mart выступает не просто хранилищем для отдельных отделов, а узлом, связывающим бизнес-онтологии, консистентные метрики и понятные пользователю витрины. В контексте курса Data Mart Standards этот подход становится основой единого набора правил, который обеспечивает совместную работу BI-аналитиков и пользователей self-service: от формулирования бизнес-терминов до доступа к данным и их обновления. Правильное понимание роли Data Mart в BI и self-service позволяет избежать избыточной изоляции между аналитическими слоями и снижает риск расхождения между ожидаемыми и фактическими значениями показателей.
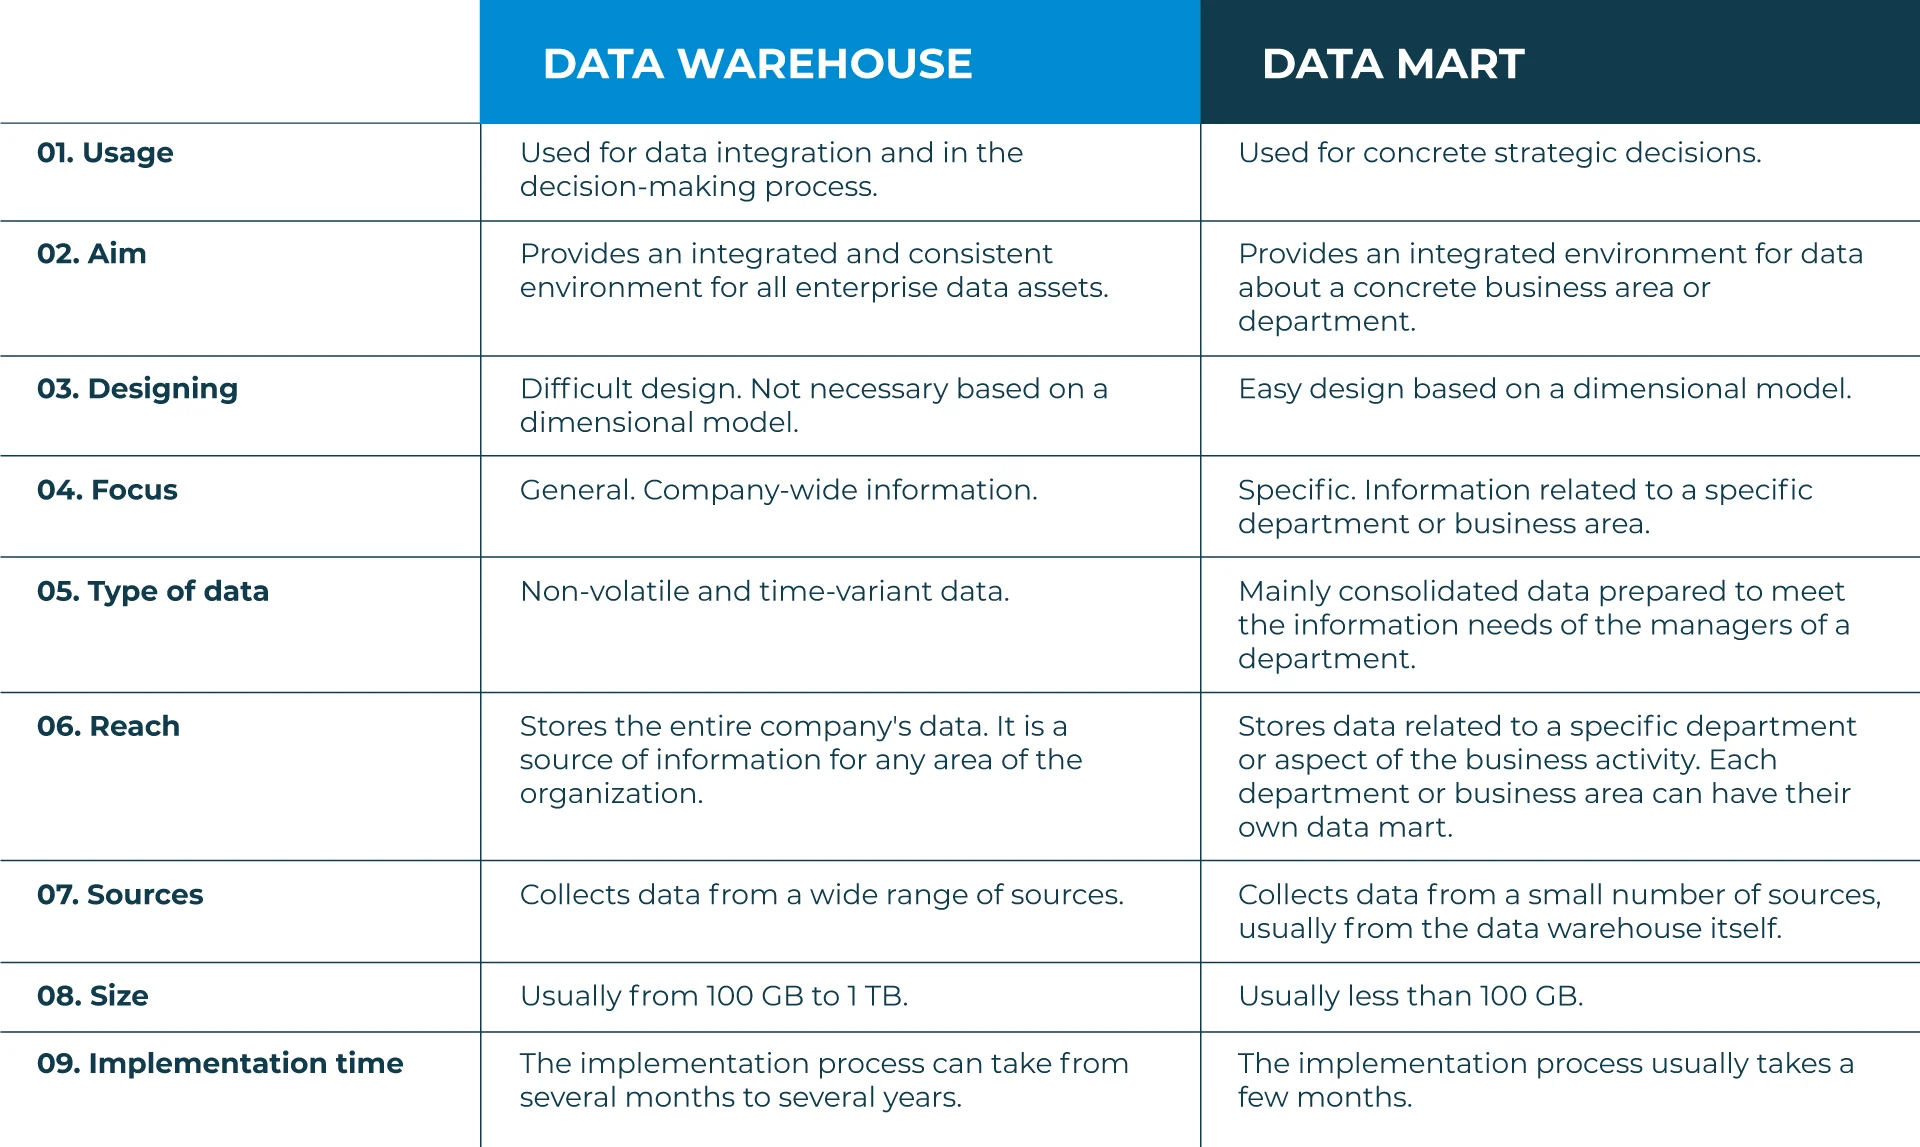
Data Mart выступает на стыке трех важных задач: консолидации данных из разнородных источников, обеспечения понятной и управляемой аналитики для бизнес-пользователей и поддержки гибкости self-service подходов без риска нарушения целостности данных. Это требует четко выстроенной архитектуры, согласованных схем витрин, управляемого процесса интеграции и непрерывного мониторинга качества и безопасности. В рамках данного раздела будут рассмотрены базовые концепции, которые позволяют перейти к практическим стандартам: как формируются слои архитектуры, какие схемы витрин применяются для поддержки консистентного анализа, какие процессы и протоколы обеспечивают единое поведение систем и пользователей, а также какие организационные практики необходимы для устойчивого внедрения.
Ключевые идеи главы заключаются в следующем:
- Data Mart должен служить единым источником истины для целевых витрин, сохраняя консистентность и управляемость метрик в BI и self-service.
- Архитектура витрины должна разделять стадии подготовки данных, их конформность и слой представления, что позволяет масштабировать использование данных без дублирования бизнес-логики.
- Стандарты по моделированию и управлению данными включают выбор схем витрин, соглашения по именованию, семантике, качеству и безопасности, а также инструменты для каталогизации и мониторинга.
- Интеграции и процессы обработки данных должны комбинировать лучшие практики ETL/ELT, управление зависимостями и мониторинг качества в рамках единой политики.
- Управление жизненным циклом витрин, безопасность и контроль доступа - фундамент для доверия к данным в рамках BI и self-service.
Краткое содержание главы
- Определение роли Data Mart в BI и self-service в контексте единой архитектуры данных.
- Архитектура витрины данных: уровни, конформность, semantic layer и принципы повторного использования.
- Схемы витрин: преимущества и ограничения star, snowflake, Data Vault и их применение для единообразия метрик.
- Интеграции, протоколы обмена данными и управление качеством: ETL/ELT, lineage, мониторинг и каталогизация.
- Безопасность, управление доступом и жизненный цикл витрин: governance, аудиты, контроль доступа и миграции версий.
- Рекомендации по внедрению стандартов и организационные практики для устойчивой эксплуатации.
Архитектура Data Mart: концепции, уровни и конформность
Архитектура витрины данных должна проектироваться как многоуровневая система, обеспечивающая четкое разделение ответственности и возможность масштабирования. Обычно выделяют три слоя: staging (или ods-слой), core Data Mart и presentation/semantic layer. Staging используется для инкапсуляции источников, загрузки сырой информации и ранней очистки. Core Data Mart состоит из конформированных фактов и измерений, где бизнес-логика нормализуется и агрегируется. Semantic layer отвечает за понятную бизнес-терминологию, единые метрики и правила экспорта данных в BI-инструменты и self-service-платформы.
Одной из важнейших концепций является конформность измерений. Конформные измерения и факты позволяют нескольким витринам и дашбордам сравнивать и агрегировать данные без противоречий. Это достигается через стабильные определения мер, единый набор измерений и строгие соглашения по имени, типам и временным границам. В рамках Data Mart Standards именно конформность становится базовым правилом, поскольку она обеспечивает согласованность между различными аналитическими интерфейсами и исключает ситуацию, когда одно и то же понятие имеет по-разному определенную трактовку в разных витринах.
Переход к одному слою представления требует продуманного слоя semantic, который обеспечивает общие термины, бизнес-словарь и правила агрегаций. Semantic layer минимизирует расхождения между IT-логикой и восприятием бизнес-пользователями: пользовательский интерфейс BI и self-service-платформы работают с единообразной семантикой и метриками, не запрашивая повторный доступ к сложной трансформационной логике в базах данных.
Практическими направлениями являются:
- проектирование слоев для поддержки повторного использования и разделения обязанностей между командами данных и бизнес-пользователями;
- определение конформности измерений, которые позволяют проводить кросс-витрины и сравнения без привязки к конкретным источникам;
- создание единого бизнес-словаря и согласованных KPI, которые фиксируются в metadata и доступны через semantic layer;
- внедрение механизмов мониторинга и аудита, чтобы отслеживать соответствие между данными и их семантическим определением.
С точки зрения инструментов и технологий в гибридной архитектуре можно упомянуть использование подходов ETL и ELT в зависимости от нагрузки и возможностей источников, применение оркестрации задач через открытые инструменты (например, Apache Airflow) и моделирования через современные средства трансформации данных (например, dbt). Такие решения позволяют обеспечить управляемость процессов и прозрачность для операторов и аналитиков.
Data Mart в Self-Service: единообразие, каталог и шаблоны
Self-service analytics требует доступности, но и управляемости. Data Mart стандартизирует набор адаптируемых шаблонов витрин, где бизнес-пользователи могут быстро сопоставлять свои запросы с готовыми конструкциями, не нарушая целостность данных. Эту функцию обеспечивает единая семантика, бизнес-глоссарий и набор предопределённых моделей витрин. В качестве примера стоит рассмотреть управляемые шаблоны для типовых предметных областей: продажи, маркетинг, финансы, операционные показатели. Шаблоны позволяют ускорить создание отчётов и дэшбордов в BI-инструментах и в self-service-платформах за счёт повторного использования конформных определений и мер.
Каталогизация метаданных и линейность данных (data lineage) здесь выступают ключевыми компонентами. Бизнес-пользователь должен увидеть, как данные проходят через источники, трансформации и агрегации, понять, какие версии фактов используются, и видеть, как изменяются определения KPI со временем. Применение открытых систем каталогизации и управления метаданными (например, в сочетании с инструментами вроде Great Expectations для контроля качества и Amundsen/OpenMetadata для каталога) обеспечивает прозрачность и доверие к витринам.
Важно подчеркнуть, что единообразие не означает жесткую стандартизацию без контекста. Гибкость self-service достигается за счет контекстуальных представлений: бизнес-термины и примеры использования должны быть привязаны к конкретной витрине, но при этом сохранять общую семантику. Это достигается через:
- наличие единого бизнес-словаря и формулировку KPI, которые согласованы с бизнес-заказчиками;
- создание и поддержание наборов тестов качества данных для ключевых метрик;
- предоставление доступных, но безопасных мостов между витринами и инструментами BI/self-service.
В рамках практики использовать можно сочетание инструментов: для моделирования - dbt; для оркестрации - Apache Airflow; для мониторинга качества - Great Expectations; для каталогизации - OpenMetadata. Элементы интеграции должны быть совместимы со стандартами и обеспечивать единообразие через конформные определения и политики доступа.
Схемы витрин и их влияние на дизайн и использование
Схемы витрин являются основой для структуры данных и поведения аналитических запросов. В архитектуре BI и self-service чаще всего выбирают три базовых подхода: Star Schema, Snowflake Schema и Data Vault. Каждый подход обладает своими преимуществами и ограничениями. В рамках Data Mart Standards целесообразно рассмотреть их в связке, а не как взаимоисключающие альтернативы.
-
Star Schema обеспечивает простую и понятную структуру, где факты централизованы, а измерения денормализованы. Такая схема хорошо подходит для быстрых ответов в self-service и для визуализаций, где требуется простая навигация по измерениям. Основной риск - дублирование информации и ограничение гибкости в изменении бизнес-логики, что требует строгого управления конформностью и консервативной политики версий.
-
Snowflake Schema повышает нормализацию, снижает избыточность и обеспечивает более тонкое управление зависимостями между измерениями. Это подходит для крупномасштабных витрин, где каждая отрасль имеет специфические атрибуты. Однако комплексность схемы может усложнить пользовательскую навигацию в self-service, поэтому необходима качественная семантика и понятные механизмы агрегаций.
-
Data Vault ориентирован на устойчивость к изменению источников и историческую версию данных. Он хорошо подходит для регрессионного анализа, аудита и долгосрочного сохранения истории. Для бизнес-пользователя Vault обычно требует дополнительных уровней презентейшн и бизнес-слоя, чтобы не перегружать интерфейс сложной логикой. В рамках стандарта целесообразно рассмотреть Vault как базовый слой для источников и истории, а поверх него строить конформные витрины в Star или Snowflake для представления бизнес-аналитики.
С точки зрения реализации стоит рассмотреть принципы:
- конформность на уровне измерений и фактов для кросс-витринной сопоставимости;
- аккуратная версия трансформаций и контроль изменений в схемах;
- поддержка временных измерений и Slowly Changing Dimensions (SCD) для точного отражения изменений в атрибутах;
- единая номенклатура имен и описание атрибутов в метаданных, чтобы пользователи знали, какие данные и как именно агрегируются.
Реализация данных принципов в легитимной среде требует документирования правил миграции схем, четких соглашений по обновлению витрин и механизмов тестирования на соответствие конформности. В практических условиях можно опираться на существующие подходы моделирования и поддерживать гибкость через слои представления, которые позволяют бизнес-пользователям работать с привычной структурой данных, не погружаясь в детали трансформаций.
Интеграции, протоколы и качество данных
Эффективная интеграция данных - это не только загрузка данных в витрины, но и обеспечение прозрачности, управляемости и контроля. В Data Mart Standards следует выстроить единый набор процессов и протоколов, которые охватывают источники, трансформации и представление. Основные направления включают:
- ETL/ELT-подходы: выбор стратегии зависит от объема данных, задержки обновления и доступности источников. ETL полезен при необходимости глубокого контроля на входе, ELT - при больших объемах и возможности переноса вычислительной нагрузки в хранилище.
- Оркестрацию и планирование загрузок: использование открытых решений вроде Apache Airflow позволяет централизованно управлять зависимостями, повторяемостью и мониторингом процессов.
- Метаданные и линейность данных: построение карты происхождения данных (data lineage) и бизнес-словаря крайне важно для понимания происхождения и трансформаций. Каталоги метаданных облегчают поиск и повторное использование витрин.
- Контроль качества данных: внедрение стандартов валидации данных на каждом этапе (из источников, в процессе трансформаций и на уровне представления) снижает риск недостоверной аналитики в BI и self-service.
На практике рекомендуется сочетать инструменты для обеспечения прозрачности и контроля. Например, инструмент трансформации данных в сочетании с оркестратором и системой тестирования качества позволяет обеспечить качественный и предсказуемый поток данных от источников до витрин. В контексте self-service особенно важны понятные метаданные и линейность, чтобы пользователи могли проверить происхождение показателя и понять, какие источники и преобразования вели к конкретному результату.
Важно обеспечить совместимость между инструментами и стандартами. Например, схема именования и формата атрибутов должны быть едины и применяться как в транзакционных источниках, так и в витринах, чтобы запросы и визуализации приходили с предсказуемой семантикой. Влияние протоколов доступа и форматов обмена данными отражается на скорости обновления витрин и на устойчивости к изменениям источников. Поэтому особое внимание уделяется выбору протоколов доступа (JDBC/ODBC, REST API), форматов данных (параметризованные JSON/Parquet/ORC) и способам синхронной или асинхронной передачи обновлений.
Культурный аспект интеграции данных важен: в командах должны существовать четкие правила взаимодействия между данными инженерами, аналитиками и бизнес-специалистами. Это включает совместную работу над определениями KPI, процедурами тестирования и политиками версии витрин. В итоге Data Mart становится не просто техническим узлом, а средством, соединяющим бизнес-циели и технологическую реализацию в едином стандартизированном контуре.
Управление безопасностью и жизненным циклом витрин
Безопасность и управление доступом являются неотъемлемой частью Data Mart Standards. Основные принципы включают:
- риск-ориентированное разграничение доступа: реализуется через ролевая модель и политики атрибутного доступа, включая ролевые атрибуты, временные разрешения и минимальные привилегии;
- прозрачность и аудит: журналирование доступа к данным, изменений в схемах и трансформациях, чтобы обеспечить возможность аудита и восстановления;
- защита конфиденциальной информации: применение маскирования данных, приватизации и ограничения вывода чувствительных полей в self-service;
- контроль изменений и миграции версий витрин: последовательная миграция и откаты, тестирование на совместимость, документирование изменений в semantic layer;
- соответствие требованиям регуляторов: обеспечение вычислительной и юридической легитимности использования данных, управление правами доступа для пользователей в рамках политик организации.
Эти аспекты необходимо внедрять по принципу "security by design" и сопровождать принципами безопасности на протяжении всего жизненного цикла витрин: от планирования и проектирования до развёртывания, эксплуатации и поддержки. В качестве примеров можно упомянуть интеграцию с корпоративными системами управления идентификацией (например, интеграцию с Azure AD или аналогичными системами) и применение политик маскирования на уровне хранилища и presentation layer.
Жизненный цикл витрин предполагает:
- документирование изменений и версий моделей витрин;
- регламент обновления и тестирования при изменениях источников;
- планирование релизов и миграций, включая откаты;
- мониторинг производительности и доступности витрин, чтобы своевременно выявлять узкие места и риски для бизнеса.
Эти практики обеспечивают устойчивость и доверие к Data Mart как к основному источнику истины для BI и self-service, что особенно важно для горизонтальных и вертикальных бизнес-подразделений, которые должны работать с едиными данными и едиными правилами агрегации.
Рекомендации по внедрению стандартов и организационные практики
Успешное внедрение стандартов Data Mart требует плана действий, ориентированного на устойчивое развитие архитектуры и культуры данных. Основные действия включают:
- формирование единого набора стандартов: именование, типы данных, форматы, метаданные, описания измерений и атрибутов;
- создание бизнес-словаря и процесс поддержки семантики: обеспечение доступности терминов и их определения для всех пользователей;
- централизованный каталог витрин и линейности: создание прозрачной карты происхождения данных и траектории изменений;
- разработку политики доступа и безопасности: роли, права, политики маскирования и аудит;
- внедрение процессов управления изменениями и миграциями версий витрин: регламенты релизов, тестирования и отката;
- внедрение практик CI/CD для данных: автоматизированные тесты качества, верификации схем и согласование изменений между командами;
- обучение и вовлечение бизнеса: понятные руководства, примеры и готовые шаблоны витрин, которые можно быстро адаптировать под потребности;
- выбор инструментов: сочетание open-source и коммерческих решений для оркестрации, качественного контроля и каталогизации данных. В рамках hybrid-подхода следует обеспечить баланс между гибкостью self-service и контролируемостью через конформность и единые метаданные.
Организационные изменения включают внедрение ролей и ответственности: владельцы витрин, инженеры данных, аналитики, бизнес-уровень и службы управления данными. Это обеспечивает ясный набор задач и ответственности на каждом этапе жизненного цикла витрин. Важно поддерживать культуру совместной ответственности за качество данных и прозрачность использования витрин.
Стратегия внедрения стандартов должна быть поэтапной: начать с ядра конформной витрины и базовых KPI, затем расширять набор витрин и семантику, параллельно внедряя каталог и governance-процессы. Такой подход позволяет быстро получить ощутимую ценность и при этом постепенно наращивать управляемость и защиту.
Key takeaways
- Data Mart выступает центральной связующей точкой между источниками, аналитикой BI и self-service пользователями, обеспечивая единые термины, KPI и правила агрегаций.
- Архитектура витрины с конформной слоем позволяет поддерживать кросс-витринную сопоставимость и единые бізнес-показатели.
- Выбор схем витрин (Star, Snowflake, Data Vault) должен основываться на балансе между простотой использования в self-service и потребностью в гибкости и истории изменений.
- Интеграции и качество данных требуют унифицированных процессов ETL/ELT, оркестрации и мониторинга, с акцентом на прозрачность через lineage и metadata.
- Безопасность и жизненный цикл витрин должны быть встроены на стадии дизайна, с чётко прописанными правами доступа, аудитами и управлением версиями.
- Внедрение стандартов должно сопровождаться организационными изменениями, обучением, шаблонами витрин и поэтапной реализацией с акцентом на быстрый ROI.
FAQ
- Какова основная роль Data Mart в BI и self-service?
Data Mart служит единым, управляемым источником данных с конформной семантикой и согласованными KPI, который поддерживает как традиционную BI-аналитику, так и self-service-пользователей. Он обеспечивает согласованность значений, прозрачность происхождения данных и возможность повторного использования моделей витрин. Это снижает риск расхождений между отчётами и ускоряет создание самодельной аналитики без нарушения целостности данных.
- Какие принципы архитектуры особенно важны для поддержки self-service?
Ключевые принципы включают: разделение подготовки данных и представления, конформность измерений, единый semantic layer с бизнес-терминологией, наличие бизнес-словаря, понятные шаблоны витрин и прозрачную линейность данных. Self-service пользователи получают быстрый доступ к готовым, проверенным моделям, а аналитики - возможность управления качеством и семантикой на уровне витрины.
- Как выбрать между Star, Snowflake и Data Vault в витрине?
Выбор зависит от целей: Star обеспечивает простоту и скорость для визуализаций; Snowflake снижает дублирование и сложность изменений; Data Vault удобен для больших архиваций и частых изменений источников. В практике часто используют комбинацию: Vault как основа для истории и источников, поверх которой строят Star или Snowflake витрины для бизнес-аналитики.
- Какие инструменты лучше сочетать для поддержки стандартов?
Рекомендуется сочетать: dbt для моделирования и трансформаций, Apache Airflow для оркестрации, Great Expectations для контроля качества данных, OpenMetadata или Amundsen для каталога и lineage. Эти инструменты поддерживают гибкость и одновременно обеспечивают управляемость и прозрачность витрин.
- Какие данные относятся к критичным и как обеспечить их защиту?
Критичные данные - это данные, связанные KPI, финансовой и персональной информацией. Их защиту обеспечивают role-based access, минимальные привилегии, маскирование данных, аудит доступа и мониторинг. В self-service особенно важно ограничивать вывод чувствительных полей и предоставлять безопасные преднастроенные витрины с необходимым минимумом данных.
- Как интегрировать качество данных в повседневную работу?
Качество данных должно проверяться на каждом этапе: источники → трансформации → представление. Введите валидаторы, тесты на корректность, тесты на соответствие определениями KPI и правил агрегации. Мониторинг и автоматизированные уведомления помогут своевременно реагировать на проблемы и поддерживать доверие к витринам.
- Каковы лучшие практики управления изменениями витрин?
Разработайте регламенты версий и миграций, внедрите тестовую среду, используйте откаты и документирование изменений в метаданных. Применяйте CI/CD для данных, где возможно, и поддерживайте связь между бизнес-типами изменений и техническими обновлениями витрин, чтобы бизнес-пользователи знали, какие изменения влияют на их отчеты.
- Как организовать обучение и поддержку бизнеса в контексте стандартов?
Создайте набор готовых шаблонов витрин, руководства по использованию и примеры KPI, сопровождаемые пояснениями в бизнес-словаре. Регулярно проводите тренинги по семантике и обновлениям витрин, обеспечивая поддержку через центр знаний и доступ к каталогу метаданных.
- Какую роль играет каталог метаданных и lineage?
Каталог метаданных и lineage обеспечивают прозрачность источников данных, трансформаций и конечных витрин. Это критично для аудита, поддержки и доверия пользователей; пользователи могут увидеть, откуда берутся значения KPI, какие правила применяются и какие версии данных доступны.
- Какие риски следует учитывать при внедрении Data Mart Standards?
Среди рисков - избыточная бюрократия, задержки в обновлениях, недостаточное вовлечение бизнеса, слабый контроль доступа и некорректная конформность. Чтобы минимизировать риски, необходимо поддерживать баланс между гибкостью self-service и контролем качества, а также строить процессы на прозрачной архитектуре, с четко документированными правилами и активной поддержкой со стороны организации.


