

Обогащение данных: неструктурированные и полуструктурированные источники
Обогащение данных в рамках CDP представляет собой переход от сырых сигналов к информированным признакам, которые можно использовать для точной сегментации и персонализации маркетинга и продаж. В основе лежит способность извлекать смысл из текста, образов и шумных пайплайнов логов, преобразуя их в структурированные свойства профиля клиента. Эта глава посвящена продуктовой стороне обогащения: какие компоненты продукта обеспечивают захват, обработку и интеграцию неструктурированных и полуструктурированных источников, какие сценарии внедрения реализуют бизнес-ценности, и какие риски сопровождают такие решения.
Неструктурированные и полуструктурированные данные обладают высоким потенциалом для создания богатых признаков: тональность взаимодействий, направления интереса, контекст покупательской коммуникации, документы с историей взаимоотношений и визуальные сигналы из изображений и сканов. Однако их эффект достигается только через продуманную архитектуру продукта: коннекторы к источникам, механизмы извлечения структуры, верификация качества, сопоставление с единым профилем клиента и интеграция в сегментный и персонализирующий функционал CDP. В этой главе рассматриваются архитектурные принципы и практические сценарии внедрения, опираясь на требования к функциональности продукта: повторяемость процессов, управляемость качеством данных, прозрачность происхождения признаков и соблюдение нормативов.
- Ключевые концепции и ценности обогащения: увеличение полноты профиля за счет информации из неструктурированных источников; улучшение точности сегментов и персонализации; повышение устойчивости к шуму через управление качеством и контекстом.
- Продуктовая архитектура обогащения: коннекторы и адаптеры, движок извлечения признаков, слой нормализации и верификации, профиль данных и метаданные, слои поддержки приватности и комплаенса, интерфейс управления правилами и мониторинга.
- Этапы внедрения: анализ источников, определение целевых признаков, проектирование пайплайна обработки, внедрение в профиль клиента, тестирование и измерение эффекта на сегментацию и кампании.
Краткое содержание главы
- Архитектура обогащения в CDP: коннекторы, пайплайны, верификация и управление качеством.
- Обогащение неструктурированными источниками: типы данных, вызовы, подходы к извлечению смысла.
- Обогащение полуструктурированными источниками: извлечение структуры из JSON/XML/логов и привязка к профилю.
- Инструменты и паттерны: ETL/ELT, NLP, OCR, инференс признаков и управление данными.
- Внедрение в CDP: сценарии, управление качеством и риски, планы эксплуатации.
Архитектура обогащения данных в CDP
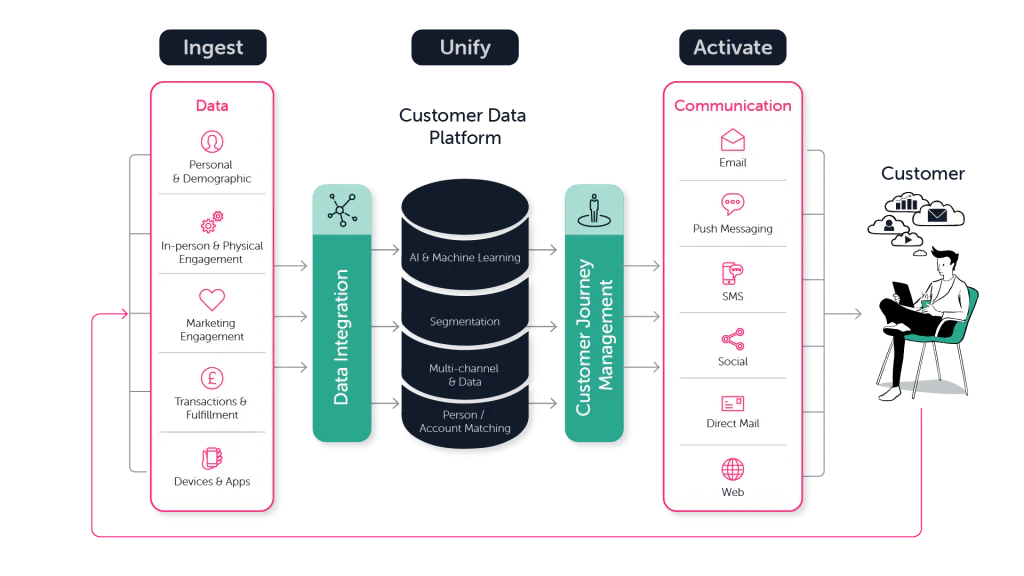
Архитектура обогащения должна обеспечивать беспрепятственный поток данных от источников к единому профилю клиента и далее к сегментам и персонализации. В рамках продукта это значит наличие четко описанных компонентов и контрактов между ними.
- Коннекторы к источникам. Необходимо поддерживать широкий набор источников: текстовые чаты, письма и заметки агентов, звуковые записи, PDF-документы, изображения и сканы, веб-страницы, логи платформ и CRM-экспорт. В целях устойчивости следует предусмотреть повторяемые конфигурации коннекторов, обработку ошибок и retry-политики.
- Движок извлечения признаков. Здесь реализуется обработка неструктурированных и полуструктурированных данных: OCR для документов, NLP-пайплайны для текста, извлечение сущностей, тональности, намерений и топиков, извлечение метаданных из файлов (язык, дата, источник).
- Слой нормализации и верификации. Признаки преобразуются в согласованные типы данных и форматы, проводятся валидации, нормализация единиц измерения, привязка к существующим полям профиля (ивенты, сигналы взаимодействия, атрибуты устройства). Верификация качества выполняется на каждом шаге пайплайна: охват, полнота, точность извлечения, доверие к источнику.
- Профиль данных и метаданные. Все признаки сохраняются как свойства профиля. Включаются метаданные источника, язык, уровень доверия, дата обновления и правила использования (например, правила согласия на обработку персональных данных). Это обеспечивает прозрачность происхождения признаков и возможность аудита.
- Интерфейсы управления и мониторинга. Продуктовый слой должен предоставлять UI/конфигурацию для определения признаков, правила их обработки и соответствие политикам компании. Мониторинг качества данных, алерты по аномалиям, дашборды по проникновению признаков в профили и в сегменты - критически важны для эксплуатации.
- Обогащение и персонализация. Итоговые признаки применяются к сегментациям, рекомендациям и персонализированным каналам. Важно обеспечить обратную связь: какие признаки действительно влияют на конверсии и отклики кампаний, чтобы корректировать пайплайны.
Почему так устроено именно в продукте CDP? Потому что без единообразной модели профиля, которая связывает признаки из разнородных источников, сегменты будут расплывчатыми, а персонализация - неконстантной по качеству. Продуктовая архитектура должна обеспечивать управляемость, повторяемость и прозрачность, что важно для бизнес-метрик и регуляторных требований.
На практике архитектура обогащения взаимодействует с модулями идентити-рипло (identity resolution), сегментации, хранения признаков и слоя персонализации. Взаимодействие с обработкой неструктурированных данных часто реализуется через пайплайны, ориентированные на события (streaming) и пакетные пайплайны (batch), что позволяет балансировать между задержками и полнотой данных. Выбор паттерна зависит от бизнес-требований: для оперативной персонализации полезна более низкая задержка, тогда как для глубокой аналитики и устойчивой сегментации - более полное извлечение признаков возможно посредством пакетной обработки.
Компоненты продукта и связь между ними
- Коннекторы к источникам должны поддерживать расширяемость и версию интерфейсов. Они несут ответственность за первоначальное извлечение данных и передачу на этап обработки.
- Модуль извлечения признаков должен быть модульным и конфигурируемым: можно добавлять новые модели NLP, новые правила OCR, обновлять словари топиков без изменения остальной архитектуры.
- Нормализация и согласование признаков требуют единых справочников: терминологий, бизнес-словарей, лингвистических норм и политик обработки ПД. Это обеспечивает единообразие и сопоставимость признаков на уровне профиля.
- Управление качеством данных и мониторинг должны быть встроены в конвейеры: правила валидации, механизмы возврата ошибок, уведомления и регламентированные шаги коррекции.
- Инструменты управления политиками приватности, согласиями и юридическими ограничениями должны быть частью UI и процесса развёртывания пайплайнов, чтобы соответствовать требованиям регуляторов и корпоративной стратегии данных.
Практически это означает, что продукт CDP должен предоставлять готовые к использованию наборы коннекторов и обработчиков, а также гибкие средства конфигурации без необходимости глубокой переработки кода. В случае больших корпораций это включает многоуровневую архитектуру с разделением обязанностей: команды по данным занимаются настройкой и мониторами пайплайнов, команды безопасности - политиками хранения и доступа к признакам, бизнес-единицы - тестированием и оценкой влияния на кампании.
Неструктурированные источники: типы данных и подходы обработки
Неструктурированные данные охватывают широкий спектр форм языка и медиа: текстовые взаимодействия, аудиозаписи, изображения, сканированные документы, видеоконтент. Они содержат богатый сигнал о предпочтениях, настроениях и контексте взаимоотношений с брендом. Однако для использования в CDP необходимо перевести их в признакный формат и привязать к идентичности клиента.
Типы данных и источники
- Текстовый контент взаимодействий: чат‑истории, письма, заметки агентов, отзывы, комментарии в соцсетях. Эти данные часто не имеют фиксированной структуры, но несут сигнальные признаки: темы, вопросность клиента, уровень удовлетворённости.
- Аудио и видео: звонки в контакт-центр, видеосессии сопровождением покупок. Их сигналы извлекаются через автоматическое распознавание речи (ASR) и последующий NLP.
- Документы и изображения: PDFs, сканы договоров, визитки, скрины экрана, фото упаковки. Они требуют OCR и извлечение контекстуальной информации (номера договоров, даты, артикулы).
- Веб- и мобильный контент: страницы и формы на сайте, страницы , клик‑путы и поведенческая информация. Часто включают разнообразные форматы и вложения.
Проблемы и вызовы
- Низкое качество сигнала и шум. Тексты на разных языках, разговорные формы, сленг, опечатки.
- Многоязычность и культурные различия. Локализация и обработка естественного языка требует адаптированных моделей.
- Неоднородность форматов. Разные источники возвращают разные наборы полей, иногда без явной структуры.
- Наличие PII и чувствительной информации. Необходимо обеспечить защиту данных и соответствие правилам.
Подходы к обработке
- Извлечение смысла через NLP и NER. Традиционные методы: моделирование тональности, тематическое моделирование, выделение сущностей и контекста. Современные подходы - трансформеры для извлечения зависимостей и смысловых связей.
- Контекстуализация и кластеризация. Признаки основаны на семантике и контексте, а не только на лексической близости. Это помогает выявлять скрытые интересы и намерения.
- Этапы преобразования. Конвертация данных в единый формат признаков: язык и региональная настройка, нормализация единиц измерения, эскалация неоднозначностей через управление доверием к источнику.
- Верификация качества. Примеры проверок: обнаружение ошибок OCR, корректность распознавания имен собственных, сравнение с существующими профилями и верификация повторяемости признаков.
Реализация в CDP
- Интеграция конвейеров обработки. Через пайплайны обработки можно внедрять новые модели NLP, обновлять словари и правила трактовки.
- Связь с единым профилем. Признаки из неструктурированных источников сопоставляются с идентификаторами клиента и агрегируются в профиль.
- Управление довериями. Каждое извлечение сопровождается уровнем доверия и источником. Это позволяет бизнесу оценивать влияние признаков на сегменты и кампании.
- Мониторинг и аудит. Логирование шагов обработки, прозрачность происхождения признаков и возможность отката к предыдущим версиям признаков.
Практические принципы внедрения
- Начинать с пилота по конкретному источнику. Выберите набор источников с наиболее ценными сигналами (например, чат-истории и звонки). Постепенно расширяйте коннекторы.
- Определять целевые признаки заранее. Формулируйте набор признаков для сегментов и персонализации, например: тематика взаимодействия, вопрос-решение, уровень боли клиента, доверие к бренду.
- Обеспечивать управляемость сигналами. Для каждого признака задавайте источники, правила пересчета, доверие и период обновления.
- Встраивать обратную связь. Результаты кампаний и отклики пользователей должны возвращаться в пайплайн, чтобы корректировать признаки и правила.
Опыт внедрения в продуктах CDP
- Пайплайны энrichment, ориентированные на события. В реальном времени признаки из чатов и звонков начинают влиять на сегменты в течение нескольких минут после взаимодействия.
- Архитектура поддержки политики приватности. Признаки с ограниченными правами доступа требуют дополнительной фильтрации и анонимизации на уровне слоев обработки.
- Инструментарий управления данными. Встроенные каталоги данных и lineage позволяют бизнесу видеть, какие признаки пришли из каких источников и как они применяются к сегментам.
Полуструктурированные источники: извлечение структуры из иерархий
Полуструктурированные данные обладают частичной структурой, которая упрощает их связывание с едиными профилями, но требует специальных инструментов и методологий. JSON, XML, логи, CSV с переменной схемой - все это потенциальный источник признаков, если правильно интерпретировать вложенные уровни данных и зависимости.
Типы и примеры
- JSON‑поля и XML‑документы. Обычно встречаются в API-выходах систем продаж и поддержки, в логах событий клиента и в обменах между сервисами.
- Логи приложений и веб‑сайтов. Часто приходят потоками и несут данные об активности клиента, статусах API‑звонков, ошибках и задержках.
- CSV/планшетные данные с переменной схемой. Иногда в файлах встречаются вложенные списки и вложенные объекты, требующие дополнительной нормализации.
Подходы к обработке
- Инференс схемы и маппинг полей. Использование правил для автоматического вывода структуры при обработке нового источника, а затем привязка к существующим бизнес-словарям.
- Применение схемон‑рейта. Включение в пайплайн проверки соответствия данных предопределенным схемам; поддержка версии схемы для эволюции данных.
- Извлечение ключевых признаков. На основе вложенной структуры извлекаются сигналы: идентификаторы транзакций, связи между сущностями, временные рамки событий.
- Гибкая нормализация. Привязка полей к единым именам и форматам, чтобы далее признаки можно было использовать в модельном профиле и сегментах.
Реализация в CDP
- Модуль согласования схем. Позволяет автоматически выносить новые источники в стандартизованный набор полей и значений.
- Преобразование к единому формату признаков. Полуструктурированные данные превращаются в структурированные признаки с пометками источника и доверия.
- Связь с идентификацией клиента. Признаки из полуструктурированных источников связываются с существующими идентификаторами и профилями, поддерживая единообразие и консистентность.
- Контроль качества и аудит. Проверки на полноту, некорректные значения и дубликаты. Возможность отката изменений и анализа влияния признаков на сегменты.
Практические рекомендации
- Фокус на наиболее ценными полуструктурированными данными. Начните с источников, где структура понятна и связь с профилем сильна.
- Внедряйте гибкие правила сопоставления полей. Конфигурационные правила позволяют быстро адаптироваться к изменению источников без переработки кода.
- Поддерживайте версионирование схем. Эволюция источников требует прозрачной истории изменений, чтобы можно было восстанавливать предыдущие признаки и оценки их влияния.
Инструменты и подходы: ETL/ELT, NLP, OCR, признаки и управление данными
Для реализации обогащения в CDP применяются сочетания инструментов и методологий. В продуктовой логике это означает готовые к применению модули и настроиваемые конвейеры, которые легко адаптируются под бизнес‑контекст и требования к скорости и качеству.
Концептуальные компоненты
- Интеграционные коннекторы. Готовые адаптеры к источникам данных с возможностью расширения. Они обеспечивают перенос данных в пайплайн с минимальными задержками и корректной обработкой ошибок.
- Инструменты извлечения признаков. Включают OCR для документов, NLP/NER для текста, а также модели для извлечения намерений, тональности и тем. Важно иметь модульность: можно обновлять модели без изменения архитектуры.
- Этап нормализации и обогащения. Привязка извлеченных признаков к единым форматам и справочникам, объединение признаков, управление контекстом и довериями.
- Слоий хранения признаков и профиля. Признаки должны храниться в консиcтентизированной форме и иметь линейку доверия, источника и временной метки.
- Мониторинг качества и governance. Системы мониторинга и алертов, инструменты аудита и каталог данных с прослеживаемостью происхождения признаков.
Практические паттерны
- Streaming ETL и ELT. Для неструктурированных данных часто применяют комбинацию потоковой и пакетной обработки: первые признаки формируются оперативно, вторичные признаки - в пакетной обработке для глубокой аналитики.
- Модульность и повторяемость. Продуктовая архитектура должна позволять добавлять новые источники и признаки без крупных изменений в существующих пайплайнах.
- Контроль качества на уровне пайплайна. Пороговые значения качества, валидации типов данных, корректности обобщения и соответствия политик конфиденциальности.
- Управление данными и приватность. Встроенные политики доступа, маскирование и минимизация данных, управление согласием клиентов.
Открытые и локальные примеры инструментов
- Apache NiFi в роли коннектора и маршрутизатора данных между источниками и пайплайнами обработки. NiFi хорошо подходит для многоуровневых пайплайнов, гибкости и мониторинга.
- Apache Spark в роли вычислительного ядра для обработки больших массивов данных и реализации сложных NLP и анализа текста. Spark обеспечивает масштабируемость и возможность интеграции с хранилищами данных.
- По необходимости можно рассмотреть OpenSearch/Elasticsearch для индексации и быстрого поиска по признакам, а также Tika для контент-экстракции из документов.
Порядок внедрения
- Шаг 1: картирование источников и целевых признаков. Определение того, какие неструктурированные и полуструктурированные источники будут обогащаться и какие признаки будут извлечены.
- Шаг 2: выбор инструментов и архитектурных паттернов. Решение о секвенировании пайплайнов, выборе OCR/NLP моделей и качестве компромисса между задержкой и полнотой.
- Шаг 3: настройка коннекторов и извлечения признаков. Реализация конфигураций, тестирование на реальных данных и валидация признаков.
- Шаг 4: интеграция признаков в единый профиль. Привязка к идентификаторам клиента, управление правилами использования признаков и контекстом.
- Шаг 5: тестирование эффектов на сегменты и кампании. Непосредственно оценка влияния на точность сегментации и персонализацию.
- Шаг 6: мониторинг, аудит и эволюция пайплайнов. Регулярный анализ качества, обновление моделей и соблюдение политик приватности.
Внедрение в CDP: сценарии и риски
Сценарии внедрения обогащения данных в CDP часто строятся вокруг стратегий персонализации и повышения конверсии. Ниже приведены типовые сценарии и ключевые риски, которые необходимо учитывать на этапе планирования.
Сценарий 1: персонализация на основе текстовых взаимодействий
- Источники: чат, письма, заметки агентов, отзывы.
- Признаки: тематика, намерение, эмоциональная окраска.
- Влияние: более точные гипотезы сегментации и персонализированные месседжи.
- Риски: качество NLP, языковая вариативность, приватность и согласие на обработку текста.
Сценарий 2: использование документов и изображений
- Источники: PDFs, сканы договоров, квитанции, визитки.
- Признаки: номера договоров, даты, позиции в документах, артикулы.
- Влияние: автоматическое связывание истории клиента с контрактами и покупками.
- Риски: точность OCR, юридические требования к хранению документов, обработка PII.
Сценарий 3: анализ логов и поведения на сайте
- Источники: веб-лог, мобильные события, API‑звонки.
- Признаки: последовательности действий, частота событий, задержки в ответах.
- Влияние: более точные сигналы интереса и склонности к покупке.
- Риски: корректное сопоставление с профилем клиента, защита от фродовых сигналов.
Сценарии внедрения по уровням сложности
- Базовый MVP. Подключение 1-2 источников, извлечение нескольких признаков и их привязка к основному профилю. Быстрый запуск, ограниченный набор сегментов.
- Расширенный пайплайн. Добавление 2-3 источников, больше признаков и начальное внедрение в сегментирование и персонализацию на нескольких каналах.
- Эволюционная платформа. Полновесное обогащение неструктурированными и полуструктурированными данными, полноценные модели доверия признаков, сложная сегментация и многоканальная персонализация, структурированная прозрачность происхождения признаков и аудиты.
Оценка и управление рисками
- Приватность и правовые требования. Обособление чувствительных данных, соблюдение политик согласия, маскирование и минимизация данных.
- Качество данных. Контроль за точностью, полнотой и стабильностью признаков. Регулярная валидация и аудит.
- Управление производительностью. Задержки обработки, масштабируемость пайплайнов, бюджет на вычисления.
- Этические и бизнес-риски. Контекстуализация и корректировка использования признаков, чтобы не создавать предвзятости сегментаций и персонализации.
Key takeaways
- Неструктурированные и полуструктурированные источники являются ценным, но сложным источником сигналов для CDP: они требуют специализированной обработки и управляемого конвейера признаков.
- Архитектура обогащения должна включать коннекторы, движок извлечения признаков, нормализацию, единый профиль населения и governance слой с мониторингом качества.
- Продуктовая реализация требует модульности и повторяемости: возможность добавлять новые источники и признаки без переработки кода и без риска для существующей функциональности.
- Инструменты и подходы должны сочетать OCR, NLP/NER, схемы обработки и управление довериями к признакам. Важна прозрачность происхождения признаков и возможность аудита.
- Внедрение в CDP требует ориентированности на бизнес-цели: повышение точности сегментации, улучшение персонализации и измерение эффективности кампаний. При этом должны быть учтены риски приватности, качества данных и производительности.
- Практическая дорожная карта начинается с пилота на ограниченном наборе источников, затем расширяется на новые сигналы и каналы, а затем превращается в устойчивую экспертизу по обогащению в рамках CDP.
- Реализация должна опираться на проверяемые метрики: охват признаков, точность извлечения, влияние на конверсии и качество сегментов, а также на показатели соблюдения политики приватности.
FAQ
- Что считается неструктурированным источником по сравнению с полуструктурированным?
- Неструктурированные источники - это данные без явной схемы, например текст взаимодействий, аудио/видео сигналы, изображения и сканы. Они требуют извлечения смысла и признаков через NLP, OCR и визуальный анализ.
- Полуструктурированные источники - это данные с частично заданной структурой, например JSON, XML, логи, CSV с переменной схемой. Их можно сопоставлять с едиными полями через схемы и правила инференса.
- Как выбрать инструменты OCR и NLP для CDP?
- Выбор зависит от языковой группы, требований к точности и скорости обработки. Для OCR чаще применяются локальные или облачные решения с поддержкой многоязычности и постобработки ошибок. Для NLP - модели, обеспечивающие извлечение сущностей, тем и эмоциональной окраски, а также эффективную обработку длинных текстов.
- В контексте продукта важна модульность: можно заменить одну модель без переработки всей архитектуры. Также важно учитывать затраты на внедрение, качество и требования к приватности.
- Как обеспечить качество обогащения и контроль доверия к признакам?
- Признаки должны иметь метаданные: источник, время обновления, уровень доверия и правила использования. Проводите регулярные проверки качества: сравнение признаков с ручной разметкой, мониторинг устойчивости признаков со временем, контроль за точностью извлечений.
- Визуальные и автоматические проверки помогают выявлять деградацию моделей и ошибок в конвергенции признаков.
- Как согласовать неструктурированные признаки с существующим профилем клиента?
- Используйте идентификационный слой CDP, который связывает признаки с идентификаторами клиента. Признаки должны быть нормализованы к единым типам и форматам, чтобы их можно было агрегировать в профиль.
- Введите логику разрешения конфликтов признаков и ретроверсии: если два признака противоречат друг другу, сохраняйте оба и назначайте более высокий уровень доверия одному источнику.
- Какие инфраструктурные требования предъявляются к обогащению?
- Требуется обработка на уровне управления данными, масштабируемости и скорости. Рекомендуются гибридные архитектуры, поддерживающие как потоковую обработку для оперативной персонализации, так и пакетную для глубокой аналитики.
- Важна интеграция с хранилищами данных, системами каталогов и средствами мониторинга. Соблюдение политик приватности и безопасности - обязательная часть архитектуры.
- Какие лучшие практики сохранения приватности и соответствия требованиям законодательства?
- Минимализация данных: обрабатывайте только те признаки, которые необходимы для целей персонализации. Маскируйте или вытесняйте чувствительную информацию там, где это возможно.
- Контроль согласий и политики доступа. Управляйте конфиденциальностью на уровне набора признаков, источников и каналов передачи.
- Аудит и прозрачность. Включайте в пайплайны механизмы аудита, отчеты о происхождении признаков и возможность отката к предыдущим версиям признаков.
- Как измерить эффект обогащения на ROI?
- Введите показатели влияния признаков на сегментацию, конверсии и отклики кампаний. Сравнивайте сегменты и результативность кампаний до и после внедрения обогащения, контролируя внешние факторы.
- Отслеживайте влияние на точность предиктивной модели: прирост точности классификации, улучшение ROC-AUC и прочие метрики, связанные с целями маркетинга и продаж.
- Проводите тестирование гипотез и A/B‑тестирования для оценки влияния конкретных признаков на показатели конверсии.
- Какие риски на этапе эксплуатации и как их минимизировать?
- Риск деградации качества признаков. Регулярно обновляйте модели и обновляйте данные обучения; применяйте мониторинг и алерты.
- Риск нарушения приватности. Придерживайтесь политики согласия и минимизации данных; используйте маскирование и агрегацию там, где возможно.
- Риск перегрузки системы. Планируйте горизонтальное масштабирование, устанавливайте пороги на обработку и очереди, мониторьте производительность пайплайнов.
- Как выстроить устойчивую дорожную карту внедрения обогащения?
- Начните с MVP на 1-2 источниках и ограниченным набором признаков, чтобы быстро получить бизнес‑ценность.
- Расширяйте коннекторы и признаки по мере роста понимания бизнес‑потребностей и возможностей инфраструктуры.
- Вводите governance и мониторинг на ранних этапах, чтобы обеспечить прозрачность и соответствие регуляторным требованиям.
- Включайте бизнес‑единицы в тестирование и оценку эффекта на сегментацию и персонализацию.
- Какие примеры итоговых показателей в CDP после внедрения обогащения?
- Увеличение охвата целевых признаков в профиле клиента.
- Улучшение точности сегментов и повышение отклика на персонализированные кампании.
- Снижение времени отклика персонализации до необходимого срока.
- Повышение удовлетворенности клиентов и конверсий по целевым каналам.


