

Терминология CDP: определения, границы и ключевые концепты
CDP (Customer Data Platform) становится центральной точкой синергии данных клиентов: от первичных источников до активных каналов коммуникации. В рамках курса рассматриваются понятия, которые позволяют единообразно говорить о терминах, границах и концептах. Правильная терминология служит основой для проектирования архитектуры, согласования ожиданий стейкхолдеров и выстраивания управляемого процесса внедрения. В данной главе представлены базовые определения, границы CDP и ключевые концепты, которые встречаются в современных реализациях.
CDP выступает как объединение разрозненных данных о клиентах в едином контексте, поддерживающее обработку, идентификацию, сегментацию и активацию аудиторий. Важно понимать, что понятие CDP не является монолитной парадигмой: в организациях встречаются различные реализации и степени зрелости, где границы между CDP, DMP, CRM, DWH и IDM могут быть размытыми. Сохранение четкой терминологии позволяет снизить риски недопонимания между бизнес-единицами, data engineering и data governance.
В рамках главы рассмотрены: определения и границы CDP, архитектурные составляющие, модели данных и их эволюции, управление идентификацией и профилем, роли и процессы управления данными, а также практические принципы внедрения терминосистемы в реальных проектах. Особое внимание уделяется балансу между теоретическими концепциями и практическими сценариями внедрения, чтобы аудитория могла переходить от слов к действиям без потери целостности концепций.
- Определение CDP, границы и отличие от соседних систем (CRM, DMP, DWH, IDM).
- Архитектура CDP: профили клиентов, идентификаторы, потоки данных и их жизненный цикл.
- Модели данных CDP: атрибуты профиля, динамические сегменты, контекст и аудит.
- Границы CDP и принципы интеграций: что входит, что не входит, и как выстраивать взаимодействие с соседними решениями.
- Термины, согласие и управление данными: PII, lineage, governance, роли и процессы.
- Практические аспекты внедрения терминологии: глоссарий, коммуникации, изменения и управление рисками.
Что такое CDP: определения и границы
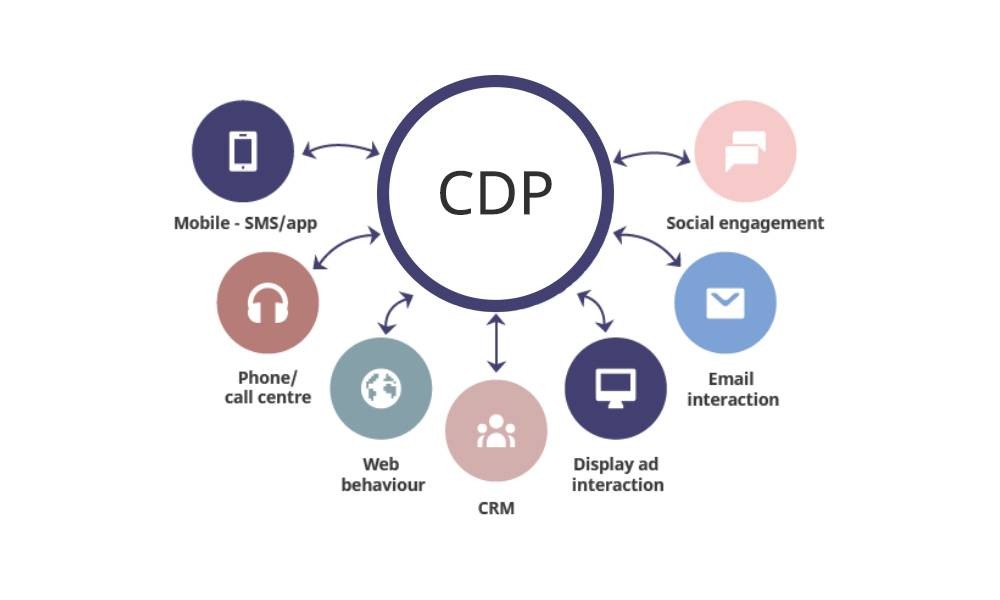
CDP определяется как система, которая объединяет данные о клиентах из множества источников, приводит их к единому обозреваемому профилю и поддерживает активацию аудиторий через различные каналы. При этом важна не только полнота данных, но и качество их согласования и доступность в режимах реального времени или близких к нему. В рамках этой концепции выделяются несколько ключевых элементов: единый профиль клиента, идентификаторы, потоки данных, обработка и активация.
Определение и основные границы
CDP - это платформа, ориентированная на хранение и обработку личной информации клиентов в пределах предприятия, поддерживающая создание целостного представления о клиенте и эффективную активацию аудитории. Границы CDP традиционно включают:
- источники данных первого лица (web and mobile interactions, CRM систем, офлайн-источники);
- процессы нормализации и сопоставления идентификаторов;
- построение единого профиля и его версионирование;
- сегментацию и передачу сегментов в activation channels (маркетинг, сервисные каналы, партнёры);
- базовую слежку за качеством данных и соблюдение политики приватности.
CDP взаимодействует с рядом соседних решений: CRM - для операционной видимости клиентов; DMP - для активации аудиторий в рекламе; DWH/Лабораторные хранилища - для аналитических задач; IDM/ETL-платформы - для инфраструктурных процессов. В реальной архитектуре границы часто пересекаются и усредняются в зависимости от зрелости организации и требований к скорости обновления данных.
Важной характеристикой CDP является концепция «одной истинной записи» (single customer view) и способность поддерживать детализированный профиль, который может дополняться новыми атрибутами на протяжении времени. Однако в рамках границ следует помнить о требованиях к персональным данным, согласиям пользователей и политике приватности, что вынуждает рассматривать CDP не только как техническое, но и как управляемое корпоративное решение.
Архитектурные контуры и роли данных
Архитектура CDP обычно включает следующие слои:
- источник данных и инпуты: веб- и мобильные события, CRM, ERP, офлайн-источники, партнёрские данные;
- слой очистки и нормализации: согласование форматов атрибутов, привязка атрибутов к единым семантикам;
- идентичность и сопоставление: формирование и поддержка графа идентификаторов, разрешение дубликатов;
- слой профилей: хранение и эволюция профилей клиентов, включая версии и временные атрибуты;
- сегментация и активация: создание аудиторий и передача их в каналы коммуникации;
- обеспечение соответствия и управление качеством данных: защита приватности, управление согласиями, аудит и lineage.
Ключевыми концепциями являются:
- профиль клиента как агрегированный набор атрибутов и поведения;
- идентификаторы и граф идентификации, включающий deterministic и probabilistic методы;
- версия профиля и логи обновления данных;
- контекст и событие как источник дополнительной информации для профиля;
- управляемые процессы согласия и приватности.
Архитектура CDP: профили, идентификаторы и потоки данных
Данные в CDP движутся через конвейер from-source → normalize → identity → profile → segments → activation. Этот конвейер отражает жизненный цикл данных и позволяет обеспечить последовательность и согласованность.
Профиль клиента и его состав
Профиль клиента - это объединённый view на персону или сущность клиента, состоящий из атрибутов (демографика, предпочтения, статус подписки), поведения (события, транзакции, взаимодействия) и контекстной информации (сессии, устройство, география). В профиль могут входить как фиксированные данные (имя, email), так и динамические сигналы (последнее действие, частота покупок). Важно различать структурированные свойства (атрибуты) и поведенческие сигналы (активность, события), а также хранение версий и временных отметок.
Наличие хорошо описанного профиля позволяет:
- быстро строить и обновлять аудитории;
- обеспечивать консистентную активацию на разных каналах;
- анализировать траектории клиента и выявлять паттерны.
Идентификаторы и детерминирование
Идентификаторы - это ключи, которые связывают различные источники данных с одним и тем же клиентом. В CDP применяются как детерминированные идентификаторы (например, зафиксированные email/phone, клиентский идентификатор в приложении), так и вероятностные (probabilistic matching) на уровне графа идентификаторов. В современных реализациях строится Identity Graph - сеть взаимосвязей между идентификаторами, которая позволяет перейти от одного идентификатора к другим и удержать целостный профиль клиента даже при отсутствии единого ключа повсеместно.
Ключевые принципы:
- устойчивость к изменениям идентификаторов (персональные данные могут обновляться, но связь остаётся через граф);
- минимизация дубликатов за счёт сопоставления и нормализации;
- поддержка политик приватности и согласия в контексте идентификатов (например, возможность деидентифицировать или pseudonymize данные в отдельных сценариях).
Deterministic matching обеспечивает точность сопоставления на основе заранее известных связей, в то время как probabilistic matching повышает охват, но требует оценки риска ошибки и механизмов контроля качества.
Потоки данных: от источников к активностям
Конвейер данных CDP условно развертывает следующие этапы:
- сбор и нормализация источников данных: приведение полей к единым семантикам, очистка значений, привязка к атрибутам профиля;
- обработка идентичности: сопоставление идентификаторов, обновление Identity Graph;
- сборка и обновление профиля: агрегирование атрибутов и сигналов, управление версиями;
- сегментация и аудитория: создание динамических или статических сегментов с учётом требований к частоте обновления;
- активация: передача сегментов в каналы коммуникации и внешние системы;
- мониторинг качества и управление политикой приватности: контроль соответствия требованиям, журнал изменений, аудит.
Несколько важных аспектов в потоках:
- задержка и задержка обновления: выбирается компромисс между скоростью обновления и точностью сопоставления;
- обработка ошибок и повторные попытки: гарантии доставки событий и атрибутов;
- безопасность и приватность на каждом этапе: минимизация персональной информации, шифрование при передаче, аудит доступа;
- согласование с локальными требованиями: хранение данных в рамках юрисдикций, поддержка права на удаление.
Модели данных CDP: атрибуты, сегменты и контекст
Модели данных CDP должны быть достаточно гибкими, чтобы охватывать множество источников и сценариев активации. При этом необходимо поддерживать четкую семантику и возможность эволюции схемы без разрушения текущих активностей.
Атрибуты профиля: структуры и качество
Атрибуты профиля делятся на статические (например, дата рождения) и динамические (последнее взаимодействие, текущий статус лояльности). Хорошая архитектура предусматривает:
- типы атрибутов: строка, число, дата/время, булево;
- источники атрибутов и их доверие: какой источник считается основным, как обрабатываются конфликты значений;
- политика качества данных: валидации, диапазоны, нормализация, дефолтные значения.
Важно, чтобы атрибуты поддерживалиversioning - возможность хранить изменения и возвращаться к предыдущим состояниям профиля, что особенно полезно при аудитах и ретроспективном анализе.
Сегменты и аудитория: динамика и контекст
Сегменты в CDP - это группы профилей, сформированные по набору условий. Они могут быть:
- статическими: фиксированная выборка на определённый момент времени;
- динамическими: обновляющиеся по событиям и атрибутам.
Контекстные данные добавляют смысл к сегментам: география, устройство, канал взаимодействия, временные окна. Эффективная сегментация требует ясных правил фильтрации, версионирования сегментов и управления устареванием аудитории в рамках политики приватности.
Источники и контекстные данные
Источники данных охватывают как онлайн-события (сессии, клики, покупки), так и офлайн-данные ( POS, call-центр, CRM-истории). Контекстные данные включают:
- геолокацию, устройство и браузер;
- контекст времени и поведенческие сигналы;
- метаданные источников и качество данных.
Совокупность контекстных данных обогащает профиль и позволяет давать более точные сигналы активации. Важно документировать происхождение данных (data lineage): какие источники в каком виде внесли изменение и по какому правилу, чтобы обеспечить прозрачность и соответствие требованиям регуляторов.
Логика обновления и версионирования профиля
Версионирование профиля обеспечивает сохранение состояний на различные моменты времени, что важно для ретроспективного анализа, коррекции ошибок и аудита. Обновления могут происходить на уровне:
- атрибутов профиля (изменения значения);
- событийных сигналов (новые события добавляют контекст к профилю);
- идентификаторов и их сопоставления (изменение способа связывания идентификаторов).
Правила обновления должны быть явно зафиксированы в governance-процессе: частота обновления, правила конфликтов, порядок приоритета источников и механизм отката при ошибках.
Границы CDP: что входит и что не входит
Чтобы избежать перегрузки ожидания и обеспечить ясность ответственности, важно формализовать границы CDP в отношении функций, данных и интеграций.
-
Что входит:
- единый профиль клиента и его обновление;
- управление идентификацией и сопоставление идентификаторов;
- сбор, нормализация и хранение данных из источников;
- сегментация и активация аудиторий;
- элементарное управление приватностью и согласиями (gdpr- и ccpa-подобные сценарии);
- аудит, lineage и governance основным образом.
-
Что не входит (или входит не в полном наборе функций CDP, но может потребоваться интеграция):
- глубинная аналитика на уровне больших данных и продвинтые ML/AI модели, выходящие за рамки профиля пользователя;
- сложные DMP-like постановки для поведенческих сегментов в рекламных сетях, если сеть не поддерживает интеграцию с CDP;
- оперативная CRM-автоматизация и ERP-логика, которые чаще являются частью других систем, но взаимодействуют через API/CDP.
Баланс между границами и возможностями требует чётко определённых контрактов между командами: какие данные можно использовать для активации, какие источники требуют дополнительной проверки, как обрабатываются согласия и право на удаление.
Терминология и практики: согласие, приватность и управление данными
Обеспечение прозрачности и управляемости в части терминологии критично для соответствия требованиям регулирующих органов и бизнес-целям.
Персональные данные и PII
Персональные данные и PII (Personally Identifiable Information) - центральная часть CDP. В терминах архитектуры необходимо:
- отличать PII и псевдонимизованные данные;
- обеспечивать минимизацию и защиту данных по принципу «минимального сбора»;
- поддерживать механизмы обезличивания или псевдонимизации там, где это возможно и целесообразно;
- документировать источники, связки и обработку каждого атрибута PII.
Согласие и управление императорскими данными
Согласие на обработку персональных данных критично для легитимной активации. Практики:
- управление согласиями на уровне пользователей и их контекстов;
- поддержка сценариев opt-in и opt-out, включая возможность отзыва согласия;
- хранение метаданных согласия (когда дано, на какие цели, срок действия);
- аудит соблюдения согласий и возможности удаления данных по запросу.
Прогонная линия данных (data lineage)
Lineage обеспечивает прослеживость данных от источников через все трансформации до конечной активации. Это важно для аудитов, ответственности и отладки. В рамках lineage фиксируются:
- источники данных и время поступления;
- трансформации и правила сопоставления идентификаторов;
- обработанные версии профилей и сегментов;
- точки активации и партнерские каналы.
Governance, роли и ответственности
Роли в управлении данными:
- Data Owner - владелец бизнес-доменов и полноты данных;
- Data Steward - ответственный за качество, соответствие и регуляторные вопросы;
- data architect/engineer - разработка и поддержка архитектуры CDP;
- Privacy Officer - контроль соблюдения приватности и согласий.
Процессы: модель управления изменениями, регламент версионирования схем, политики доступа и безопасной передачи данных между системами. governance-практики должны быть встроены в проект на ранних этапах, предусмотреть эволюцию терминологии и гармонизацию между подразделениями.
Практические схемы внедрения терминологии
- Разработка и поддержка общего глоссария: перечень определений, примеры и контексты использования. Глоссарий должен быть доступен всем стейкхолдерам и регулярно обновляться.
- Определение контрактов и политики межсистемной интеграции: какие данные можно передавать, в какие каналы, в каком формате; как урегулировать вопросы согласия.
- Управление изменениями терминологии: как новые термины вводятся, как устаревшие термины выводятся из активной эксплуатации и как сохраняется совместимость.
- Этапы внедрения: пилоты с clearly defined success metrics, последующая масштабируемость и поддержка в долгосрочной перспективе.
- Роли и ответственность: где документируются политики, где отслеживаются нарушения, как осуществляется аудит.
Key takeaways
- CDP - это системное решение для объединения и активации данных о клиентах через единый профиль и идентификаторы, но границы CDP зависят от контекста организации и существующей инфраструктуры.
- Ключевые компоненты CDP: единый профиль, граф идентификаторов, потоки данных, сегментация и активация, governance и согласие.
- Архитектура CDP требует четкого объяснения и документирования: какие источники данных поддерживаются, как осуществляется сопоставление идентификаторов, как обновляются профили.
- Терминология должна быть единообразной: понятия PII, согласие, lineage, governance - не просто слова, а управляемые элементы архитектуры.
- Управление данными и согласиями должно быть встроено в процессы на ранних стадиях проекта: глоссарий, политика доступа, аудит и transparency для бизнеса и регуляторов.
- Практика внедрения терминологии требует сочетания технических и организационных подходов: согласованные правила, прозрачность и обучение команд.
- Гибкость схем данных и моделей должна сочетаться с контролируемостью: версия профиля, история изменений и возможность отката к предыдущим состояниям.
FAQ
- Что такое единое клиентское хранилище и как CDP достигает единого профиля?
CDP объединяет данные из множества источников, нормализует атрибуты и идентификаторы, разрешает противоречия и строит единый профиль клиента, который может эволюционировать во времени. Единая запись достигается за счет детерминированного и вероятностного сопоставления идентификаторов, а также версии профиля, которая регистрирует изменения во времени.
- Как различаются идентификаторы в CDP и зачем нужен Identity Graph?
Идентификаторы - это ключи к связям между различными источниками данных, например email, device_id, клиентский идентификатор в приложении и т. п. Identity Graph строит граф взаимосвязей между этими идентификаторами, что позволяет перейти от одного ключа к другим и сохранить целостность профиля даже при изменениях идентификаторов.
- Какие типы атрибутов включаются в профиль, и как обеспечиваетось их качество?
Атрибуты разделяются на статические и динамические. Качество обеспечивается через валидации, нормализацию значений, управление конфликтами источников, версии атрибутов и мониторинг целостности данных.
- Что входит в governance CDP и какие роли в нем участвуют?
Governance охватывает политику доступа, управление согласиями, мониторинг соответствия требованиям, аудит и lineage. Роли включают Data Owner, Data Steward, Privacy Officer, а также архитекторов и инженеров данных.
- Каковы основные принципы управления согласиями и приватности в CDP?
Необходимо документировать цели обработки, срок действия согласия, возможность отзыва, хранить сведения о согласиях и реализовать механизмы деидентификации/псевдонимизации, где это допустимо, чтобы минимизировать риск использования персональных данных.
- Какие типы данных чаще всего встречаются в конвейере CDP и как управлять их обработкой?
Чаще встречаются веб- и мобильные события, транзакционные данные из CRM/ERP, офлайн-данные. Управление включает нормализацию форматов, обработку временных меток, обеспечение конфиденциальности и соблюдение политики согласий на каждом этапе.
- Какой подход к моделям данных CDP наиболее универсален?
Универсальная схема предполагает слои: raw, cleaned/normalized, unified profile, segments, activation. Такой подход облегчает эволюцию схемы, поддерживает версионирование и упрощает аудит данных.
- Как избежать переполнения терминологией в проектах CDP?
Необходимо поддерживать глоссарий, регламентировать новые термины через согласование со стейкхолдерами, документировать источники и контексты использования, а также внедрять обучение и сопровождение изменений.
- Какие примеры практических реализаций терминологии в реальных проектах можно привести?
Публичные примеры включают open-source решения, где есть понятная структура идентификации и профилей, например, проекты, которые демонстрируют Identity Graph и модульность слоёв данных. В рамках корпоративной практики следует учитывать локальные требования и регуляторные требования.
- Какие риски связаны с неправильной терминологией CDP на старте проекта?
Риск конфликтов между бизнес-единицами, неверная трактовка границ CDP, несоответствие требованиям приватности, злоупотребления данными и задержки в активации аудиторий. Чёткая терминология и governance позволяют минимизировать такие риски и ускорить внедрение.


