

Будущее CDP: тренды, новые подходы к персонализации и автономной аналитике
В условиях ускоренной цифровой трансформации единое клиентское хранилище (CDP) перестает быть просто хранилищем данных о клиентах. Оно становится центром принятия решений, платформой для персонализации и автономной аналитики, связующим звеном между данными, технологиями и бизнес-целями. Будущее CDP строится на архитектуре, которая способна обрабатывать потоки данных в реальном времени, поддерживать сложные модели идентификации и профилирования, обеспечивать баланс между персонализацией и приватностью, а также автоматически адаптироваться к меняющимся требованиям рынка. В этой главе представлены ключевые тенденции, концепции и типовые подходы к реализации таких систем.
Истоки будущего CDP лежат в трех взаимосвязанных направлениях: архитектурная гибкость и потоковая обработка, продвинутая модель данных с единым профилем клиента, а также автономная аналитика и автоматизированное управление качеством данных и моделями. Важную роль играют принципы безопасности и приватности данных, а также управляемая эволюция схем и интеграций, позволяющая сохранять устойчивость к изменениям channel mix, регуляторным требованиям и технологическим обновлениям. В результате CDP становится не только интегратором данных, но и движущим механизмом для систем рекомендаций, маркетинговой автоматизации и бизнес-аналитики на уровне предприятия.
Краткое содержание главы
- Архитектура будущего CDP: модульность, потоковая обработка и интеграционные паттерны.
- Модели данных и единая идентификация: профиль клиента как центральная сущность и методы разрешения идентификаций.
- Персонализация в реальном времени: decisioning, feature stores, алгоритмы и управление контекстом.
- Автономная аналитика и самонастраивающиеся модели: AutoML, мониторинг, drift-д detection и объяснимость.
- Безопасность, управление данными и внедрение: стандарты, governance, приватность и управление данными на уровне предприятия.
Архитектура будущего CDP: модульность, потоковая обработка и интеграционные паттерны
Современный CDP строится как набор взаимосвязанных модулей, каждый из которых специализируется на своем участке обработки данных: прием, очистка и нормализация, идентификационная зера, обогащение, хранение профилей, управление атрибутами и правила персонализации, а также аналитику и мониторинг. Архитектура должна быть поддержана постоянной эволюцией схем данных и контрактов между модулями. Важнейшими принципами являются:
- Потоковая архитектура и обработка в реальном времени. Событийно-ориентированная платформа позволяет не просто накапливать данные, но и оперативно внедрять правила персонализации и принимать решения на уровне конкретного клиента в нужный момент. Это требует устойчивой очереди событий, publish-subscribe паттернов и механизмов сериализации/десериализации данных, которые минимизируют задержки и потери информации.
- Модульность и контрактная интеграция. Модули должны быть заменяемыми и независимо развиваемыми, поддерживая стандартизированные RPC-интерфейсы, такие как REST или gRPC, а также брокеры сообщений (например, Apache Kafka) для асинхронной передачи данных. Контракты между модулями - четко определенные схемы данных и согласованные форматы событий.
- Архитектура данных как платформа. В центре - единая модель профиля, однако внешние источники и каналы требуют гибких адаптеров и конверсионных слоев. Важно поддерживать Catalogue данных, метаданные и lineage, чтобы видеть источник данных, трансформации и влияние изменений на downstream-потребителей.
- Data mesh и data fabric как принципы масштабирования. Разделение на домены данных с ответственностями за качество и контракты между доменами позволяет масштабировать CDP без централизации и перегруженности. Data fabric обеспечивает единое представление и доступ к данным через сетку сервисов, что особенно ценно при кросс-канальных сценариях.
- Безопасность и приватность как встроенная часть архитектуры. Шифрование на уровне сервиса, управление ключами, псевдонимизация и защита PII на стадии обработки. Принципы минимизации сбора данных и доступ по ролям помогают соответствовать требованиям конфиденциальности.
Типовые архитектурные паттерны включают:
- Event-Driven CDP: потоковая обработка данных и принятие решений в реальном времени, где каждый канал событий становится точкой входа для enrichment и профилирования.
- Lambda или Kappa архитектура: разделение слоев батчевой и потоковой обработки или объединение их в едином конвейере, поддерживающем режим continuous reasoning.
- Data Lake + Core CDP: хранилище данных в ленивой консолидированной форме с обогащениями и индексами в слое CDP.
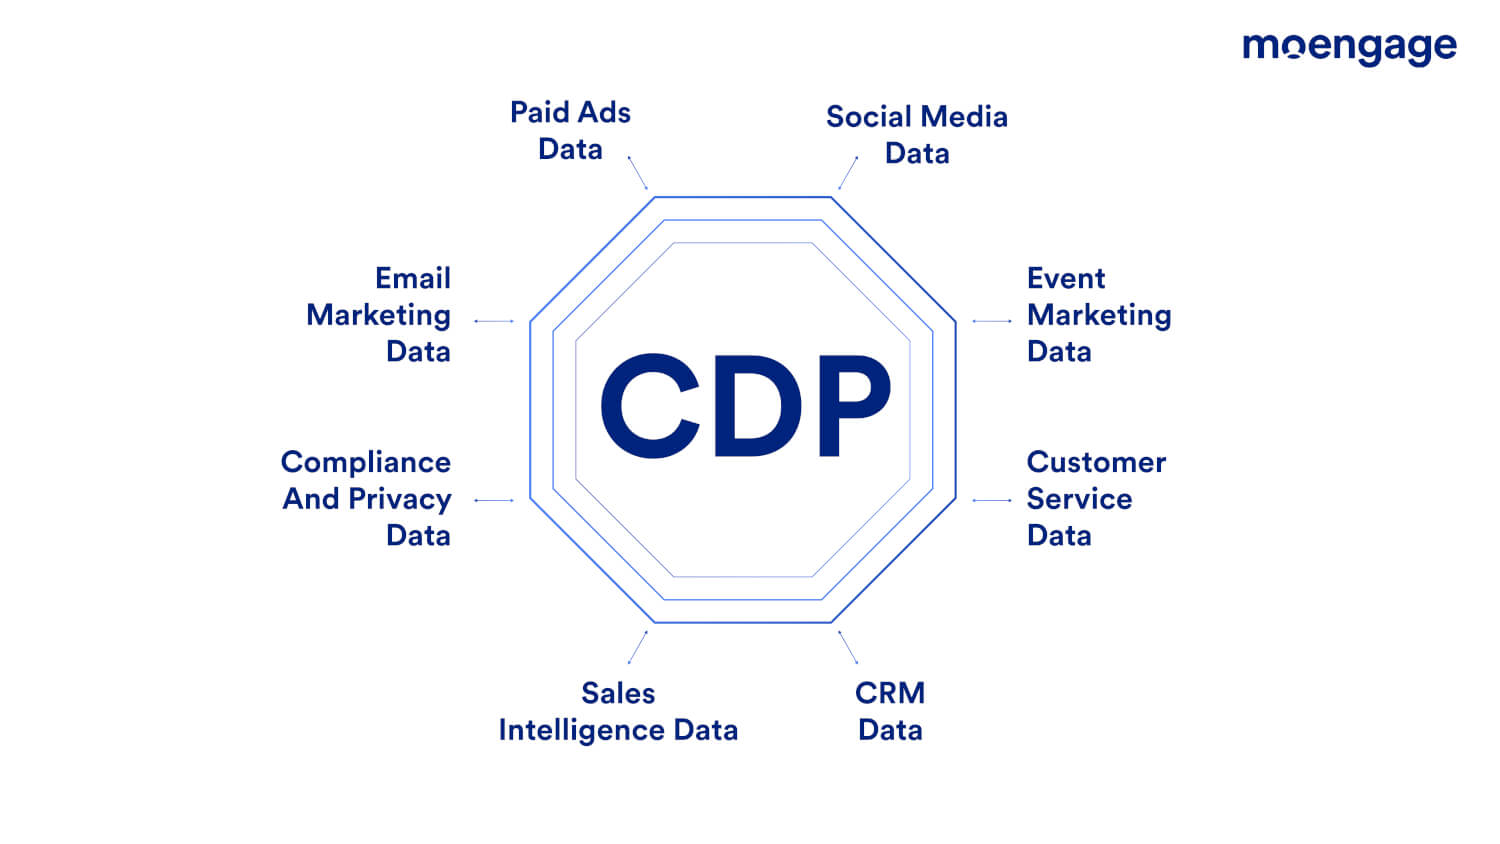
Пример схемы взаимодействий внутри CDP: источники данных (CRM, веб- и мобильные события, офлайн транзакции) направляются в конвейер приемки, затем проходят через идентификацию и унификацию профилей, enrichment и сохранение в каталог профилей. Далее активируется decisioning-модуль персонализации, который передает инструкции в каналы (website, mobile, email, ads) и регистрирует отклик в ленте анализа.
{ "event": "page_view",
  "user_id": "anon-123",
  "timestamp": "2026-02-22T12:34:56Z",
  "attributes": { "device": "mobile", "location": "Moscow" } }
Такой подход позволяет не только реагировать на поведение пользователя, но и накапливать контекст для последующей аналитики и обучения моделей. Важной частью является управление схемами, версионирование и совместимость между модулями: любые изменения должны сопровождаться миграцией контрактов и тестами совместимости.
Архитектурные решения должны учитывать требования производительности и устойчивости: горизонтальное масштабирование контейнеризированных сервисов, автоматическое восстанавливание после сбоев, мониторинг задержек и throughput, а также автоматический контроль качества данных и соответствия политик приватности.
Почему это важно. Модульная архитектура обеспечивает гибкость и скорость реакции на изменения бизнес-требований. Потоковые конвейеры позволяют снизить задержки между сбором события и персонализированным откликом, что критично для удержания клиентов и эффективности кампаний. Интеграционные паттерны и согласованные контракты снижают риск рассогласований между системами и упрощают внедрение новых источников данных.
Модели данных и единая идентификация: профиль клиента как центральная сущность и методы разрешения идентификаций
В центре CDP - единый профиль клиента, который объединяет демографику, поведенческие сигналы, транзакции и контекст канала. Однако сама идентификация клиента - сложная задача, требующая сочетания deterministic и probabilistic подходов, а также соответствия требованиям приватности и регуляторики. Фундаментальные решения включают:
- Канонический профиль и его атрибуты. Канонический профиль объединяет атрибуты из разных источников в одну «золотую запись» клиента, к которой привязаны верифицированные идентификаторы и эвристики соответствия. Архитектура должна поддерживать эволюцию схемы: новые атрибуты добавляются без нарушения существующих интеграций.
- Разрешение идентификации (identity resolution). Это процесс сопоставления различных идентификаторов (cookie, идентификаторы устройства, email, телефон) к одному профилю. Включает детерминированные правила (одинаковые значения идентификаторов) и вероятностные методы (профилирование на основе поведения и контекстов). Важно иметь конфигурацию правил и пороги доверия, чтобы балансировать точность и охват.
- Глобальный идентификатор и граф клиентов. Создание единого глобального ID облегчает агрегацию действий пользователя по каналам и устройствам. Построение клиентского графа позволяет увидеть связи между профилями, устройствами, событиями и транзакциями, поддерживая сложные сценарии ремаркетинга и кросс-канальных рекомендаций.
- Приватность и псевдонимизация. Для соответствия регуляторам следует применять техники pseudonymization, tokenization и ограничение использования PII в рабочих конвейерах. Важна возможность «разборки» профиля по требованию прав доступа пользователей и при аудиторских проверках.
- Управление конфликтами и качеством данных. Обнаружение дубликатов, несоответствий и пропусков в атрибутах требует автоматизированных правил очистки, а также процессов ручной верификации в случае критических ошибок. Метрики качества данных должны быть частью операционной панели.
Почему это важно. Единый профиль - это не просто агрегатор атрибутов, а синергия данных из множества источников, позволяющая персонализацию и аналитические выводы на уровне индивидуального клиента. Без надлежащей идентификации любая персонализация теряет точность, а бизнес-решения становятся менее воспроизводимыми и управляемыми.
Существует ряд подходов к реализации. Один из них - создание центральной таблицы профилей в data warehouse или data lakehouse с индексами по всем ключевым идентификаторам и версионностью атрибутов. Другой подход подразумевает использование графового хранилища для сохранения связей между профилями, устройствами, контекстами и событиями. В любом случае разумно внедрять политики жизненного цикла идентификаторов, регламентировать хранение PII и отслеживать происхождение атрибутов через lineage.
Для примера можно рассмотреть следующий упрощенный сценарий: поступает событие веб-страницы от пользователя с новым email-идентификатором. Многошаговая идентификационная цепочка пытается сопоставить этот идентификатор с уже существующим профилем по cookies, device ID и другим сигнатурам. В случае совпадения обновляется профиль, добавляются новые атрибуты, формируются новые сегменты и подготавливаются персонализированные рекомендации. В случае дубликатов - применяются правила слияния и версионирования, чтобы не потерять историю клиента.
{ "event": "purchase",
  "identifiers": { "cookie_id": "C1A2B3", "email": "user@example.com" },
  "attributes": { "amount": 120, "currency": "USD" },
  "timestamp": "2026-02-22T12:40:00Z" }
Важно помнить: идентификация - не одноразовый акт, а непрерывный процесс, который должен автоматически адаптироваться к новым каналам, устройствам и политическим требованиям. Управление схематикой идентификации должно сопровождаться тестированием на предмет ошибок сопоставления и механизмами отката изменений, чтобы минимизировать распространение ошибок по всем сегментам и каналам.
Персонализация в реальном времени: decisioning, feature stores, алгоритмы и управление контекстом
Персонализация сегодня выходит за рамки простой подстановки баннеров. Реализация в CDP требует интеграции потоковой обработки, контекстуализации и динамического обновления функций принятия решений. Основные принципы:
- Контекстно-зависимое принятие решений. Решения должны учитывать текущий контекст клиента: трассируемый путь пользователя, текущий канал, устройство, географическое положение и предыдущее поведение. Реализация предполагает оркестрацию между сервисами персонализации и каналами коммуникации, чтобы ответ приходил в нужный момент и через нужный канал.
- Feature store и управление признаками. Хранение подготовленных признаков с версионированием позволяет повторно использовать признаки между моделями и конвейерами, ускоряя время внедрения новых персонализационных сценариев и снижая риск повторной инженерии признаков.
- Модели и правила принятия решений. Комбинация машинного обучения и правил (rule-based) обеспечивает устойчивость и прозрачность решений. Правила полезны в ситуациях, когда необходима высокая предсказуемость и соответствие бизнес-ограничениям, тогда как ML-модели приносят адаптивные и контекстуальные рекомендации.
- Реализация в реальном времени. Архитектура доставки решений в реальном времени требует минимальных задержек, устойчивости к сбоям и гарантированной доставки. Верификация и мониторинг эвристик должны быть встроены в конвейер, чтобы выявлять деградацию точности и аномалии в откликах.
- Управление контекстом и мультиканальность. Персонализация должна быть согласована между веб, мобильными приложениями, офлайн-каналами и рекламой. Контекстная синхронизация обеспечивает непрерывность взаимодействия и единое восприятие клиента.
Почему это важно. Эффективная персонализация в реальном времени приводит к более высокому вовлечению, повышению конверсии и лояльности. Центральная роль отводится не только выбору контента, но и своевременности его доставки, устойчивости решений к изменениям поведения и способности быстро адаптироваться к новым каналам и форматам взаимодействия.
Реализация часто включает:
- Архитектуру decisioning-модуля, который подключается к источникам данных и каналам вывода, получая контекст клиента и возвращая действие в формате, пригодном для канала.
- Инструменты для мониторинга эффективности персонализации и метрик удержания по сегментам.
- Процессы тестирования и A/B-тестирования в реальном времени для проверки влияния изменений в правилах и признаках.
Возможен пример кода или конфигурации, если он необходим для объяснения конкретной реализации, например, конфигурационный фрагмент для правила принятия решения или описание процессов кеширования признаков в feature store. Однако целесообразнее держать такие примеры минимальными, чтобы не отвлекать от архитектурной концепции.
Автономная аналитика и самонастраивающиеся модели: AutoML, мониторинг, drift-дetection и объяснимость
Автономная аналитика становится основой для масштабируемого управления CDP: модели обучаются и адаптируются по мере появления новых данных, а роль человека-создателя фокусируется на постановке целей и контроле рисков. Ключевые направления:
- АвтоML и автоматическое извлечение признаков. Автоматизированные конвейеры признаков позволяют быстро переходить от идеи к работающей модели, снижая временные задержки и зависимость от узких экспертов. Такой подход ускоряет внедрение новых персонализационных сценариев и анализов поведения.
- Континуальное обучение и обновление моделей. Модели должны поддерживать циклы обучения, обновления и отката в ответ на дрейф данных или изменения бизнес-целей. Включает мониторинг качества данных, тестирование на отложенных выборках и версионирование моделей.
- Drift-detection и качество данных. Автоматизированные детекторы дрейфа помогают обнаруживать, когда поведение пользователя или распределение признаков существенно изменились, что требует перекрестной проверки и ребалансировки признаков или повторного обучения моделей.
- Explainability и driver-based explanations. В целях доверия и регуляторной прозрачности необходимо объяснять, какие признаки влияют на конкретные решения и какие драйверы поведения клиента приводят к определенным рекомендациям.
- Контроль ошибок и аудит. Все изменения моделей, источников данных и правил персонализации должны иметь аудит и возможность отката до стабильной версии.
Зачем это нужно. Автономная аналитика снижает операционную стоимость, повышает скорость внедрения и адаптации к изменениям рынка. В сочетании с объяснимостью и контролем рисков она поддерживает устойчивую и прозрачную работу CDP, что особенно важно в среде с высокими требованиями к соответствию и приватности.
Можно рассмотреть следующий конструкт: сбор данных, очистка и нормализация, автоматическое построение признаков, выбор и обучение моделей, развертывание и мониторинг, объяснимость и аудит. Взаимодействие с decisioning-модулями позволяет оперативно внедрять решения на основе обученных моделей и предоставлять контекст для дальнейшего анализа.
## Пример упрощенного потока: автообучение модели сегментации
1) собрать признаки из feature store;
2) выбрать модель на основе метрик;
3) обучить и верифицировать на отложенной выборке;
4) развернуть в онлайн-сервис и мониторить drift;
5) предоставить объяснимость по драйверам и атрибутам.
Роль мониторинга. В автономной аналитике крайне важна способность быстро распознавать деградацию, обнаруживать аномалии и управлять жизненным циклом моделей: тестирование, внедрение, мониторинг и откат. Эффективная архитектура включает в себя механизмы автоматического уведомления и планов корректировок, которые минимизируют вероятность негативного влияния на бизнес-процессы.
Интеграции, стандарты, безопасность и внедрение: протоколы, governance и управление данными
Интеграции в CDP включают как внутренняя обработка данных, так и внешнее взаимодействие с рекламными системами, CRM, аналитическими платформами и бизнес-операциями. Важно обеспечить единые интерфейсы, поддерживать стандарты обмена данными и соблюдать требования безопасности и приватности. Основные направления:
- Протоколы и форматы. REST и gRPC остаются основными интерфейсами для синхронного доступа, тогда как Apache Kafka и другие брокеры сообщений обеспечивают надежную потоковую передачу. Форматы сериализации, такие как Avro или Protobuf, обеспечивают компактность и совместимость между сервисами.
- Соединение источников и коннекторов. Встроенная поддержка коннекторов для известных источников и каналов данных упрощает добавление новых источников и ускоряет освоение платформы. Логика коннекторов должна учитывать контроль доступа, ретроспективную идентификацию и минимизацию задержек.
- Governance и качество данных. Управление данными на уровне предприятия требует наличия каталогов данных, линейной трассируемости, правил соответствия, политики доступа, версионирования схем и инструментов контроля качества. Важно прописать процессы изменения схемы, миграции и тестирования совместимости.
- Приватность и регулирование. Необходимо внедрять технику псевдонимирования, минимизацию данных, защиту PII и приватность по контексту. Поддержка региональных правил (например, управление согласием и хранение данных) должна быть встроена в управляемый конвейер данных.
- Внедрение и эксплуатация. Руководство по внедрению должно включать дорожную карту, критерии успеха, методику оценки ROI, принципы управления изменениями, обучение персонала и план устойчивой эксплуатации.
Почему это важно. Без надежной интеграционной инфраструктуры и строгого управления данными CDP рискует столкнуться с задержками, несогласованностями и регуляторными рисками. Гибкая архитектура и ясные контракты между системами позволяют быстро адаптироваться к изменениям в каналах взаимодействия, источниках данных и требованиям бизнеса.
В рамках раздела можно привести краткие примеры текущих технологий: например, для обработки потоков - Apache Kafka, Apache Flink; для хранения - современные data lakehouse решения; для API - REST и gRPC; для управления данными - каталоги метаданных и инструменты lineage. В качестве конкретики можно упомянуть по одному-два примера open-source или российских продуктов: например, Apache Kafka как протокол потоковых данных и OpenSearch/Elastic для полнотекстового поиска и мониторинга; а из российских решений - не более одного примера, если он действительно поддерживает смысл главы, например, платформы для управления данными или коннекторы. В любом случае упоминания должны служить усилению аргументов, а не перегружать текст списком.
Архитектурные паттерны и сценарии внедрения
Эта часть объединяет архитектуру, практику внедрения и управление изменениями. Основные принципы:
- Дорожная карта внедрения. Реализация CDP - это не одноразовый проект, а программное направление. Рекомендуется разделить внедрение на этапы: инфраструктура и основу данных, идентификацию и профиль, потоковую обработку и персонализацию, автономную аналитику и governance. На каждом этапе следует проводить контроль качества, тесты на соответствие и обучение сотрудников.
- Паттерны интеграции. Внедрение должно использовать стандартные коннекторы и протоколы, с готовыми контрактами данных. Это позволяет быстро подключать новые источники, не нарушая существующую архитектуру и не выбрасывая принципы приватности.
- Элемент управления изменениями. Любое обновление схем, правил персонализации или моделей должно сопровождаться планом миграций, тестами регрессии и механизмами отката. Централизованный реестр изменений и аудит позволяют быстро выявлять источник проблемы и восстанавливать работоспособность.
- Безопасность по умолчанию. Встроенная безопасность - это не опция, а базовая функциональность. Это включает шифрование в движении и на покое, контроль доступа по ролям, мониторинг попыток несанкционированного доступа и регулярные аудиты.
- Экономика и устойчивость. Важно понимать не только техническую, но и экономическую сторону проекта: расчеты ROI, TCO, оценка затрат на хранение, обработку и лицензии. Регулярная переоценка архитектуры и практик обеспечивает устойчивость к темпам изменений в технологиях и бизнес-стратегиях.
Практический следующий шаг - построение дорожной карты, которая учитывала бы конкретные источники данных, требования к приватности, целевые каналы персонализации и уровень автономии аналитики. Важно, чтобы вся дорожная карта была согласована между бизнес-инициативами и IT-подразделением, с четкими метриками успеха и механизмами коррекции курса.
Key takeaways
- Будущее CDP опирается на модульную, потоковую архитектуру, готовую к масштабированию и интеграции с разнообразными источниками данных и каналами коммуникации.
- Единый профиль клиента и эффективная идентификация являются краеугольными камнями персонализации и аналитики; методы deterministic и probabilistic должны дополнять друг друга, при этом соблюдаются принципы приватности.
- Персонализация в реальном времени требует цепочки обработки, ориентированной на контекст и каналы, поддержки feature store и сочетания правил с моделями машинного обучения.
- Автономная аналитика обеспечивает ускорение внедрения и адаптивность к изменению данных, при этом требует контроля качества данных, drift-дetection и объяснимости решений.
- Интеграции, безопасность и governance являются фундаментом для устойчивого внедрения CDP: стандарты обмена данными, контроль доступа, регуляторные требования и управляемость изменений.
- Эффективная реализация требует продуманной дорожной карты, управляемой архитектуры и тесного взаимодействия между бизнесом и IT.
- Руководство по эксплуатации CDP должно включать меры по мониторингу, обслуживанию, обновлениям моделей и процессов аудита.
FAQ
- В чем ключевое отличие будущего CDP от текущей парадигмы?
Future CDP строится на реальном времени, гибкой архитектуре, единых профилях с продвинутой идентификацией и автономной аналитикой. Это означает не просто хранение данных, а активное использование их для decisioning и самообучения моделей в рамках единого управляемого контура. Важной характеристикой является интеграция governance и приватности на уровне всей платформы, чтобы соответствовать регуляторным требованиям и ожиданиям бизнеса.
- Как обеспечить единый профиль клиента при наличии множества источников и различных идентификаторов?
Необходимо сочетать deterministic правила (одинаковые идентификаторы) и probabilistic подходы (поведенческие связи). Важна миграция к каноническому профилю с версиями атрибутов и поддержка глобального ID и клиентного графа. Применение псевдонимизации и контроля доступа поможет сохранить приватность. Регулярное тестирование матчинга, а также аудит lineage помогают поддерживать точность и доверие.
- Какие технологии наиболее полезны для реализации потоковой обработки в CDP?
Эффективная реализация требует брокеров сообщений (например, Kafka) и движков потоковой обработки (например, Flink) для низкой задержки и масштабируемости. Для хранения и аналитики применяются современные data lakehouse или data warehouse with lakehouse-подходами. Важна совместимость с REST/gRPC для синхронных вызовов и коннекторы для интеграции источников.
- Что такое feature store и зачем он нужен в CDP?
Feature store - это центральное хранилище признаков, предназначенное для повторного использования признаков между моделями и конвейерами. Он ускоряет внедрение новых персонализационных сценариев и обеспечивает консистентность данных между обучением и онлайн-инференсом. Управление версиями признаков и контроль качества критически важны для устойчивого функционирования систем.
- Как строить автономную аналитику без ущерба для прозрачности и управляемости?
Комбинация AutoML, мониторинга качества данных и drift-дetection, совместно с explainability-инструментами, позволяет автоматизировать часть процессов, сохраняя при этом возможность аудита и объяснения решений. Включение драйверов объяснимости в каждом принятом решении помогает бизнесу понять влияние факторов и снизить риск необоснованных действий.
- Какие аспекты безопасности и приватности являются критическими для CDP?
Безопасность по умолчанию должна быть встроена: шифрование в движении и на покое, ограничение доступа по ролям, контроль контрактов и хранение минимально необходимого объема PII. Управление согласием, политиками хранения и региональными требованиями должно быть частью архитектурной и операционной модели CDP, а не отдельной задачей.
- Какие шаги стоит предпринять при планировании внедрения CDP в крупной организации?
Начать с определения целей и KPI, оценить существующую архитектуру и источники данных, выбрать целевые каналы персонализации и каналы вывода. Затем сформировать дорожную карту по этапам внедрения: инфраструктура и база данных, идентификация и профили, потоковая обработка, персонализация и автономная аналитика, governance. Обязательна подготовка кадров и монтаж процессов аудита, тестирования и контроля качества.
- Как оценивать ROI внедрения CDP?
ROI следует оценивать на нескольких уровнях: качество персонализации (улучшение конверсий, роста вовлеченности), ускорение времени вывода новых сценариев, сокращение затрат на интеграцию источников и снижение эксплуатационных рисков. Важно устанавливать измеримые KPI до начала проекта и регулярно пересматривать их после внедрения.
- Какие риски связаны с автономной аналитикой и как их минимизировать?
Риски включают деградацию моделей, дрейф данных, непреднамеренное нарушение приватности и недостаточную объяснимость. Минимизировать риски можно через контроль версий моделей и данных, мониторинг drift, обязательную фазу аудита и включение механизмов отката, а также обеспечение прозрачности через объяснимость.
- С какими внешними системами CDP обычно интегрируется и как выбирать способы интеграции?
CDP интегрируется с CRM, рекламными платформами, аналитическими системами и каналами коммуникаций. Выбор способов интеграции зависит от требований к задержке, объему данных, совместимости форматов и политики приватности. Предпочтение отдают стандартным коннекторам и контрактам, которые позволяют быстро масштабировать систему и поддерживать единое имущество данных.


