

Hive оптимизация: LLAP, векторизация, операторы и статистика
Hive в экосистеме Hadoop выступает как доступный и расширяемый аналитический движок, ориентированный на обработку больших объемов данных. Однако для достижения конкурентного отклика и стабильной пропускной способности при аналитических нагрузках необходимо системно подходить к оптимизации трёх взаимосвязанных уровней: вычислительный движок и архитектура исполнения (LLAP), механизм векторизации и набор операторов, а также полнота и качество статистики для планирования. В этой главе рассмотрены принципы проектирования и реализации оптимизационных возможностей Hive, связанные с LLAP, векторизацией и эффективным использованием статистики и операторов. Особое внимание уделяется взаимному влиянию решений на производительность и на интеграцию с существующей инфраструктурой Hadoop и файловыми форматами.
Краткое содержание главы
- Архитектура LLAP как ядра ускорения Hive: принципы работы, кэширование данных и взаимодействие с Tez.
- Векторизация: принципы пакетной обработки данных, поддерживаемые типы данных и ограничения.
- Операторы и их оптимизация: выбор стратегий выполнения, пушдауны predicate, планировщик и объединения.
- Статистика и планирование: сбор статистик, роль CBO и принципы обновления метрик.
- Практические ориентиры по конфигурации и мониторингу: как структурировать процесс оптимизации и проверять влияние изменений.
LLAP как ядро ускорения Hive
LLAP (Low Latency Analytic Processing) представляет собой набор долговременных демонов, запущенных на узлах кластера, что позволяет перемещать вычисления ближе к данным и уменьшать издержки на перемещение между узлами. В архитектуре LLAP основная идея состоит в следующем: данные, необходимые для выполнения запроса, кэшируются на уровне демона, а вычисления выполняются рядом с этим кэшем. Это снижает задержку доступа к данным и обеспечивает более предсказуемую латентность, что особенно критично для интерактивной аналитики.
Технически LLAP выполняет несколько функций сразу: обработку прочитанных данных, оптимизацию ввода-вывода через ускоренный путь чтения из HDFS или Object Store, управление кешем и координацию задач в рамках DAG Tez. Взаимодействие LLAP с HiveServer2 обеспечивает быстрое развертывание и повторное использование ресурсов, а также возможность повторного использования кеша между запросами, что особенно эффективно в сценариях с повторяющимися рабочими нагрузками.
С точки зрения реализации архитектура LLAP требует согласованного управления памятью и мониторингом использования ресурсов. Объем кеша, размер пула памяти под выполнения и настройка параллелизма влияют на общий throughput и задержку. Реальные эффекты затрат на LLAP зависят от типа нагрузок: сканирование столбцовых форматов (ORC, Parquet), агрегации и соединения в больших объемах работают лучше благодаря локализации данных и конвейерной обработке.
Для эффективной эксплуатации LLAP важно учитывать следующие моменты:
- совместимость форматов и схем с локальной кэш-задачей, особенно для столбцовых форматов; Leverage columnar access и IPC-оптимизации;
- соотношение между размером кеша и рабочей нагрузкой: слишком маленький кеш не дает выгоды, слишком большой может конкурировать за память с другими процессами;
- настройка параллелизма и координации задач между LLAP и текущим исполнением (Tez или Spark в рамках одного кластера);
- мониторинг cache hit rate, latency и throughput по префиксу запросов, чтобы понимать эффект от добавления узлов или увеличения кеша.
Векторизация: принципы и реализация
Векторизация в Hive представляет концепцию обработки данных пакетами, а не по одному ряду за раз. Это снижает накладные расходы на вызовы методов и разворачивает процессоры более эффективно, особенно при больших сканированиях. Векторизованный движок работает с пакетами VectorizedRowBatch, состоящими из столбцов ColumnVector. Типы столбцов (LongColumnVector, DoubleColumnVector, StringColumnVector и т. д.) позволяют компилировать и выполнять простые операции над данными без повторной интерпретации отдельных элементов.
Преимущества векторизации очевидны: значительное сокращение числа проходов по данным, улучшение кэширования и снижения перегруженности конвейерной цепи операторов. Это особенно заметно на больших выборках и при агрегациях с группировками. Однако существуют ограничения и нюансы:
- не все UDF и выражения совместимы с векторизацией; некоторые сложные выражения или пользовательские функции требуют неблокирующих режимов или полной конвейеризации обычного плана;
- производительность векторизации может снижаться при большом количестве типов данных с большими размерами полей (например, длинные строки) или при высокой доле пропусков (nulls);
- необходимо разумно подбирать формат хранения: столбцовый формат (ORC/Parquet) естественно дополняет векторизацию за счет компоновки данных.
На практике включение векторизации может быть реализовано через соответствующие конфигурационные параметры и совместное использование с LLAP. Векторизация работает лучше при сканировании больших наборов столбцов, где операторы могут выполнять фильтрацию, проекцию и агрегацию внутри пакетной обработки без постоянной распаковки значений.
Операторы и их оптимизация
Оптимизация операторов в Hive тесно связана с выбором стратегий выполнения, распределением задач и эффективной поддержкой фильтрации и агрегаций. В контексте Hive на Tez/LLAP ключевые направления включают:
-
Predicate pushdown и фильтрацию на уровне источников. В столбцовых форматах Parquet и ORC фильтры часто могут применяться на чтение данных, что сокращает объем читаемой информации и ускоряет обработку. Векторизированная обработка дополняет этот эффект, позволяя выполнить фильтры на пакетном уровне.
-
Порядок и выбор операторов. Планировщик может переупорядочивать соединения и агрегации, чтобы минимизировать промежуточные данные. В некоторых сценариях предпочтителен MapJoin (локальная агрегация на карте) для уменьшения неравномерности распределения и операционной памяти, тогда как Sort-Mood Join или Sort-Merge Join может быть предпочтительнее при больших входах и необходимости сохранения детерминированных результатов.
-
Конвейеризация и слияние операторов. Fusion-оптимизации конвейера позволяют уменьшить этапы передачи данных между операторами и повысить локальность доступа к данным. Векторизация дополняет этот подход, выполняя упрощенные операции в рамках пакетов.
-
Управление памятью и шаринг кеша. Эффективная работа LLAP требует оптимального разделения памяти между кешем и вычислениями. Неправильная настройка может привести к деградации производительности из-за frequent cache misses или чрезмерной конкуренции за память.
-
Архитектура вывода. Приоритетдачается конвейерная передача результатов и минимизация операций копирования. В случаях сложных выражений и больших наборов данных следует учитывать влияние на латентность.
Чтобы оптимизировать операции, целесообразно применять стратегию постепенного внедрения: сначала активировать фильтры и векторизацию, затем проверять влияние на план выполнения, и только затем рассматривать сложные операции сортировки или объединения. При этом обязательно рекомендуется использовать EXPLAIN для анализа плана выполнения и понимать, какие части плана используют LLAP и векторизацию, а какие остаются на Tez или на стандартном hell engine.
Статистика и планирование: сбор, интерпретация и использование
Ключ к эффективной оптимизации Hive - качественная статистика. Без точной информации планировщик не может точно оценить стоимость выполнения, распределение данных и выбирать наиболее выгодную стратегию выполнения, что приводит к неоптимальным планам и снижению производительности.
-
Сбор статистики. Простой и распространённый подход - сбор статистики для таблиц и столбцов, включая число строк, распределение значений, частоты встречаемости и количество NULL-значений. Команды типа ANALYZE TABLE ... COMPUTE STATISTICS и ANALYZE TABLE ... COMPUTE STATISTICS FOR COLUMNS создают базовую информацию, необходимую для планирования.
-
Роль CBO (Cost-Based Optimizer). Включение CBO позволяет планировщику учитывать стоимости операций, такие как чтение данных, фильтрация, группировка и соединение. При активном CBO Hive может выбирать более эффективные алгоритмы выполнения и порядок соединений на основе реальных статистических данных и предположений.
-
Гистограммы и статистика по столбцам. Гистограммы дают лучший шанс понять распределение значений и позволяют планировщику корректнее разбирать диапазоны фильтров. Особенно полезны при высокоизбыточных данных и для предикатов с диапазонами.
-
Автогонка и обновление статистики. Автоматическое обновление статистики может быть полезно в условиях частых изменений данных. Однако следует оценивать стоимость повторной сборки статистик против выигрыша в точности плана.
-
Точность и ограничение. Статистика - оценочная информация. В реальных нагрузках следует учитывать возможную неточность и планировать резерв в плане присутствия исключений и skew-эффектов. В случае сильной дисперсии полезно сочетать статистику с эмпирическим тестированием и анализом фактических данных.
-
Мониторинг и диагностика. В процессе оптимизации необходимо отслеживать реальные показатели выполнения: latency, throughput, cache-hit rates, spill-to-disk, локализацию доступа к данным. EXPLAIN ANALYZE и профилировщики на уровне JVM и LLAP помогают диагностировать узкие места.
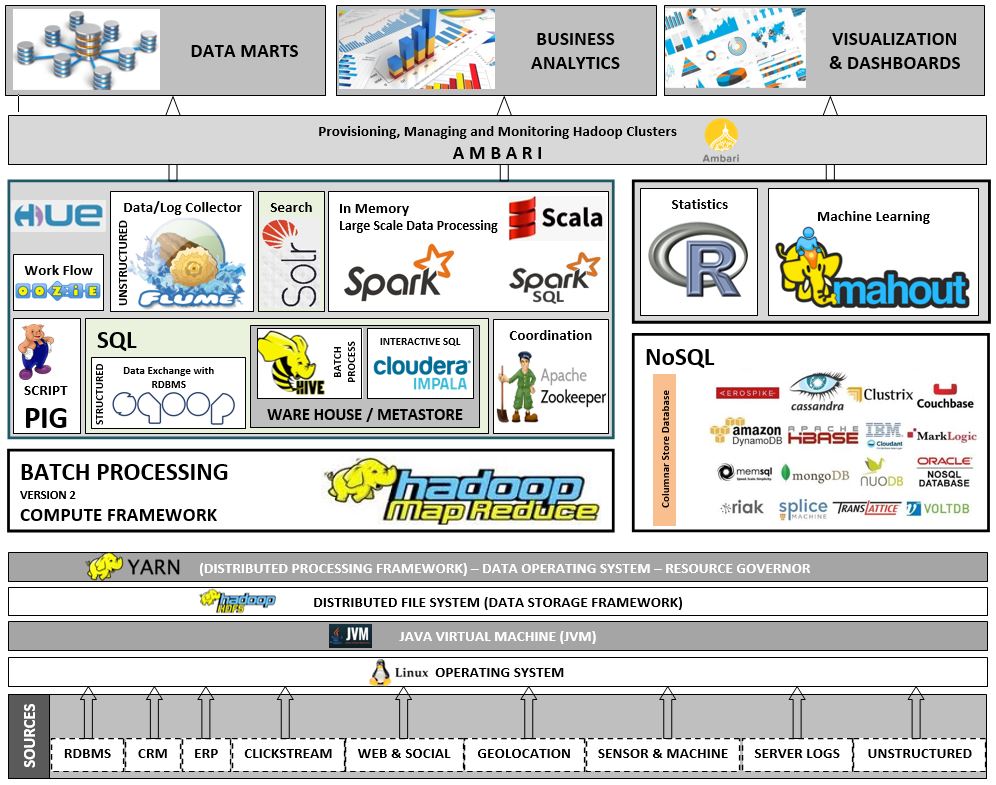
Интеграция и практические примеры
Эффективная оптимизация Hive требует последовательности действий и конкретных практических шагов. Рассмотрим наиболее распространённый сценарий:
-
Базовая настройка. Включение векторизации и опций LLAP. В начале следует убедиться, что столбцовые форматы (ORC/Parquet) используются по умолчанию и хранение сведений о схеме не требует частых миграций. Активировать векторизацию и LLAP через соответствующие параметры конфигурации и запустить тестовую нагрузку, чтобы оценить высокий уровень латентности и потенциальной выгоды.
-
Применение фильтров и ограничение чтения. При наличии условий в WHERE и JOIN-условиях следует убедиться, что они могут быть применены на уровне чтения источника данных. Это минимизирует объем загружаемых данных в процесс и повышает общую производительность.
-
Оптимизация соединений и агрегаций. В сценариях с большими данными и сложными соединениями нужно подобрать стратегию соединения: MapJoin или Shuffle-Hash Join в зависимости от объема входных данных и доступной памяти. В некоторых случаях предпочтителен локальный Join на LLAP для уменьшения сетевых перемещений.
-
Мониторинг и корректировка памяти. После внедрения изменений требуется мониторинг потребления памяти LLAP и Tez, чтобы избежать перегрузок и конкуренции ресурсов. При необходимости увеличить размер кеша или ограничить параллелизм, чтобы повысить устойчивость к пиковым нагрузкам.
-
Интеграция с экосистемой. Hive оптимизация не должна ухудшать совместимость с Impala и Spark SQL, если в кластере предусматриваются совместные сегменты для различных двигателей. В большинстве сценариев можно наставить каждую технологию на собственные конфигурации и обеспечить согласованный набор метрик для сравнения эффективности.
-
Практический чек-лист оптимизации:
- включена ли векторизация и LLAP;
- используется ли столбцовый формат и применяются ли фильтры на чтении;
- активирован ли CBO и анализ статистик;
- выбраны ли правильные стратегии соединений и агрегаций;
- мониторинг latencies и кеш-использования;
- регулярная проверка EXPLAIN и фактических планов выполнения.
Key takeaways
- LLAP существенно снижает задержку выполнения за счет локального кеширования данных и близости вычислений к данным.
- Векторизация обеспечивает пакетную обработку данных и сокращение накладных расходов на вызовы функций, что особенно эффективно на больших сканированиях столбцовых форматов.
- Эффективная оптимизация операторов требует сочетания predicate pushdown, правильного выбора алгоритмов соединения и конвейерной обработки для минимизации промежуточных данных.
- Точные статистики и активный CBO позволяют Hive выбирать более оптимальные планы выполнения, особенно в условиях больших таблиц и частых обновлений данных.
- Практическая оптимизация - это непрерывный процесс: начинать следует с базовых изменений (векторизация, LLAP, фильтры), затем анализировать планы и постепенно усиливать конфигурацию по мере необходимости.
- Оценка производительности требует системного мониторинга ресурсов, латентности, кеш-попаданий и анализа плана выполнения.
FAQ
- Что такое LLAP и почему он важен для Hive?
LLAP - это архитектура движка Hive, где вычисления выполняются на долговременных демонах, размещённых рядом с данными, с локальным кешем. Это уменьшает сетевые задержки и повышает пропускную способность, особенно в интерактивной аналитике. LLAP снимает часть нагрузки с YARN ResourceManager и даёт стабильные времена отклика за счёт повторного использования кеша между запросами и эффективной обработки IO.
- Какие данные лучше всего подходят для векторизации?
Крайне эффективны сканирования больших наборов столбцов в столбцовых форматах (ORC, Parquet). Векторизация особенно выигрывает на последовательном чтении, агрегациях и фильтрациях по диапазонам. Следует быть осторожным при работе с очень длинными строками, сложными типами данных (Maps, Arrays) и наличии большого количества пропусков, которые могут снизить эффективность пакетной обработки.
- Как определить, поддерживает ли мой запрос векторизацию?
Большинство простых выражений, фильтров и арифметических операций поддерживаются векторизацией. Однако нестандартные UDF и сложные вычисления могут перейти в неблокирующий режим. Включение векторизации и анализ плана выполнения через EXPLAIN помогут определить, какие части запроса выполняются векторизованно.
- Какие шаги включают базовую оптимизацию операторов?
Включают: фильтр-pushdown, использование столбцовых форматов и фильтрацию на чтении, выбор эффективной стратегии соединения (MapJoin, Shuffle-Hash Join), конвейеризацию операторов и минимизацию промежуточных данных. Важно анализировать план выполнения и тестировать влияние каждого изменения.
- Что такое CBO в контексте Hive и как его использовать?
CBO (Cost-Based Optimizer) учитывает стоимость операций чтения, фильтрации, сортировки и соединения при выборе плана выполнения. Включение hive.cbo.enabled=true и точная статистика для таблиц и столбцов позволяют планировщику выбирать более эффективные планы, особенно в больших и изменяющихся наборах данных.
- Как сбор статистики влияет на производительность?
Статистические данные позволяют планировщику оценить стоимость операций и выбрать оптимальные стратегии. Правильная статистика снижает риск неоптимальных планов и повышает качество предсказаний производительности. Автоматическая сборка статистики упрощает поддержание плана в актуальном состоянии по мере роста данных.
- Какие проблемы могут возникнуть при оптимизации и как их диагностировать?
Основные проблемы: несбалансированная память, частые кеш-промахи LLAP, непредсказуемая производительность из-за skew-данных, неэффективные плановые узлы. Диагностику проводят через EXPLAIN, мониторинг Latency/Throughput, анализ использования памяти и профилировку LLAP/Tez-узлов.
- В чем разница между Hive и Impala в части оптимизации?
Impala и Hive достигают схожих целей, но реализация оптимизации отличается. Impala ориентирован на реализацию мгновенного ответа за счёт своего собственного механизма планирования и реализации, тогда как Hive в связке с LLAP и Tez опирается на архитектуру Hadoop и столбцовые форматы. В контексте Hadoop-аналитики Hive может давать схожие результаты при корректной настройке LLAP, векторизации и статистики, но подход к конфигурации и мониторингу имеет свои особенности.
- Каковы риски при переходе на LLAP и векторизацию?
Основные риски связаны с перераспределением памяти и потреблением кеша, а также с совместимостью UDF и некоторых выражений с векторизацией. Неправильная настройка кеша может привести к деградации производительности. Рекомендуется внедрять изменения постепенно, сопровождать их мониторингом и тестированием на реальных нагрузках.
- Какие практические шаги следует предпринять для старта оптимизации?
Начните с включения векторизации и LLAP, использования столбцовых форматов, активации фильтрации на чтении, проверки плана выполнения и анализа реальных метрик. После этого постепенно добавляйте стратегии JOIN, настройку памяти и статистику, регулярно сравнивая результаты до и после изменений.


