

Эксплуатация и операционная модель: мониторинг, логирование, SLA, инцидент-менеджмент
Современная аналитика на стеке Hadoop требует единообразной операционной модели: от сбора метрик и логов до управляемых процессов реакции на инциденты и соблюдения согласованных уровней сервиса. В контексте Hive, Impala и Spark SQL это означает объединение наблюдаемости по различным компонентам, единые принципы логирования, четко сформулированные SLA/SLO и полноценный цикл инцидент-менеджмента. Глава раскрывает принципы архитектуры операционной модели, конкретизирует требования к мониторингу и логированию, обсуждает формализацию SLA и планирование ресурсов, а также описывает процессы реагирования на инциденты и их последующего улучшения.
В условиях многопользовательской аналитики и разнообразия задач важно обеспечить прозрачность исполнения запросов, предсказуемость времени отклика и возможность быстрого устранения проблем. Именно поэтому операционная модель должна быть принципиально связана с архитектурой стека: данные и выполнение запросов связываются через управляемые каналы мониторинга, журналирования и обработки инцидентов, которые работают независимо от конкретной аналитической задачи, оставаясь воспроизводимыми и документированными.
Краткое содержание главы
- Архитектура операционной модели для Hadoop-аналитики и роли Hive, Impala, Spark SQL в ней.
- Мониторинг и алертинг: метрики, панели и процедуры реагирования.
- Логирование, трассировка и управление журналами событий.
- SLA/SLO, управление емкостью и контрактами обслуживания.
- Инцидент-менеджмент, эскалация и непрерывное улучшение процессов.
Архитектура операционной модели
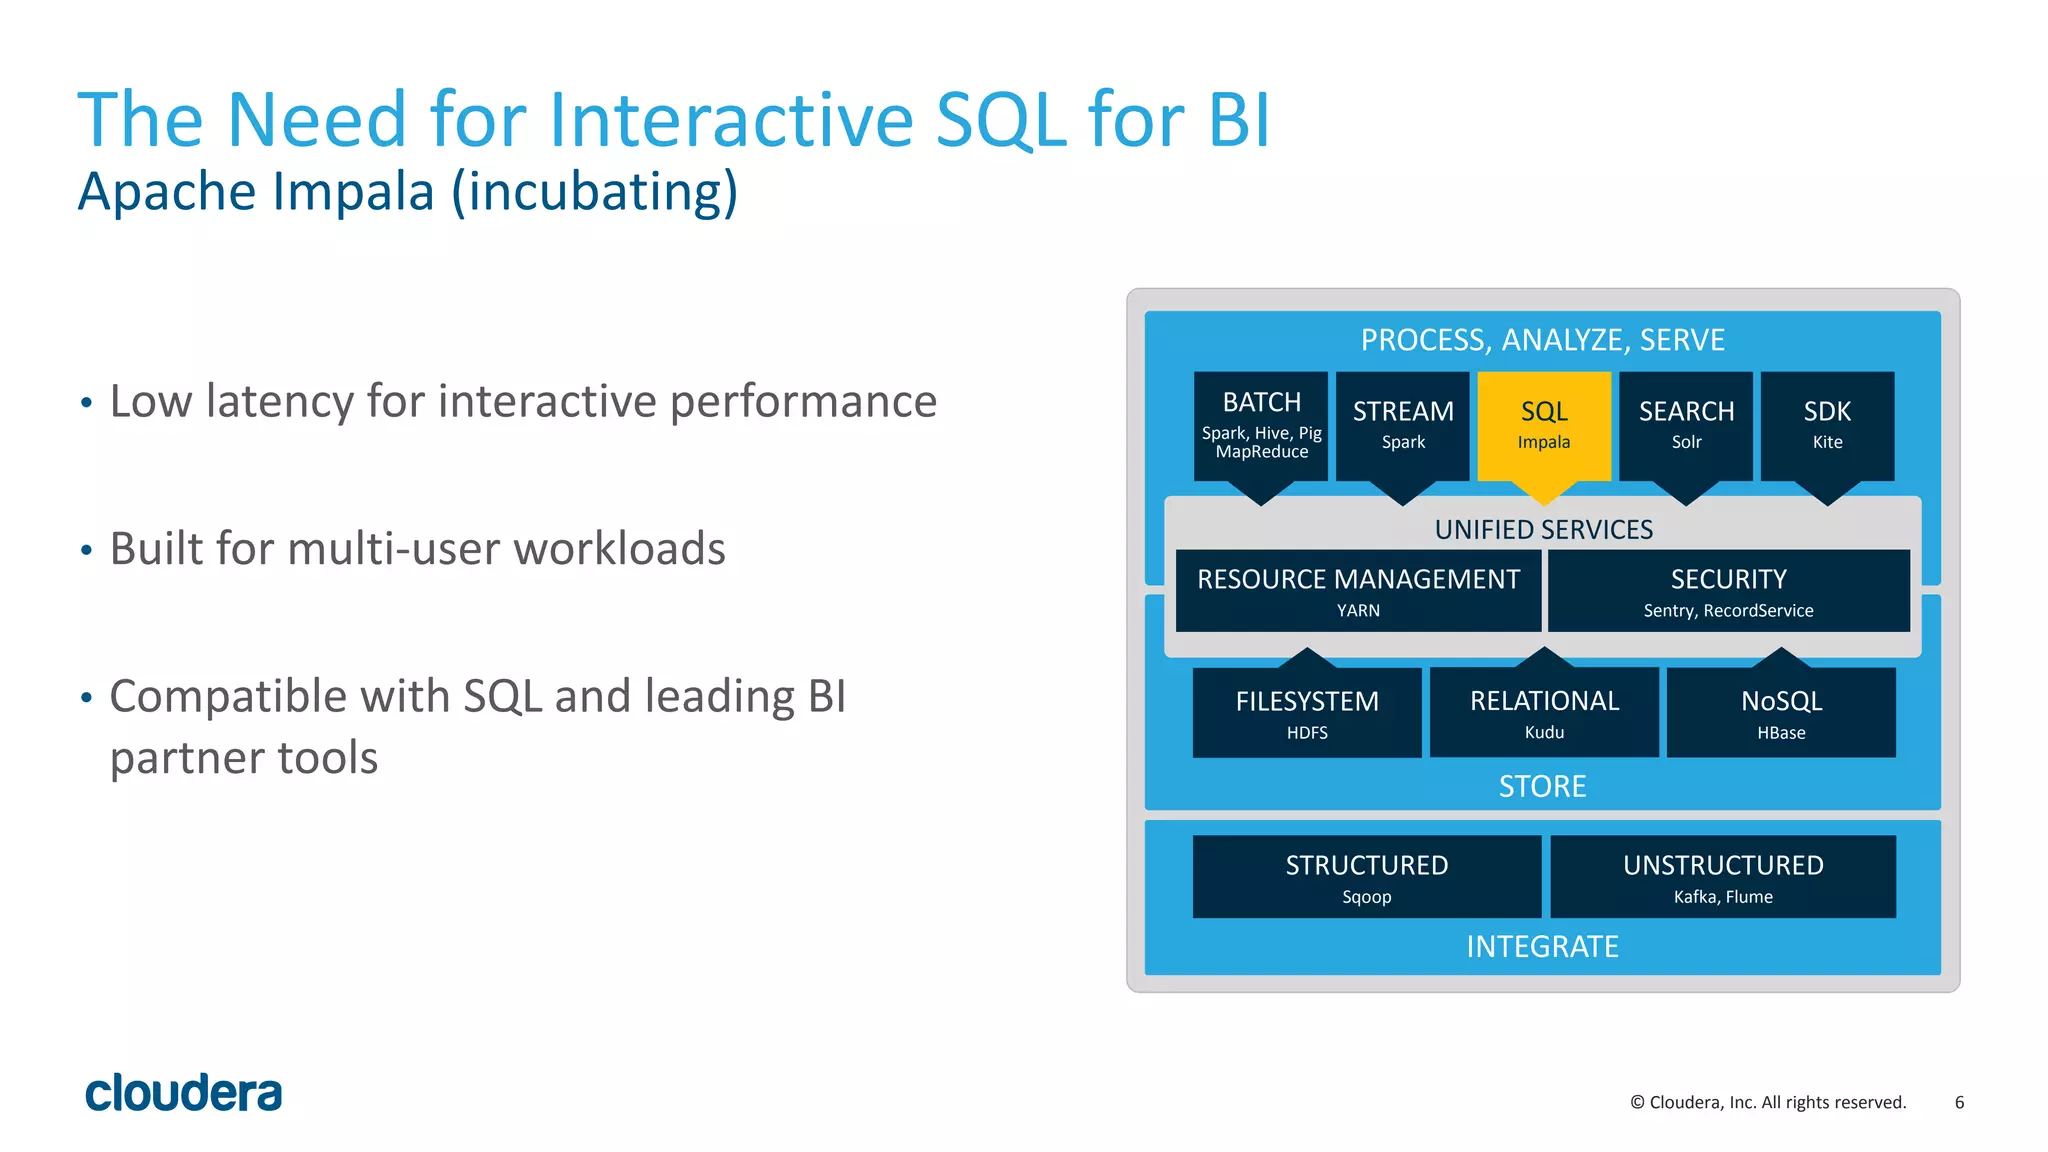
Эксплуатационная архитектура для Hadoop-аналитики должна отделять управляемые сервисы, данные и вычисления, обеспечивая прозрачную связь между ними. В центре - единой архитектуры находятся: метрики и логи, процессы инцидентов и запасные планы, а также инфраструктура, которая обеспечивает выполнение запросов Hive, Impala и Spark SQL на устойчивом уровне.
Основные принципы архитектуры включают:
- Разделение ответственности. Контроль и данные разделяются по слоям: контрольная плоскость (менеджеры ресурсов, оркестраторы, oversee-контроль за состоянием кластера) и плоскость данных ( Hive Metastore, HiveServer2, Impalad, Spark Driver/Executors, HDFS). Такое разделение облегчает доступ к мониторингу и журналам, не мешая пользователям и задачам анализа.
- Обеспечение последовательности интерфейсов. Метрики и логи должны иметь единые точки доступа: JMX/REST API для сервисов, стандартные пути экспорта метрик в Prometheus, логи в формате, пригодном для корреляции.
- Гибкость развертывания. В современных рамках поддерживаются локальные кластеры, облачные аналоги (EMR, Dataproc, HDInsight) и гибридные схемы. Архитектура должна поддерживать централизованный сбор метрик и логов независимо от места размещения компонентов.
- Безопасность и аудит. В каждом слое необходимо реализовать Kerberos/TLS, контроль доступа к журналам и метрикам, хранение аудиторских данных и возможность ретроспективного аудита действий пользователей и систем.
- Непрерывность и восстанавливаемость. Архитектура должна предусматривать план аварийного восстановления, резервирование метрик/логов и минимальные сроки MTTR (Mean Time to Repair) за счет готовых runbooks и автоматизированных процедур.
Контуры архитектуры включают связи между тремя ключевыми элементами: метрики, логи и инциденты. Метрики собираются из компонентов HiveServer2, impalad, Spark (driver и executors), соответственно из YARN/Кubernetes, HDFS и метаданных. Логи - это журнал действий исполнителей, аудиты запросов, трассировки выполнения и служебные сообщения. Инциденты возникают на пересечении проблем с доступностью, производительностью и корректностью данных, и должны автоматически связывать логи и метрики для ускорения диагностики.
Практическая интеграция в облаке часто предполагает использование управляемых сервисов мониторинга (Prometheus/Grafana, OpenTelemetry) и средств агрегации логов (ELK/EFK, OpenSearch). Для российского контекста эффективной может быть параллельная работа открытых инструментов и локальных решений, обеспечивающих хранение и обработку журналов и метрик в требованиях регуляторики.
Разделение обязанностей и схема взаимодействий должны быть зафиксированы в Runbooks и служебном каталоге услуг. В рамках Hive, Impala и Spark SQL доминируют следующие интерфейсы взаимодействия: экспорт метрик через JMX и REST, сбор логов через агенты на нодах, корреляция по клиентским трассировкам и операциям.
Важным элементом является видение, как адаптировать архитектуру под конкретную организацию: выбор между Kubernetes-оригинальным развертыванием Spark SQL и классическим YARN-управлением ресурсами, определение того, какие компоненты должны иметь централизованный мониторинг, и какие логи агрегируются на уровне кластера и на уровне сервисов. Единство интерфейсов позволяет строить общие дашборды и единый процесс реагирования на инциденты, даже если часть систем работает в облаке, а часть - локально.
Мониторинг и алертинг
Мониторинг в аналитическом стеке Hadoop должен охватывать как состояние кластера, так и качество исполнения конкретных запросов. Эффективная система мониторинга строится вокруг определения SLI/SLO, набора метрик и политики алертинга, а также инфраструктуры панелей, которые позволяют быстро локализовать проблему.
- Модель мониторинга. В рамках операционной модели следует определить набор SLI/SLO, относящихся к каждому компоненту: доступность HiveServer2, латентность выполнения запросов Impala, задержку планирования в Spark, загрузку узлов, пропускную способность сетевых каналов и доступ к файловой системе. Важно учитывать контекст выполнения: пиковые часы, дневная вариация нагрузки, сезонные паттерны и аптайм сервисов.
- Метрики и источники. Ключевые группы метрик включают: (1) здоровье кластера: доступность менеджеров ресурсов, загрузка CPU/memory, диск и сеть; (2) исполнение запросов: время выполнения, этапы (Stages) и задачи (Tasks) внутри Spark, латентность импалада и HiveServer2; (3) операции с данными: размер очередей, задержки чтения и записи HDFS, частота метаданных в Metastore; (4) JVM-метрики: GC-паузы, пиксельная нагрузка на сервисы; (5) безопасность и аудит: количество успешных/неуспешных аутентификаций и доступов к данным.
- Инструменты и архитектура панелей. Наиболее эффективной является связка Prometheus + Grafana для сбора метрик и визуализации. Экспортеры для Spark, Hive/Impala, YARN и HDFS позволяют централизованно накапливать данные. В качестве альтернативы можно рассмотреть OpenTelemetry для трассировок и контекстной корреляции. Панели должны поддерживать drill-down: от общего состояния к конкретной ноде или исполнителю, к конкретному запросу.
- Алертинг. Стратегия алертинга должна снижать шум и предоставлять контекст. Роли и уровни инцидентов следует формализовать: предупреждения (warning), критические (critical) и неисправности с кратным повтором. Важно задать пороги на основе статистики и исторических паттернов, учесть сезонность и устойчивость к ложным срабатываниям. Алерты должны сопровождаться контекстным набором: ссылка на дашборд, идентификатор инцидента, каналы эскалации и Runbook.
- Практические примеры. Панели по ключевым направлениям: (а) латентность выполнения запросов по Hive/Impala/Spark; (b) загрузка ресурсов кластера; (c) активные запросы, конвейеры данных и очереди в Metastore; (d) новости по ошибкам доступа к данным и аудиту.
- Анти-паттерны. Избегать излишне агрессивной пороговой настройки, которая приводит к «шуму»; не следует полагаться на единый порог для всех рабочих нагрузок; рекомендуется внедрять корреляцию между метриками и логами, чтобы исключить ложные срабатывания.
Практическая подсказка: для начала достаточно двух-трех базовых дашбордов: кластерная карта состояния; латентность запросов по ядрам (Hive/Impala/Spark); и топ ошибок выполнения. Со временем к ним добавляются детализированные панели по памяти, GC-паузы и задержкам на уровне каждого сервиса.
Логирование и трассировка
Логирование и трассировка являются неотъемлемой частью наблюдаемости, необходимой для диагностики и аудита. В контексте Hive, Impala и Spark SQL следует выстроить единую стратегию сбора, хранения и корреляции логов, а также внедрить распределенную трасировку, позволяющую проследить путь запроса через все компоненты.
- Архитектура логирования. Логи собираются на нодах выполнения и серверах управления, отправляются в централизованный хранилище и индексируются с использованием единых форматов. Важное требование - обеспечение сохранности PII и чувствительных данных: настройка уровней логирования, фильтрация и возможность ретро-перекрестной обработки.
- Корреляция и трассировка. Для эффективной отладки необходима единая корреляционная идентификация запросов: клиентский идентификатор, запрос, шаги выполнения и их временные метки. Распределенная трасировка с использованием OpenTelemetry обеспечивает видимость сквозного выполнения через Spark драйвер и executors, Impala Daemon и HiveServer2, включая соответствие логов и трассировок.
- Практики и форматы. Рекомендуется единый формат логов (например, JSON) для упрощения парсинга. Важно поддерживать системные логи (операционные, аудиты) и журналы исполнителей (query logs, планы выполнения, предупреждения сервиса). Периодическая очистка и архивирование допускается после достижения минимальной retention-политики.
- Инструменты. Эффективной комбинацией являются ELK-стек (Elasticsearch/Logstash/Kibana) или OpenSearch для полнотекстового поиска и анализа, а также Loki для интенсивного логирования. Выбор зависит от регуляторных требований и наличия компетенций в команде.
- Безопасность и соответствие. Логи могут содержать данные об запросах, пользователях и доступах к данным. Необходимо обеспечить доступность журналов только уполномоченным лицам, реализовать шифрование на покое и в транспортировке, а также задокументировать политику хранения и удаления.
Жизненный цикл логов следует держать в связке с моделями мониторинга: поиск причин аварий по коррелированным метрикам и логам должен приводить к конкретному исправлению и обновлениям Runbooks.
SLA, планирование пропускной способности и управление ресурсами
Грамотная операционная модель требует формального определения SLA и SLO, а также планирования ресурсов для выполнения аналитических задач. Это позволяет обеспечить удовлетворение ожиданий бизнеса по времени отклика, доступности и управляемости данных.
- Определение SLA/SLO. SLA описывает ожидаемое качество сервиса и доступность в целом, тогда как SLO - конкретные показатели для отдельных сервисов (HiveServer2, Impala, Spark SQL). Примеры SLO: P95 латентность выполнения запросов под заданный порог, средняя задержка выполнения под 2 секунды, доступность сервиса выше 99.9%.
- Планирование емкости. Необходимо моделировать пиковые нагрузки, сезонные колебания и новые источники данных. Важным является наличие резервирования ресурсов и возможность масштабирования - как вертикального (ресурсы нод), так и горизонтального (добавление нод, масштабирование кластера Spark на Kubernetes).
- Управление ресурсами. В рамках Spark и Spark SQL применяют ресурсоемкие настройки: количество executors, объем памяти, параллелизм задач; в Hive/Impala - режимы выполнения, спецификации очередей и настройка кэширования. В Kubernetes/YARN важно следить за балансировкой ресурсов между различными пользователями и задачами.
- Каталог услуг и договоры. В сервисном каталоге следует зафиксировать уровни сервиса, приоритеты нагрузок и процедуры подачи изменений. Это упрощает коммуникацию с бизнес-пользователями и повышает прозрачность эксплуатации.
- Прогнозирование отказов и устойчивость. Включает планы резервного копирования данных, политики восстановления после сбоев, план тестирования аварийных сценариев и регламентные проверки доступности критически важных компонентов.
Практическая нотация: SLA и SLO должны быть согласованы с бизнес-пользователями, четко документированы в Runbooks и привязаны к конкретным данным и их критичности. Автоматизация масштабирования и перераспределения задач между пулами ресурсов позволяет снизить риск превышения порогов и улучшить общий сервис.
Инцидент-менеджмент и операционные практики
Инциденты - естественная часть эксплуатации сложных обработок больших данных. Эффективная операционная модель требует структурированного цикла реагирования, документированных ролей и постоянного улучшения процессов.
- Цикл инцидента. Эффективная реакция начинается с обнаружения проблемы, триажа, устранения, восстановления сервиса и постинцидентного анализа. Включаются этапы сбора контекста, уведомления стейкхолдеров, фиксация времени и причин сбоя, принятие corrective actions и обновление Runbooks.
- Роли и процессы. Назначение ответственных: Incident Commander, on-call инженеры, специалисты по данным и безопасностям. Важна интеграция с системами тикетов (например, Jira) и оповещениями в чат-каналы. Runbooks должны быть детализированы: шаги для проверки состояния компонентов, варианты обходных путей и процедуры восстановления.
- Взаимодействие с изменениями. Инциденты часто связаны с изменениями в конфигурации, обновлениях версий или миграциях. Следует внедрить контроль изменений с этапами тестирования, ограничениями на релизы и стратегиями отката.
- Постинцидентные обзоры. Каждое значимое нарушение требует анализа корня проблемы, оценки влияния и обновления документации - Runbooks, дашбордов, алертинга и регламентов по безопасной работе с данными.
- Интеграции и инструменты. Инцидент-менеджмент эффективен через интеграцию с тикетинг-системами, системами оповещений и базами знаний. Это обеспечивает единый контекст проблемы и быстрый доступ к прошлым решениям.
- Автоматизация и продвинутая реакция. В рамках инцидентов возможна автоматизация: автоматическое отключение проблемных задач, перераспределение ресурсов или применение предопределенных обходных путей. Вызов автоматизированных реакций должен сопровождаться безопасностью и возможностью принудительного отката.
- Непрерывное улучшение. Проводятся периодические ретроспективы по инцидентам, формируются меры по предотвращению повторения, а также обновляются контрольные списки, Runbooks и обучающие материалы.
Формирование культуры оперативности и дисциплины в области инцидент-менеджмента требует не только наличия процессов, но и постоянного тренировочного цикла: регулярные учения на сценариях с имитацией реальных инцидентов, чтобы участники могли быстро и слаженно реагировать.
Key takeaways
- Эффективная операционная модель Hadoop-аналитики требует единообразной архитектуры наблюдаемости, журналирования и инцидент-менеджмента, связывающей Hive, Impala и Spark SQL.
- Мониторинг строится на наборе SLIs/SLOs, централизованной панели и продуманной политике алертинга для снижения шума и ускорения диагностики.
- Логирование и трассировка должны обеспечить корреляцию между сервисами, поддерживать безопасность данных и упрощать аудит и постинцидентный анализ.
- SLA и планирование емкости должны быть формализованы, документированы в сервисном каталоге и поддержаны механизмами резервирования и автоматического масштабирования.
- Инцидент-менеджмент требует четких ролей, детализированных Runbooks, интеграции с системами тикетов и регулярных практик по улучшению процессов.
FAQ
- Как определить конкретные SLA/SLO для Hadoop-аналитики?
- Определение SLA/SLO начинается с согласования бизнес-целей и критичности данных. Выделяются безопасные и критичные данные, после чего устанавливаются целевые уровни доступности (uptime), латентности запросов (например, P95/P99) и времени восстановления. Эти параметры измеряются на протяжении реального периода, и корректировочно адаптируются по мере роста нагрузки и изменений инфраструктуры.
- Каким образом обеспечивать корреляцию между логами Hive, Impala и Spark SQL?
- Используется единая корреляционная идентификация запросов: клиентский идентификатор, уникальный идентификатор запроса и ноды, через которые он проходит. Логи собираются в централизованный хранилище и индексируются единым форматом (например, JSON). Корреляционные поля позволяют объединять события разного сервиса и строить трассировку по времени.
- Какие инструменты подойдут для мониторинга в среде Hadoop?
- Популярная связка Prometheus + Grafana подходит для сбора и отображения метрик. В качестве альтернативы можно рассмотреть OpenTelemetry для трассировки и объединение с ELK/OpenSearch для логов. Выбор зависит от компетенций команды и регуляторных требований.
- Какую стратегию алертинга выбрать, чтобы не перегружать команду?
- Следует использовать многоуровневый подход: предупредления на уровне отдельных сервисов и критические инциденты, с задержкой и повторными попытками для снижения шума. Важно внедрить антиматчинг по контексту и коррелировать алерты с логами и метриками.
- Какие практики помогут в инцидент-менеджменте в контексте Hive/Impala/Spark?
- Важно определить роли (Incident Commander, On-Call, Data Engineer), разработать детальные Runbooks, внедрить интеграцию между тикетами и чатами, а также проводить постинцидентные обзоры для улучшения процессов и корректировок в конфигурациях.
- Как обеспечить безопасность при логировании и хранении логов?
- Применяются механизмы шифрования на покое и в транспортировке, контроль доступа к журналам, фильтрация ПДИ-данных, а также хранение аудита и регуляторно значимой информации в соответствии с политиками компании.
- Какие подходы к планированию ресурсов подходят для многопользовательской аналитики?
- Рекомендуется использовать несколько пулов ресурсов, квоты по пользовательским задачам, предиктивное масштабирование и резервирование. В Spark можно управлять параллелизмом и памятью executors, в Hive/Impala - настройкой очередей и ограничениями ресурсов.
- Что важно учитывать при миграции между Hive, Impala и Spark SQL?
- Ключевое - совместимость форматов данных, согласование планов выполнения и совместимость функций. В процессе миграции важно поддерживать единые схемы мониторинга и логирования, чтобы не потерять контекст выполнения запросов.
- Как обеспечить устойчивость операционной модели при переходе в облако?
- Необходимо обеспечить централизованный сбор метрик и логов независимо от места размещения сервисов, использовать облачные и локальные средства безопасности и аудита, и обеспечить совместимость инструментов мониторинга и трассировки.
- Какие сценарии тестирования стоит проводить для инцидент-менеджмента?
- Резервирование и восстановление данных, тестирование аварийного переключения в кластере, воспроизведение падений отдельных нод, проверка реакции на перегрузку и повторные срабатывания оповещений. Регулярные учения позволяют повысить скорость реакции и точность диагностики.


