

Будущее ETL в экосистеме Hadoop: миграции, lakehouse и новые паттерны
ETL в Hadoop традиционно был связан с периодическими пакетными обработками, жестко зафиксированными схемами и многослойной архитектурой недоступности данных. Современная реальность требует иной подход: объединить скорость и гибкость потоков данных с надежностью и полнотой истории, обеспечить единый слой доступа к данным и минимизировать стоимость владения инфраструктурой. В этом контексте архитектура lakehouse, поддерживаемая открытыми технологиями, становится центральной концепцией, позволяющей сочетать принципы data lake и data warehouse в единой платформе. В данной главе рассматриваются стратегические паттерны, миграционные дорожные карты и новые решения хранения, которые задают будущее ETL в экосистеме Hadoop.
Глубоким драйвером развития становится интеграция продвинутых форматов файлов, управляемых метаданными слоев и концепций федеративного доступа к данным. Эти тенденции требуют переосмысления процессов ingestion, partitioning и хранения, а также пересмотра организационных и технических границ между командами разработки и эксплуатации данных. Рассматриваются конкретные архитектурные подходы, которые позволяют перейти к устойчивым, масштабируемым и сопровождаемым данным, пригодным для аналитики, машинного обучения и оперативной отчетности.
- Lakehouse как паттерн архитектуры: объединение преимуществ data lake и data warehouse через управляемые слои метаданных, версионность и ACID-операции.
- Инструменты и форматы: роль Iceberg и Hudi в обеспечении прозрачной эволюции схем, времени путешествия данных и эффективного обновления больших наборов.
- Эволюция процессов ETL: переход от монолитной пакетной обработки к гибридным режимам, сочетающим потоковую и пакетную обработку без потери консистентности.
- Управление данными и операционная грамотность: усиление governance, lineage и качества данных в условиях динамической архитектуры.
Краткое содержание главы
- Введение в lakehouse-архитектуру и ее влияние на ETL в Hadoop, принципы консистентности и управления метаданными.
- Миграционные стратегии: как спланировать переход, минимизировать риск и обеспечить непрерывность бизнес-потребностей.
- Роль Apache Iceberg и Apache Hudi в ingestion, partitioning и версиях данных; сравнение и выбор между ними.
- Паттерны хранения и оптимизации доступа: эволюция схем, файлоформаты, управление временем жизни данных и хранение статистик.
- Governance, lineage и качество данных: как поддерживать доверие к данным в lakehouse и какие процессы внедрять на уровне организации.
Архитектурные паттерны будущего ETL в Hadoop
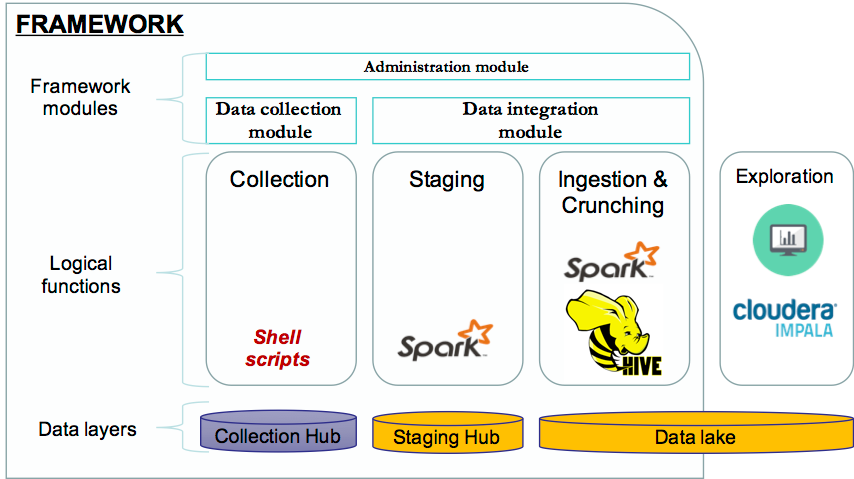
В рамках lakehouse-концепции данные не ограничены одним слоем хранения; они проходят через конвергентную модель ingestion, трансформаций и сервиса доступа. Это требует четкой декомпозиции на слои и ясно defiнированных интерфейсов между ними. Важнейшими компонентами становятся: гибкая схема и её эволюция, версия данных, управление метаданными, поддержка времени путешествия и способность быстро восстанавливаться после сбоев. Архитектура ориентирована на сбалансированное использование вычислительных мощностей и носителей данных, что особенно критично в рамках крупных Hadoop-экосистем, где вычисления часто выполняются рядом с данными на распределённых файловых хранилищах.
Ключевые принципы включают:
- decoupled ingestion и processing: отделение потоков данных от бизнес-правил трансформаций и хранения;
- единый слой метаданных: каталогизация, управление версионированием и линия данных;
- поддержка ACID-операций на уровне хранения и упорядочение изменений через паттерны, аналогичныеTRANSACTIONAL слоям;
- архитектуру, ориентированную на совместное использование вычислений и данных через federated query-подходы.
Выбор между Iceberg и Hudi как опорой lakehouse влияет на паттерны ingestion и обновления: Iceberg лучше подходит для сложной аналитической загрузки с большим количеством чтения и сложной эволюции схем, в то время как Hudi особенно силён в сценариях upsert/merge и частых инкрементальных обновлений. В любом случае критически важны внешний каталог метаданных (например, Apache Hive Metastore, Glue или Amundsen) и интеграция с существующими пайплайнами Spark/Hadoop.
- ACID и версионирование: современные форматы обеспечивают консистентность при обновлениях больших таблиц и позволяют безопасно читать данные в любой момент времени.
- Эволюция схем без сбоев: поддержка добавления и удаления столбцов, адаптация к изменению типов данных без полного переписывания таблиц.
- Временные копии и time travel: возможность вернуться к конкретной версии данных для аудита, аудиторских проверок и тестирования.
- Оптимизация доступа: разделение метаданных и данных, поддержка динамической фильтрации и эффективной фильтрации partition-ключами.
Миграции: дорожная карта от традиционного ETL к lakehouse
Переход от классических ETL-пайплайнов к lakehouse не является одномоментным событием, это последовательный процесс, который требует стратегического планирования, контроля качества и управляемости изменений. В первую очередь необходима ревизия существующих пайплайнов: какие этапы можно сохранить, какие переинастарть, какие данные потребуют переработки форматов и структур. Затем следует определить целевые ориентиры по времени жизни данных, требованиям к частоте обновления и SLA.
Ключевые подходы:
- оценка текущей зрелости data-pipelines: какие пайплайны устарели, какие можно модернизировать без чрезмерного риска;
- стратегия миграции: параллельная работа старых и новых пайплайнов (dual-write), постепенная замена, минимизация дублирования данных;
- пилотные проекты: запуск ограниченного набора таблиц в lakehouse для проверки производительности, согласованности и бизнес-ценности;
- управление метаданными и качеством: внедрение единого каталога, тестов качества на постоянной основе и метрик для контроля скорости миграции;
- правовые и безопасность требования: сохранение политик доступа, аудит и шифрование на протяжении всей миграции.
Оптимальные сценарии миграции включают постепенное внедрение: сначала кладутся в lakehouse не критичные или архивные данные, затем подключаются источники потоковых данных, и, наконец, выполняются ключевые аналитические пайплайны. Важная часть - синхронизация бизнес-правил и трансформаций между старым и новым стеком, чтобы минимизировать риск рассинхронизации и ошибок.
- Инкрементальная миграция: перенос одной предметной области за раз, с сохранением неизменности бизнес-процессов, позволяет оценить влияние и качество на каждом шаге.
- Стратегия двойной записи: при переходе к lakehouse, запись данных в оба слоя обеспечивает непрерывность и снижает риск потери данных.
- Ключевые KPI миграции: задержки обработки, точность и полнота данных, стоимость владения, скорость внедрения новых функций.
Lakehouse в экосистеме Hadoop: Iceberg, Hudi и их роль в ingestion и хранении
Lakehouse в Hadoop строится на сочетании управляемых слоев данных, ускоренного доступа и устойчивого хранения. Форматы файлов и механизмы версионирования становятся основой для надежности и гибкости. Iceberg и Hudi занимают центральное место в этом контексте, каждый со своими сильными сторонами.
Iceberg предлагает:
- строгую схему эволюцию и управление partitioning без дорогостоящего переписывания данных;
- атомарные операции над таблицами и временную версию(read-time/transaction-time) для консистентности;
- оптимизацию чтения за счет скрытых сведений о партициях и улучшенной статистики.
Hudi обеспечивает:
- эффективные upsert и delete операции на больших объемах, что важно для событийной смены статусов и коррекций;
- инкрементальные загрузки и быстрый доступ к последним версиям данных;
- возможность построения "мгновенных" витрин на основе постоянно обновляемых данных.
В контексте Hadoop Iceberg и Hudi дополняются:
- управляющими каталогами метаданных (например, Apache Hive Metastore) для совместимости с существующими инструментами;
- интеграцией со Spark, Hive и Presto/Trino для единообразного доступа к данным;
- обеспечением совместимости с инфраструктурой YARN, Kubernetes или локальным кластерам, в зависимости от дорожной карты организации.
Выбор между Iceberg и Hudi зависит от сценария: если доминируют пакетные загрузки и аналитика с редкими обновлениями, Iceberg может быть предпочтительным; если же существенно важны частые обновления, deletes и upserts, Hudi может дать более естественную модель работы. В любом случае ключ к успеху - единый метаданные-слой и ясная стратегия миграции, позволяющая проводить параллельный доступ к данным в lakehouse и существующим хранилищам.
Новые паттерны хранения и оптимизация доступа
Переход к lakehouse не означает отказ от разумной архитектуры хранения. Наоборот, для эффективной эксплуатации данных необходимы продуманные паттерны хранения, включая гибкую конфигурацию partitioning, управление схемами и оптимизации доступа к данным.
- Partitioning и файловые форматы: выбор подходящего ключа партиционирования и сочетание форматов, предоставляющих баланс между скоростью чтения и стоимостью хранения. В lakehouse критично важно избегать частого переписывания данных и поддерживать совместимость между версиями таблиц.
- Эволюция схем: изменения нормативных требований и бизнес-логики требуют безболезненной эволюции схем. Поддержка добавления столбцов, изменения типов и переопределения атрибутов без разрушения существующих потребителей обеспечивает устойчивость пайплайнов.
- Управление временем жизни данных: использование TTL, архивирования и ретенции обеспечивает долговременное хранение, при этом сохраняя доступ к актуальным данным и возможность быстрого восстановления истории.
- Метаданные и статистика: поддержка полных и точных статистик, которые помогают оптимизировать план выполнения запросов, особенно на больших таблицах и в условиях высоких скоростей потребления данных.
- Архитектура доступа: Federated queries и близость вычислений к данным - важная концепция. В рамках Hadoop это может означать стратегию расположения вычислений вместе с данными, увеличение роли Spark и SQL-инструментов, а также интеграцию с внешними системами через безопасные и управляемые каналы доступа.
Управление данными в lakehouse: качество, lineage и governance
Без надлежащего управления данными lakehouse рискует превратиться в разрозненную коллекцию таблиц, где непредсказуемость и потеря доверия становятся обычной ситуацией. Поэтому необходимы процессы и инструменты, позволяющие не только хранить данные, но и держать их под контролем.
- Качество данных: внедрение тестирования на входе и в процессе трансформаций, автоматизированные проверки на полноту, уникальность и корректность значений. Puppet-метрики к качеству помогают своевременно выявлять проблемы и проводить корректирующие действия.
- Lineage и аудит: отслеживание происхождения данных, цепочек преобразований и ответственных лиц. В lakehouse это особенно важно, так как данные могут изменяться с разных источников и несколькими способами.
- Governance и безопасность: единая политика доступа, шифрование на уровне хранения и передачи, аудит операций и соответствие регуляторным требованиям. Управление данными должно быть встроено в архитектуру, а не реализовываться в виде отдельных модулей.
- Каталоги и поиск: единый каталог метаданных упрощает поиск данных и ускоряет внедрение новых аналитических решений. Интеграция с инструментами карьерного роста и паттернами самоконсультации сотрудников по данным повышает продуктивность.
- Управление рисками: определение критичных таблиц, мониторинг изменений в системах и своевременная реакция на инциденты. В условиях lakehouse управление рисками становится частью операционного цикла, а не итоговым звеном.
Влияние на организацию и процессы: методики перехода, управление затратами, безопасность
Глубокая трансформация инфраструктуры требует изменений в организационных практиках и управлении затратами. Вводится новая роль data governance, расширяются функции data engineering, усиливается сотрудничество между командами анализа, разработки и эксплуатации. Эффективная миграция требует прозрачной методологии, рассчитанной на длительный период, с небольшими и управляемыми шагами, в рамках которых цели бизнеса остаются ясными и измеримыми.
- Управление затратами: перераспределение капитальных и операционных расходов, оптимизация использования кластера, выбор гибридных моделей хранения. Lakehouse должен снижать суммарную стоимость владения за счет снижения дублирования данных и ускорения аналитических циклов.
- Безопасность и соответствие: интеграция механизмов контроля доступа и мониторинга, обеспечение аудита и защиты данных на всех этапах пайплайнов.
- Организационные изменения: расширение роли data governance, внедрение практик DevOps для Data, формирование кросс-функциональных команд по данным, создание единой культуры качества и ответственности за данные.
- Обучение и компетенции: повышение квалификации сотрудников в области новых паттернов хранения, форматов и инструментов, развитие навыков по мониторингу, тестированию и автоматизации пайплайнов.
- Эксплуатационная устойчивость: внедрение мониторинга, автоматизированного восстановления, резервного копирования и тестирования отказоустойчивости в контексте lakehouse и новых паттернов хранения.
Key takeaways
- Lakehouse представляет собой синтез data lake и data warehouse, обеспечивая единый слой доступа и управление данными на уровне метаданных.
- Iceberg и Hudi являются ключевыми технологиями для реализации lakehouse в Hadoop, обеспечивая версионирование, ACID-операции и эффективные обновления данных.
- Миграции к lakehouse требуют детального плана, стратегий dual-write и последовательного переноса областей бизнес-аналитики с минимальным воздействием на операционные процессы.
- Оптимизация хранения и доступа строится на продуманном partitioning, эволюции схем, управлении временем жизни данных и качеством данных.
- Governance, lineage и качество данных должны быть встроены в архитектуру с самого начала, чтобы обеспечить доверие к данным и соответствие требованиям.
- Интеграция lakehouse с существующими пайплайнами и инструментами Hadoop требует продуманной стратегии каталогов и совместимости с инфраструктурой Spark/Hive.
- Организационные изменения и обучение сотрудников являются неотъемлемой частью успешной трансформации, поскольку переход к lakehouse затрагивает процессы, роли и ответственность за данные.
FAQ
- Что такое lakehouse в контексте Hadoop и почему это важно?
Lakehouse - это архитектурный паттерн, который объединяет преимущества data lake (гибкость, масштабируемость, низкая стоимость хранения) и data warehouse (структурированность, ACID-табличности, управляемость). В Hadoop-окружении это позволяет хранить данные в централизованном, управляемом слое метаданных и обеспечивать единый способ доступа к ним через различные аналитические и машинно-обучающие инструменты. Это критично для ускорения аналитики, упрощения управления данными и снижения общей сложности инфраструктуры.
- Какие главные преимущества у Iceberg и Hudi для ETL-процессов?
Iceberg обеспечивает устойчивую эволюцию схем и эффективное управление партициями, что особенно важно для больших таблиц и постоянного чтения. Hudi сильнее в сценариях с частыми Upsert и Delete, облегчая инкрементальные обновления и время близких к реальному времени витрин. Оба решения поддерживают транзакционность и упрощают агрегации данных, что критично для надежной ETL-архитектуры.
- Как начать миграцию без остановки текущих бизнес-процессов?
Начинать следует с аудита текущих пайплайнов, идентификации кандидатов под миграцию, организации dual-write и параллельной эксплуатации как старых, так и новых слоев. Важно задать четкие KPI миграции и обеспечить тестирование на уровне данных и бизнес-логики до вывода новых пайплайнов в продуктивную среду.
- Что значит управлять временем жизни и хранением данных в lakehouse?
Эффективное управление временем жизни данных включает политики TTL, архивирование устаревших данных и периодическое удаление устаревших версий, если это согласуется с требованиями регуляторики. В lakehouse это достигается за счет поддержки версионирования, времени путешествия и гибких правил хранения, позволяющих балансировать между доступностью и стоимостью.
- Каковы принципы обеспечения консистентности в смешанных средах ETL?
Контролируйте консистентность через единый каталог метаданных, согласованные схемы и версии таблиц, а также через транзакционные механизмы в Iceberg/Hudi. Временные замыкания и синхронные/асинхронные обновления должны проектироваться так, чтобы потребители данных получали согласованные версии данных независимо от того, на каком слое они выполняют запрос.
- Какие паттерны следует использовать для partitioning в lakehouse?
Используйте согласованные ключи разделения, которые отражают бизнес-логику и частоту доступа. Избегайте перегрузки таблицы малыми партициями, что может привести к чрезмерному количеству файлов и ухудшению планирования запросов. Регулярно обновляйте статистику партиций и используйте динамическую фильтрацию там, где это возможно.
- Как интегрировать lakehouse с существующими инструментами Hadoop?
Необходимо обеспечить совместимость каталогов метаданных, поддерживать единый доступ через Spark/Hive/Presto+TiP и сделать переход плавным через слой промежуточной абстракции. Важно сохранить существующие интерфейсы потребления данных и обеспечить прозрачность для бизнес-потребителей.
- Какие организационные изменения сопровождают переход к lakehouse?
Требуется развитие роли data governance, расширение функций data engineering, формирование кросс-функциональных команд и внедрение практик DevOps для данных. Обучение сотрудников новым паттернам хранения и управлению данными должно стать постоянной частью корпоративной культуры.
- Насколько критично выполнение миграционной дорожной карты в условиях жестких сроков?
Соблюдение сроков зависит от реальной зрелости данных, ясности бизнес-тотребностей и устойчивости инфраструктуры. Часто эффективнее реализовать поэтапную дорожную карту, чтобы минимизировать риск, повысить управляемость изменений и позволить бизнесу адаптироваться к новым моделям хранения и доступа к данным.


