

YARN и планирование ресурсов: очереди, контейнеры, QoS
YARN выступает центральной сущностью управления ресурсами в Hadoop-кластере, объединяя требования приложений и физическую инфраструктуру в единую модель. В рамках эксплуатации кластера критически важны не только эффективность распределения ресурсов и минимизация задержек, но и устойчивость к сбоям, изоляция и предсказуемость качества обслуживания. Глава раскрывает архитектуру YARN, принципы очередей и планирования, механизмы управления контейнерами и их жизненный цикл, а также практические подходы к настройке, мониторингу и интеграции в реальных условиях эксплуатации.
Построение эффективной модели планирования ресурсов требует синергии между архитектурной моделью YARN, политиками планирования и практиками эксплуатации. Рассматривая очереди, мы обращаем внимание на разделение пространства квазиизолированных ресурсов между различными проектами и отделами, на методы обеспечения справедливости и гарантированных долей, а также на механизмы прерывания заданий и перераспределения ресурсов. Раздел о контейнерах охватывает вопросы выделения памяти и CPU, изоляции через cgroups и namespaces, мониторинга жизненного цикла контейнеров и обеспечения отказоустойчивости процессов, запущенных в рамках ApplicationMaster и контейнеров в NodeManager. В конце рассматриваются сценарии внедрения и операционные практики: настройка на реальных кластерах, тестирование регрессионных сценариев, интеграция с экосистемой Hadoop/Spark и выстраивание процессов мониторинга и аварийного восстановления.
- Краткое содержание главы
- Архитектура YARN и принципы планирования ресурсов.
- Очереди, политика планирования и QoS на уровне кластера.
- Контейнеры: жизненный цикл, ресурсы, изоляция и отказоустойчивость.
- Практические аспекты внедрения: настройка, мониторинг и интеграция в эксплуатацию.
- Особенности устойчивости к отказам и сценарии повышения надежности.
Архитектура YARN и принципы планирования ресурсов
YARN разделяет ответственность за управление и выполнение задач между несколькими компонентами: ResourceManager (RM), NodeManager (NM) и ApplicationMaster (AM). RM отвечает за глобальное планирование и координацию всего кластера, включая выбор узлов для контейнеров и распределение ресурсов между приложениями. NM запускает и регулирует контейнеры на конкретном узле, следит за состоянием узлов, мониторит потребление CPU и памяти, а также управляет жизненным циклом контейнеров. AM заказывает ресурсы у RM и управляет выполнением конкретного приложения, делегируя часть задач на уровне контейнеров.
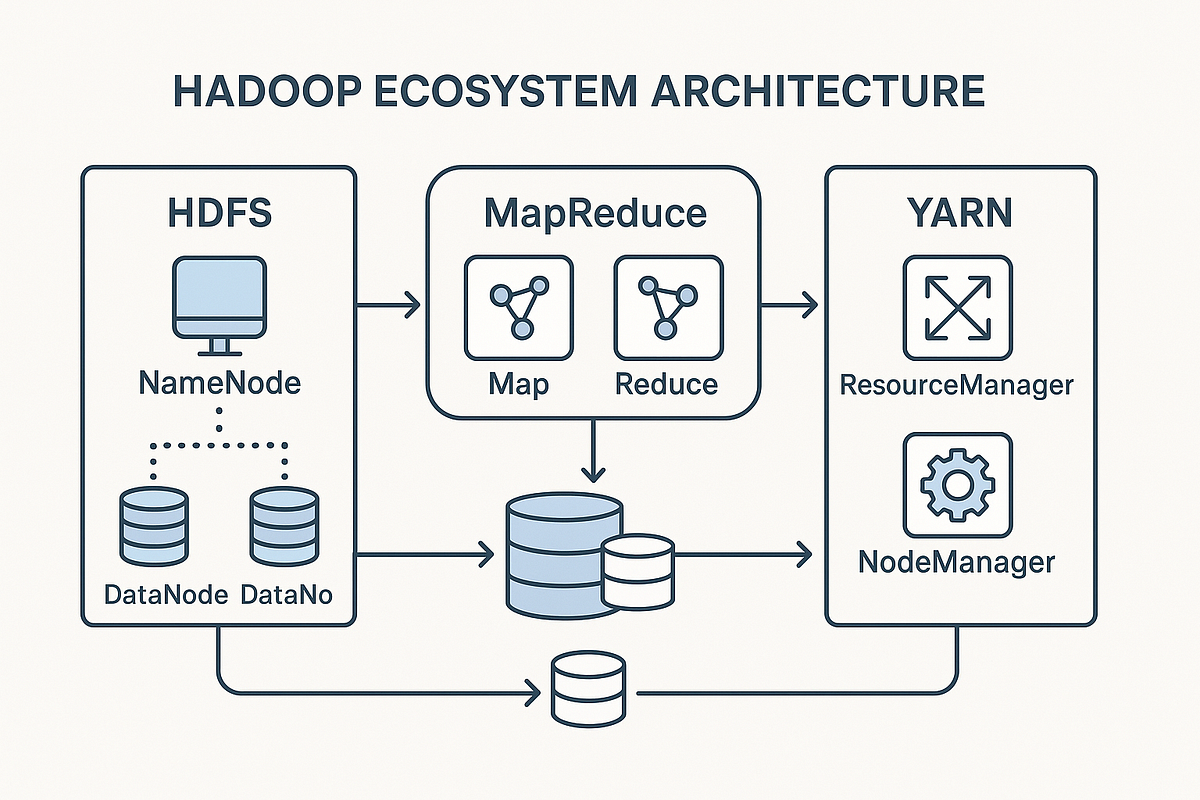
Ключевые концепции:
- Контейнер как базовая единица планирования. Контейнер включает набор ресурсов (memory, vCPU) и окружение исполнения. Контейнеры изолируются на уровне ядра ОС через механизмы cgroups и надстроек ядра, что позволяет ограничивать потребление и влиять на качество обслуживания.
- Ресурсы кластера представлены как уникальный набор возможностей: общее количество памяти и CPU на узел, а также динамически доступные параметры. RM должен точно учитывать текущую загрузку NM и доступные ресурсы, чтобы минимизировать задержки и избегать перегрузки узлов.
- Планирование - это не только распределение ресурсов, но и адаптация к подпискам и приоритетам: задачи разных приложений могут требовать различной доли ресурсов, локальности данных или обеспечения QoS.
Изучение архитектуры помогает понять, какие точки отказа и узкие места существуют в системе. Например, узкие места в RM могут стать критичными для задержек в планировании и перераспределении ресурсов во время пики нагрузки. Подходы к повышению доступности RM включают избыточность через High Availability (HA) и механизмы фоллоуэра (failover), а также разделение планирования на активную и резервную роли. В рамках архитектурной модели важно учитывать совместимость версий между компонентами экосистемы Hadoop и следить за тем, чтобы новые версии ядра YARN сохраняли совместимость с существующими AM и сервисами.
Реализация поддержки QoS начинается на уровне политики планирования и заканчивается настройками конкретных очередей. QoS в YARN достигается через гарантирование пропускной способности очередей, приоритеты задач и, при необходимости, прерывание задач (preemption). Важную роль играют узлы с ярлыками (Node Labels), позволяющие ограничивать, на каких узлах могут размещаться контейнеры определённых приложений. Это дает возможность настройки локальности и изоляции на более тонком уровне, чем просто общая ёмкость кластера. Альтернативой является настройка политик на уровне очередей: cap, share и перехват ресурсов, что позволяет обеспечить баланс между скоростью выполнения и предсказуемостью задержек.
Очереди, политика планирования и QoS на уровне кластера
Очереди в YARN создают логическую декомпозицию ресурса: каждая очередь инкапсулирует набор ограничений и правил планирования для приложений, принадлежащих конкретной группе пользователей, проекта или бизнес-единице. В рамках технических и эксплуатационных требований очереди служат фундаментом для обеспечения изоляции и предсказуемого поведения систем в условиях высокой конкуренции за ресурсы.
Существуют две наиболее распространённые реализации планирования в YARN: Capacity Scheduler и Fair Scheduler. Capacity Scheduler подходит для организаций, которым нужна горизонтальная масштабируемость и гарантированная доля ресурсов для каждого департамента или проекта. Он позволяет задавать cap на ресурсы и гарантирует минимальные порции для каждой очереди, даже в условиях пиковых нагрузок. Fair Scheduler ориентирован на уровень справедливости между активными приложениями. Он стремится предоставить каждому приложению примерно равную долю ресурсов за прочитанный период времени, что особенно ценно в окружениях с разнообразной загрузкой и многочисленными пользователями.
Построение QoS включает несколько механизмов:
- Гарантированные ресурсы на уровне очереди: cap и minResources позволяют задать минимально гарантированную часть ресурсов, чтобы важные процессы не уходили в неизбежную задержку.
- Привязка контейнеров к узлам через Node Labels: позволяет локализовать выполнение, например, для задач с высокой интенсивностью I/O на конкретных дисках, или для задач, связанных с данными, размещёнными на отдельных узлах.
- Приоритеты и прерывание: прерывание (preemption) позволяет RM высвобождать ресурсы у менее важных приложений в пользу более критичных задач. Это особенно полезно во время пиковых нагрузок или сбоев.
- Мониторинг влияния на задержку: сбор метрик по времени ожидания в очереди, времени до запуска контейнера и фактической задержке выполнения помогает корректировать параметры квот и баланс между очередями.
Настройка очередей часто опирается на конфигурационные файлы кластера. В случае Capacity Scheduler выражение политики может выглядеть как:
- root > проект1, project2, project3 с заданными cap и minResources.
- В рамках каждой очереди могут быть вложенные очереди для подразделений, с собственными настройками.
Важным аспектом является предсказуемость задержек и предвидение проблем с планированием. Следует внедрить практику постоянной калибровки: мониторинг потребления ресурсного времени, анализ задержек запуска и периода перераспределения. Необходимо учитывать влияние preemption на приложения: прерывание может приводить к потере вычислений, поэтому стоит настраивать пороги прерывания так, чтобы минимизировать потерю ценных вычислительных шагов, особенно для долгих задач и интерактивных рабочих нагрузок.
Имеет смысл рассмотреть интеграцию с дополнительными инструментами мониторинга кластера: например, сбор статистики по очередям, уровням QoS и задержкам выполнения. Это позволит заранее выявлять узкие места, прогнозировать влияние изменений на производительность и на устойчивость работы кластера. В реальных условиях оптимальная стратегия планирования - это сочетание гарантированного обеспечения критически важных задач на конкретных очередях и поддержки справедливой загрузки для остальных рабочих нагрузок.
Контейнеры: жизненный цикл, ресурсы, изоляция и отказоустойчивость
Контейнеры в YARN являются единицами выполнения, которые RM выделяет на основании доступного объема ресурсов. Контейнеры не только предоставляют изоляцию в рамках операционной системы, но и позволяют управлять жизненным циклом задач на уровне каждого узла.
Жизненный цикл контейнера начинается с запроса ресурсов у RM через AM. После утверждения ресурса RM запускает контейнер на одном из узлов, где NM готовится предоставить пространство вычислительных ресурсов и необходимую среду выполнения. В рамках контейнера запускается процесс, который может быть основным рабочим процессом задачи, а также вспомогательные процессы, включая процессы логирования, мониторинга и взаимодействия с системой управления данными.
Изоляция и ресурсы достигаются с помощью технологий ОС и платформенных механизмов. Ключевые элементы:
- Ограничение памяти в рамках контейнера для предотвращения «OutOfMemory» и переполнения кэшами, что могло бы повлиять на соседние задачи.
- Ограничение CPU через cgroups и приоритеты процессов внутри контейнера, чтобы задача не монополизировала узел.
- Изоляция сетевых потоков и дисковых операций, чтобы минимизировать взаимное влияние задач.
- Узлы с ярлыками (Node Labels) дают дополнительную гибкость в размещении контейнеров, что усиливает QoS за счет локальности данных и более управляемого использования ресурсов.
Устойчивость к сбоям в контексте контейнеров достигается за счет нескольких подходов:
- Мониторинг жизненного цикла контейнера и автоматическое восстановление в случае сбоев или аварийной остановки процесса.
- Стратегия перезапуска и повторного выполнения: если контейнер завершается ошибкой, AM может инициировать повторный запуск на том же или другом узле в рамках заданного числа попыток.
- Взаимодействие с RM и NM: при сбоях узла, NM передаёт информацию RM и AM, что позволяет переназначить или перераспределить контейнеры без потери работоспособности.
QoS на уровне контейнеров достигается через ограничение ресурсов и прерывания. При необходимости, RM может прервать ресурсы, выделенные менее критичным задачам, чтобы освободить пространство для более приоритетных приложений. Это особенно важно в случаях пиковых нагрузок и для выполнения критических рабочих процессов с минимальными задержками. В корпоративной среде эксплуатация QoS также может сопровождаться использованием ярлыков узлов и стиральной политики для определения того, где следует размещать наиболее чувствительные к задержкам контейнеры, например, для аналитических приложений, требующих быстрого доступа к данным на локальном носителе.
Практическая настройка контейнеров включает:
- Определение оптимальных параметров памяти и CPU для различных типов задач, учетом профилей приложений и типовых рабочих нагрузок.
- Настройку политики прерывания и параметров прерывания, чтобы минимизировать нежелательные задержки и потери прогресса вычислений.
- Включение мониторинга и журналирования на уровне контейнера для быстрого определения узких мест и для ускорения диагностики.
- Использование Node Labels для изоляции контейнеров по требованиям: например, выполнение I/O-ресурсно-интенсивных задач на узлах с высоким пропусканием дисков или локальными данными.
Практическая реализация: настройка, мониторинг и интеграция в эксплуатацию
Эта часть главы посвящена практическим аспектам внедрения YARN в эксплуатацию Hadoop-кластера с учётом требований производительности и отказоустойчивости. Ниже приведены рекомендации и шаблоны действий, которые применяются в реальной среде.
-
Планирование пропускной способности и QoS. В начале цикла эксплуатации следует определить целевые показатели задержки, жилые интервалы очередей и требования к прерыванию. В рамках крупных кластеров разумно реализовать две или более очередей: одна обеспечивает минимальные гарантии для критических бизнес-процессов, другая - для интерактивных задач и периодических рабочих нагрузок. Периодически следует пересматривать cap и policy-параметры в зависимости от тенденций использования ресурсов.
-
Мониторинг и алертинг. Включение полной телеметрии по каждому уровню стека: RM, NM, AM, контейнеры. Необходимо собирать метрики по времени планирования, задержкам запуска контейнеров, распределению по очередям, коэффициенту прерываний и повторных попыток. Важны не только сами цифры, но и контекст: какие задачи запустились позже, чем ожидалось, какие очереди достигли предела, и какие узлы стали узкими местами.
-
Высокая доступность RM и отказоустойчивость. В современных реализациях YARN поддерживается HA-режим, при котором активная и резервная роли RM обеспечивают непрерывность обслуживания. Порядок переключения ролей должен быть надёжно протестирован и документирован. В эксплуатации важно обеспечить корректную синхронизацию состояния очередей, политик планирования и конфигураций между активной и резервной инстанциями RM.
-
Интеграция с экосистемой. В рамках Hadoop-экосистемы YARN работает как базовый механизм планирования ресурсов для таких систем, как MapReduce, Apache Spark и пр. Её настройка в связке с этими системами требует точной координации параметров выделения памяти, числа контейнеров и ожиданий по задержкам. При интеграции с Spark на YARN часто применяется dynamic allocation для контейнеров, что требует дополнительных настройок для управления пулами ресурсов и перераспределением в реальном времени.
-
Тестирование и регрессия. В условиях эволюции кластера крайне важно поддерживать тестовые сценарии, воспроизводящие пики нагрузки и реальные сценарии отказа. Регрессионное тестирование должно включать сценарии с прерыванием задач, сбоем узла и сменой активной роли RM. Это позволяет своевременно выявлять регрессию поведения планирования и корректно настраивать политики.
-
Примеры конфигурации. Конфигурации YARN включают параметры, управляющие очередями, планированием, ограничениями ресурсов и поведением при отказах. Пример ниже демонстрирует, как может выглядеть набор параметров для эффективного разделения ресурсов между очередями и обеспечения QoS:
## Пример базовых параметров для Capacity Scheduler
yarn.scheduler.capacity.root.queues = root.kpi,root.analytics,root.misc
yarn.scheduler.capacity.root.kpi.capacity = 40
yarn.scheduler.capacity.root.analytics.capacity = 40
yarn.scheduler.capacity.root.misc.capacity = 20
yarn.scheduler.capacity.root.kpi.user-limit-factor = 1.0
yarn.scheduler.capacity.root.analytics.user-limit-factor = 1.0
yarn.scheduler.capacity.root.misc.user-limit-factor = 1.0

## Пример для Node Label и изоляции
yarn.node-labels.enabled = true
yarn.scheduler.capacity.root.kpi.useNodeLabels = true
yarn.node-labels.machine1 = true
yarn.node-labels.machine2 = true
-
Инструменты и открытые решения. В открытом источнике широко применяются проекты, которые помогают мониторингу и управлению кластерами. Например, Apache Ambari и Cloudera Manager предоставляют удобные UI и автоматизированные сценарии настройки YARN, включая настройку очередей, политики планирования и прерываний. В российских условиях допустимы примеры отечественных решений, ориентированных на мониторинг и интеграцию с локальными системами, однако их использование требует внимательного подхода к совместимости версий и безопасности.
-
Стратегия устойчивости и регулярные операции. В эксплуатационной практике крайне важно поддерживать плановую «чистку» кластера: мониторинг неиспользуемых резервов, перераспределение ресурсов в пользу критичных рабочих нагрузок и периодическая переоценка QoS-правил в контексте текущих бизнес-требований. При этом следует избегать чрезмерной агрессивности прерывания, чтобы не обрушить прогресс важных рабочих процессов.
Key takeaways
- YARN разделяет управление ресурсами и исполнение задач на RM, NM и AM, что позволяет гибко управлять инфраструктурой кластера.
- Очереди и политики планирования обеспечивают изоляцию и предсказуемость задержек, что критично для производительных аналитических и бизнес-приложений.
- Контейнеры - это управляемые еденицы исполнения, которые обеспечивают изоляцию, ограничение ресурсов и устойчивость к сбоям.
- QoS достигается через комбинированное использование очередей, прерываний и узловой изоляции, что позволяет поддерживать требуемый уровень сервиса для критических приложений.
- Практическая эксплуатация требует системного подхода к мониторингу, тестированию и HA-режимам RM, а также выработки регламентов по настройке и обновлениям конфигураций.
- Интеграция с экосистемой Hadoop и инструментами мониторинга позволяет поддерживать баланс между производительностью и отказоустойчивостью.
- Регулярная переоценка политик планирования и параметров QoS в контексте бизнес-требований и реальной рабочей нагрузки необходима для устойчивой эффективности кластера.
FAQ
- Что такое YARN в контексте эксплуатации Hadoop и зачем он нужен?
YARN заменяет монолитный подход к управлению задачами в Hadoop, разделяя ответственность между ResourceManager, NodeManager и ApplicationMaster. RM координирует ресурсы всего кластера, NM реализует исполнение на каждом узле, а AM управляет конкретным приложением. Это разделение позволяет гибко масштабировать кластер и внедрять многопользовательские сценарии с различными требованиями к QoS и задержкам.
- Как выбрать между Capacity Scheduler и Fair Scheduler для моего кластера?
Выбор зависит от бизнес-терминов и структуры организации. Capacity Scheduler обеспечивает гарантии для структурированных подразделений и predictable quotas, что полезно в больших организациях с разнесенными бизнес-юнитами. Fair Scheduler фокусируется на равномерном распределении ресурсов между активными приложениями, что полезно в средах с непредсказуемой загрузкой и необходимостью минимизировать задержки отдельных задач.
- Какие механизмы QoS доступны в YARN и как их реализовать на практике?
QoS реализуется через гарантирование ресурсов очередями (cap, minResources), приоритеты и прерывания, а также благодаря Node Labels для изоляции. Реализация включает настройку политик в конфигурационных файлах, мониторинг влияния на задержки и тестирование сценариев прерывания. Важна корректная настройка порогов прерывания, чтобы минимизировать потерю прогресса для критических задач.
- Что такое контейнер в YARN и как управлять его жизненным циклом?
Контейнер - это выделенный набор ресурсов (память, CPU) и окружение исполнения. Жизненный цикл начинается с запроса через AM, затем RM выделяет ресурсы и запускает контейнер на NM. Контейнер может завершиться успешно или с ошибкой; в случае ошибок AM может инициировать повторный запуск. Контейнеры обеспечивают изоляцию и позволяют точно контролировать использование ресурсов.
- Как обеспечить устойчивость к сбоям RM и нейтрализовать риск потери данных?
Высокая доступность RM достигается через HA-режим с активной и резервной ролями RM и механизмами failover. Это требует согласованности конфигураций и синхронизации состояний. В случае сбоя активной инстанции, резервная переходит в активное состояние и продолжает управление. Важна регулярная проверка миграции состояний и корректная настройка сессий и очередей между ролями.
- Какие параметры следует оптимизировать при планировании нагрузок в кластере?
Ключевые параметры - объем памяти и CPU, выделяемые для разных очередей; политики cap и user-limit-factor; параметры прерывания и числа контейнеров на AM; использование Node Labels для изоляции и локальности; настройки мониторинга и оповещений. Регулярная переоценка этих параметров в контексте текущей нагрузки позволяет поддерживать баланс между производительностью и устойчивостью к сбоям.
- Как интегрировать YARN с экосистемой Spark и MapReduce и какие нюансы учитывать?
Spark и MapReduce под управлением YARN получают ресурсы через AM и контейнеры. Для Spark часто применяют dynamic allocation, что требует корректных настроек RM, памяти и длительности жизни контейнеров. В эксплуатации важно учитывать совместимость версий и корректное распределение ресурсов между Spark-агентами и другими задачами, чтобы избежать конфликтов и чрезмерной конкуренции за контейнеры.
- Какие практики тестирования критичны для поддержания производительности и отказоустойчивости?
Необходимо проводить стресс-тестирование и сценарии отказов: отключение узла, сбой RM, прерывание задач, резкое увеличение числа задач, изменения очередей и правил планирования. Регрессионные тесты должны покрывать типовые рабочие нагрузки, а также сценарии, связанные с прерываниями и перераспределением ресурсов.
- Как управлять локальностью данных и изоляцией задач на уровне узлов?
Использование Node Labels позволяет ограничивать размещение контейнеров определённых приложений на выбранных узлах. Это полезно для задач, чувствительных к задержке доступа к данным или требующих высокой скорости I/O. Правильная локализация снижает латентность и конкуренцию за дисковый ввод-вывод, что напрямую влияет на предсказуемость времени выполнения.
- Какие сигналы указывают на необходимость пересмотра политики планирования в продакшене?
Сигналами являются устойчивое увеличение задержек в очередях, непропорциональное потребление ресурсов одними задачами, частые прерывания и потери прогресса, а также изменение бизнес-требований. В таких случаях целесообразно пересмотреть cap, перераспределить ресурсы между очередями и корректировать настройки локализации через Node Labels и политики планирования.


