

Практические кейсы: отраслевые сценарии использования Hadoop для производительности
В данной главе рассматриваются конкретные сценарии эксплуатации Hadoop-кластера для повышения производительности обработки больших данных в разных отраслях. Рассматриваются архитектурные решения, алгоритмы планирования, методы интеграции источников данных и периферийных систем, а также практические примеры настройки и мониторинга. Основной акцент сделан на объяснении причинно-следственных связей между архитектурными решениями и достигнутыми метриками производительности и отказоустойчивости.
Глава ориентирована на инженеров по данным, архитекторов решений и руководителей проектов, отвечающих за эксплуатацию Hadoop-кластеров в условиях реальных нагрузок: массированного пакетного анализа, обработки потоковых данных, моделирования и обучения, а также интеграции с современными системами ingestion и хранения.
- Архитектура, ориентированная на производительность: как выбирать топологии, параметры хранения и планирования.
- Интеграции и обмен данными: какие протоколы и форматы данных обеспечивают эффектную обработку.
- Отраслевые кейсы: банковский сектор, ритейл и любая индустрия с высокой интенсивностью данных.
- Мониторинг, диагностика и устойчивость к сбоям: как поддерживать низкие задержки и высокую доступность.
- Практические рекомендации по внедрению и тестированию производительности.
Архитектура, ориентированная на производительность
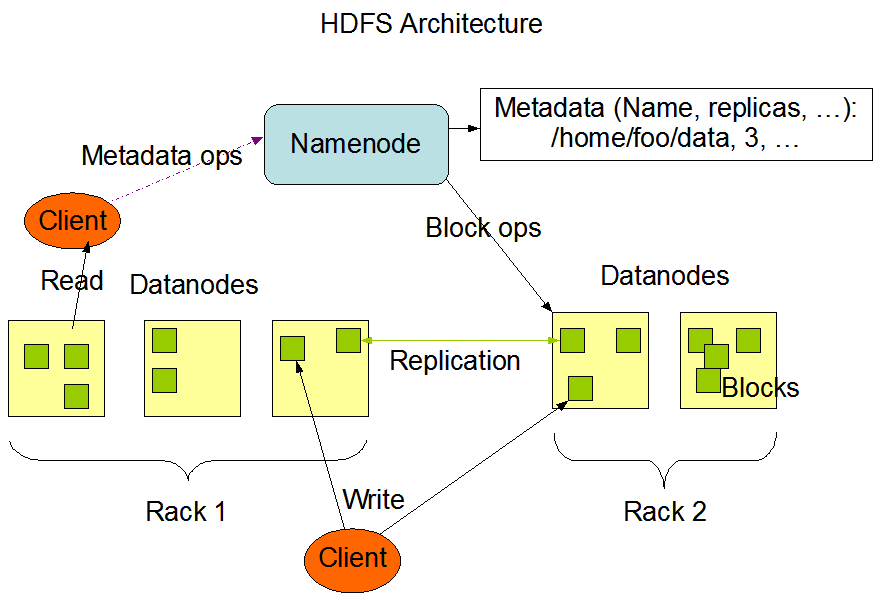
Эффективная производительность Hadoop-кластера начинается с архитектурной основы: как размещаются данные, как организуется вычислительная мощность и как обеспечивается локализация данных и балансировка нагрузки. В современном Hadoop-окружении это означает тесную интеграцию HDFS, YARN и слоев обработки (MapReduce, Tez, Spark on Hadoop) с учетом требований к задержкам, пропускной способности сети и доступности.
Основные принципы:
- Данные локализуются по возможности близко к вычислениям. Эффективная топология кластера, учет расположения узлов в стойках и сетях, а также умеренная величина блока (обычно 128-256 МБ) снижают сетевые издержки. В крупных кластерах целесообразно рассматривать адаптивную настройку размера блоков под характер нагрузки: для чтения больших последовательностей можно увеличить размер блока, в то время как для произвольного доступа к векторам - снизить его и увеличить степень параллелизма.
- Планирование задач должно учитывать диск-партии, сетевые узлы и близость к данным. Варианты планирования в YARN (CapacityScheduler, FairScheduler) позволяют управлять ресурсами между различными очередями и задачами, снижая «групповую» конкуренцию и обеспечивая приоритет бизнес-критичных рабочих нагрузок.
- Архитектура Хранения. Выбор между HDD и SSD на уровне DataNodes и опции Erasure Coding для экономии дискового пространства в больших кластерах помогают уменьшить стоимость хранения без потери производительности. В критичных для задержек сценариях разумно сочетать SSD-accelerated узлы для горячих данных и обычные HDD для холодных.
- Протоколы и интерфейсы. Внутренняя коммуникация между компонентами строится на RPC, HTTP и низкоуровневых протоколах передачи, обеспечивая малые задержки на operaciones типа RPC-get. Встроенная безопасность (Kerberos, ACL) должна быть неотъемлемой частью конфигурации, чтобы не увеличивать задержки аутентификации в больших кластерах.
## Пример: конфигурация HA NameNode и базовая настройка репликации ## Примечание: это упрощенная инструкция для иллюстрации конфигураций.
dfs.nameservices mycluster dfs.ha.namenodes.mycluster nn1,nn2 dfs.namenode.rpc-address.mycluster.nn1 host1:8020 dfs.namenode.rpc-address.mycluster.nn2 host2:8020 dfs.client.failover.proxy.provider.mycluster org.apache.hadoop.hdfs.server.namenode.ha.CachingNameNodeProxyProvider dfs.replication 3 Архитектурные решения для производительности включают настройку распределения нагрузки между очередями в YARN, корректную реализацию HA NameNode, выбор схемы хранения и оптимизацию сетевых путей. В отраслевых сценариях особенно важно сочетать подходы к хранению и вычислениям, которые позволяют минимизировать задержки при пиковых нагрузках и обеспечивать предсказуемую производительность в условиях роста объема данных.
Интеграции и обмен данными: протоколы, форматы и каналы
Чтобы Hadoop мог использоваться как единая платформа для всех источников данных, необходима четко выстроенная интеграционная архитектура. В рамках производительности особое внимание уделяется скорости поступления данных, эффективному хранению и возможности повторного анализа без переработки данных.
Ключевые компоненты интеграции:
- Источники данных и каналы загрузки. Kafka, Flume и Sqoop являются наиболее часто используемыми инструментами для инфразагрузки потоков и пакетной миграции. Kafka обеспечивает устойчивую запись и потребление потоков, а Flume или NiFi - эффективную маршрутизацию и агрегацию потоков. Sqoop применим для миграций между реляционными БД и Hadoop-экосистемой.
- Форматы и стеки хранения. Parquet, ORC и Avro - стандартные форматы, обеспечивающие эффективное сжатие и схему эволютивности. Parquet и ORC особенно полезны для аналитических запросов в Spark и Hive, позволяют ускорить сканирование данных и снизить I/O.
- Безопасность и соответствие. Kerberos-авторизация, ACL, а также инструменты типа Apache Ranger позволяют скрывать чувствительную информацию и обеспечивать соответствие регуляторным требованиям без влияния на пропускную способность запросов.
- Интерфейсы и API. REST API, Thrift и протокOLs RPC обеспечивают взаимодействие между слоями: ingestion, вычислениями и хранилищем. При проектировании решений следует помнить о латентности в цепочке вызовов и возможностях кэширования на разных уровнях.
## Пример: конфигурация интеграции через Kafka и Parquet через Spark
## Конфигурация чтения данных из Kafka и сохранения в Parquet:
spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092,broker2:9092")
  .option("subscribe", "events_topic")
  .load()
  .selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)")
  .writeStream
  .format("parquet")
  .option("path", "/data/warehouse/events_parquet")
  .option("checkpointLocation", "/data/checkpoints/events")
  .start()
В рамках отраслевых кейсов требуется баланс между скоростью поступления данных и качеством их структурирования. Интеграционные решения должны поддерживать восстановление после сбоев без потери данных и снижать задержки благодаря выбору подходящих форматов и режимов загрузки. Важно учитывать совместимость форматов и версий компонентов экосистемы, чтобы минимизировать риск несовместимостей при обновлениях.
Отраслевые кейсы: производительность в банковском сектое, ритейле и промышленности
Разделение кейсов по отраслевым сценариям демонстрирует, как архитектурные решения и настройки влияют на показатели производительности в реальных условиях. Здесь рассмотрены три примера, иллюстрирующие различные режимы нагрузки и требования к задержкам.
- Финансовые транзакции и риск-аналитика. В банковском секторе критично обрабатывать огромные потоки транзакций и временные ряды для оценки риска и прогнозирования дефолтов. Основные решения включают предиктивную сегментацию рабочих нагрузок, выделение приоритетов для аварийной аналитики и использования Spark-обработки на Hadoop в рамках YARN-контейнеров. Для снижения задержек применяются локальные данные и мемориальные кэши; параллелизм на уровне партий, гибкое управление ресурсами очередей.
- Ритейл и онлайн-аналитика. В розничной торговле часто возникает задача анализа кликовых данных в реальном времени и пакетной агрегации для формирования гипотез по персонализации. Архитектура ориентирована на ingestion через Kafka, скоростной просчет в Spark SQL и оперативное сохранение результатов в Parquet/ORC форматы для повторного использования. Важны схемы управления данными, минимизация дубликатов и согласование временных меток.
- Промышленность: IoT и временные ряды. Устройства генерируют огромные потоки временных рядов. Для эффективной аналитики применяются оконные функции обработки (windowing), ускорение за счет кэшей и близости вычислений к данным. Эффективность достигается через баланс между ingested-данными и хранением в HDFS с использованием ERASURE coding и оптимизированной настройкой блоков.
Каждый кейс включает набор архитектурных решений и практических правил:
- Финансы: снижайте задержку обработки критичных потоков, используйте предиктивную предобработку и локализацию данных. Пример: настройка уровней QoS и жесткое указание приоритетов в CapacityScheduler для бизнес-критичных очередей.
- Ритейл: оптимизируйте пайплайны ingestion → хранение → анализ, применяйте столбцезависимые форматы и индексацию по временным меткам. Мониторинг времени отклика запросов и задержек между ingestion и аналитикой.
- Промышленность: применяйте оконные вычисления и агрегации на уровне Spark или Tez, настраивайте хранение горячих данных на SSD-узлах, используйте ERasure Coding для экономии пространства без потери устойчивости.
Сложности и риск: распределенная обработка несовместимых форматов, задержки из-за перегруза сети в пиковые окна, координация между периодами пакетной и потоковой обработки. Решения лежат в оптимизации планирования задач, кеширования повторяющихся вычислений и в аккуратной настройке сетевых маршрутов между дата-центрами.
Мониторинг, диагностика и устойчивость к сбоям
Производительность не достигается без длительного мониторинга и оперативной диагностики. В рамках Hadoop-окружения ключевыми являются:
- Метрики узлов и файловой системы: I/O-операции, средняя задержка чтения/записи, заполнение дисков, пропускная способность сетевых интерфейсов.
- Метрики выполнения заданий: время выполнения задач, задержки очередей, коэффициенты успешного завершения, MapReduce counters, Spark UI и Tez DAG-аналитика.
- Прозрачность слоёв: JMX-метрики JVM, логи контейнеров YARN, журнал задач и истории выполнения. В идеале сбор метрик должен быть централизованным и доступным для быстрого анализа.
- Инструменты: Ambari, Cloudera Manager, Prometheus + Grafana, Grafana Loki для логов, Sorcelain для алертинга. Важно обеспечить единый канал тревог и понятные пороги.
Безопасность и устойчивость к сбоям включают:
- HA NameNode. Включение высокодоступности с ZKFC для автоматического переключения между активной и неактивной нодой снижает риск простоя. Пример конфигурации показан ранее в разделе архитектуры.
- Репликация и стимулирование отказоустойчивости. Выбор уровня dfs.replication и применение ERASURE coding позволяют сохранять доступность данных в случае выхода отдельных узлов. В критичных системах разумно сочетать оба подхода в зависимости от типа данных.
- Cross-cluster Replication. Для обеспечения disaster recovery и локальной доступности можно рассмотреть DistCp в составе архитектуры, чтобы синхронизировать данные между кластерами в разных дата-центрах.
- Тестирование устойчивости. Регулярное проведение сценариев отказа и проверка процедур восстановления, тестирование миграций и обновлений - неотъемлемая часть эксплуатационной дисциплины.
Оптимизация отказоустойчивости и сбоев: практические подходы
Чтобы обеспечить непрерывность бизнеса в условиях отказов, применяются комплексные меры:
- Разделение данных и вычислений. Правильная сегментация данных по журналам изменений, архивам и горячим данным позволяет снизить влияние выхода отдельных узлов на общую работу кластера.
- Гибкая стратегия хранения. Введение смешанных типов хранения (SSD для hot data и HDD для cold data) позволяет снизить задержку запросов к критическим данным без чрезмерного роста затрат на хранение.
- Управление конфигурациями. Поддержка параметров настройки, которые позволяют быстро адаптироваться к изменяющимся нагрузкам: увеличение числа контейнеров YARN в пиковые окна, перераспределение ресурсов между очередями.
- Миграции и обновления. Планирование миграций версий и обновлений компонентов экосистемы, с тестированием совместимости и возвратом к предыдущей конфигурации в случае проблем.
## Пример: включение HA NameNode и настройка автоматического переключения
dfs.nameservices=mycluster
dfs.ha.namenodes.mycluster=nn1,nn2
## адреса RPC NameNode для каждого узла
dfs.namenode.rpc-address.mycluster.nn1=host1:8020
dfs.namenode.rpc-address.mycluster.nn2=host2:8020
## прокси-провайдер для автоматического переключения
dfs.client.failover.proxy.provider.mycluster=org.apache.hadoop.hdfs.server.namenode.ha.CachingNameNodeProxyProvider
Эти меры позволяют не только снизить риск простоев, но и обеспечить предсказуемость задержек при пиковых нагрузках, что особенно важно для банковских систем, онлайн-ритейла и промышленных предприятий.
Сводка по разделам и практические рекомендации
- Определяйте тип нагрузки: пакетная или потоковая обработка, и подберите соответствующие режимы планирования в YARN.
- Проектируйте топологию кластера с учётом данных locality и сетевой инфраструктуры для минимизации задержек.
- Внедряйте гибридные решения хранения: SSD для горячих данных и ERASURE Coding - для экономии пространства без потери доступности.
- Интегрируйте источники данных через надёжные каналы: Kafka/Flume, форматы Parquet/ORC, контроль версий схем.
- Развивайте мониторинг и диагностику: единая система алертинга и визуализация ключевых метрик.
- Обеспечьте высокую доступность NameNode и возможность автоматического восстановления после сбоев.
- Проводите регулярное тестирование нагрузки и сбоев для поддержания предсказуемости производительности.
Key takeaways
- Производительность Hadoop зависит от связки архитектурных решений, планирования задач и эффективной организации хранения.
- Гибридные решения хранения и адаптивные схемы планирования помогают держать задержки под контролем в пиковые периоды.
- Интеграции с источниками данных и форматами хранения должны обеспечивать минимальные задержки и высокую читаемость данных для аналитических рабочих нагрузок.
- Мониторинг и безопасная эксплуатация-неотъемлемая часть устойчивой работы кластера.
- Обеспечение отказоустойчивости требует комплексного подхода, включая HA NameNode, репликацию, ERASURE coding и Cross-cluster репликацию.
- Практические кейсы по финансам, ритейлу и промышленности демонстрируют разнообразие подходов к оптимизации производительности в рамках Hadoop.
- Регулярное тестирование и обновление инфраструктуры помогают поддерживать устойчивость к эволюции нагрузок и требований бизнеса.
FAQ
- Как выбрать оптимальный размер блока и уровеньReplication для конкретной нагрузки?
- Размер блока влияет на параллелизм и скорость чтения больших последовательностей. Для аналитических пакетных нагрузок часто целесообразно использовать больший блок (128-256 МБ). Replication factor зависит от требований к доступности и стоимости хранения: для критичных данных разумно держать 3-3,5 копий, для менее критичных - 2. Внутри кластера можно динамически адаптировать эти параметры под группы данных, не нарушая общую конфигурацию.
- Какие инструменты лучше использовать для мониторинга производительности Hadoop?
- В большинстве сред хорошо работают Prometheus + Grafana для метрик, а также системы управления, такие как Apache Ambari или Cloudera Manager, для централизованной конфигурации и алертинга. Важно обеспечить единое хранилище логов и быстрый доступ к ключевым метрикам JVM и YARN.
- Как обеспечить предсказуемую задержку в потоковых сценариях обработки?
- Используйте специализированные движки на уровне кластера (Tez, Spark) в сочетании с эффективными источниками данных (Kafka) и форматов Parquet/ORC. Применяйте ограничение по задержкам на уровне очередей YARN и настройку кеширования. Разделение горячих и холодных данных и использование SSD-узлов для горячих потоков сокращает задержки.
- Какие сценарии требуют HA NameNode и какие риски без него?
- В условиях крупных предприятий и критичных бизнес-процессов любой риск простоев NameNode недопустим. HA позволяет автоматически переключаться между активной и резервной нодой, минимизируя время простоя. Без HA возможны потери данных и длительный простой при сбоях управляющих компонентов.
- Как правильно внедрять безопасное управление доступом без ухудшения производительности?
- Реализация Kerberos в сочетании с Apache Ranger обеспечивает надежную безопасность и гибкое управление доступом к данным без значительного влияния на производительность при правильной настройке и кэшировании разрешений.
- Какие шаги предпринять для миграции workloads на новую версию Hadoop?
- Планирование совместимости API и форматов, тестирование на стенде, поэтапная миграция без остановки продакшена, мониторинг после миграции с акцентом на задержки и пропускную способность. Важно сохранить обратную совместимость на время перехода.
- Как оценивать влияние изменений конфигураций на производительность?
- Применяйте методологию A/B-тестирования под регламентируемыми рабочими нагрузками, ведите подробный регистр изменений и сравнивайте результаты по ключевым метрикам: задержки, throughput, ресурсная нагрузка (CPU, память, I/O).
- Какиеiform-примеры открытых проектов и инструментов полезны для повышения производительности?
- Apache Spark и Tez на базе Hadoop обеспечивают значительный прирост скорости для аналитических задач по сравнению с чистым MapReduce. Apache Ranger и Kerberos обеспечивают безопасность, а Kafka и NiFi - устойчивый поток данных и интеграции. В рамках российского рынка можно упомянуть локальные решения интеграции, которые адаптированы под нормативные требования, однако основной упор остаётся на открытые экосистемы с хорошей поддержкой.
- Как обеспечить устойчивость к сетевым сбоям и перегрузкам?
- Резервирование каналов связи между дата-центрами, балансировка сетевого трафика и настройка QoS на уровне сетевой инфраструктуры важны. Учитывайте задержки между узлами, которые могут существенно влиять на время выполнения распределённых задач.
- Нужно ли тестировать производительность на уровне всей экосистемы?
- Обязательно. Прогон тестов под реальными рабочими нагрузками, включая ingestion, хранение и анализ, позволяет выявлять узкие места на ранних стадиях и оптимизировать конфигурации до перехода в продакшн.


