

Грани и временности: гранулярность и история изменений
Гранулярность и временность являются двумя краеугольными концепциями моделирования витрины данных. Гранулярность задаёт зерно анализа - уровень детализации фактов и измерений, на котором ведётся учёт операций и происходящих изменений. Временность же описывает, как фиксируются настоящие и прошедшие состояния данных во времени: когда именно факт произошёл, когда он стал доступен в витрине, и какие версии данных доступны для анализа в конкретном контексте бизнес-потребностей. В сочетании эти концепции позволяют строить витрину, которая не только отражает текущее состояние бизнеса, но и сохраняет след времени, обеспечивая точную ретроспективу и корректную агрегацию на разных уровнях семантики.
Фокус главы - на том, как определить и зафиксировать гранулы данных, как проектировать хранение историй изменений и какие архитектурные решения обеспечивают корректную семантику времени в витрине. Рассмотрены как концептуальные основания, так и практические конструкции: схемы фактов и измерений, типы исторических версий, подходы к загрузке и синхронизации источников, а также способы обеспечения качества и управляемости исторических данных.
- Определение гранулярности витрины и её связь с бизнес-ценностями и семантикой данных.
- Временная гранулярность: как фиксируются изменения во времени, какие паттерны версионирования применяются и как это влияет на аналитические запросы.
- Архитектурные решения и схемы: как выбрать модель хранения (star/snowflake, Data Vault, lakehouse-подходы) для поддержки историй и гранул.
- Интеграция источников и протоколы загрузки: CDC, потоковые и пакетные подходы, гарантии консистентности и навигации по времени.
Гранулярность как фундамент витрины данных
Гранулярность задаёт зерно событий и измерений, которое становится единицей анализа. Именно на этом уровне бизнес-логика определяет, какие поля и какие комбинации ключей являются атрибутами фактов и измерений. Важно отделять понятие бизнес-зерна от физического хранения: одна и та же бизнес-ситуация может быть представлены на разных уровнях детализации в разных слоях витрины ( Raw, Cleansed, Business). Этот подход позволяет не только снизить стоимость ответов на специфические запросы, но и сохранить достаточную детализацию для аудита, регуляторных требований и причинно-следственных анализов.
Гранулярность в контексте измерений и фактов тесно связана с источниками данных и временными аспектами. Например, событие продажи может быть зафиксировано с точностью до секунды, в то время как агрегации по дневной или недельной детализации требуют аккуратной обработки времени, чтобы избежать двойного учёта или пропусков. Важной здесь является концепция зерна времени: transaction time (время фиксации в витрине) и event time (время, когда событие фактически произошло). Разделение этих времён позволяет корректно отвечать на вопросы "когда событие произошло в бизнес-процессе" и "когда мы увидели это событие в системе".
- В архитектуре витрины данных существует риск «размывания» границ между уровнями детализации, если не определить явное зерно для каждой таблицы. Каждая таблица фактов должна иметь явно указанные поля зерна (например, зерно продаж - {продукт_id, магазин_id, дата_факт, валюта, сумма}). Аналогично измерениям следует определить зерно измерения (например, клиент, продавец, география) и временной контекст, в котором оно трактуется.
- Изложение семантики времени требует внедрения политик хранения времени, включая создание метаданных по времени действия данных, диапазона валидности и версии. Без этого аналитик не может корректно сочетать данные из разных источников или проводить ретро-аналитику с надлежащей точностью.
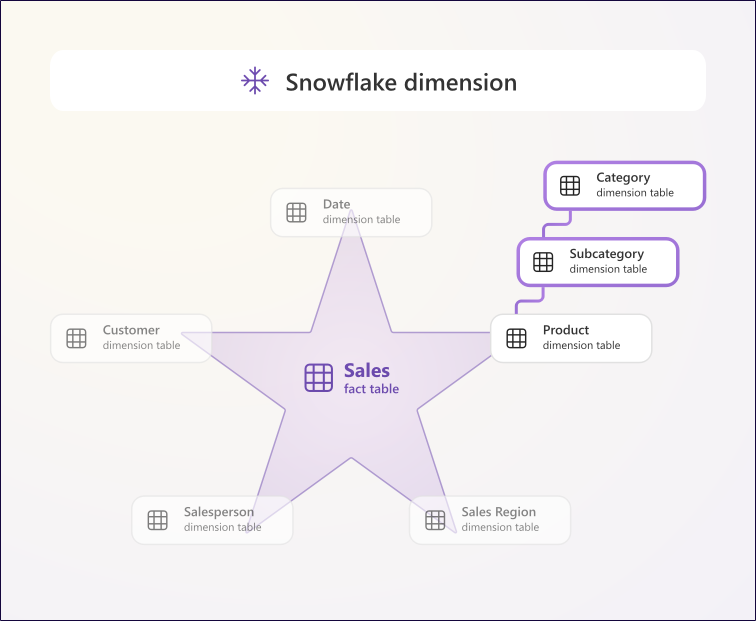
Факты и измерения: гранулярность на уровне данных
Гранулярность фактов задаёт точность и детализацию транзакций и бизнес-операций, которые регистрируются в витрине. На уровне фактов зерно обычно фиксируется через признаки, определяющие конкретную ситуацию: что произошло, где и когда. Фактовый слой опирается на измерения, которые дают контекст для этих событий: клиенты, продукты, каналы, география и т. д.
- Факт имеет «зерно» - совокупность ключей измерений и временных аспектов, которые однозначно описывают конкретное событие или агрегированную величину. Например, факт продажи может иметь зерно: (факт_продажи_id, product_id, store_id, date_id, quantity, amount).
- Измерения добавляют контекст и могут иметь свои собственные зерна: например, измерение «клиент» может основываться на (customer_id, loyalty_level, region), где временной контекст важен для анализа динамики поведения.
Традиционные СХЕМы витрины - звезда (star) и снежинка (snowflake) - нередко расчленяют зерно между фактами и измерениями. Важно обеспечить, чтобы каждое измерение имело явное семантическое описание времени и контекста. В реальных сценариях зерно может зависеть от бизнес-сценария: например, зерно «заказ» отличается от зерна «модель клиента» или «сегментация по кампании» - и каждое зерно может жить в рамках отдельных слоёв витрины.
- В контексте реализации это означает, что фактовые таблицы будут держать ключи измерений и временной контекст, тогда как размерные таблицы - детальные атрибуты и их собственный временной контекст, если применимо.
- В некоторых сценариях целесообразно отделять временные атрибуты в отдельных политических слоях: например, для измерений можно хранить версию атрибутов или их период действия, чтобы поддержать историю изменений без дублирования фактов.
| Тип изменения | Описание | Пример применения |
|---|---|---|
| SCD Type 1 | Перезапись атрибута без сохранения истории | Обновление имени клиента без сохранения прошлых значений |
| SCD Type 2 | Добавление новой записи версии измерения с сохранением истории | Изменение адреса клиента - создаётся новая версия с действительным периодом |
| SCD Type 3 | История через дополнительные атрибуты прошлого значения | Удержание текущего и прошлого значения в отдельных столбцах |
| SCD Type 4 | Отдельная «историческая» таблица для вариаций | Разделение текущих и исторических версий в две таблицы |
| Бим temporal | Время действия и время фиксации в витрине | Возможность временного запроса по реальному времени и по учёту изменений |
Практические примеры на уровне механизмов версионирования показывают, как выбрать подход, соответствующий бизнес-требованиям к анализа и аудиту. В реальности часто сочетаются несколько способов сохранения истории: часть атрибутов хранится по SCD Type 2, часть - по SCD Type 1 в отдельных измерениях, а часть - в багажной «исторической» таблице для быстрого доступа к прошлым состояниям.
-- Пример SCD Type 2: добавление новой версии dimension
## MERGE INTO dim_customer AS target
USING (SELECT customer_id, name, address, effective_from, effective_to
## FROM staged_customer) AS source
## ON target.customer_id = source.customer_id
WHEN MATCHED AND (target.name  source.name OR target.address  source.address)
  THEN UPDATE SET effective_to = CURRENT_DATE - INTERVAL '1' DAY
## WHEN NOT MATCHED THEN
  INSERT (customer_id, name, address, effective_from, effective_to)
  VALUES (source.customer_id, source.name, source.address, CURRENT_DATE, '9999-12-31');
Рассмотрение таких механизмов в контексте гранулярности требует учета задержек между событием и его появлением в витрине, а также учет параллельности загрузок из разных источников. В некоторых случаях целесообразно организовать «когда данные становятся видимыми» как отдельный временной контекст для анализа и отчетности.
Временная гранулярность и история изменений: SCD, версии и хроники
Работа с временной гранулярностью требует систематического подхода к учёту времени. В витрине данных временная гранулярность описывает не только точность моментности записи, но и период валидности и доступности состояния данных. В практических условиях это означает двойной временной слой: transaction time (когда запись поступила в хранилище) и event time (когда событие реально произошло в бизнесе). Такой подход позволяет:
- корректно строить ретроспективные отчёты и анализ «что видели тогда»;
- синхронизировать данные из разных источников с различной задержкой;
- соблюдать регуляторные требования по аудиту и версии.
Временная история изменений подключает концепции SCD (Slowly Changing Dimensions) и их вариации, а также современные подходы бимTEMPORAL (бимем temporal) для сложных сценариев. Важной частью является выбор стратегии хранения и доступа к версиям: хранение версий в отдельных таблицах (SCD Type 2/Type 4), хранение временных атрибутов внутри таблиц (Type 1/Type 3), либо применение гибридных решений на уровне архитектуры витрины.
-
SCD Type 2 позволяет сохранять полную историю изменений измерений и поддерживает согласованность при ретроспективном анализе. Основное - наличие действенных полей: effective_from, effective_to, version и обновления соответствующих индексов для ускорения запросов.
-
SCD Type 3 даёт компактное хранение прошлого значения в наборах атрибутов, но ограничивает глубину истории и подходит для задач, где критично видеть только текущее и предыдущее состояние.
-
Бим Temporal-модели требуют поддержки версий как в измерениях, так и в фактах, обеспечивая временную валидность каждого значения и возможность запроса данных по конкретному моменту времени и историческим контекстам.
-
В реальных системах полезно применять паттерны временного управления: хранение «периодов действия» в измерениях, «дату начала/окончания» активности фактов и метаданные по источнику, чтобы обеспечить прозрачность и возможность аудита.
-
Архитектура витрины часто предполагает несколько слоев: Raw (сырые данные с минимальной обработкой времени), Cleansed (стандартизированные и валидированные данные), Business (концептуальные измерения и факты) и иногда Vault (хранилище метаданных и истории). Временные слои помогают разделить ответственность за хранение истории и управляемость достоверной семантики.
-
В рамках архитектурных подходов полезно упоминать современные технологии Lakehouse, которые поддерживают нативное хранение версий и временную навигацию. Примеры open-source инструментов для реализации временной навигации и версий: Apache Iceberg и Apache Hudi - они предоставляют функциональность времени путешествий (time travel) и версионирования таблиц.
-
Российские и локальные решения иногда применяются там, где особенно важна регуляторная совместимость и локализация: в качестве примера можно упомянуть мерехи интеграции с ClickHouse для аналитических запросов и быстрой навигации по временным версиям в рамках больших наборов данных.
Архитектура и модели: как реализовать гранулярность и версионирование
Реализация гранулярности и истории требует выбора архитектурных моделей, которые обеспечивают баланс между детальностью данных, производительностью запросов и управляемостью изменений. В качестве базовых направлений чаще применяются:
-
Star и Snowflake схемы для явного разделения фактов и измерений, с явной привязкой к времени через временные атрибуты и диапазоны валидности. В контексте гранулярности это означает, что каждому измерению и факту назначается конкретное зерно - например, продажа за день и за конкретный товар.
-
Data Vault как архитектура, ориентированная на историю и интеграцию данных из множества источников. Vault-философия поддерживает версионирование через hubs, links и satellites, что естественно соприкасается с задачами временной навигации и аудита изменений.
-
Lakehouse-подходы: хранение в формате колонного слоя с поддержкой времени путешествий и версионирования таблиц, включая интеграцию с потоками данных и CDC. В качестве практических инструментов можно указать Iceberg/Hudi в зависимости от инфраструктурного контекста. Эти технологии позволяют гибко управлять версиями таблиц и обеспечивают эффективное выполнение аналитических запросов на разных уровнях гранулярности.
-
Логика версионирования в витрине требует явной политики по времени действия данных: определение даты начала и окончания валидности, управление «покрытием» текущей версии и архивных копий. Это критично для точной агрегации и ретроспективного анализа.
-
Архитектура протоколов загрузки и интеграции: CDC (Change Data Capture) и streaming-потоки (Kafka, Kinesis) обеспечивают своевременное обновление витрины и сохранение контекста времени. В сочетании с временными моделями это позволяет поддерживать актуальные данные без потери истории.
-
Важной частью является метаданные и управление данными: версия, источник, качество и соответствие требованиям. Наличие управляемого слоя метаданных существенно упрощает доступ к данным, их поиск и аудиты.
-
Пример интеграции: источники систем продаж отправляют события в поток в режиме реального времени, биндинг к витрине выполняется через потоковую обработку и CDC. В витрину попадают оба типа изменений: текущие версии и исторические, через SCD-тип-2 или аналогичные механизмы. В результате аналитики получают возможность строить временные серии и ретроспективные досье по целым сегментам.
Применение конкретных решений требует баланса между требованиями бизнеса и ограничениями инфраструктуры. В круглом контексте можно опираться на пары технологий: Iceberg и Hudi для временной навигации в lakehouse, и в российских реалиях - ClickHouse как потребитель аналитических запросов и источников с хорошей скоростью чтения, а также современные конструкторы потоков и интеграционных пайплайнов (например, open-source конвейеры CDC и ELT-инструменты) для обеспечения непрерывности данных.
-- Пример MERGE-процедуры SCD Type 2 для обновления измерений в витрине
MERGE INTO dim_customer AS target
## USING staged_customer AS source
## ON target.customer_id = source.customer_id
WHEN MATCHED AND (target.name  source.name OR target.address  source.address)
  THEN UPDATE SET target.effective_to = CURRENT_DATE - INTERVAL '1' DAY
## WHEN NOT MATCHED THEN
  INSERT (customer_id, name, address, effective_from, effective_to)
  VALUES (source.customer_id, source.name, source.address, CURRENT_DATE, '9999-12-31');
-
В этой схеме ясно прослеживается временная гранулярность: существующая версия маркируется как устаревшая, новая версия становится текущей. В реальном проекте такой подход следует дополнить индексами по эффективным периодам, чтобы ускорить запросы на конкретный временной интервал.
-
В контексте протоколов загрузки стоит организовать три слоя для загрузки: raw (передача через CDC), cleansed (нормализация, устранение дубликатов, унификация форматов дат и чисел) и business (математические агрегации и бизнес-правила). Это обеспечивает управляемость изменений по времени и упрощает тестирование.
Практические сценарии внедрения: интеграция источников и поддержка семантики времени
Реальные проекты требуют сочетания методик и инструментов, чтобы обеспечить корректную гранулярность и устойчивую историю изменений. В этом контексте полезны следующие практики:
-
Ясная дефиниция зерна для каждого фактового и измерительного объекта. Это минимизирует неоднозначности в аналитических запросах и упрощает экспорт в BI-слоя.
-
Чёткая политика версий и времени валидности. Необходимо определить, какие состояния считать «актуальными» в конкретном сценарии анализа и как обрабатывать временные пересечения между источниками.
-
Управление качеством данных и аудит изменений. Включение полей источника, времени фиксации, роли пользователя и т.д. облегчает аудит и воспроизводимость.
-
Инструменты для временной навигации. Применение Lakehouse-технологий или специализированных механизмов версионирования таблиц позволяет исследователю данных "вернуться в прошлое" и проверить, как бизнес-процессы выглядели в конкретный момент.
-
Границы между слоями загрузки. Разделение raw, cleansed, и business слоёв обеспечивает чистую архитектуру и упрощает тестирование.
-
Важно помнить и про организационные аспекты: роли и ответственности, процессы управления изменениями, тестирование и регламент по развёртыванию пайплайнов. В частности, для методологий DevOps и DataOps необходима автоматизация тестирования и мониторинга изменений в гранулярности и версиях.
Key takeaways
- Гранулярность витрины определяет зерно данных, которое используется для аналитики; она формирует точность и производительность запросов.
- Временная гранулярность требует явного учёта времени действия данных (valid time) и времени фиксации в хранилище (transaction time); совместно они обеспечивают корректную ретроспективу.
- Существуют разные подходы к хранению истории: SCD Type 1, 2, 3 и более сложные бим temporal-модели; выбор зависит от бизнес-требований к аудиту и аналитике.
- Архитектура витрины может быть построена на Star/Snowflake схемах, Data Vault и lakehouse-решениях; каждый подход имеет свои преимущества для поддержки истории и гранулярности.
- Интеграция источников через CDC и потоковые механизмы требует продуманной политики времени и валидности, чтобы сохранить согласованность между источниками и витриной.
- Open-source и локальные решения (например, Apache Iceberg, Apache Hudi, ClickHouse) могут существенно ускорить реализацию временной навигации и версии таблиц, но требуют обоснования в контексте инфраструктуры и регуляторных требований.
- Метаданные по времени, источникам и версиям необходимы для аудита, прослеживаемости и управления качеством данных в витрине.
- Внедрение слоя метаданных и governance упрощает использование витрины бизнес-аналитиками, инженерами и составителями репортов.
- Рациональное сочетание SCD-стратегий и временных паттернов позволяет оптимально балансировать между сохранением истории и эффективностью запросов.
- Важно не перегружать архитектуру лишними слоями; цель - обеспечить необходимую детализацию бизнес-кейсов и возможность масштабирования по мере роста объёмов данных.
FAQ
- Что такое гранулярность витрины и зачем она нужна?
Гранулярность витрины данных - это конкретное зерно, на котором строится аналитика: какие поля и какие комбинации ключей образуют одну запись в фактовой или измерительной таблиce. Она влияет на точность агрегаций, объём хранения и скорость ответов на запросы. Правильная гранулярность позволяет избегать избыточности, не забывая про возможность анализа на нужном уровне детализации.
- Как выбрать гранулярность для фактов и измерений?
Выбор гранularity обусловлен бизнес-требованиями: какие события и какие детали необходимы аналитикам. Факты должны содержать ключи измерений и временной контекст; измерения - атрибуты с идентификаторами и временем действия. Эффективно - фиксировать зерно по бизнес-логике и оставлять возможность масштабирования: начинать с минимального разумного зерна и расширять по мере спроса, сохраняя исторические данные через SCD.
- В чем разница между event time и transaction time и как они применяются в витрине?
Event time - время самого события в бизнес-процессе; transaction time - время, когда запись появилась в хранилище или была изменена системой. Разделение обеих времён позволяет корректно анализировать состояние бизнеса в момент времени и управлять задержками загрузки из источников. Это особенно важно для ретроспективной аналитики и кросс-источниковой консолидации.
- Какие подходы к хранению истории данных существуют и когда их применять?
Наиболее распространены SCD Type 1 (перезапись), SCD Type 2 (добавление новой версии), SCD Type 3 (сохранение предшествующей версии в дополнительных атрибутах) и более сложные бим temporal-модели. Выбор зависит от требований к аудиту и анализу: если нужно сохранить полную историю изменений атрибута - выбирают Type 2; если достаточно видеть текущее и предыдущее - Type 3; если история не требуется - Type 1.
- Какую архитектуру выбрать: star, snowflake, Data Vault, lakehouse?**
Выбор зависит от контекста: звезда и снежинка - простые и эффективны для аналитики; Data Vault - лучше для интеграции большого количества источников и версионирования; lakehouse - объединяет хранение данных и вычисления с поддержкой времени и версий. В современных проектах часто применяют гибрид: витрина на слоях Data Vault для источников и Lakehouse для хранения версий и временных аспектов.
- Какие инструменты и паттерны помогают реализовать временную навигацию?
Apache Iceberg и Apache Hudi предлагают нативную поддержку версий таблиц и time travel, что упрощает реализации временной навигации. В российской и локальной среде может быть полезна интеграция с ClickHouse для быстрых аналитических запросов и поддержки простых временных запросов. Внедрение CDC и потоков (Kafka/Kinesis) обеспечивает своевременное обновление витрины и сохранение контекста времени.
- Как обеспечить качество и аудируемость историй изменений?
Необходимо внедрить управляемый слой метаданных: источник данных, время возникновения события, версия, режим обработки. Также полезны тестовые наброски: регрессионные тесты на корректность SCD, тесты на консистентность между слоями Raw и Cleansed, проверки целостности временных интервалов. Аудит изменений и репликация в рамках индустриальных регуляторных требований помогают снизить риски.
- Какие риски существуют при неверной гранулярности и как их минимизировать?
Неправильная гранулярность может привести к неверным агрегациям, пропускам данных и неоправданной нагрузке на хранилище. Чтобы минимизировать риски, следует: четко определить зерно для каждого объекта, поддерживать общий словарь измерений и фактов, внедрять мониторинг качества данных, тестировать изменения в гранулярности в рамках регламентированных цепочек изменений.
- Как тестировать гранулярность и версионирование?
Тестирование следует проводить на уровне моделирования запросов бизнес-потребителя, проверки ретроспективности и консистентности версий. Включайте тесты на корректность SCD обновлений, тесты на целостность временных интервалов и на совместимость между слоями. Автоматизированные тестовые сценарии и регрессионные тесты по времени позволят обнаружить отклонения до внедрения.
- Как поддерживать семантику времени в многоисточниковой витрине?
Необходимо создать централизованный слой управления временем: единый подход к определению event time и transaction time, единый формат временных полей, единая политика обновления и архивирования. Важно обеспечить прозрачность источников и цепочку происхождения данных, чтобы аналитики могли корректно сравнивать данные между источниками и периодами времени.
Эта глава обеспечивает практическое понимание того, как концепции границы и времени формируют архитектуру витрины данных, как выбирать подходящие схемы и методы версионирования, и какие паттерны загрузки и управления данными применяются для устойчивой аналитики в условиях изменений и разнообразия источников.


