

ETL vs ELT и паттерны загрузки: CDC, репликация и конвейеры данных
Витрины данных сегодня строятся на стыке традиционных подходов к обработке данных и современных концепций lakehouse/платформенной трансформации. Выбор между ETL и ELT, а также применение паттернов CDC, репликации и конвейеров данных определяют скорость внедрения, стоимость владения и качество бизнес-аналитики. Глава ставит целью систематизировать концепции, сравнить архитектурные решения и описать практики реализации, которые обеспечивают устойчивость семантики витрин: фактов, измерений и бизнес-словаря.
Эффективность загрузки в витрину во многом зависит от баланса между задержкой, объёмом обрабатываемых данных и требованиями к управляемости данных. В ходе обзора приведены принципы, лежащие в основе каждого паттерна, а также критерии выбора технологий и процессов: от проектирования зон обработки в хранилище до мониторинга качества и согласованности данных на уровне бизнес-словаря.
- ETL против ELT: критерии выбора, архитектурные последствия и сценарии применения.
- CDC, репликация и конвейеры данных как ключевые паттерны загрузки в реальном времени и близком к нему времени.
- Семантика витрины: как факты, измерения и конформированные измерения поддерживают бизнес-аналитику и управляемость данных.
- Практические схемы внедрения, управление качеством, безопасность и эволюция схем.
ETL vs ELT: архитектура, выбор и последствия
ETL (Extract-Transform-Load) и ELT (Extract-Load-Transform) представляют собой два разных подхода к превращению данных и их загрузке в целевой сегмент витрины. В контексте моделирования витрин данных это различие определяется тем, где выполняется трансформация: в отдельном ETL-слое перед загрузкой в схему витрины или уже после загрузки - на вычислительных мощностях целевой системы.
- Архитектура ETL ориентирована на централизованную обработку в промежуточном хранилище: извлечение из источников, трансформация и очистка данных выполняются до загрузки в staging/consumer-зоны. Такой подход часто обеспечивает раннюю проверку качества и детерминированную схему, однако может создавать узкие места при больших объёмах и высокой частоте обновления.
- Архитектура ELT переносит основную трансформацию в целевую систему: данные загружаются «как есть» в долговременный хранилищный слой, а затем выполняются трансформации средствами целевой платформы. Это благоприятно для горизонтального масштабирования и сокращения задержек на загрузке, особенно в lakehouse/облачных архитектурах, где вычислительная мощность доступна по требованию.
Выбор между ETL и ELT зависит от нескольких факторов:
- объём и скорость данных; чем выше лобовая нагрузка на источники и сеть, тем более целесообразно перенести трансформацию в целевое хранилище;
- требования к чистоте данных на входе: если бизнес-процессы требуют строгой нормализации и строгих правил очистки, ETL может быть предпочтительнее;
- стоимость вычислений и доступность вычислительных ресурсов в целевой системе; ELT позволяет горизонтально масштабировать трансформации по мере роста данных;
- архитектурная зрелость платформы: традиционные СУБД и конвейеры часто лучше поддерживают ETL, тогда как lakehouse и современные data warehouse-решения развиты под ELT.
В практических условиях характерным является переход на гибридные паттерны: часть трансформаций выполняется на этапе загрузки (например, базовая нормализация и первичная проверка качества), а продвинутые преобразования - на целевой платформе с использованием инструментов ELT. Такой подход сочетает предсказуемость контроля качества и способность к масштабированию.
В контексте витрин данных особенно важно структурировать загрузку через триггеры этапов:
- Landing (или Raw) зона - сохранение исходных данных без изменений;
- Staging - временная зона для первичной обработки и верификации;
- Curated/Transformed - целевые таблицы фактов, измерений и семантического слоя.
Эти зоны поддерживают независимую эволюцию схем, упрощают аудит и восстанавливаемость процессов. В качестве инструментального набора для ELT часто используются dbt, Spark и вычислительные кластеры в облаках; для ETL - традиционные инструменты интеграции и ETL-платформы, которые предлагают графические конвейеры и встроенную логику трансформаций. В качестве примеров можно отметить dbt как популярный инструмент ELT в экосистеме open-source, а также классические ETL-решения, такие как Informatica или Microsoft SQL Server Integration Services, применяемые в более консервативных средах.
Влияние выбора на семантику витрины не ограничивается техникой преобразований. ELT-архитектура чаще ведет к более гибкому управлению семантикой за счёт возможности работы с большой схематической вариативностью в целевой базе и более тесной интеграции с семантическим слоем. ETL же обеспечивает раннюю нормализацию и более строгую схему на входе, что может ускорить внедрение в зрелые аналитические процессы, где бизнес-термины и кондомены уже устоялись.
Промежуточные архитектурные решения требуют продуманной организации данных: создание Raw, Staging и Curated зон, согласование версий схем и управление зависимостями между конвейерами. В современных платформах концепция «lakehouse» делает ELT особенно естественным, поскольку вычисления и хранение данных находятся на одной платформе, что упрощает управление схемами и семантикой.
В части реализации следует помнить о принципах идемпотентности и управляемости:
- операции загрузки должны быть идемпотентны: повторный запуск приводит к ожидаемому результату без дублирования данных;
- контроль качества на каждом этапе: валидаторы форматов, схем, уникальных ключей, целостности связей между фактами и измерениями;
- управление зависимостями между конвейерами и версионированием схем; схема изменений должна быть отражена в семантическом слое и потребительских моделях;
- мониторинг и алерты на задержку, ошибки и несоответствия.
На практике гибридный подход часто реализуется через сочетание:
- ETL-этапов для критичных бизнес-правил, которые требуют предсказуемости и качества на входе;
- ELT-этапов для масштабной трансформации и поддержки множества аналитических сценариев;
- зона Data Lake/Lakehouse как единая платформа для хранения суррогационных и подготовительных данных.
CDC и репликация: паттерны загрузки в реальном времени и близком к нему времени
Изменение данных в источниках становится движущей силой современных витрин: бизнес-операции требуют обновления витрины в минимально возможные сроки. Change Data Capture (CDC) обеспечивает полезную функциональность: регистрирует и распространяет изменения из исходных систем в целевые хранилища без повторной загрузки всего объема данных. Это особенно важно для поддержания согласованности между источниками и витриной, а также для минимизации задержки между событием в источнике и отражением в аналитике.
Существуют несколько подходов к CDC:
- лог-базированное CDC (log-based) - просматривается журнал изменений базы данных; обеспечивает минимальные накладные расходы и высокую производительность. Примеры: Debezium, интеграционные коннекторы для Kafka Connect; хорошо подходит для систем с поддержкой журналов транзакций.
- триггерное CDC (trigger-based) - триггеры записывают изменения в отдельные логи; обеспечивает точную детектируемость, но может вносить накладные расходы в нагрузку на базу.
- запросно-CDC (query-based) - периодическая сверка изменений через сравнение снимков; применяется чаще для запасных систем или в средах с ограниченными возможностями логов.
CDC имеет ряд преимуществ:
- минимизация латентности: данные почти в реальном времени становятся доступными для аналитики;
- экономия пропускной способности: передаются только изменения, а не полные копии данных;
- улучшенная аудируемость и факторная прозрачность изменений через данные лога, что критично для регуляторной и бизнес-аналитики.
Однако CDC требует тщательного подхода к обработке событий:
- идемпотентность и повторная обработка: конвейеры должны корректно обрабатывать повторные появления одних и тех же изменений;
- обработка конфликтов: обновления и удаления должны корректно применяться к существующим записям;
- сохранение линейности и цельности данных: поддержка временной версии записей и история изменений;
- управление деградацией схем: необходимость адаптивной схемной эволюции без потери совместимости.
Репликация как паттерн загрузки приносит латентность и устойчивость в сценарии, когда требуется синхронное или близко к синхронному копирование данных между источником и витриной. Репликационные механизмы могут быть на уровне базы данных (например, транзакционные репликации) или через инструменты гетерогенной интеграции (например, конфигурации потоков данных между источником и целевой системой). В сочетании с CDC репликация становится мощным механизмом формирования и поддержания согласованности витрины с минимальной задержкой.
Практические аспекты CDC и репликации:
- выбор подхода зависит от требований к латентности, объему изменений и характеру источников. Лог-базированное CDC чаще всего предпочтительно для крупных распределённых сред, где источники поддерживают журналы изменений, и есть потребность в непрерывной доставке изменений;
- архитектура обработки изменений должна обеспечивать идемпотентность и детерминированность: повторная подача одного и того же изменения не должна приводить к неконсистентности;
- линейность безопасности и аудита: каждое изменение должно иметь привязку к источнику и временной отметке, чтобы обеспечить трассируемость;
- интеграция с семантическим слоем: конвейеры CDC должны бесшовно поддерживать обновления в измерениях и фактах, учитывая историческую версию и научную применяемость.
Репликация и CDC становятся надёжной опорой для конвейеров данных, особенно когда речь идёт о сценариях Near Real-Time (NRT) или Continuous Analytics. В рамках конкретных инструментов та же логика может быть реализована через Debezium в связке с Apache Kafka, что обеспечивает устойчивую архитектуру для стриминг-платформ. В российском контексте можно упомянуть решения на базе отечественных ERP-систем и платформ, где CDC адаптировано под локальные требования, и примеры внедрения могут включать интеграцию с Яндекс DataSphere или аналогичными инфраструктурами.
Конвейеры данных: оркестрация, качество и управление семантикой
Конвейеры данных - это не просто последовательности загрузки. Это управляемые потоки трансформаций, которые объединяют источники, зоны обработки, семантику витрин и потребителей аналитики. В рамках ELT- или ETL-архитектур конвейеры отвечают за:
- оркестрацию этапов извлечения, трансформации и загрузки, синхронизацию зависимостей и управление версиями;
- обеспечение качества данных через валидацию форматов, проверку ограничений, контроль целостности и информирование о сбоях;
- мониторинг производительности, задержек и надежности, обеспечение устойчивости к сбоям и повторному выполнению;
- интеграцию с бизнес-слоем семантики: верификация соотношения фактов и измерений к конвенциям именования, соответствующим словарям и бизнес-правилам.
Современные конвейеры эволюционируют от простых задач ETL к более сложным сценариям стриминга и планирования. Гибридная архитектура с компонентами для оркестрации и обработки позволяет:
- распределять задачи по уровням: ingestion, staging, transformation, semantic enrichment и consumption;
- поддерживать адаптивное масштабирование: изолированные конвейеры для разных областей (финансы, продажи, складская логистика) с общей инфраструктурой;
- реализовать каналы распространения изменений: по подписке, по запросу и через события.
Ключевые принципы проектирования конвейеров:
- модульность и повторное использование: разделение логики на независимые сервисы или задачи;
- идемпотентность и повторяемость выполнения: повторный запуск не должен приводить к дубликатам;
- контрактность на уровне схем и бизнес-правил: явно зафиксированные форматы сообщений и схемы данных;
- наблюдаемость и трассируемость: детальные логи, метрики задержек и SLA;
- безопасность и доступ: ограничение доступа к данным с учётом чувствительности и соответствия требованиям.
Инструменты для оркестрации и конвейеров варьируются от открытых решений до облачных сервисов. В Open Source доминируют Apache Airflow и Dagster, которые позволяют описывать зависимые задачи через графы и обеспечить повторяемость выполнения. В реальном времени популярны Kafka и CDC-коннекторы, а для трансформаций - Spark и dbt. В российских условиях часто встречается сочетание облачных решений и локальных сервисов с интеграцией через виртуальные каналы и API между системами, что обеспечивает желаемый баланс между безопасностью и гибкостью.
Семантика витрины данных напрямую зависит от качества конвейеров. Факты и измерения должны поддерживать консистентность, конформированность и понятность для бизнес-пользователей. Семантический слой координируется через словари, онтологии и канонические модели, которые позволяют единообразно интерпретировать значения в разных источниках. В контексте паттернов CDC и репликации конвейеры должны грамотно обрабатывать версионирование схем, эволюцию бизнес-терминов и изменение мер, чтобы не разрушать аналитические сценарии.
Опора на современные практики и технологии обеспечивает устойчивость конвейеров:
- проектирование зон Data Lakehouse с золотой копией (curated layer) и миграцией в более зрелые витрины;
- использование семантического слоя для унификации терминов: конформированные измерения, фактовые таблицы и измерения времени;
- практики качества: набор тестов на превью-данных, валидация на этапе Curated, мониторинг схематических изменений, алерты на несоответствия;
- безопасность: шифрование на уровне хранения и передачи, управление правами доступа, аудит изменений.
Семантика витрины: факты, измерения и семантический уровень
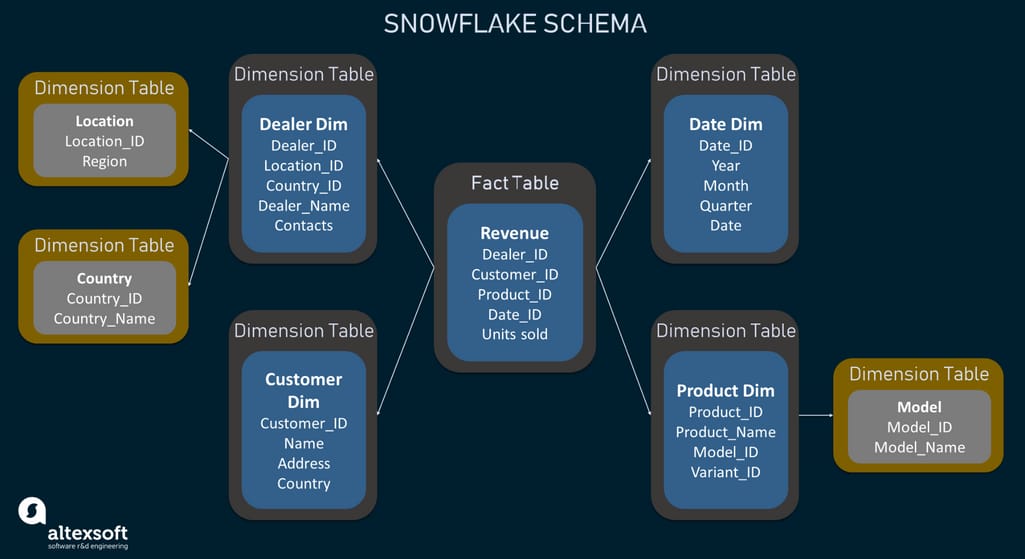
Целевая витрина объединяет две сущности: факты и измерения. Факты отражают количественные показатели бизнеса, часто с высокой степенью детализации и временной составляющей. Измерения (dimensions) описывают контекст, в котором вычисляются факты: время, валюта, разделы продукции, регионы и другие атрибуты. Конформированные измерения обеспечивают согласованность между различными источниками и областями аналитики. Семантический слой берет роль мостика между техническими моделями (таблицами в зоне Curated) и бизнес-потребителями: он складывает бизнес-термины, правила агрегации и контекст, понятный пользователю.
Ключевые принципы семантики витрины:
- единая бизнес-лексика: словари и глоссарии, которые синхронизируются с данными и аналитиками;
- конформированность измерений: одинаковые признаки и уровни агрегации в разных доменах;
- управляемые версии схем: прозрачная эволюция фактов и измерений без потери обратной совместимости;
- историчность и временные версии: поддержка slowly changing dimensions и версионности фактов;
- семантические слои: виртуальные представления, которые позволяют аналитикам работать с понятиями, не погружаясь в технические детали.
Промышленная реализация семантики требует тесной координации между командами данных и бизнес-пользователями. В рамках паттерна ELT семантика становится более гибкой за счёт возможности динамически менять трансформационные правила, не трогая исходные данные. С другой стороны, в ETL-подходах семантика может быть встроена на этапе загрузки, что обеспечивает более строгий контроль на входе, но ограничивает гибкость последующих изменений.
Роль технологий в семантике витрины не ограничивается схемами. Инструменты моделирования и управления словарями (BI-слой, semantic layer) обеспечивают двустороннюю связь между бизнес-терминами и данными. Примеры инструментов и подходов:
- конформированные_dims: единая временная размерность, согласование по измерениям между мульти-доменными витринами;
- канонические модели: унифицированные представления для консолидированной аналитики;
- словари и метаданные: поддержка бизнес-терминов, правил агрегации и трактовок.
В контексте CDC и конвейеров важно обеспечить согласованность семантики на протяжении всего жизненного цикла данных. Это означает:
- фиксацию контрактов данных: какие поля доступны, какие значения допустимы, какие версии схем и бизнес-правил применяются;
- мониторинг изменений семантики: уведомления о изменениях в терминах, структурных изменениях и новых версионированиях;
- тесты соответствия бизнес-правилам: проверки, что агрегации и иерархии точно отражают бизнес логику.
Архитектурные схемы и сценарии внедрения
Схема три зоны - Raw, Staging и Curated - остаётся базовой в большинстве подходов к витрине данных и обеспечивает ясность траектории данных. В рамках ETL и ELT эти зоны поддерживают границы ответственности между источником, процессами трансформации и потребителями аналитики. В современной архитектуре lakehouse эта концепция дополняется слоями semantic layer и data mart, которые служат мостами между техническими данными и бизнес-аналитикой.
Типичное внедрение включает:
- Raw (необработанные данные): хранится минимальная семантика, задача - регистрировать источник и временные характеристики;
- Staging (первичная обработка): проверка качества, нормализация и подготовка к финальным преобразованиям;
- Curated (факт/измерение/семантика): целевые таблицы фактов и измерений с конформированными представлениями и бизнес-правилами;
- Semantic/BI слой: представления и канонические модели, доступные бизнес-пользователям.
Эволюция данной архитектуры подчиняется принципу минимизации степени риска изменений на ранних этапах и максимальной гибкости на поздних. В реальном мире следует помнить о следующем:
- управление версиями и обратимость: версии схем, соответствие бизнес-правилам и возможность возврата к прежним версиям;
- эволюция схем без прерывания потребителей: поддержка нескольких версий и миграционных путей;
- масштабируемость: распределение нагрузки по конвейерам, параллельная обработка, контейнеризация и автоматическое масштабирование;
- безопасность и комплаенс: контроль доступа на уровне зон, аудит изменений и соответствие требованиям.
Инструменты и практики, которые чаще всего встречаются в современных проектах:
- ELT-платформы и инструменты моделирования: dbt как средство организации трансформаций в рамках ELT-подхода и управления семантикой;
- конвейеры и оркестрация: Apache Airflow, Dagster, Prefect - для определения зависимостей и мониторинга;
- стриминговые технологии: Apache Kafka, потоковые коннекторы, Debezium для CDC, которые обеспечивают доставку изменений в реальном времени;
- данные в российском контексте: Яндекс DataSphere и сопутствующие решения, адаптированные под локальные требования к безопасности, хранению и соблюдению регуляторных норм.
Сложность архитектуры требует согласованной методологии внедрения. Рекомендованные практики:
- определение бизнес-словаря и контрактов данных на старте проекта;
- выбор стратегии загрузки (ETL, ELT или гибрид) в зависимости от типа данных, задержек и доступной инфраструктуры;
- проектирование конвейеров с учётом возможной эволюции источников и бизнес-правил;
- обеспечение качества данных на каждом уровне архитектуры;
- формирование лицензионно-ответственных ролей и процессов управления изменениями.
Key takeaways
- Выбор между ETL и ELT зависит от объема данных, требуемой задержки и возможностей целевой платформы; современные тенденции склоняют к ELT в lakehouse-архитектурах, но гибридные подходы часто дают наилучшее сочетание контроля и масштабируемости.
- CDC и репликация являются ключевыми паттернами для поддержания близкой к реальному времени витрины; лог-базированное CDC обеспечивает латентность и масштабируемость, в то же время требует продуманной обработки повторных изменений.
- Конвейеры данных служат связующим звеном между источниками и потребителями; они требуют модульности, идемпотентности, контрактной схемы и устойчивости к изменениям.
- Семантика витрины - ядро аналитики: факты, измерения и конформированные измерения в сочетании с семантическим слоем обеспечивают единообразие и понятность бизнес-пользователям.
- Архитектура должна быть эволюционной и управляемой: зоны Raw/Staging/Curated, контроль версий схем, мониторинг качества и безопасность доступа.
- В качестве инструментов стоит рассмотреть dbt для ELT-трансформаций, Apache Airflow или Dagster для оркестрации, Debezium и Kafka для CDC и стриминга, а также учитывать российские решения типа Яндекс DataSphere там, где это релевантно требованиям рынка.
- Практические решения требуют активного взаимодействия между командами данных и бизнес-пользователями: общие словари, правила агрегации, канонические модели и чётко прописанные контракты данных упрощают внедрение и сопровождают эволюцию витрины.
FAQ
- Что такое ETL и ELT и чем они различаются?
ETL означает извлечение данных из источников, трансформацию во временном промежуточном слое и загрузку в целевую систему. ELT переносит этап трансформации в целевую платформу, загружая данные «как есть» и выполняя трансформацию непосредственно на целевой системе. Разница сложна и зависит от характеристик инфраструктуры: ELT чаще подходит для lakehouse и облачных платформ с мощными вычислениями, тогда как ETL - когда источник ограничен вычислительными ресурсами или требуется строгий контроль на входе.
- В каких случаях предпочтителен CDC?
CDC особенно полезно, когда необходима высокая актуальность данных и минимальная задержка между событием в источнике и отражением в витрине. Лог-базированное CDC обеспечивает наименьшие задержки и позднее влияние на производительность источников. Однако требует строгого управления последовательностью изменений и поддержки трансформаций событий.
- Что такое конформированные измерения и зачем они нужны?
Конформированные измерения - это единые атрибуты измерений (например, время, продукт, регион), применяемые во всех доменах витрины, что обеспечивает согласованные агрегации и сопоставление данных из разных источников. Это критично для целостной аналитики, совместной отчётности и качественной семантики витрины.
- Как обеспечить идемпотентность конвейеров?
Идемпотентность достигается через:
- уникальные ключи операций и idempotent-обработку изменений;
- детерминированные обновления и сохранение версий;
- контроль повторных событий и защиту от дублирования записей;
- тестирование повторных запусков конвейера в рамках регламентных процессов.
5. Какие преимущества даёт использование lakehouse-подхода?
Lakehouse сочетает хранение больших массивов данных и возможность выполнять трансформации непосредственно на той же платформе. Это снижает задержку, упрощает схему эволюции и улучшает управляемость семантики за счет единой модели данных и унифицированного слоя для анализа.
6. Какие средства мониторинга стоит внедрить в конвейеры?
Необходимо:
- отслеживание задержек между этапами и SLA по каждому конвейеру;
- мониторинг ошибок, повторные попытки и показатели качества;
- трассировка lineage: прозрачная связь между исходными источниками и конечной семантикой;
- алерты и уведомления для оперативной реакции на отклонения.
7. Какие инструменты наиболее востребованы в практике?
Open-source: dbt для ELT-трансформаций, Apache Airflow или Dagster для оркестрации, Debezium в связке с Kafka для CDC. Российские примеры: Яндекс DataSphere и схожие инфраструктурные решения, адаптированные под локальные требования к безопасности и регуляциям.
8. Какой подход выбрать для миграции существующей витрины?
Начать с анализа текущих процессов и требований: оценить логику трансформаций, частоту обновления, требования к качеству. Постепенно внедрять гибридный подход: перенос части трансформаций на ELT-платформу, сохранение контрольных точек кэша и staging-зон, обеспечить версионирование схем и миграционные планы без простоя.
9. Как интегрировать семантику в процесс загрузки?
Определить бизнес-термины и канонические модели на старте, зафиксировать контракты данных и esquema evolution. Внедрить Semantic Layer: виртуальные представления и канонические наборы измерений, которые облегчают доступ аналитикам и сокращают расхождения между подразделениями.
10. Какие риски наиболее критичны при внедрении паттернов CDC и конвейеров?
Ключевые риски: некорректная обработка повторных изменений, нарушение целостности данных при конфликтных обновлениях, задержки в стриминге и проблемы масштабирования. Управление ими требует продуманной архитектуры, строгих контрактов данных, качественных тестов и прозрачного мониторинга.
Эта глава представляет собой интегрированное видение, где архитектура ETL/ELT, CDC, репликация и конвейеры работают в синергии для поддержания эффективной и управляемой витрины данных. В условиях цифровой трансформации и растущей потребности в оперативной аналитике важно сочетать строгую методологию с гибкими технологическими решениями, чтобы факты и измерения поддерживали бизнес-решения на каждом уровне организации.


