

Масштабирование и зрелость витрины: путь к data mesh и multi-cloud
Витрина данных - это не только хранилище фактов и измерений, но и развивающаяся платформа для предоставления данных как продукта. По мере роста организаций растут сложность и требования к управлению данными: скорость появления новых источников, требования к качеству, семантике и совместному использованию данных между подразделениями. Движущие силы масштабирования - федеративное владение данными, контрактные границы между доменами и способность работать в условиях multiple cloud. В этой главе рассматривается путь зрелости витрины к архитектурной парадигме data mesh и к технологическим реалиям multi-cloud: как выстроить ответственность, как обеспечить совместимость и как достичь управляемости и экономичности при больших масштабах.
Краткое введение
-
Витрина данных перестает быть монолитной тахографией процессов: она становится Франшизой данных, где каждый домен управляет своим набором продуктов данных, соблюдает общие контракты и через каталоги и семантику поддерживает взаимную совместимость.
-
Реализация в условиях data mesh и multi-cloud требует перехода от централизованного подхода к федеративной организации работы, где платформа выступает как инженерная база, а домены отвечают за качество и жизненный цикл своих данных.
-
Эффективная реализация сопряжена с управлением контрактами, метаданными, семантикой и observability: без ясности контрактов и единых понятий метаданных масштабирование превращается в хаос, который оборачивается избыточными затратами и снижением доверия к витрине.
-
Ключевая мысль: масштабирование достигается не только техническими средствами, но и архитектурной дисциплиной, организационными изменениями и управлением данными как продуктом.
Краткое содержание главы
- Организационная зрелость и архитектура витрины в рамках data mesh: принципы федеративного владения, Data Product, контракт на данные, семантика и управляемость.
- Архитектура и паттерны интеграции в условиях multi-cloud: федеративная платформа, каталоги метаданных, семантический слой, обработка потоков и запросов через разные облака.
- Инженерная реализация и практические маршруты: внедрение, метрики зрелости, observability, безопасность и примеры контрактов данных.
Стратегический контекст: зрелость витрины и вызовы масштаба
Масштабирование витрины данных начинается не с «кода» или «площадки», а с изменения парадигмы владения и ответственности. В условиях data mesh ответственность за данные распределена по доменам: каждый домен отвечает за продукт данных, четко определяет контракт, качество и доступность. Переход от монолитной витрины к федеративной архитектуре требует нескольких важных шагов.
-
Контракты и семантика: для каждого домена формируются спецификации контрактов, включающие набор доступных таблиц, схемы, качество данных и SLA на обновление. Контракты позволяют автономным командам безопасно взаимодействовать через общую платформу.
-
Data products как единицы владения: данные представляются как продукт, который имеет владельца, цели, пользователя и метрики. Это меняет роль платформы: она больше не хранитель всех данных, а платформа поддержки продукта в рамках согласованных контрактов.
-
Метаданны и семантика: единая семантика (именование измерений, единицы измерения, правила агрегации) должна быть поддержана через каталог метаданных и управляемый словарь терминов, чтобы данные из разных доменов можно было корректно сочетать.
-
Observability и качество: на каждом уровне внедряется мониторинг качества, трассировка данных и аудит изменений. Без видимости процессов трудно поддерживать согласованность и доверие к витрине.
-
Экономика и стоимость: в условиях multi-cloud стоимость обработки и передачи данных существенно выше; необходимо внедрять технику «cost governance» и оптимизации хранения/запросов, чтобы масштабирование не приводило к значительным перерасходам.
-
Этапы зрелости витрины (упрощенная модель):
- Foundational: централизованный набор источников + базовый каталог и мониторинг.
- Emergent: введение доменных владений, первых Data Products, контрактов и семантики.
- Defined: формализованные процессы развёртывания продуктов, расширение каталога, расширенная observability.
- Managed: устойчивые практики качества, автоматизация жизненного цикла, управляемость затрат.
- Optimized: непрерывная эволюция архитектуры, предиктивная аналитика качества, самовосстанавливающиеся конвейеры.
-
Вызовы масштаба: синхронность обновлений, согласование семантики между доменами, управление доступами в разных облаках, согласование политики безопасности и соответствие требованиям регуляторов.
-
Практический вывод: рост витрины до уровня data mesh требует интегрированного подхода, который объединяет архитектуру, продукты данных и управляемость. Без этого масштабирование становится дорожной картой к хаосу.
-
Рекомендации по старту: сфокусируйтесь на формализации контрактов и создании первых Data Products, затем постепенно расширяйте каталог и внедряйте observability на уровне домена и платформы.
-
В примерах open-source решений упоминнем такие технологии, как Apache Iceberg для управляемых таблиц и Apache Flink для обработки потоков, которые позволяют строить эффективные конвейеры в многоклаудной среде.
Метрики зрелости витрины
- Временная задержка обновления данных по продукту.
- Уровень соответствия контракта данным (математика соответствий).
- Доля доменов, имеющих свои Data Products и каталог.
- Скорость добавления новых источников и обновления схем.
- Показатели качества данных (процент пропусков, корреляции, точность и полнота).
- Метрики observability: покрытие мониторинга, доступность сервисов витрины, время восстановления после инцидентов.
Роль Data Product и контракты данных
- Data Product несет ответственность за предоставление набора данных: описание, цель использования, требования к качеству, SLA, версия контракта и политика доступа.
- Контракты данных требуют четкого формализма: какие поля доступны, форматы, единицы измерений, методики агрегации, уровень исправления ошибок.
- Контракты служат для снижения неопределенности между доменами и обеспечивают устойчивый обмен данными в условиях data mesh.
Роль семантики и каталога
- Семантика обеспечивает единое понимание измерений и концепций. Каталог метаданных становится «маяком» для аналитиков и инженеров данных, уменьшая риск неправильного использования данных.
- Включение словаря терминов и связей между концепциями (например, CUSTOMER_ID, ORDER_DATE, CURRENCY) в каталог повышает совместимость между доменами.
пример контракта данных (yaml)

data_product: sales_transactions
domain: sales
owner: Sales Analytics Team
 SLA: 24h
schema:
  - **name**: transaction_id
    type: string
  - **name**: customer_id
    type: string
  - **name**: amount
    type: decimal
  - **name**: currency
    type: string
  - **name**: transaction_date
    type: timestamp
quality:
  completeness: 98.5
  accuracy: 99.2
access:
  - **role**: data_analyst
    read: true
  - **role**: data_scientist
    read: true
version: 1.0
Архитектура витрины в эру data mesh
Архитектура витрины в рамках data mesh ориентирована на децентрализованное владение данными доменами и унифицированную платформу поддержки. В таком контексте платформа исполняет роль инфраструктуры и сервисов, предоставляющих возможности совместного использования данных, автоматизацию конвейеров и обеспечение согласованности семантики и безопасности.
-
Домены как владелицы: каждый домен управляет своим набором Data Products, инфраструктурой и качеством данных. Это снижает зависимости между командами и ускоряет развитие.
-
Data Platform как сервис: платформа обеспечивает общие сервисы: каталог и метаданные, управление контрактами, безопасность и идентификацию, мониторинг, обработку потоков, доступ к данным и т.д.
-
Контракты и семантика как первооснова взаимодействия: единая семантика и контрактная архитектура позволяют доменам безопасно и быстро интегрироваться.
-
Архитектурные паттерны:
- Федеративная платформа: платформа предоставляет инфраструктуру, но данные остаются под владением доменов.
- Self-serve data platform: команды используют готовые сервисы для публикации и использования Data Products.
- Семантический слой: слой, который объединяет термины и измерения из разных доменов, обеспечивая единое понимание данных.
- Каталог метаданных: единая точка доступа к описаниям источников, схемам, качеству данных и контрактам.
- Оркестрация и обработка данных: гибрид потоковой и пакетной обработки, поддерживающий межоблачные конвейеры.
-
Инструменты и примеры:
- Apache Iceberg: управляемые таблицы для масштабируемого хранения и версионирования; работает как единая абстракция под разные источники.
- Apache Flink: обработка потоков и микро-пакетная обработка для реал-тайм конвейеров и совместной обработки в многоклаудной среде.
-
Архитектурная модель в виде слоистой схемы:
- Источники данных (домены) - сбор и потребление.
- Data Products - описание и доступ к данным.
- Каталог и семантика - единый словарь и определения.
- Платформа и сервисы - безопасность, доступ, оркестрация, качество.
- Клиенты и аналитика - потребители данных.
-
Преимущества:
- Ускоренная доставка данных: домены отвечают за качество и доступность своих продуктов.
- Масштабируемость: платформа поддерживает клиенты в разрезе облаков и регионов.
- Управляемость: централизованные сервисы для мониторинга, контроля доступа и политики.
-
Риск-менеджмент:
- Риск несогласованной семантики: решения - единый словарь и согласованные контракты.
- Риск задержек обновления контрактов: автоматизация их жизненного цикла.
- Риск утечки данных и нарушения регуляторных требований: строгие политики доступа и аудита.
Архитектурные слои и взаимодействия
- Контекст уровня домена: управление Data Products и SLA
- Контекст уровня платформы: координация, безопасность, каталоги, политики
- Контекст уровня потребителей: запросы, аналитика, данные как продукт
Интеграционные паттерны
- Federation через слой семантики и контрактов
- Data virtualization и кросс-облачная агрегация
- Пакетная и потоковая обработка в гибридной среде
- Обеспечение качественных даннных через магистральные конвейеры
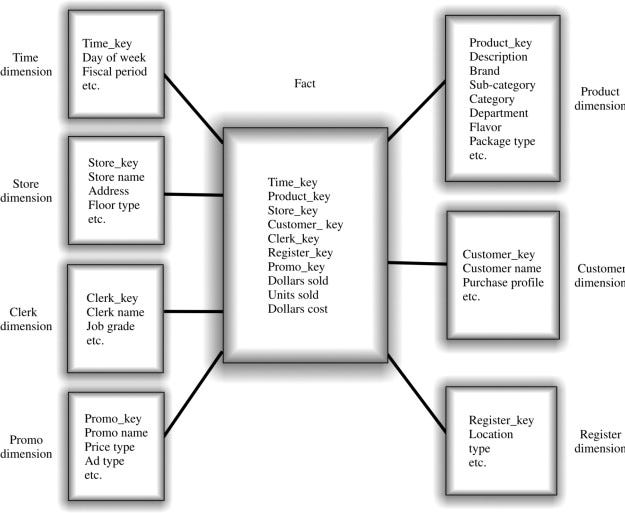
Мультиоблачная инфраструктура и паттерны интеграции
Multi-cloud подходит для снижения vendor lock-in, повышения устойчивости и обеспечения региональных требований. Однако он предъявляет требования к управлению данными и совместному потреблению: задержки, стоимость передачи и различия в сервисах.
-
Паттерны кросс-облачной интеграции:
- Федеративная обработка запросов: выполнение запросов и агрегаций через локальные источники, а не перемещение больших объемов данных.
- Репликации и синхронизация: выбор политик репликации в зависимости от latency и регуляторных ограничений.
- Виртуализация данных: единый интерфейс к данным, который скрывает физическое размещение источников.
- Порталы и API-шлюзы: унифицированная точка доступа к Data Products в разных облаках.
-
Безопасность и соответствие:
- Identity and Access Management (IAM) кросс-облачного уровня
- Карантин и шифрование в покое и в передаче
- Политики кросс-доменных доступов и аудит действий
-
Производительность и стоимость:
- Расчеты стоимости запросов и передачи данных
- Выбор стратегий кеширования и предиктивной оптимизации
- Мониторинг латентности и ошибок в каждом облаке
-
Инструменты и ограничения:
- Apache Iceberg и Apache Flink поддерживают межоблачные конвейеры, но их настройка требует аккуратной координации между доменами и платформой.
- Выбор облачных инструментов для каталога, мониторинга и управления доступом должен быть совместимым и устойчивым к изменениям.
Типовые сценарии кросс-облачной работы
- Сценарий 1: источник в облаке A, аналитика в облаке B - через federated query и semantic layer.
- Сценарий 2: репликация критичных Data Products в нескольких регионах/облаках для снижения задержек.
- Сценарий 3: виртуальный слой данных, обеспечивающий единый доступ к данным через слой абстракции.
Ключевые архитектурные решения
- Нужна единая семантика и контракты между доменами, чтобы обеспечить совместимость в условиях разных облаков.
- Внедрить observability на уровне конвейеров и услуг витрины, чтобы выявлять точки задержек и отклонения в SLA.
- Применять policy-as-code для управления безопасностью и доступом в разных средах.
Управление качеством, семантикой и жизненным циклом витрины
Ключ к устойчивости витрины - управляемость качеством данных, единая семантика и формальные жизненные циклы. Управление данными как продуктом требует системности: от определения Data Product до его версии и устной поддержки.
-
Качество данных: метрики полноты, точности, непрерывность обновления, устойчивость к изменению источников.
-
Семантика и каталог: единая система терм Erfahrung - словарь, кодируемые определения измерений и связь между концепциями.
-
Жизненный цикл Data Product: создание, публикация, обновление, версия, deprecation; политика доступа и правки.
-
Наблюдаемость: сбор и анализ метрик качества, мониторинг конвейеров и SLA; автоматические уведомления и автоматические реакции на инциденты.
-
Методы обеспечения качества:
- Внедрение тестирования данных на уровне конвейеров
- Верификация контрактов и автоматическое сравнение версий
- Мониторинг значимых изменений в схемах источников
-
Инструменты и подходы:
- Каталоги метаданных как единая точка доступа
- Semantic Layer для унификации и согласования определений
- Observability и трассировка для выявления узких мест
-
Пример жизненного цикла:
- Инициирование нового Data Product
- Определение контракта и семантики
- Публикация и доступ пользователей
- Мониторинг и уведомления об изменениях
- Версионирование и эволюция контракта
- Устаревание и де-презентация
yaml data_product: customer_profile domain: marketing owner: Marketing Analytics SLA: 12h schema: - **name**: customer_id type: string - **name**: profile_version type: int - **name**: segments type: arrayquality: completeness: 99.0 accuracy: 98.7 access: - **role**: marketing_analyst read: true - **role**: data_scientist read: true version: 2.1 contracts: - **contract_id**: c-001 description: "Semantics for customer_profile fields" Семантика и строгие контракты
-
В рамках витрины важно исключить двусмысленности: одинаковые названия полей и мер должны иметь единое определение во всех доменах.
-
Семантика должна быть поддерживаема через общий словарь и связь с Data Products.
-
Контракты данных должны быть версионированы и доступны для потребителей.
Наблюдаемость и безопасность
- Наблюдаемость по каждому Data Product обеспечивает прозрачность работы и своевременный отклик на происшествия.
- Безопасность и соответствие должны быть встроены в контракт: кто имеет доступ, на каких условиях, какие данные могут быть экспортированы.
Практические сценарии внедрения и эволюции продукта
Этапы перехода к зрелой витрине требуют последовательных и четко выверенных шагов. Ниже приведены типовые маршруты внедрения и их практическая реализация.
-
Этап 1: Формирование базовых Data Products и контракты
- Определение доменов и первых Data Products
- Разработка контрактов и семантики
- Внедрение каталога и базовых сервисов безопасности
-
Этап 2: Расширение и стандартизация
- Расширение набора Data Products
- Стандартизация поведения конвейеров
- Расширение observability и мониторинга
-
Этап 3: Федеративная платформа и мультиоблачность
- Внедрение federation паттернов
- Оптимизация межоблачной передачи и хранения
- Поддержка региональных политик и регуляторных требований
-
Этап 4: Управление стоимостью и устойчивостью
- Контроль затрат в условиях multi-cloud
- Автоматизация масштабирования и оптимизация конвейеров
- Продвинутые политики доступа и безопасность
-
Этап 5: Опережающее управление и инновации
- Прогнозирование потребностей бизнеса
- Инициативы по улучшению качества и семантики
- Расширение за пределы текущих доменов
Пример дорожной карты внедрения
- Квартал 1-2: построение инфраструктуры каталога, выбор первых Data Products, определение контрактов
- Квартал 3-4: внедрение федеративной платформы, расширение доменов
- Квартал 5-6: оптимизация затрат, расширение мультиоблачности, улучшение качества
- Квартал 7+: дальнейшее развитие Data Products, совершенствование семантики и автоматизации
Key takeaways
- Масштабирование витрины данных требует сочетания архитектуры, процессов и культуры: федеративная структура и управление Data Products являются основой.
- Data mesh внедряет децентрализованное владение данными: домены отвечают за контракты, качество и жизненный цикл своих Data Products.
- Семантика и каталог метаданных нужен на уровне всей организации для обеспечения единообразия и корректной интеграции между доменами.
- Multi-cloud паттерны требуют контроля затрат, кросс-облачной согласованности и единых политик безопасности.
- Архитектура должна включать семантический слой, каталоги, observability и контрактно-ориентированное взаимодействие между доменами и платформой.
- Применение инструментов, таких как Apache Iceberg и Apache Flink, позволяет реализовать масштабируемые конвейеры и гибкую обработку данных в условиях многоклаудности.
- Этапы зрелости витрины: от базовой централизации до зрелой федеративной модели с устойчивой мультиоблачной инфраструктурой и управляемыми Data Products.
FAQ
- Что такое data mesh и зачем он нужен витрине данных?
- Data mesh - это архитектурная парадигма, в которой владение данными распределено по доменам, а платформа обеспечивает инфраструктуру и общие сервисы. Основная идея - повысить скорость доставки данных и снизить зависимости между командами, сохранив единые принципы качества, семантики и безопасности.
- Какие основные элементы должны быть в контракте данных?
- Контракт данных должен содержать: описание Data Product, владелец, SLA на обновления, схема и типы полей, требования к качеству, политики доступа, версия контракта и ссылки на семантику. Контракты обеспечивают согласованность и прозрачность для потребителей.
- Как обеспечить единую семантику в условиях разных доменов и облаков?
- Создайте единый словарь терминов и связанный с ним семантический слой. Каталог метаданных должен содержать определения измерений, единицы, форматы и правила агрегаций. Регулярно согласуйте обновления между доменами и автоматически применяйте версии семантики в клиентах витрины.
- Какие паттерны следует применять в мультиоблачной среде для минимизации задержек?
- Рассматривайте федеративный подход к обработке запросов, кросс-облачную агрегацию через семантику и кэширование часто запрашиваемых Data Products. Важно выбирать локальные источники для критических операций и использовать виртуальный слой для унифицированного доступа.
- Какой уровень зрелости витрины стоит ожидать на старте проекта?
- Начните с Foundational уровня: централизованный каталог, базовые Data Products и мониторинг. Затем переходите к Emergent и Defined, постепенно достигая Managed и Optimized по мере роста количества доменов и сложности операций.
- Какие риски чаще всего встречаются при переходе к data mesh?
- Риск несогласованной семантики, риск задержек обновления контрактов, риск ненадлежащего управления доступами между облаками и риск перерасхода бюджета из-за дублирования данных и неэффективных конвейеров. Эффективный контрактный подход, единая семантика и observability снижают эти риски.
- Какие open-source инструменты подходят для реализации витрины в multi-cloud?
- Apache Iceberg обеспечивает управляемые таблицы и версионирование; Apache Flink обеспечивает потоковую и пакетную обработку данных, включая возможности кросс-облачной интеграции. Эти технологии позволяют строить масштабируемые конвейеры и управлять данными как продуктом.
- Как обеспечить безопасность и соответствие при работе в multi-cloud?
- Внедрите одинаковые политики доступа, управляемые через IAM и политики доступа на уровне Data Products, применяйте криптографическую защиту и аудит действий. Обеспечьте соответствие требованиям регуляторов посредством централизованных механизмов контроля и журналирования.
- Что считать успехом внедрения витрины в условиях data mesh?
- Успех - это возможность автономным доменам быстро публиковать Data Products, единая семантика и качественные метрики, предсказуемое выполнение запросов и поддерживаемая экономика. Важно, чтобы платформа позволяла масштабировать количество доменов без потери управляемости и скорости доставки данных.
- Какие шаги предпринять для быстрой апробации концепции витрины?
- Определите 2-3 домена в качестве пилотной зоны, сформируйте первые Data Products и контракты, внедрите каталог и семантику, настройте observability и базовые политики безопасности. После этого расширяйте круг доменов и Data Products, постепенно переходя к federated архитектуре и мультиоблачной поддержке.
- Конечная цель главы - дать практическое руководство по построению масштабируемой витрины в условиях data mesh и multi-cloud: как выстроить организацию владения данными, как реализовать архитектуру и как выстроить жизненный цикл Data Products, чтобы витрина стала ценным активом бизнеса и поддерживала цифровую трансформацию.


