

Формулы расчета версий, текущих записей и истории
Медленно изменяющиеся измерения (SCD) - ключевой инструмент управления историей в витринах данных. Цель главы - разобрать формулы и моделирования версий, определить, как отделить текущие записи от истории, и показать практические алгоритмы обновления на уровне архитектуры и ETL. В условиях современных архитектур данные обновляются в реальном времени или пакетами; задача состоит в том, чтобы сохранять целостную историю изменений при минимальных расходах на хранение и поддержке консистентности связанных фактов и измерений.
SCD требуют согласованного подхода к идентификации изменений, версионированию и управлению эффективными периодами. В этой главе рассматриваются концептуальные основы, формулировки версий, схемы хранения текущих записей и истории, а также практические алгоритмы обновления и интеграции с витринами данных и системами источников.
- Архитектура и схемы SCD: типы изменений, surrogate keys и временные интервалы.
- Формулы версий и текущих записей: как формально задаются версии, effective_from и end_date.
- Модели хранения истории: что хранить в текущей записи и в исторических версиях.
- Алгоритмы обновления и интеграции: детекция изменений, режимы загрузки и сценарии миграций.
- Практические примеры реализации: SQL-решения, паттерны загрузки и управляемые конвейеры.
Концепции и архитектура SCD
В витринах данных SCD различают как хранение текущих значений фактов, так и сохранение их истории. Это позволяет аналитикам видеть не только «как есть», но и как было в разные периоды времени, что особенно важно для анализа тенденций, регулирования и аудита. Архитектура SCD строится вокруг трех базовых элементов: идентификаторов, версий и диапазонов валидности.
- Идентификаторы и surrogate keys. В качестве уникального идентификатора версии в dimensão чаще используют surrogate key (SK). Он отделяет естественный ключ (natural key) от внутренних изменений структуры. SK обеспечивает линейную однозначность в хранилище и независимость от изменений бизнес-ключей.
- Временные интервалы. Валидность записи задается двумя параметрами: EffectiveDate (или FromDate) и EndDate (или ToDate). В некоторых проектах применяются флаг CurrentFlag, но он менее надёжен для точной фильтрации исторических периодов, чем пары дат.
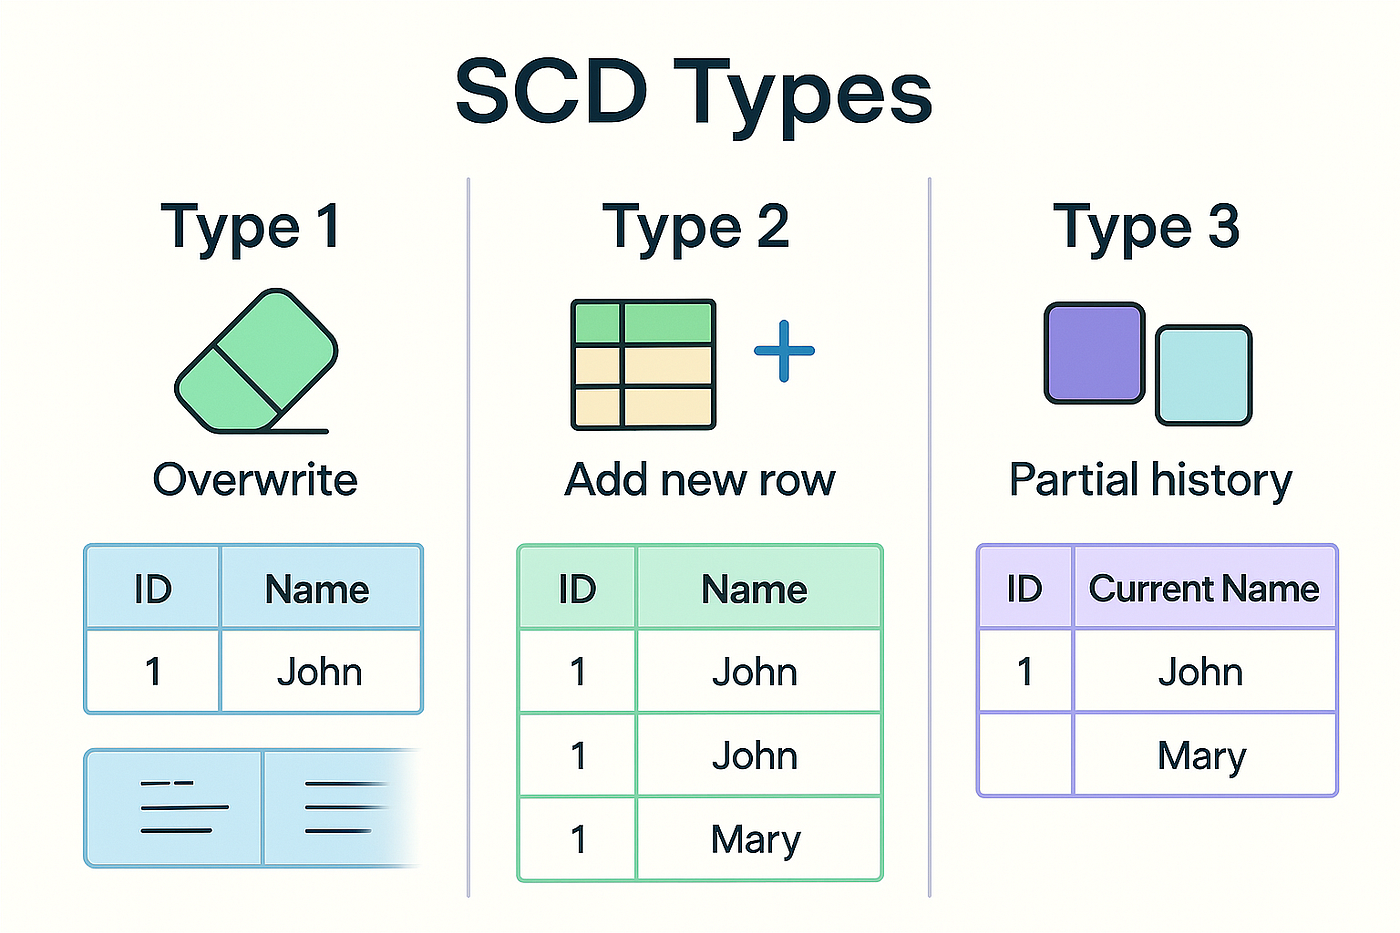
- Типы изменений и модели SCD. Наиболее распространены типы 1, 2 и 3, с возможными гибридами и четвертым типом (SCD 4) для специальных сценариев. Тип 1 обновляет запись без сохранения истории; Тип 2 добавляет новую версию и закрывает старую; Тип 3 хранит частично изменившееся значение в дополнительном столбце; Типы 2/3 часто дополняются логикой управляемого архивирования и временными интервалами.
Поскольку задача главы - формулы и расчеты версий, далее будет сфокусировано на конкретных моделях и их реализации через сквозные паттерны.
Формулы версий и текущих записей
Версии записей в SCD должны быть воспроизводимы и воспроизводимо сопоставляемы между системами. Формально можно определить набор элементов, которые участвуют в расчете версии и области валидности.
- Версия записи V. Основной параметр версии может быть числом или хешем комбинации естественного ключа, значений атрибутов и моментальной временной отметки. В простейшем виде версия может быть выражена как:
V = VersionCounter, где VersionCounter увеличивается при каждом изменении набора атрибутов не зависящих от контекста факторов. - Эффективная дата и конец действия. Для каждой версии задаются:
- EffectiveDate (FromDate) - дата начала валидности версии.
- EndDate (ToDate) - дата окончания валидности версии, либо NULL/∞, если версия текущая.
- Текущая версия. Версия считается текущей, если EndDate не задан или CurrentFlag = TRUE. В некоторых реализациях применяется оба признака: EndDate IS NULL и CurrentFlag = 1.
- Хэш изменений. В некоторых сценариях для ускорения детекции изменений применяют хеш набора значений атрибутов бизнес-логики: HashAttr = Hash(Name, Address, Phone, Email, …). Сравнение HashAttr между лоадами позволяет зафиксировать факт изменения без сравнения всех полей.
- Нагрузочная формула для типа 2. При изменении атрибутов, влияющих на срези витрины, создается новая версия, а предыдущая версия помечается как завершенная. Простой вариант формулы:
Если t. атрибуты(t) ≠ s.атрибуты(s) тогда
EndDate(t) = s.LoadDate - 1
CurrentFlag(t) = FALSE
Вставить новую запись с EffectiveDate = s.LoadDate и EndDate = NULL, CurrentFlag = TRUEгде t - текущая версия вари; s - запись staging.
- Формула сопоставления ключей. В некоторых реализациях учитываются не только естественные ключи, но и временные версии. Пусть NK - естественный ключ бизнес-объекта, а SK - суррогатный ключ. Окончательная корреляция между NK и SK может быть выражена через правило: NK → SK по состоянию на сегодняшний момент. При отсутствии соответствия создается новая версия.
Важно помнить, что формулы должны быть детерминированными и воспроизводимыми независимо от режима загрузки (пакетный или streaming). В конкретной реализации часто применяются два ядра: детектор изменений на этапе трансформации и механизм обновления на этапе загрузки.
-
Формула для выбора текущих записей. В витрине данных текущие записи обычно выбирают как те версии, где EndDate является NULL и CurrentFlag = TRUE. В реальной схеме могут применяться дополнительные условия доменной логики, например фильтры по сегментам, датам обновления и признакам актуальности.
-
Формула для расчета хеша нового значения. Если нужно быстро определить факт изменения, можно вычислять хеш набора полей обновляемой записи:
HashNew = Hash(Name, Address, Email, Phone, Segment, Status)
Сравнивать HashNew с HashAttr у существующей версии. При несовпадении считаем изменение и применяем соответствующую схему обновления.
Приведём пример абстрактной схемы версий и формул без привязки к конкретной СУБД, чтобы сохранить общность концепций.
-
Выбор версии:
- При загрузке новых данных из источника, если NK не найден в dimension, создаётся новая запись с новым SK, EffectiveDate = LoadDate, EndDate = NULL, CurrentFlag = TRUE, HashAttr = HashNew.
- Если NK найден и HashAttr отличается от текущей версии, выполняется обновление как для типа 2: EndDate текущей версии устанавливается на LoadDate - 1; создаётся новая версия той же NK, с теми же атрибутами за исключением изменённых, EffectiveDate = LoadDate, EndDate = NULL, CurrentFlag = TRUE.
- Если NK найден и HashAttr совпал с текущей версией, ничего не делается (нет изменений).
-
Формула обобщенного паттерна. Пусть D - размерная таблица, в которой каждая запись имеет NK, SK, EffectiveDate, EndDate, CurrentFlag, HashAttr и набор бизнес-атрибутов. На входе staging-данные S с теми же полями, возможно без SK. Алгоритм:
- Для каждой строки s из S найдите существующую актуальную версию d.t в D по NK, где EndDate IS NULL и CurrentFlag = TRUE.
- Если совпадение по HashAttr - пропустить (нет изменений).
- Если совпадения по NK отсутствуют - вставить новую запись (SK = новый суррогатный ключ, EffectiveDate = LoadDate, EndDate = NULL, CurrentFlag = TRUE, HashAttr = HashNew).
- Если совпадение по NK найдено и HashAttr отличается - обновить старую запись: EndDate = LoadDate - 1, CurrentFlag = FALSE; вставить новую запись с теми же значениями атрибутов, но с EffectiveDate = LoadDate и EndDate = NULL, CurrentFlag = TRUE, HashAttr = HashNew.
Эти формулы задают базовые принципы моделирования и могут легко расширяться для поддержания версии по нескольким целям, например дифференциации по источникам или пользователям, которые инициировали изменения.
Текущие записи и история: схемы и реализации
Управление текущими записями и историей требует внимательного подхода к тому, как данные хранятся и как к ним обращаются аналитики. В практических схемах часто применяются две парадигмы: хранение текущих записей как основного слоя (для быстрого доступа к актуальным данным) и хранение полной истории в отдельных версиях. В реальном мире это может быть реализовано двумя способами: «одна таблица» (SCD Type 2 в одной таблице) или «разделение таблиц» (одна таблица для текущих записей и отдельная для истории).
-
Текущая версия как основная точка доступа. В витрине данные похоже на «единую живую» таблицу с записанной текущей версией для каждого бизнес-ключа. Но история сохранена в отдельных версиях той же таблицы через поля EffectiveDate и EndDate, что позволяет выполнить запрос текущего набора и истории через фильтры по датам.
-
История в виде отдельных версий. В некоторых реализациях история хранится в отдельной версии каждой записи в рамках одной таблицы; или же используют отдельную архивную таблицу. Это предоставляет более явные разделения между данными текущего состояния и историей.
-
Привязка к фактам и измерениям. Взвешенная архитектура SCD требует координации между измерениями и фактами, особенно когда изменяется бизнес-ключ или атрибут, влияющий на агрегацию. Например, изменение названия продукта в измерении должно отражаться в связях фактов через долговременную ссылку на текущую версию, чтобы сохранить корректность на временном диапазоне.
-
Вариант со статусом CurrentFlag. В некоторых реализациях применяют только CurrentFlag без EndDate. Это упрощает запрос текущей версии, но затрудняет точную выборку исторических периодов и усложняет поддержку временных аналитических запросов. В техническом плане EndDate предпочтительнее, потому что он позволяет гибко фильтровать исторические версии даже в случаях, когда фокус на текущем состоянии утерян.
-
Взаимодействие с загрузчиком. Основная задача загрузчика - корректно определить, какие версии обновлять, какие удалять и какие создавать. Это приводит к необходимости детальной логики в ETL/ELT-конвейере: поиск текущей версии по NK, сравнение HashAttr, корректная постановка EndDate и создание новой версии. В крупных системах такие механизмы оформляются как модуль «SCD Processor», который применяется к каждому изменению из источника и возвращает набор изменений в витрину.
-
Управление временем. В практике SCD применяют временные таблицы и журналы изменений (Change Data Capture, CDC). CDC-слой обеспечивает детектирование изменений на уровне источника и упрощает передачу изменений в конвейер. В зависимости от объема данных выбирают пакетную обработку (batch) или потоковую обработку (streaming). Потоковая обработка требует минимального времени задержки между источником изменений и витриной, что особенно важно для текущих записей.
Алгоритмы обновления и интеграции
Эффективная реализация SCD требует детализированного подхода к обновлению и интеграции. Ниже приведены базовые алгоритмы для типов 1 и 2, которые составляют костяк большинства архитектур SCD, а затем обсуждаются гибридные подходы и производственные практики.
-
Тип 1 (полное перезаписывание). В этом случае изменения не сохраняются в истории. Прямой_UPDATE существующей записи без создания новой версии:
-- Пример (упрощенный) для типа 1
UPDATE dim_person
SET Name = s.Name,
    Address = s.Address,
    Email = s.Email
WHERE dim_person NK = s.NK;
Применение типа 1 полезно, когда сохранение истории не требуется, но чаще применяется внутри измерений, которые действительно должны отражать только текущее состояние. Стоит отметить, что для аналитики тип 1 не поддерживает аудиторские требования и регулятивные проверки.
-
Тип 2 (версионирование). Самый распространенный подход для сохранения изменений. Ввод новой версии и закрытие старой:
-- Псевдо-SQL-операции для тип 2
-- 1) Найти текущую версию
SELECT t.SK, t.HashAttr FROM dim_person t
JOIN staging s ON t.NK = s.NK AND t.EndDate IS NULL;

-- 2) Если изменения есть, закрыть старую версию и вставить новую
## UPDATE dim_person
SET EndDate = s.LoadDate - INTERVAL '1' DAY,
    CurrentFlag = FALSE,
    HashAttr = t.HashAttr
WHERE NK = s.NK AND EndDate IS NULL;

INSERT INTO dim_person (SK, NK, Name, Address, Email, EffectiveDate, EndDate, CurrentFlag, HashAttr)
VALUES (NEW_SK, s.NK, s.Name, s.Address, s.Email, s.LoadDate, NULL, TRUE, HASH(s.Name, s.Address, s.Email));
В реальных системах применяют MERGE-операции, CDC-процессоры и штатные конвейеры ETL/ELT. Вариант на практике может выглядеть иначе в зависимости от конкретной СУБД и инфраструктуры.
-
Тип 3 (сохранение предшествующего состояния). В этом подходе фиксируется изменение в одном или нескольких дополнительных столбцах без полной версии:
-- Пример для типа 3
IF s.Name  d.Name THEN
  d.PreviousName = d.Name;
  d.Name = s.Name;
END IF;
Тип 3 полезен, когда нужен быстрый доступ к прошлому значению конкретного атрибута, но не требуется полноценно хранить все версии. Это упрощает модель и снижает стоимость хранения, но снижает способность видеть полную историю по каждому атрибуту.
-
Гибридные подходы и дополнительные стратегии. В современных архитектурах часто комбинируются принципы типов 2 и 3, применяются мини-версии объектов, или же используется «многоуровневая» витрина: слой текущих записей и слой изменений. В этом контексте важно поддерживать единообразие и согласованность между слоями, чтобы аналитические запросы могли корректно агрегировать данные.
-
Управление временем и региональными требованиями. В глобальных системах часто требуется поддержка временных зон, аудит и соответствие регулятивным требованиям. В таких случаях полезна унифицированная модель временных атрибутов и аккуратная документация правил обновления и миграций.
Проектирование схемы витрины данных
Дизайн витрин под SCD влияет на производительность запросов, простоту поддержки и способность масштабироваться. Рассмотрим ключевые принципы проектирования в контексте архитектуры SCD.
- Выбор схемы. В простой версии можно использовать одну таблицу для текущих записей с полем EndDate и CurrentFlag, но, как правило, предпочтительнее хранить версии в одной таблице с EndDate и вторая кнопка для текущих записей. В сложных сценариях разумно разделить текущие версии и архив, чтобы ускорить запросы на актуальные данные и снизить нагрузку на часть инфраструктуры, связанную с историческими запросами.
- Суррогатные ключи. Все dimension-таблицы должны иметь суррогатные ключи (SK), отделяющие бизнес-ключи от внутренней логики системы. Это упрощает параллельность загрузок, обеспечивает стабильность ссылочного целого и облегчает миграции.
- Индексирование и партиционирование. Для эффективной обработки версии и временных интервалов рекомендуется использовать композитные индексы по NK, EffectiveDate и EndDate. Партиционирование по диапазону дат улучшает производительность исторических запросов и ускоряет архивирование.
- Архитектура обработки изменений. В современных конвейерах обработки данных обычно выделяют модули CDC/ETL-processor, которые детектируют изменения на источнике и применяют их к витрине через регламентированные шаги: идентификация изменений, выбор паттерна версионирования (Type 1/2/3), создание новой версии и обновление статуса текущей версии.
- Интеграционные протоколы. В крупных системах важна совместимость между источниками и витриной. Для CDC может применяться Debezium, встроенные функциональные возможности СУБД или внешние сервисы потоковой передачи (Kafka, Kinesis). Протоколы должны поддерживать согласование событий и порядок применения изменений, чтобы не нарушать целостность временных интервалов.
Примеры реализации на SQL: расчёт версий, текущих записей и истории
Ниже приведены конкретные примеры, которые иллюстрируют типовые кейсы SCD Type 2 и интеграцию в конвейер ELT. Эти примеры служат для иллюстрации архитектурного подхода и не являются узким шаблоном под конкретную СУБД. В реальных проектах они адаптируются под выбранную платформу (PostgreSQL, Snowflake, Oracle и пр.).
-
Пример таблицы dimension и staging данных. Обозначим dimension как dim_customer и staging как stg_customer, где dim_customer содержит поля NK (естественный ключ), SK (суррогатный ключ), Name, Address, Email, EffectiveDate, EndDate, CurrentFlag, HashAttr. В staging - те же поля без SK, и LoadDate.
-
Пример схемы хранения текущей версии и истории. В типичной реализации версия - это строка или целочисленный счетчик. Реализация с EndDate и CurrentFlag позволяет избежать лишнего дублирования.
-- Пример DDL (упрощенный)
CREATE TABLE dim_customer (
  SK BIGINT PRIMARY KEY,
  NK VARCHAR(50),
  Name VARCHAR(100),
  Address VARCHAR(200),
  Email VARCHAR(100),
  EffectiveDate DATE,
  EndDate DATE,
  CurrentFlag BOOLEAN,
  HashAttr VARCHAR(64)
);

CREATE TABLE stg_customer (
  NK VARCHAR(50),
  Name VARCHAR(100),
  Address VARCHAR(200),
  Email VARCHAR(100),
  LoadDate DATE
);
-
Пример пошаговой логики загрузки типа 2 через MERGE (псевдокод, адаптируйте синтаксис под СУБД).
-- Псевдо-логика Merge для SCD Type 2 MERGE INTO dim_customer AS d USING stg_customer AS s ON d.NK = s.NK AND d.EndDate IS NULL WHEN MATCHED AND (d.Name s.Name OR d.Address s.Address OR d.Email s.Email) THEN UPDATE SET EndDate = s.LoadDate - 1, CurrentFlag = FALSE ## WHEN NOT MATCHED THEN INSERT (SK, NK, Name, Address, Email, EffectiveDate, EndDate, CurrentFlag, HashAttr) VALUES (NEXTVAL('dim_customer_seq'), s.NK, s.Name, s.Address, s.Email, s.LoadDate, NULL, TRUE, HASH(s.Name, s.Address, s.Email)); -- После обновления должны обработать случаи, когда запись уже есть, но атрибуты изменились: ## UPDATE dim_customer SET EndDate = s.LoadDate - 1, CurrentFlag = FALSE WHERE NK IN (SELECT NK FROM stg_customer WHERE EXISTS (изменение)); INSERT INTO dim_customer (SK, NK, Name, Address, Email, EffectiveDate, EndDate, CurrentFlag, HashAttr) VALUES (NEXTVAL('dim_customer_seq'), s.NK, s.Name, s.Address, s.Email, s.LoadDate, NULL, TRUE, HASH(s.Name, s.Address, s.Email)); -
Пример вычисления HashAttr в этапе трансформации (упрощенно). Это обеспечивает детекцию изменений без сравнения всех полей.
SELECT
  NK,
  Name,
  Address,
  Email,
  HASH(Name, Address, Email) AS HashAttr
FROM stg_customer;
-
Пример запроса для выборки текущих записей. Это ключевой запрос аналитических сцен.
SELECT *
## FROM dim_customer
WHERE EndDate IS NULL AND CurrentFlag = TRUE;
-
Пример сценария Type 3. Если требуется сохранить предыдущее значение Name для анализа тенденций, можно добавить столбец PreviousName и заполнять его при изменении.
IF s.Name  d.Name THEN
  UPDATE dim_customer
  SET PreviousName = d.Name,
      Name = s.Name
  WHERE d.NK = s.NK AND d.EndDate IS NULL;
END IF;
Замечание. Конкретная реализация зависит от выбранной СУБД и инфраструктуры конвейера. В продакшн-системах используют комбинации MERGE, процедурных обработчиков и модулей CDC, которые выстраивают устойчивый и повторяемый поток изменений.
Интеграции и протоколы обновления
Интеграционные аспекты SCD не менее важны, чем сами формулы и схемы. Эффективная интеграция требует:
- Определение источников изменений. В зависимости от источника возможно получение изменений через CDC-систему, лог-аппараты или файловые конвейеры. Важно согласовать временные метки LoadDate и SourceSystem, чтобы корректно реконструировать историю.
- Согласование форматов. Убедитесь, что естественные ключи и формат дат согласованы между источником и витриной. Неправильная конвертация временных зон или форматов дат может привести к расхождениям и ложно-положительным изменениям.
- Протоколы повторной загрузки. Важно предусмотреть детерминированные правила повторной загрузки и обработки ошибок. Считайте, что любое повторение операции следует детерминировать и не должно приводить к дублированию версий.
- Взаимодействие с инструментами конвейеров. Внедрение SCD в общую архитектуру требует тесной интеграции с инструментами ETL/ELT и мониторингом конвейеров. Эти системы должны обеспечивать отслеживание статуса обработки, версионирование конвейеров и журнал изменений.
Key takeaways
- SCD позволяют сохранять историю изменений в измерениях при поддержке быстрого доступа к текущей версии.
- Основные принципы: surrogate keys, временные интервалы (EffectiveDate и EndDate), и выбор подхода к версии (Type 1, 2, 3, гибриды).
- Тип 2 является наиболее распространенным способом сохранения полной истории изменений без дублирования записей и обеспечивает точность временных запросов.
- Детальная архитектура конвейера, CDC и согласование форматов критически важны для корректной интеграции изменений между источником и витриной.
- Примеры SQL-реализаций демонстрируют общие паттерны: детекция изменений, закрытие старых версий и создание новых версий.
- Гибридные подходы и продуманное проектирование схемы витрины позволяют достигнуть баланса между производительностью запросов и полнотой истории.
- В реальных проектах следует документировать правила версионирования, согласовать ключевые поля и обеспечить тестовую среду, где можно воспроизвести любые сценарии изменений.
FAQ
- Что такое SCD и зачем нужна история изменений в витрине данных?
SCD - это методология хранения изменений измерений так, чтобы можно было увидеть не только текущее состояние, но и его изменение во времени. История изменений важна для аналитических задач, аудита, регуляторных требований и для корректного анализа трендов.
- Как выбрать между SCD Type 1 и Type 2?
Выбор зависит от требований по аудиту и аналитике. Type 1 подходит, если история изменений не требуется, а обновления должны отражаться мгновенно. Type 2 сохраняет полную историю изменений и поддерживает точность анализа по времени.
- Какие данные следует сохранять в HashAttr и как его использовать?
HashAttr следует рассчитывать на основе набора атрибутов, которые участвуют в анализе изменений. HashAttr позволяет быстро определить изменение и снизить стоимость сравнения больших наборов полей. При этом нужно контролировать коллизии и обеспечивать повторяемость расчета хеша.
- Какие риски связаны с EndDate и CurrentFlag в одной таблице?
Главный риск - сложность в поддержке согласованности и корректности текущих версий, особенно при параллельной загрузке и нескольких потоках. EndDate и CurrentFlag должны обновляться атомарно, чтобы исключить несогласованность между текущей и архивной версиями.
- Как обеспечить согласованность времени при сборе изменений из разных источников?
Необходимо использовать единый источник времени (например, LoadDate) и корректно нормализовать временные зоны. CDC-слой должен передавать корректную временную метку и источник изменений. Важно избегать гонок условий и дублирования версий.
- Какие паттерны мониторинга и тестирования подходят для SCD?
Рекомендованы тестовые сценарии на предметы: добавление новой записи, изменение атрибутов, отсутствие изменений, повторная попытка загрузки и обработка ошибок. Мониторинг должен включать метрики задержки, ошибок и консистентности версий.
- Какие open-source решения полезны для реализации SCD?
В open-source контексте можно отметить PostgreSQL и Apache Spark как платформы для реализации SCD через расширения и конвейеры, а также инструменты CDC, например Debezium, для детекции изменений. В российской практике можно упомянуть ограниченные кейсы интеграции с локальными системами, если они соответствуют требованиям к хранению и безопасности данных.
- Как управлять историей при изменении бизнес-правил и ключей?
Внесение изменений в бизнес-правила требует фиксации версий схемы и возможно миграций. В таких случаях имеет смысл создавать новую версию модели витрины (например, добавление нового типа версий или создание отдельной архивной таблицы), чтобы не разрушать существующие анализы.
- В чем отличие между архитектурой «одна таблица» и «разделение таблиц» для SCD?
Архитектура «одна таблица»Simplified хранит все версии в одной таблице, что упрощает запрос текущих записей. Архитектура с разделением таблиц чаще обеспечивает лучшую производительность для запросов к текущим данным и упрощает архивирование, но требует согласования между слоями и более сложной координации загрузки.
- Какие рекомендации по проектированию и внедрению SCD в крупной организации?
Рекомендуются: четко описать требования к истории; выбрать подходящие типы SCD; обеспечить согласование форматов данных и временных интервалов; спроектировать эффективную архитектуру конвейеров и CDC; реализовать модуль SCD-процессор в ETL/ELT; внедрить тестовую среду и автоматизированную проверку целостности версий; обеспечить мониторинг и аудит изменений.


