

Мониторинг и трассировка: метрики Spark/Trino/ClickHouse/MinIO, логи
Современные ландшафты обработки данных объединяют MinIO как слой хранения, к которому обращаются Spark, Trino и ClickHouse, а также BI-слои для визуализации результатов. В таких системах наблюдаемость становится критическим фактором устойчивости и производительности: она позволяет обнаруживать узкие места, понимать распределение задержек по конвейеру и быстро локализовать проблемы в сложной цепочке вызовов. В этой главе рассмотрены архитектурные принципы мониторинга, набор метрик и подходы к трассировке и логированию, специфичные для интеграции MinIO с Spark, Trino, ClickHouse и BI-системами. Особое внимание уделяется унифицированным схемам корреляции контекста, практикам сбора данных и практическим сценариям внедрения в реальных кластерах.
- Обеспечение целостной картины производительности через связанные метрики, трассировку и логи.
- Архитектура observability-слоя: Prometheus/ Grafana, Loki/ Tempo, единые идентификаторы запроса и контекста.
- Практики по сбору и корреляции данных на уровне компонентов MinIO, Spark, Trino, ClickHouse и BI-интерфейсов.
- Руководство по внедрению: шаги, типовые схемы мониторинга и примеры сценариев диагностики.
Архитектура мониторинга и трассировки
Мониторинг в распределённых средах строится вокруг трех взаимодополняющих слоёв: метрики, трассировка и логи. Метрики дают агрегированные сведения о частоте событий, задержках и ресурсопотреблении. Трассировка позволяет реконструировать траекторию отдельного запроса через все участки конвейера. Логи содержат детальные события и контекст, который не всегда помещается в агрегированные показатели. В интеграции MinIO со Spark, Trino, ClickHouse и BI эти три слоя должны быть тесно связаны, чтобы обеспечить единый контекст и возможность быстрого переноса информации между системами.
- Метрики ориентированы на скорость обнаружения аномалий и реакцию на инциденты. Их следует собирать как в масштабе всей цепочки хранения и вычислений, так и внутри каждого компонента: MinIO, Spark, Trino, ClickHouse, а также на уровне BI-шлюзов и кэширования результатов.
- Трассировка обеспечивает холистическую видимость узких мест, которые не отражаются в отдельных метриках. Контекст запроса должен плавно проходить через REST/HTTP вызовы, gRPC и S3-совместимый API MinIO.
- Логи позволяют детально реконструировать траекторию событий, ошибки и исключительные ситуации, а также связывать их с метриками и трассировкой посредством общих идентификаторов.
Архитектурно следует рассматривать observability-платформу как связующий узел: Prometheus для метрик, Grafana для дашбордов, Loki для логов и Tempo (или Jaeger) для трассировки. В Kubernetes-окружении целесообразно использовать ServiceMonitors/ServiceUIs для динамического обнаружения эндпойнтов и унифицированной сборки метрик и логов через sidecar или агентские решения. Вне контейнеризированной инфраструктуры применяются аналогичные принципы через агентские внедрения и централизованные сборщики.
- Включение контекстной информации: trace_id, span_id, request_id должны быть переданы между компонентами через все уровни API-S3-подобный вызов к MinIO, запросы к Trino/ClickHouse и обращения BI-инструментов.
- Конфигурации должны поддерживать гибкую настройку выборочной выборки трассировки (sampling) и безопасное хранение чувствительных метрик.
- Архитектура должна учитывать безопасность и соответствие политик доступа, особенно когда данные проходят через BI-слой и внешние консоли мониторинга.
Метрики Spark, Trino, ClickHouse и MinIO: чем измерять
Для каждого компонента критически важно выбрать набор метрик, который позволяет оценивать как общую производительность, так и внутреннюю эффективность алгоритмов. Ниже приведены ориентиры по характеру метрик и примерам показателей, на которые стоит смотреть в контексте совместной эксплуатации MinIO и вычислительных движков.
-
Spark. В рамках Spark основное внимание уделяют задержкам обработки, загрузке кластерных ресурсов и здравому принятию решений по планированию задач. Важны такие группы метрик, как throughput записей и объём прочитанных данных, latency по стадиям выполнения, время ожидания очередей на планировщике задач и GC-потребление. Метрики памяти и CPU помогают раннее обнаруживать деградацию из-за перерасхода ресурсов или неэффективной конфигурации памяти и сериализации. Наличие метрик по взаимодействию со Storage Layer (MinIO) - время обращения к данным (read/write), частота ошибок доступа к bucket-ы и задержки чтения сегментов - позволяет отследить влияние хранилища на общий конвейер.
-
Trino. Как distributed SQL-движок, Trino особенно чувствителен к задержкам сетевых вызовов и к узким местам в чтении данных. Ключевые метрики включают задержку выполнения запросов (latency), латентность выполнения отдельных этапов, размер и скорость передачи данных между узлами, количество успешных и неуспешных запросов, а также показатели по пулу соединений с источниками данных и конвейеру вывода результатов в BI. В контексте MinIO выделяются показатели работы с объектами: скорость операций GET/PUT, средняя и медианная задержка на уровне объектов и операций над сегментами данных.
-
ClickHouse. Для колоночного СУБД-сервера критически важны задержки выполнения запросов, поступление и обработка данных, больший вес имеет ingestion-пайплайн, если данные пишутся в MinIO перед последующей агрегацией. Метрики следует собирать по времени выполнения запросов, throughput, загрузке CPU и памяти, IO-wait, а также по состоянию конкурентности чтения и записи. Дополнительно важны показатели по использованию дисковых каналов и кэширования, особенно при работе с большим количеством данных в MinIO.
-
MinIO. Как слой хранения, MinIO предоставляет метрики по операциям хранения: PUT/GET/DELETE, списки объектов, создание и удаление бакетов, а также латентности на уровне отдельных операций и общие показатели пропускной способности. В контексте интеграции с Spark/Trino/ClickHouse критично отслеживать яблочные узкие места: задержки доступа к данным в bucket-ах, очереди на обработку запросов, количество ошибок аутентификации и ошибок доступа, а также задержки в многопоточном выполнении.
-
BI-системы. Метрики BI-слоя часто опираются на задержки выполнения дашбордов, время обновления кадровой прогрузки и устойчивость к пиковым нагрузкам. Важно понимать задержки от момента запроса до визуализации, а также влияние кэширования и агрегаций на общую задержку отклика. Интеграция с MinIO и вычислительными движками отражается в задержках на этапе извлечения данных и преобразования, поэтому следует держать под контролем как внутренние показатели BI-инструментов, так и показатели взаимодействия с исходными системами.
Сводная идея: собрать сетку метрик по каждому участку конвейера, но сохранить единый контекст для корреляции. Это позволяет, с одной стороны, обнаруживать локальные проблемы в MinIO или в конкретном движке, а с другой стороны - видеть влияние на весь конвейер, включая BI-слой.
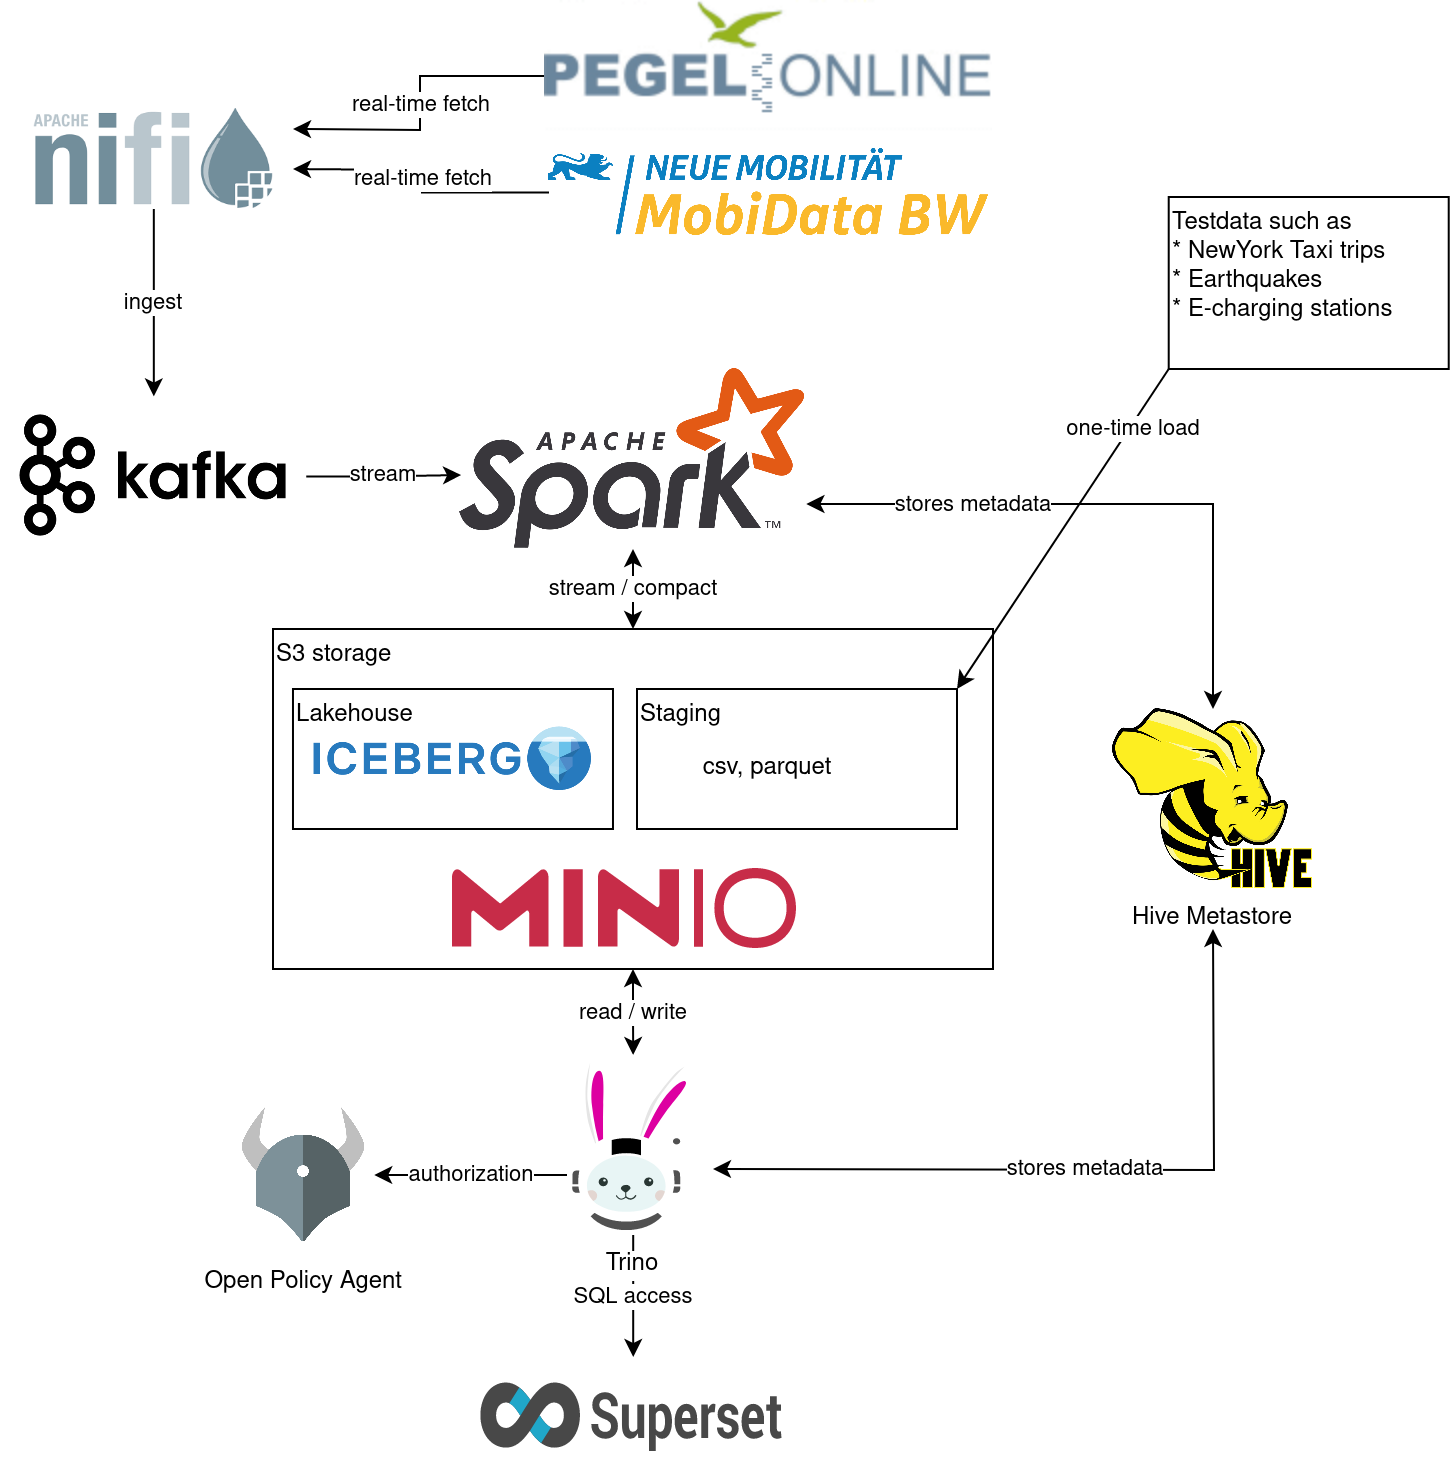
Трассировка и контекст: прокси-слой и протоколы
Распределённая трассировка необходима для реконструкции полного пути запроса через MinIO, Spark, Trino, ClickHouse и BI-платформы. В идеале контекст прослеживается от источника (BI или клиентский запрос) до точки записи результатов, включая все промежуточные сервисы. Основные принципы:
- Пропагация контекста. Встраивание trace-context в заголовки HTTP- и S3-совместимых вызовов позволяет сохранить трассировку на всем пути запроса. В MinIO контекст должен сохраняться во всех операциях над объектами, соответствующим образом переноса контекста в запросах к данным.
- Выбор трассировщика. Tempo или Jaeger предоставляет распределённую трассировку, которая позволяет строить полную карту зависимостей между компонентами. Важно обеспечить совместимость версий библиотек и корректную агрегацию трасс по различным источникам данных.
- Сэмплинг. В условиях высокой нагрузки целесообразна гибкая политика снижения выборки трассировки (sampling). Это позволяет сохранить разумное потребление памяти и сетевых ресурсов без потери возможности диагностики самых критичных инцидентов.
Трассировка должна быть нацелена на выявление задержек на границах между MinIO и вычислительными движками, а также на уровне BI-слоя. В идеальном сценарии можно сопоставлять trace_id с конкретной сессией BI, запросами к Trino и операциям в MinIO, чтобы быстро локализовать узкие места.
Логи и их обработка: сбор, хранение, поиск и корреляция
Логи представляют собой насыщенный контекст, который трудно уложить в агрегированные метрики. В связке MinIO, Spark, Trino, ClickHouse и BI логи часто содержат информацию об ошибках, предупреждениях, деталях выполнения и контексте операций. Эффективная стратегия логирования должна включать:
- Структурированные логи. Формат JSON или подобный структурированный формат упрощает поиск и агрегацию по полям, таким как trace_id, request_id, bucket, operation, user, и т. п.
- Централизованный сбор. Loki или аналогичный инструмент для логирования должен агрегировать логи со всех компонентов в единый репозиторий. Это облегчает поиск по контексту и сопоставление с метриками и трассировкой.
- Корреляция контекста. Логи должны содержать поля для корреляции: trace_id, span_id и, при необходимости, идентификаторы партии задач Spark или запросов Trino. Это позволяет быстро связать событие в логе с соответствующей точкой в трассировке и метрике.
- Уровни логирования. Конфигурации должны поддерживать динамическое изменение уровней логирования без перезапуска систем, чтобы оперативно усиливать детализацию в случаях инцидентов.
- Хранение и ретеншн. В зависимости от потребностей бизнеса и регуляторных требований следует выбирать политику хранения логов, оптимизацию пространства и архитектуру хранения (დ) копий на уровне холодной и горячей зоны, а также механизмы архивирования.
Композиция логов должна позволять быстро отвечать на вопросы вроде: где произошла ошибка при доступе к MinIO, какой запрос в Spark или Trino вызвал задержку, и какие операции были инициированы BI-инструментами в этот момент. Вдобавок, наличие общего поля контекста усиливает способность проводить ретроспективный аудит и пост-инцидентный разбор.
Интеграция: MinIO с Prometheus, Grafana, Loki, Tempo и BI-платформами
Интеграция MinIO с инструментами мониторинга и логирования происходит через унифицированный подход к экспозиции метрик, логов и трассировок. В контексте MinIO-Spark-Trino-ClickHouse-BI целесообразно реализовать следующее:
- Метрики. Включение Prometheus-совместимой экспозиции метрик на стороне MinIO и на каждом уровне вычислительного контура. В Prometheus-конфигурации должны присутствовать целевые точки для MinIO, Spark, Trino и ClickHouse. В Kubernetes возможно использование ServiceMonitors для автоматического сбора метрик и настройки алертов на основе порогов.
- Логи. Центральное хранение логов в Loki с возможностью индексирования по trace_id и другим полям контекста. Это позволяет оперативно связывать события из логов с конкретными трассировками и метриками.
- Трассировка. Tempo или Jaeger собирают trace-данные, возможность трассировать запросы от BI до MinIO через Spark/Trino/ClickHouse. Важно обеспечить передачу контекста через все стеки API.
- BI-инструменты. Подключение BI-платформ к источникам данных и к observability-слою через общие идентификаторы контекста. Визуализация должна строиться на дашбордах, которые комбинируют показатели метрик, трассировки и логи по единым срезам данных.
- Безопасность и доступ. Для открытых доступов к дашбордам и к данным метрик следует внедрять политики RBAC, шифрование в состоянии покоя и в транзите, а также аудит доступа к критическим данным наблюдаемости.
Практические направления внедрения:
- Определение набора критичных дашбордов: задержки чтения/записи MinIO по bucket-узлам, задержки выполнения запросов Spark/Trino/ClickHouse, и время обновления BI-дашбордов.
- Внедрение единых оповещений на основе метрик и трассировок для инцидентов на уровне хранения и вычислений.
- Стратегия эволюции observability-платформы: начиная с базового набора метрик и лога, переход к трассировке и контекстной корреляции.
Безусловно, интеграция требует планирования в части политики мониторинга, чтобы не перегружать систему избыточной детализацией. Важно разделять уровни будемых данных: горячие дашборды для оперативной диагностики, холодные хранилища для ретроспективного анализа и архивные трассировки для аудита.
Практические сценарии мониторинга и оптимизации
- Сценарий 1: задержки доступа к данным MinIO во время пиковой загрузки. Диагностику начинают с метрик MinIO: количество операций, средняя задержка и пропускная способность. Далее изучают Spark-пайплайн, который читает данные, проверяют показатели IO и GC. Наконец сверяют трассировку, чтобы увидеть, на каком участке конвейера возникает задержка: MinIO-стороне или вычислительном слое.
- Сценарий 2: долгое выполнение сложного запроса в Trino, использующего данные из MinIO. Сначала анализируются latency и throughput запросов, затем трассировка показывает путь запроса через брокеры и обмен данными между узлами. Логи помогают понять, почему часть узлов задерживается: перегруженность сети, contention по памяти или проблема с аутентификацией.
- Сценарий 3: загрузочные пики BI-представлений, которые запускают повторные чтения данных из MinIO. Здесь важно проверить кэширование и режимы предварительной агрегации на BI-слое, а также влияние на MinIO и Spark-слои. Метрики читаемости, задержки и частоты повторных запросов в BI-инструментах помогают определить точки оптимизации.
Эти сценарии демонстрируют необходимость синхронной работы между уровнями наблюдаемости и оперативной настройкой параметров. Важно внедрить процессы регулярного анализа и ретроспективного аудита, чтобы не полагаться на разрозненные кросс-метрики и фрагменты логов.
Key takeaways
- Эффективная наблюдаемость в интеграции MinIO с Spark, Trino, ClickHouse и BI требует синхронного сбора метрик, трассировок и логов с единым контекстом.
- Контекстная корреляция (trace_id, span_id, request_id) должна проходить через все этапы конвейера, включая S3-совместимый доступ к MinIO.
- Архитектура наблюдаемости должна покрывать три слоя: Prometheus для метрик, Loki для логов и Tempo/Jaeger для трассировки, с возможностью интеграции в Grafana-дашборды.
- Метрики по каждому компоненту следует дополнять индикаторами взаимодействия с другими слоями: задержки доступа к MinIO, задержки выполнения запросов в Spark/Trino/ClickHouse и задержки обновления BI-дашбордов.
- Важна структурированная и коррелируемая логика: логи должны содержать поля trace_id и другие ключевые параметры, чтобы связывать события с метриками и трассировкой.
- Практические сценарии диагностики требуют начала с местности MinIO, затем двигаться вверх по конвейеру к вычислительным системам и BI-слою, чтобы локализовать узкие места.
- Планирование безопасности и соответствия при внедрении наблюдаемостиiko обеспечивает защиту чувствительных данных и контроль доступа к дашбордам.
FAQ
- Какие базовые метрики важны для мониторинга MinIO в связке со Spark, Trino и ClickHouse?
- Важно измерять частоту и задержку операций над объектами в MinIO (PUT/GET), throughput, процент ошибок доступа и задержку по операциям чтения и записи. Эти показатели должны коррелироваться с задержками чтения/записи в Spark и выполнении запросов в Trino и ClickHouse, чтобы увидеть влияние хранилища на конвейер.
- Как обеспечить корреляцию между метриками, трассировкой и логами?
- Необходимо внедрить единый идентификатор контекста (trace_id) на уровне входного запроса от BI или клиента и проксировать его через все слои: MinIO, вычислительный движок и BI-инструмент. Логи должны включать trace_id, span_id и request_id, что позволяет соединить трассировку, метрики и логи в единый разрез.
- Какие инструменты выбора полезны для Kubernetes-окружения?
- Prometheus и Grafana для метрик и дашбордов, Loki для логов и Tempo для трассировки. В Kubernetes можно использовать ServiceMonitors и соответствующие адаптеры для автоматического сбора данных, а также интегрировать BI-инструменты через безопасные коннекторы к данным.
- Какие типичные проблемы возникают при интеграции MinIO с BI-инструментами?
- Проблемы могут быть связаны с задержкой доступа к данным, с некорректной корреляцией контекста между слоями, а также с нехваткой ресурсов в MinIO или в вычислительных движках, что приводит к задержкам и ошибкам. Эффективная диагностика требует связки метрик, трассировки и логов.
- Какой подход выбрать к трассировке в контексте S3-подобного доступа?
- Необходимо обеспечить проксирование trace-context через HTTP-запросы к MinIO и через вызовы к Spark/Trino/ClickHouse. Tempo или Jaeger должны принимать трассировки с едиными идентификаторами и агрегировать их по всей цепочке.
- Как минимизировать избыточную детализацию в метриках?
- Применяется политика выборки (sampling) трассировки и фильтрация по уровню детализации метрик. Важно сохранять критические показатели и избегать перегрузки системы журналирования и хранения данных.
- Какие сценарии способствуют быстрой диагностике инцидентов?
- Быстрый доступ к связке trace_id/логов/метрик и наличие готовых дашбордов по задержкам MinIO, времени выполнения запросов и обновления BI-дашбордов. Наличие готовых сценариев реагирования и чек-листов помогает ускорить RCA.
- Какие аспекты безопасности нужно учитывать в observability?
- Шифрование данных на каналах передачи и в состоянии покоя, безопасный доступ к дашбордам и логам, ограничение прав на просмотр и изменение в observability-платформе. Корреляционные поля должны быть обезличены или зашифрованы там, где это требуется по регуляторным требованиям.
- Как начать внедрять мониторинг с минимального набора?
- Начните с базовых метрик и дашбордов по MinIO и ключевым точкам в Spark/Trino/ClickHouse, затем добавьте трассировку и логи. Постепенно расширяйте набор метрик и корректируйте политики сохранения, чтобы обеспечить устойчивость к нагрузкам и возможность эволюции системы.
- Какие есть преимущества унифицированной Observability для BI?
- Унифицированная observability позволяет BI-командам быстро переходить от визуализации к источникам данных, проводить ретроспективный анализ инцидентов и снижать время реакции. Это содействует устойчивости и прозрачности конвейера данных на протяжении всего цикла обработки.


