

Архитектура для больших данных: федеративные запросы, кросс-платформенная аналитика
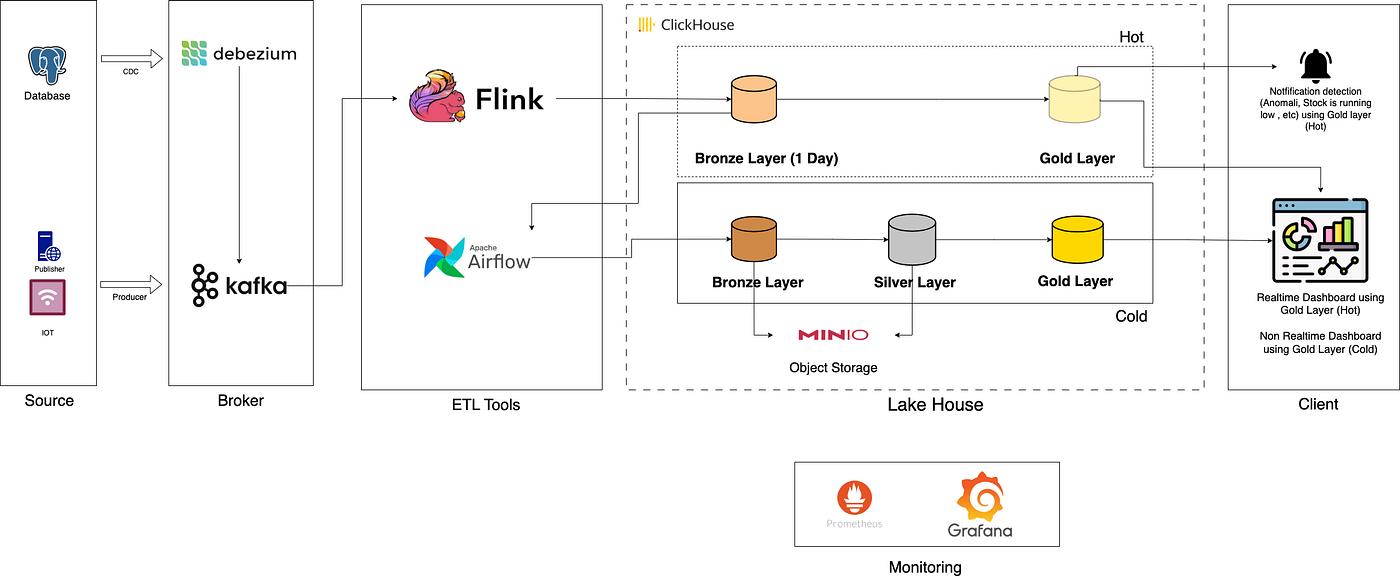
Краткое введение
Глобальные данные hoje становятся не централизованной копией истины, а сетью распределённых источников, где MinIO выступает как единая, надёжная точка доступа к данным. В такой среде кросс-платформенная аналитика требует скоординированного взаимодействия между вычислительными движками - Spark, Trino и ClickHouse - и визуализацией через BI-системы. Архитектура должна поддерживать федеративные запросы, где данные остаются локализованными в рамках источников, но результаты объединяются на уровне планирования и выполнения запросов. В этом контексте критически важно сочетать подписанные протоколы доступа, единые принципы безопасности и надёжную каталогизацию метаданных, чтобы снижать задержки, повышать точность и сохранять управляемость данных.
Данная глава формирует практическое и концептуальное руководство для проектирования и реализации федеративной аналитики с MinIO в качестве основного слоя хранения. Мы рассмотрим принципы архитектуры, протоколы интеграции между Spark, Trino и ClickHouse, схемы хранения и каталоги данных, а также подходы к безопасности, мониторингу и оптимизации производительности. В конце - реальные паттерны внедрения и типовые конфигурации, позволяющие двигаться от идеи к эксплуатации.
- Концепции федеративной аналитики и роль MinIO как центра доступа к данным
- Архитектурные паттерны взаимодействия Spark, Trino, ClickHouse и BI-систем
- Протоколы доступа, безопасность и согласованность данных
- Варианты реализации паттернов интеграции и практические конфигурации
- Мониторинг, производительность и управляемость кросс-платформенной аналитики
Архитектурная рамка федеративной аналитики
Федеративная аналитика - это подход, в котором данные остаются в своих источниках, а вычисления осуществляются над этими данными с минимальной передачей больших объёмов информации. Миньо играет здесь роль унифицированного слоя хранения и стека управления метаданными, обеспечивая доступ к неструктурированным и структурированным данным через S3-совместимый API. Это позволяет централизовать управление доступом, политики хранения и версии данных, не нарушая принцип локальности данных.
Ключевые элементы архитектуры:
- Единая точка доступа к данным: MinIO позволяет слоям вычисления и BI обращаться к данным через стандартные протоколы S3, обеспечивая консистентность и единообразие доступа.
- Разделение вычисления и хранения: вычислительные движки (Spark, Trino, ClickHouse) выполняют запросы над данными в MinIO, не копируя данные без надобности.
- Каталоги и метаданные: централизованные каталоги позволяют схематизировать данные, поддерживать версии, описания и lineage, что критично для управляемости в федеративной среде.
- Управление безопасностью и политиками: единая аутентификация и авторизация, шифрование на уровне хранения и передачи, контроль доступа на уровне объектов и префиксов.
Почему этот подход эффективен?
- Локализация данных снижает издержки на копирование больших массивов и упрощает соответствие требованиям регуляторов.
- Гибкость в выборе вычислительного движка под конкретную задачу: Spark - ETL и машинное обучение; Trino - интерактивная аналитика и BI; ClickHouse - быстрые OLAP-запросы на ограниченных массивах данных.
- Единая платформа хранения упрощает каталоги, lineage и управления версиями, что особенно важно для кросс-платформенной аналитики.
Протоколы доступа и интерфейсы интеграции
MinIO реализует S3-совместимый API, что позволяет использовать стандартные клиента и драйверы в разных средах. В контексте интеграции с Spark, Trino и ClickHouse ключевым является корректная настройка доступа, а также согласование параметров безопасности и аутентификации.
-
Spark: доступ к данным осуществляется через Hadoop FileSystem API (fs.s3a). Конфигурация usually предполагает указание точки входа, ключей доступа и параметров TLS/SSL. Важна поддержка path-style access и совместимость с MinIO, который может работать в режиме без виртуального хоста. Это позволяет использовать привычный для Spark код ETL-пайплайнов и ML-циклов над данными, расположенными в MinIO, без переработки логики чтения.
-
Trino: как федеративный движок, он может обращаться к данным в MinIO через секцию s3a/специализированные каталоги. Для BI-итераций и интерпретации под аналитические запросы Trino становится центральной точкой объединения данных из разных источников, где MinIO выступает как Data Lake.
-
ClickHouse: устойчив к высокопараллельным OLAP-запросам и может использовать S3-слой MinIO для хранения «сырого» и «отобранного» датасета, разделяя хранение и вычисление так же, как и остальные движки. Это особенно полезно, когда нужно строить быстрые агрегаты над данными, уже доступными в MinIO.
Безопасность и аутентификация в федеративной схеме требуют:
- Централизованной аутентификации (например, через интеграцию с корпоративной системой IAM).
- Ролевых политик на уровне объектов и префиксов MinIO, чтобы ограничить доступ по данным и контексту выполнения запроса.
- Шифрования на покое и в транзите, включая возможности TLS и клиентские ключи.
- Контроль версий и аудит операций для обеспечения соответствия требованиям.
## Пример конфигурации Spark для доступа к MinIO (fs.s3a) через MinIO:
spark = SparkSession.builder()
  .config("spark.hadoop.fs.s3a.endpoint", "http://minio.example.com:9000")
  .config("spark.hadoop.fs.s3a.access.key", "MINIOACCESSKEY")
  .config("spark.hadoop.fs.s3a.secret.key", "MINIOSECRETKEY")
  .config("spark.hadoop.fs.s3a.path.style.access", "true")
  .config("spark.hadoop.fs.s3a.connection.ssl.enabled", "false")
  .getOrCreate()
## Пример конфигурации Trino (catalog) для доступа к MinIO: connector.name=hive hive.metastore.uri=thrift://metastore.example.com:9083 hive.s3.endpoint=http://minio.example.com:9000 hive.s3.access-key=MINIOACCESSKEY hive.s3.secret-key=MINIOSECRETKEY hive.s3.path.style.access=true hive.s3.signing-version=2
## Пример конфигурации ClickHouse для хранения данных в MinIO (storage_configuration):
storage_configuration:
  s3:
    endpoint: "http://minio.example.com:9000"
    access_key_id: "MINIOACCESSKEY"
    secret_access_key: "MINIOSECRETKEY"
    use_environment_variables: 0
    cartesian: 0
    region: "us-east-1"
    scheme: http
Эти примеры иллюстрируют общий подход к настройке подключения: минимальный набор ключей доступа, корректная адресация и корректная настройка пути доступа. В реальном проекте конфигурации дополняются политиками безопасности, включают временные креденшиалы и управление ключами через секрет-менеджеры.
Архитектура хранения и каталоги данных
MinIO обеспечивает объектное хранение с тонкой настройкой политик доступа, версионирования и ретенции. В контексте federated analytics важно проектировать структуры bucket-ов и префиксов так, чтобы обеспечить минимальные задержки доступа и простоту управления данными.
- Стратегия разбиения данных: логическое разделение по предметным областям (например, продажи, операционные данные, журналы) и по временным диапазонам. Это облегчает фильтрацию на этапе чтения и снижает сетевые запросы к большому объему данных.
- Каталоги и схемы: центральный каталог метаданных (например, Hive Metastore или Glue) служит источником истины о схемах, типах столбцов и partitioning. В федеративной среде каталоги должны быть согласованы между движками, чтобы планировщики могли корректно объединять данные из разных источников.
- Метаданные и lineage: хранение информации о происхождении данных, версиях и зависимостях между наборами данных позволяет поддерживать прослеживаемость в рамках кросс-платформенных запросов и соответствовать требованиям регуляторов.
- Градиентная долговечность: MinIO обеспечивает версионирование объектов и политики хранения. В федеративной аналитике это важно для отката к предыдущим версиям набора данных или для аудита.
Паттерны размещения данных в рамках MinIO:
- Плоская структура bucket-предикатов по доменам и временным диапазонам, поддерживаемая префиксами. Такой подход упрощает фильтрацию на стороне клиента и снижает стоимость сканирования.
- Разнесение «сырого» и «обработанного» слоя. Оставляя оригинальные данные в одном префиксе и агрегированные/индексированные версии в другом, можно ускорить повторные запросы и уменьшить влияние загруженности отдельных сегментов.
Планирование запросов и федеративное выполнение
Архитектура федеративной аналитики требует совместного планирования, где межплатформенные движки взаимодействуют через общие результаты и частично выполняют вычисления локально. Основная идея: максимально перенести вычисления к источнику данных там, где это возможно, и минимизировать перенос больших объёмов данных между узлами.
- Планы запросов и pushdown: современные движки поддерживают pushdown predicate-pushing в уровне источника данных. Это означает, что фильтры и проекции выполняются на уровне MinIO/сервиса хранения до передачи больших данных в вычислительный слой.
- Географическая и сетевых ограничений: в федеративной архитектуре следует учитывать сетевую латентность между дата-центрами и вычислительными узлами. Распределение задач по узлам должно учитывать балансировку нагрузки и возможность локального объединения результатов.
- Временные согласованности: для кросс-платформенных запросов необходимы правила согласованности на уровне каталога и версий данных. При отсутствии строгой глобальной согласованности допускается «оптимистичная» модель версии, но должны быть механизмы отката и аудита.
- Разделение задач по движкам: Spark эффективнее применим для сложной ETL-логики, подготовки признаков и обучения моделей; Trino обеспечивает быстрые интерактивные запросы на больших объемах данных, смешанных наборов и расширенных фильтров; ClickHouse - для высокопроизводительных OLAP-скидок и быстрых агрегаций над подмножество данных.
Реализация федеративного анализа может быть достигнута через следующие паттерны:
- Паттерн «ETL-подготовки» с использованием Spark: агрегации, нормализация и обогащение данных перед загрузкой в BI-слой, при этом данные остаются в MinIO.
- Паттерн «федеративный запрос» через Trino: выполнение межсетевых join-операций и агрегаций без выноса больших данных в BI-слой; интеграция с Tableau или Looker через соответствующие коннекторы.
- Паттерн «пределённый OLAP» через ClickHouse: создание прозрательной OLAP-обработки на подвыборке данных, хранящихся в MinIO, с использованием S3-слоя как слоя хранения.
Оптимизация в рамках федеративной аналитики строится на нескольких столпах:
- Препроцессинг данных на уровне источников: фильтрация, проекции, индексация и компоновка схем, чтобы снизить количество прочитанных объектов.
- Кэширование на уровне движков: Spark может кэшировать промежуточные данные, Trino - результатные части запросов, ClickHouse - часто запрашиваемые аггрегаты.
- Стратегии распределения загрузки: планировщик должен учитывать текущую нагрузку, пропускную способность сети и задержки между узлами.
Практические паттерны интеграции
Чтобы иллюстрировать реальную практику, рассмотрим несколько типовых паттернов интеграции с MinIO и ведущими движками.
- ETL и машинное обучение через Spark: MinIO служит источником данных для обучения и подготовки признаков. Spark считывает данные через fs.s3a, выполняет сложную обработку, сохраняет результаты обратно в MinIO. Визуализация и BI остаются привязанными к данным, полученным на выходе конвейера.
- Интерактивная аналитика через Trino: BI-слой обращается к Trino, который читает данные из MinIO и объединяет источники в реальном времени. Такой подход обеспечивает низкие задержки по запросам и масштабируемость.
- OLAP через ClickHouse: хранение частично агрегированных версий данных в S3-слое MinIO позволяет ClickHouse выполнять быстро сложные агрегации. Это удобно для дашбордов с высокой обновляемостью и требованием быстрого времени отклика.
- BI-интеграции: BI-системы, такие как Tableau или Looker, могут подключаться к Trino или ClickHouse, чтобы строить дашборды над федеративной базой. Важно обеспечить согласование схем, времени обновления и политики безопасности между BI и источниками.
Типовые конфигурации:
- Файловая организация в MinIO: разделение по доменам и временным диапазонам, с разделением «сырого» и «обработанного» слоя, что упрощает повторную обработку.
- Каталоги и согласование схем: единый каталог схем в Hive Metastore или аналогичном сервисе для всех движков, что снимает риск рассинхронизации определений столбцов и типов данных.
- Секреты и политики: хранение ключей доступа в секрет-менеджере, автоматическое обновление и ротация credentials.
Мониторинг и производительность
Производительность федеративной аналитики определяется не только вычислительной мощностью, но и качеством доступа к данным. Важно устанавливать набор метрик и инструментов мониторинга, которые позволяют быстро идентифицировать узкие места.
- Метрики доступа и задержек: время чтения объектов, доля пропускной способности сети, латентности сети между MinIO и вычислительными узлами.
- Метрики планирования: доля predicate-pushdown, эффективность фильтрационных условий, доля данных, которые перемещаются между узлами.
- Метрики памяти и вычислений: загрузка JVM/кластера Spark, число активных соединений, кешируемые результаты и кэш-мисс.
- Метрики качества данных: актуальность версий, доля ошибок синхронизации схем, частота обновления каталога.
Практические рекомендации:
- Разделяйте каталоги и данные по региону/партнерам, чтобы минимизировать сетевые переходы и увеличить локальность.
- Включайте мониторинг на уровне MinIO, движков и BI-слоя: централизованный дашборд упрощает диагностику.
- Оптимизируйте чтение данных: используйте разделение по partition, фильтрацию на чтение и проекции на раннем этапе выполнения.
Примеры реализации и кейсы внедрения
Кейс 1: Финансовая компания реализовала федеративную аналитику над данными из разных источников: транзакционные логи хранились в MinIO, обучающиеся модели - на Spark, интерактивная аналитика - через Trino, агрегаты - в ClickHouse. Каталог схем был унифицирован через Hive Metastore. Ключевые результаты: сокращение времени на подготовку данных на 40-60%; увеличение скорости интерактивной аналитики на 2-3 порядка.
Кейс 2: Ритейлер внедрил кросс-платформенную аналитику для мониторинга цепочки поставок. MinIO располагался в нескольких регионах, а движки - в локальных кластерах. Согласованность и контроль доступов обеспечивались через единый каталоги и политики. BI-дашборды строились через Looker, подключённый к Trino, что позволило быстро формировать multi-канальные отчеты.
Индустриальные практики:
-
Стратегия минимального наслоения: минимизировать копирование данных между MinIO и вычислительными движками, используя единый источник.
-
Стратегия отказоустойчивости: репликация bucket-ов и резервное копирование слоёв MinIO, а также резервирование каталога метаданных.
-
Стратегия безопасности: строгие политики доступа и аудит, включая шифрование и контроль доступа на уровне префиксов и объектов.
## Пример конфигурации каталога Hive Metastore для совместной работы с Trino и Spark:
## Конфигурация Trino (catalog/hive.properties)
connector.name=hive
hive.metastore.uri=thrift://metastore.example.com:9083
hive.s3.endpoint=http://minio.example.com:9000
hive.s3.access-key=MINIOACCESSKEY
hive.s3.secret-key=MINIOSECRETKEY
hive.s3.path.style.access=true
hive.s3.signing-version=2
## Пример конфигурации ClickHouse для использования MinIO как S3-хранилища
## storage_configuration в файле config.xml


    endpoint: http://minio.example.com:9000
    access_key_id: MINIOACCESSKEY
    secret_access_key: MINIOSECRETKEY
    use_environment_variables: 0
    scheme: http
Key takeaways
-
Федеративная аналитика с MinIO позволяет хранить данные в едином слое и выполнять вычисления на нескольких движках без массового переноса данных.
-
Архитектура должна обеспечивать согласованные каталоги метаданных, единые политики доступа и эффективную маршрутизацию запросов между Spark, Trino и ClickHouse.
-
Протоколы доступа и настройки безопасности (S3-совместимый API, TLS, IAM-политики) являются критически важными для управляемости и соблюдения регуляторных требований.
-
Эффективная интеграция требует планирования данных, раздельной структуры bucket-ов, а также продуманной схемы кэширования и фильтрации на уровне источников данных.
-
Оптимальная конфигурация достигается за счёт сочетания ETL-процессов на Spark, интерактивной аналитики через Trino и OLAP на ClickHouse, с BI-визуализацией поверх federated-слоя.
-
Мониторинг производительности должен охватывать задержки доступа к MinIO, планирование запросов, использование кэшей и качество данных.
-
Реальные кейсы показывают, что рациональная организация каталога, политики безопасности и правильная балансировка нагрузок существенно повышают скорость и надёжность кросс-платформенной аналитики.
FAQ
- Что такое федеративная аналитика и зачем она нужна в контексте MinIO?
Федеративная аналитика - это подход, при котором данные остаются в их исходных источниках, а вычисления выполняются над ними с объединением результатов. В контексте MinIO это означает, что данные хранятся в MinIO как в центре доступа, а Spark, Trino и ClickHouse работают над ними, обеспечивая эффективные запросы и гибкость в выборе движка под задачу. Такой подход снижает копирование данных, упрощает управление версиями и повышает прозрачность lineage, что особенно важно для регуляторных требований и аудита.
- Какие преимущества даёт использование MinIO как слоя хранения для федеративной аналитики?
MinIO обеспечивает S3-совместимый API, что позволяет использовать существующие клиенты и инструменты, не привязываясь к конкретному облаку. Это позволяет централизовать хранение, политики доступа, версионирование и аудит в едином месте, облегчает согласование каталогов и схем между движками, а также упрощает миграцию и масштабирование инфраструктуры.
- Какие проблемы наиболее часто возникают при интеграции Spark, Trino и ClickHouse с MinIO?
Частые проблемы связаны с согласованием схем и версий между каталогами, неправильной настройкой пути доступа и TLS, задержками из-за чтения больших объемов данных, неэффективным использованием predicate-pushdown, а также необходимостью поддержки согласованных политик безопасности и аудита на уровне нескольких движков.
- Как минимизировать задержки при федеративной аналитике?
Оптимизируйте планирование запросов, используйте predicate-pushdown и фильтры на уровне источников, применяйте раздельное хранение «сырого» и «обработанного» слоя, кэшируйте частые результаты, и размещайте вычислительные узлы ближе к данным или в той же сети, что снизит сетевые задержки.
- Как организовать безопасность и доступ к данным в федеративной среде?
Используйте централизованный IAM и политики на уровне объектов в MinIO, реализуйте TLS для передачи данных, применяйте path-style access при чтении через s3a, и гарантируйте согласованность схем через единый каталог метаданных. Регулярно проводите аудит доступа и версионирование объектов.
- Какие паттерны интеграции являются наиболее эффективными в реальных проектах?
На практике эффективны паттерны:
- ETL-подготовки на Spark с сохранением результатов в MinIO,
- интерактивная аналитика через Trino над MinIO-данными,
- OLAP-обработки через ClickHouse на подмножествах данных в S3-слое. Такой набор обеспечивает баланс между скоростью, гибкостью и масштабируемостью.
- Какие типовые конфигурации стоит рассмотреть для настройки доступа?
Обязательно настраивайте endpoint MinIO и ключи доступа в конфигурациях Spark, Trino и ClickHouse, используйте path-style access, отключите или обособьте SSL там, где сеть обязана быть внутри доверенной инфраструктуры, и включите версионирование объектов. Также применяйте секрет-менеджеры для динамической выдачи креденшиалов.
- Как избежать «случайной» несогласованности между движками?
Определите единый источник схем и категорий данных, используйте единый Hive Metastore или аналогичный каталог, и реализуйте процедуры синхронизации версий. Важно не смешивать разные версии схем в одном контексте запроса и поддерживать политику обновления метаданных.
- Каковы принципы паттернов мониторинга и диагностики?
Установите дашборды по задержкам доступа к MinIO, планированию запросов, загрузке кешей и качеству данных. Следите за сетевой пропускной способностью, балансировкой нагрузки и эффективностью predicate-pushdown. Организуйте алерты на отклонения в SLAs по времени выполнения и точности данных.
- Что считается лучшей практикой для внедрения федеративной аналитики в крупной организации?
Начните с детального проектирования каталога схем, политик доступа и политики версий, затем реализуйте пилотный кейс на одном домене данных. Постепенно расширяйте к другим доменам, добавляйте движки и BI-платформы, и применяйте подход «микрорефакторинга» для минимизации риска и быстрого извлечения уроков. В конце концов, вы получите устойчивую инфраструктуру, которая поддерживает гибкую, масштабируемую и безопасную кросс-платформенную аналитику.


