

Прокачайте корпоративные данные с ChatGPT: приложения нового поколения - Azure OpenAI и Cognitive Search
Меньше недели понадобилось ChatGPT от OpenAI, чтобы набрать миллион пользователей, число которых превысило отметку в 100 миллионов всего за два месяца. Интерес к этой технологии впечатляет. Пользователи по всему миру видят огромный потенциал в использовании этого чат-бота.
В контексте корпоративных приложений чаще всего мы слышим такой вопрос: «Как мне создать что-то вроде ChatGPT, которое использовало бы мои собственные данные в качестве основы для ответов?»
Комбинация Azure Cognitive Search и Службы Azure OpenAI предлагает эффективное решение данной задачи. Оно объединяет в себе корпоративные характеристики Azure, способность Cognitive Search индексировать, понимать и извлекать нужные фрагменты Ваших данных из больших баз данных, а также впечатляющие возможности ChatGPT для взаимодействия на естественном языке, чтобы отвечать на определенные вопросы или участвовать в беседе.
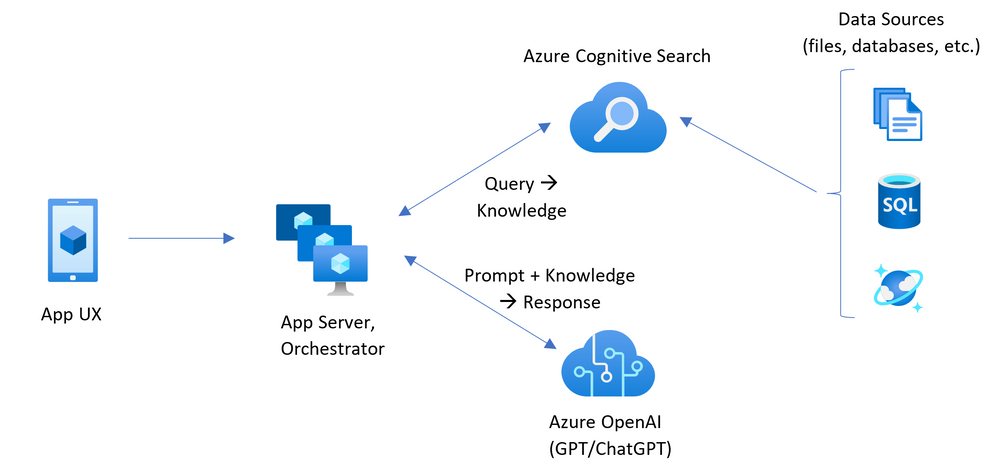
В этой статье мы подробно опишем упомянутое выше решение: от внутренней организации диалога и баз знаний до соображений пользовательского опыта, необходимых для того, чтобы помочь конечному пользователю правильно оценивать получаемые ответы. Наша цель состоит в том, чтобы дать Вам инструменты, необходимые для построения приложений на основе ChatGPT с использованием модели "gpt-35-turbo". Мы также делимся примерами на GitHub , включая UX, оркестрацию данных и т.д., которые Вы можете использовать для разработки Вашего собственного приложения или для более глубокого изучения темы.
Чат с Вашими собственными данными
Взаимодействие с большими языковыми моделями, такими как ChatGPT, основано на использовании естественного языка, «промтах» (подсказках модели) и запросов обработать эти подсказки. В данном случае ответы, которые Вы получаете, основаны на том, что модель узнала во время обучения, что может быть полезно в качестве общей информации, это не ответы, основанные на Ваших собственных данных. В качестве примера приводим чат ниже: сотрудник спрашивает о пакете медицинских услуг, при этом используется базовая модель ChatGPT; в данном случае ответ (выделен зеленым цветом) бесполезен, поскольку он не учитывает политику льгот компании, в которой работает данный сотрудник:
<|im_start|>system
Assistant helps Contoso Inc employees with their internal healthcare plan questions.
<|im_end|>
<|im_start|>user

Does my plan cover annual eye exams?
<|im_end|>
<|im_start|>assistant
I'm sorry, I'm not able to access your specific healthcare plan information. However, many healthcare plans do cover annual eye exams. I recommend checking your plan's summary of benefits or contacting your plan administrator for more information.
Один из способов заставить ChatGPT сгенерировать ответы на основе Ваших собственных данных достаточно прост и заключается в следующем: необходимо ввести эту информацию в промт. ChatGPT может прочитать информацию вместе с любыми инструкциями, контекстом или вопросами и ответить соответствующим образом. Этот подход не требует переобучения или тонкой настройки модели, а ответы могут немедленно отражать любые изменения в базовых данных.
Однако и здесь не все так просто: у этих моделей есть ограничение на «длину контекста», с которой они могут работать (текущая модель ChatGPT может принимать до 4000 токенов в промте), и даже если бы у них не было этих ограничений, было бы не целесообразно вводить данные в текстовую подсказку при каждом взаимодействии. Альтернативой является хранение всех данных во внешней базе знаний с возможностью быстро извлекать нужные фрагменты - именно для этого и был разработан Cognitive Search. Вот как может выглядеть промт и ответ:
<|im_start|>system
Assistant helps Contoso Inc employees with their internal healthcare plan questions. Only answer questions based on the fact listed below. If the facts below don't answer the question, say you don't know. Each fact sentence is numbered. Always include a reference to the fact number in the form [number] when you answer.
1. Employees have a choice of two plans, PlanA and PlanB, and they have different benefits.
2. PlanA includes coverage for annual eye and hearing exams.
3. Those with PlanB have a co-payment for routine eye exams and vision-related purchases such as glasses.
4. Both PlanA and PlanB cover preventive care visits.

<|im_end|>
<|im_start|>user

Does my plan cover annual eye exams?

<|im_end|>
<|im_start|>assistant

PlanA includes coverage for annual eye and hearing exams. [2]
В данном примере синяя часть была получена из Cognitive Search на основе вопроса пользователя и накопленного контекста, который может быть применим в данном случае, зеленая часть — это ответ, сгенерированный моделью, а остальное — это шаблон промта, который мы использовали в качестве инструкций для модели.
Такой подход дает возможность начать с простого и усложняться по мере необходимости. Существует множество вариантов того, как создавать промты, формулировать запросы для эффективного извлечения фрагментов из базы знаний и способов организации двустороннего взаимодействия между ChatGPT и базой знаний. Прежде чем углубиться в данную тему, давайте поговорим еще об одном важном пункте: пользователям нужно помочь проверить достоверность ответов, действительно ли они заслуживают доверия.
Генерация достоверных ответов
Мы считаем, что большие языковые модели, промты и системы оркестрации данных не идеальны, поэтому рассматриваем ответы, сгенерированные ими, как варианты ответов, содержащие информацию, которую сможет оценить конечный пользователь. В рамках изучения этой темы мы реализовали 3 простых способа валидации результатов. Это не значит, что они единственные; мы приветствуем и другие идеи и отзывы о том, как лучше всего предоставить пользователям более совершенные инструменты для проверки достоверности результатов, выданных системой.
Как Вы можете видеть на рисунке ниже, когда мы даем ответ в наших примерах, мы также предлагаем пользователю 3 инструмента валидации ответов:
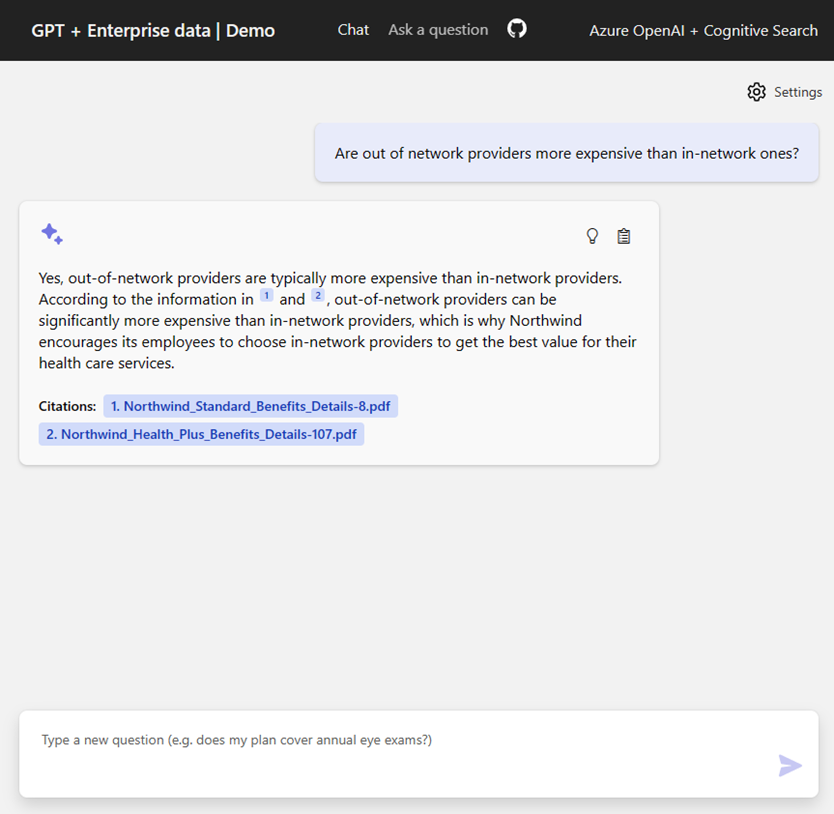
- Цитаты: каждое утверждение в ответе включает цитату со ссылкой на исходный контент. Вы можете увидеть цитаты в ответе (цифры в верхнем индексе), а также ссылки внизу. Когда Вы нажимаете на одну из них, отображается исходный контент, таким образом, пользователь получает возможность проверить достоверность полученного результата;
- Вспомогательный контент: каждый ответ или chat bubble, сгенерированный ChatGPT, имеет опцию (значок блокнота) для отображения всего исходного контента, который был отправлен в промт, как достоверные факты;
- Процесс оркестрации: также присутствует в каждом ответе (значок лампочки), с его помощью можно увидеть весь процесс взаимодействия модели с базой знани1, включая промежуточные результаты и сгенерированные подсказки.
Каждый из этих вариантов может быть (или не быть) полезным для пользователей в зависимости от аудитории. Существуют и другие варианты обеспечения прозрачности результатов и инструменты их проверки, чтобы пользователи могли быть полностью уверены в достоверности ответов. Мы рекомендуем разработчикам приложений подробно изучить эту тему в контексте каждого отдельного приложения.
Шаблоны взаимодействия
Подходов к более эффективному построению промтов, поисковых запросов, а также моделей взаимодействия между компонентами появляется все больше и больше. Это действительно широкое поле деятельности, где прогресс на лицо. Предлагаем Вашему вниманию список отправных точек для генерации промтов и запросов с ссылками на литературу для тех, кому интересно изучить данный вопрос глубже:
- Извлечь-затем-прочитать: простой подход для однократных сценариев «Вопрос-Ответ», где вопрос пользователя содержит достаточно информации для того, чтобы извлечь кандидатов из поискового индекса. На основе данного подхода выбираются топовые кандидаты и вставляются в промт наряду с инструкциями и самим вопросом;
- Прочитать контент и контекст перед извлечением: во многих случаях вопроса пользователя недостаточно для того, чтобы извлечь информацию из поискового индекса. Например, в диалогах последним выражением пользователя могут быть всего лишь несколько слов, представляющих собой последующее выражение или даже вопрос, которые невозможно использовать для эффективного извлечения информации. Необходимо учитывать весь контекст в целом. В этом случаем интересным подходом является использование ChatGPT для генерации поисковых запросов – необходимо попросить инструмент создать сводку разговора для учета любого контекста, который Вы хотите внедрить;
- Действия, инструменты и т.д.: зачастую одного взаимодействия между пользовательским вводом, промтами и базой знаний недостаточно. Например, доказано, что если попросить большие языковые модели разложить вопросы на маленькие шаги, это повысит качество ответов и позволит избежать шаблонных ошибок. После декомпозиции вопроса можно задавать более конкретные вопросы внешним источникам либо в виде неструктурированного поиска, как мы это делали до сих пор, либо в виде шагов «Вопрос-ответ» (например, семантические ответы в Cognitive search), либо в виде поиска во внешних системах (например, таблица сотрудников во внутреннем приложении или таблица происшествий в приложении поддержки клиентов). Это широкое поле для исследований, где в настоящее время проводится множество экспериментальных работ. Советуем почитать про цепочку рассуждений (CoT), про подход ReAct для комбинирования CoT с другими инструментами, а также про подход Toolformer, используемый для обучения моделей использованию множества инстрментов для генерации ответов.
Примеры, содержащиеся в данной статье, реализовывают некоторые из этих подходов, либо напрямую, либо через открытые библиотеки, такие как Langchain, например. В примере, приведенном ниже, видно, что после того, как пользователь написал, что «у меня план плюс», ответ на его следующий вопрос «покрывает ли мой план прием окулиста» при использовании подхода «извлечь-затем-прочитать» не совсем корректный, а вот при использовании более усложненного подхода с учетом всего контекста совсем другое дело – ответ исключительно по существу: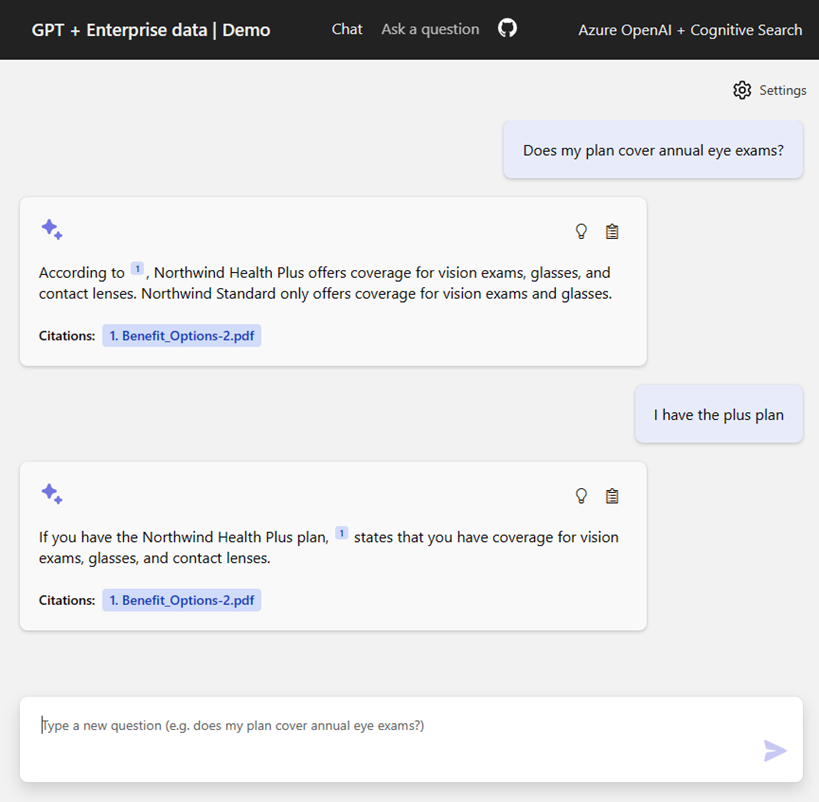
Улучшение поиска в базе знаний
Поскольку ответы в конечном счете основываются на том, что мы можем извлечь из базы знаний, качество поиска приобретает решающее значение. Вот несколько соображений по этому поводу:
- Семантическое ранжирование: по умолчанию Cognitive Search будет использовать поиск по ключевым словам в сочетании с простой вероятностной моделью. Вы можете включить семантическое ранжирование, которое будет использовать сложный вторичный слой ранжирования для повышения точности ответов;
- Фрагментация документа: при индексировании контента в Cognitive search для конкретной цели использования ChatGPT Вам нужен контент правильной длины. Если каждый документ будет слишком коротким, ему будет не хватать контекста. Если слишком длинный - трудно найти нужные части для «чтения». Мы рекомендуем настроить таргетинг на несколько предложений (например, от 1/4 до 1/3 страницы) со скользящим текстовым окном, если позволяют Ваши данные. В некоторых случаях, например, если речь идет о каталоге запчастей, разумно не разбивать данные на части, а сделать так, чтобы каждый документ содержал полное описание каждой детали;
- Резюмирование: иногда Вам может понадобиться уместить в промт больше кандидатов, сделав каждого из них короче. Вы можете сделать это, используя резюмирование. Например, Вам может подойти Semantic Captions (этап резюмирования в контексте запроса, поддерживаемый непосредственно в Cognitive Search), выделение совпадений или постобработку результатов поиска с помощью модели внешнего резюмирования.
Больше сценариев
В этой статье мы сфокусировались на диалогах и вопросах-ответах, которые сочетают в себе ChatGPT от Azure OpenAI и Azure Cognitive Search в качестве базы знаний. Существуют и другие опции, например, использование естественного языка для формулирования запросов, расширенные возможности просмотра каталогов и т.д. Мы планируем и дальше публиковать гайды и примеры, иллюстрирующие выполнение многих из этих задач.
Испытайте это сегодня, на Ваших данных или на наших
Мы опубликовали еще несколько примеров на GitHub. Собираемся и дальше пополнять эту страничку различными сценариями и примерами.
Вы можете использовать либо включенные образцы данных, либо свои собственные данные для того, чтобы потренироваться составлять приложения. Начните с загрузки того, что у Вас есть, и попробуйте.
Мы будем рады видеть улучшенные и совершенно новые сценарии, основанные на доступности больших языковых моделей в сочетании с технологией поиска информации. С нетерпением ждем Ваших результатов работы с Azure OpenAI и Azure Cognitive Search!