

Инфраструктура и развёртывание: облако, контейнеризация, инфраструктура как код и CI/CD
XBRL-отчётность из DWH требует повторяемого и воспроизводимого процесса развёртывания вычислительных пайплайнов: от инкапсуляции логики маппинга и таксономий до запуска проверки валидности и формирования финальных файлов. Глубокое проектирование инфраструктуры обеспечивает не только скорость и масштабируемость, но и соблюдение регуляторных требований, аудита и контроля качества данных. В этой главе рассмотрены архитектурные концепции, практики облачных платформ, подходы к контейнеризации, инфраструктуру как код и интеграцию CI/CD, ориентированные на устойчивые решения в рамках корпоративной цифровой трансформации.
Краткое введение
Современная инфраструктура XBRL-пайплайна строится вокруг идеологии «инфраструктура как код» и «как можно меньше ручного операционного труда» в сочетании с управляемыми облачными сервисами. Это позволяет обеспечить воспроизводимость, аудитируемость и ускорение цикла выпуска финансовой отчетности. В рамках главы дано систематизированное видение архитектуры, выбор технологических слоёв, схемы взаимодействий между компонентами и примеры практических подходов к реализации и эксплуатации.
- Архитектура развёртывания XBRL‑пайплайна: компоненты, каналы данных, контроль версий и воспроизводимость.
- Облачная инфраструктура и сервисы: выбор платформы, хранение таксономий, режимы безсерверной обработки и безопасность.
- Контейнеризация и оркестрация: упаковка процессов маппинга, валидации и формирования XBRL‑файлов, управление окружением.
- Инфраструктура как код: описания сред, управление секретами, контроль политик и совместимость с существующими корпоративными процессами.
- CI/CD для XBRL‑отчетности: пайплайны тестирования маппинга, валидации таксономий, развёртывания и регрессионного тестирования.
- Безопасность, аудит и качество данных: контроль доступа, отслеживание изменений, воспроизводимость и соблюдение нормативов.
Архитектура развёртывания XBRL‑пайплайна
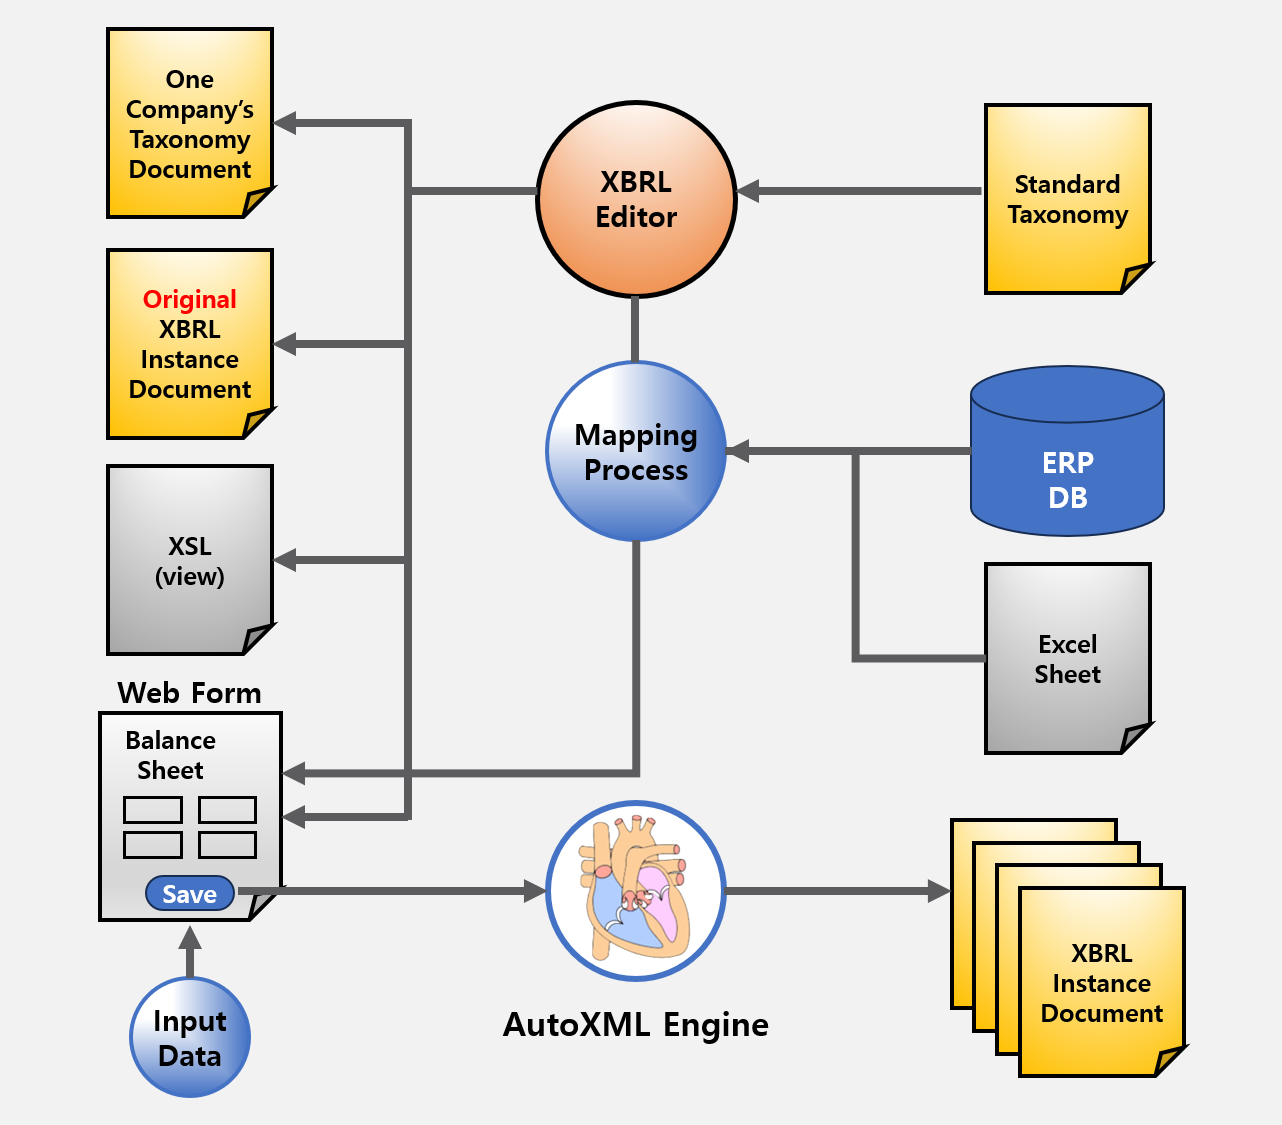
Архитектура такого пайплайна должна обеспечивать четкое разделение ролей: сбор исходников маппинга и таксономий, преобразование и упаковку в XBRL, проверку валидности и подготовку финальных документов. Ключевые элементы - это репозитории маппингов и таксономий, сервисы конвейеров обработки, хранилище артефактов и ортогональные слои обеспечения качества.
Первый аспект - модульность. Разделение на независимые сервисы снижает риск изменений в одном компоненте влиять на весь пайплайн. Второй аспект - воспроизводимость. Все стадии должны быть детерминированы и возвращать одинаковые результаты на разных окружениях при идентичных входах. Третий аспект - безопасность и аудит. Логи аудита, неизменяемость артефактов и контроль версий критически важны для регуляторных требований к XBRL.
Системная логика обычно строится вокруг следующих слоёв: источник данных (DWH/хранилища данных), слой трансформации (мэппинг, таксономии, правила бизнеса), слой валидации и формирования файлов, слой хранения и выдачи готовой XBRL‑отчетности. Коммуникация между этими слоями должна происходить через четко определённые API и сообщения (например, события в очередях или запросы к сервисам). Важнейшие требования: идемпотентность операций, детальная трассируемость и возможность отката до предыдущей версии таксономий и маппингов.
С точки зрения алгоритмов и протоколов, эффективная архитектура опирается на:
- версионирование маппингов и таксономий как первых граждан пайплайна;
- схему событийного взаимодействия (например, события об изменении данных в DWH → триггеры запуска процесса маппинга → формирование XBRL‑инстанса);
- строгие контрактные интерфейсы между компонентами (OpenAPI/ gRPC);
- отчётливо прописанные политики обработки ошибок и повторного выполнения.
## Пример концептуального взаимодействия компонентов
## - Компонент A: загрузчик Taxonomy (S3/Blob storage)
## - Компонент B: маппинг-сервис
## - Компонент C: валидатор и упаковщик XBRL
## - Компонент D: артефакт-репозиторий и аудит
Разделение по слоям помогает также управлять зависимостями между таксономиями и версиями бизнес‑правил. В сложном корпоративном окружении возможно применение паттерна «feature flags» для безопасного внедрения новых версий маппинга без риска сломать регламентируемую отчетность.
Облачная инфраструктура и сервисы
Современная облачная инфраструктура должна обеспечивать гибкость, масштабируемость и соответствие требованиям регуляторов, включая хранение таксономий и версий маппингов в географически подходящих регионах. В качестве базовых решений применяются облачные объекты хранения (S3-совместимый объект‑хранитель), управляемые контейнерные сервисы и консолидированные слои управления безопасностью. Поддержка нескольких облачных провайдеров - разумная стратегия для снижения рисков зависимости и обеспечения локального соответствия (например, в рамках российского сегмента, где допустимы решения на базе Yandex.Cloud).
Ключевые принципы:
- разделение рабочих сред: dev/stage/prod с различными данными наборами и правами доступа;
- хранение таксономий и маппингов в управляемом объектном хранилище с версионированием и политиками жизненного цикла;
- использование управляемых сервисов для оркестрации задач и обеспечения устойчивой производительности;
- детальная регламентация сетевой сегментации, мониторинга и аудита.
Облачная платформа определяется не только по функциональности, но и по операционной практике: где хранятся ключи и секреты, как осуществляются мониторинг и резервное копирование, как реализуется высокодоступное развертывание и как осуществляется регламентированная документация изменений. В рамках реальных проектов часто встречаются три шаблона:
- гибридная архитектура: критически важные данные и таксономии размещаются в облаке провайдера организации, вычислительные сервисы - в управляемом кластере;
- мультиоблачная архитектура: разные окружения для разных географий, с единым набором пайплайнов через общие интерфейсы;
- локально-облачная архитектура: часть процессов выполняется на защищённой инфраструктуре внутри корпоративного периметра с интеграциями в облако через безопасные каналы.
Примеры технологий и продуктов: Kubernetes как оркестратор контейнеров, S3‑совместимое хранение, управляемые услуги очередей или потоков данных. В качестве открытых решений можно упомянуть Kubernetes и Terraform; в контексте российского сегмента - Yandex.Cloud как реальный пример локализации облачных сервисов и соответствия региональным требованиям. Важно помнить, что выбор платформы не ради красы архитектуры, а ради доступности критических сервисов, долговременного хранения артефактов и устойчивости к сбоям.
Контейнеризация и оркестрация
Контейнеризация позволяет упаковать логику маппинга, валидатора и генератора XBRL в изолированные окружения, обеспечивая переносимость между различными средами и ускорение развёртывания. Основной рабочий набор включает образ процессора маппинга, валидатора и упаковщика, вспомогательные сервисы для очередей сообщений, кэширования и доступа к таксономиям, а также инструменты мониторинга.
Рекомендованная практика:
- создание минимальных, многоступенчатых Docker‑образов, где на стадии сборки извлекаетч из исходников только необходимый функционал;
- использование версий образов и строгого контроля зависимостей;
- настройка сетевых политик и ограничений ресурсов (requests/limits), чтобы избежать «шоков» в периоды пиковых загрузок;
- автоматизация обновления таксономий через внешние артефакты и безопасное применение обновлений с откатом;
- применение операторов Kubernetes для управления жизненным циклом сервисов, обновлениями и мониторингом.
Ключевые практики:
- репликация сервисов в разных пространствах имён (namespaces) и отделение данных о маппинге, таксономиях и результатах;
- безопасная интеграция с секретами через секрет‑менеджеры или Kubernetes Secrets, желательно с шифрованием на «передаче» и «хранении»;
- обеспечение детектируемого поведения в случае сбоев: лёгкий откат к предыдущей версии маппинга.
## Пример минимального Dockerfile для одного из сервисов пайплайна
FROM openjdk:17-jdk-slim as build
WORKDIR /app
COPY . .
RUN ./gradlew clean build -x test

FROM openjdk:17-jre-slim
## WORKDIR /app
COPY --from=build /app/build/libs/xbrl-processor.jar .
ENTRYPOINT ["java","-jar","xbrl-processor.jar"]
Облачная оркестрация приносит устойчивость к сбоям и облегчает масштабирование. Kubernetes позволяет задать горизонтальное масштабирование, политики обновления и устойчивость к сбоям через readiness и liveness пробы, распределение трафика через сервисы и ingress, а также управление конфигурациями через ConfigMaps и Secrets. Важной частью является мониторинг и логирование: сбор метрик (Prometheus), централизованный лог (ELK или EFK‑стек) и трассировка (Jaeger/Zipkin). В контексте XBRL‑пайплайна внимание уделяют задержкам между загрузкой данных и выдачей финального файла, чтобы не нарушать регуляторный график.
Инфраструктура как код: управление средами
IaC позволяет автоматизировать создание и изменение инфраструктурных окружений, обеспечивая повторяемость, аудит и контроль версий. Terraform, как один из наиболее распространённых инструментов, обеспечивает декларативное описание состояний: вычислительные ресурсы, хранилище, сеть и политики доступа. В рамках корпоративной практики рекомендуются следующие принципы:
- модульность: раздельные модули для отображения среды (dev/stage/prod), секрета, сетей и ресурсов хранения;
- управление состоянием: удалённое состояние с блочнымованием, а также хранение состояний в безопасных backend‑хранилищах;
- секреты и ключи: интеграция с Vault/Key Management System (KMS) без прямого хранения секретов в коде;
- политики и соответствие: использование инструментов политики как кода (OPA) для предиктов раннего вкуса и предотвращения несоответствий;
- миграции окружений: поддержка сценариев миграции между версиями таксономий и маппинга без прерывания выпуска.
## Пример Terraform – создание S3‑совместимого хранилища и версииBucket
provider "aws" {
  region = "eu-west-1"
}
resource "aws_s3_bucket" "taxonomy_repo" {
  bucket = "xbrl-taxonomy-repo-prod"
  versioning {
    enabled = true
  }
  server_side_encryptionConfiguration {
    rule {
      apply_server_side_encryption_by_default {
        sse_algorithm = "AES256"
      }
    }
  }
}
Требуется особое внимание к управлению зависимостями между маппингами и таксономиями. В рамках крупных проектов целесообразно внедрять централизованный реестр версий, связывающий конкретную версию таксономии с соответствующей версией маппинга и конфигурацией пайплайна. Это способствует воспроизводимости и позволяет оперативно откатывать изменения в случае регуляторного запроса или обнаружения несоответствий.
CI/CD для XBRL‑отчетности
CI/CD для XBRL‑пайплайна должен охватывать полный цикл: сборку артефактов, тестирование маппинга и таксономий, валидацию XBRL-инстансов, упаковку в артефакт и развёртывание на целевое окружение. Важны следующие элементы:
- инфраструктура как код как часть пайплайна: развертывание тестовых окружений и изоляция данных;
- автоматическое тестирование: тест-кейсы на соответствие таксономий, проверку точности маппинга, регрессионные тесты по новым версиям;
- валидация XBRL: использование открытых инструментов для проверки схем, контекстов, единиц измерения и ссылок на таксономии (например, валидаторы и процессоры XBRL);
- управление артефактами: хранение собранных образов, конфигураций и версий таксономий в артефактном хранилище;
- регламент выпуска: строгие процедуры утверждения версий и откатов, журналирование изменений.
Типичная реализация CI/CD включает следующие шаги: сборка контейнера сервиса маппинга и валидатора, запуск локальных тестов, выполнение проверки соответствия маппинга и таксономий, прогон регрессионных тестов на тестовом окружении, публикация образа в реестр, развёртывание на стейдж или продакшн после прохождения контроля качества, и создание аудируемого лога выпуска.
## Пример GitHub Actions workflow для CI/CD XBRL пайплайна
name: xbrl-pipeline
on:
  push:
    branches: [ main ]
jobs:
  build-and-test:
    runs-on: ubuntu-latest
    steps:
      - **name**: Checkout
        uses: actions/checkout@v3
      - **name**: Build Docker image
        run: |
          docker build -t xbrl-processor:latest .
      - **name**: Run unit tests
        run: |
          docker run --rm xbrl-processor:latest mvn -q -Dtest=*Tests test
      - **name**: Push image
        if: github.ref == 'refs/heads/main'
        run: |
          docker tag xbrl-processor:latest myregistry.example.com/xbrl-processor:prod
          docker push myregistry.example.com/xbrl-processor:prod
      - **name**: Deploy to Prod
        if: github.ref == 'refs/heads/main'
        uses: some-deploy-action@v1
        with:
          image: myregistry.example.com/xbrl-processor:prod
Важной частью является интеграция тестирования маппинга и валидации таксономий в рамках пайплайна. Это позволяет обнаружить несовместимости между версией маппинга и обновлениями таксономии до того, как они дойдут до регуляторной отчетности. Рекомендуется применение тестовых наборов, которые охватывают:
- проверку соответствия контекстов и единиц измерения;
- сверку структуры инстансов XBRL против Expected Taxonomy;
- проверку согласованности версий между маппингами и таксономиями.
Безопасность, аудит и качество данных
Безопасность и аудит становятся частью инфраструктуры, а не отдельной инициативы. Основные принципы включают минимальные привилегии, управление секретами и детальную трассируемость изменений. В структуре пайплайна необходимо предусмотреть:
- управление доступом через роли и политики (RBAC) на уровне Kubernetes, CI/CD и облачных сервисов;
- безопасное хранение секретов: секреты, зашифрованные в покое и в передаче, интеграция с Vault или cloud‑secret manager;
- аудит и журналирование: неизменяемые логи операций, привязка каждого артефакта к версии и пользователю;
- репродукцию: возможность воспроизвести конкретную версию окружения и конфигурацию в любой момент времени.
Контроль качества данных не ограничивается валидаторами XBRL. Включается проверка качества входных данных, консистентности сопоставлений и гарантии того, что выпуск не повредит регуляторные рамки. Непрерывная доставка должна поддерживать «плавное» обновление таксономий и маппингов без деградации производительности, поэтому важна отдельная дорожная карта миграций и тестирования в отдельных средах.
Key takeaways
- Эффективная инфраструктура XBRL‑пайплайна строится на четком разделении слоев: данные → маппинг/таксономия → валидация → формирование XBRL → аудит и публикация.
- Выбор облачных сервисов должен учитывать хранение таксономий, географическую локализацию и регуляторные требования к данным.
- Контейнеризация обеспечивает переносимость и масштабируемость; orchestration‑платформа (Kubernetes) позволяет управлять жизненным циклом сервисов и обновлениями.
- Инфраструктура как код обеспечивает повторяемость, аудит и контроль версий, снижает риск человеческих ошибок и ускоряет внедрение изменений.
- CI/CD для XBRL требует интеграции тестирования маппинга и валидации таксономий в каждый выпуск, а также надёжного контроля артефактов и версий.
- Безопасность и аудит являются составной частью пайплайна: минимальные привилегии, управление секретами, детальная трассируемость и возможность отката к прошлым версиям.
- Важно обеспечить воспроизводимость окружения и возможность отката: каждое изменение таксономий или маппингов должно быть неразрывно связано с версией пайплайна и регистрацией изменений.
FAQ
- Какие факторы выбирать при выборе облачной платформы для XBRL‑пайплайна?
- При выборе платформы следует учитывать регуляторные требования к локализации данных, доступность безопасного хранения версий таксономий, возможность масштабирования вычислительных мощностей под пики отчетности и интеграцию с существующей корпоративной ИТ‑инфраструктурой. В реальном мире гибридные или мультиоблачные решения помогают минимизировать риски зависимости от одного провайдера и обеспечивают устойчивость к регуляторным изменениям. Практически это означает выбор облачного провайдера, который обеспечивает надлежащий набор управляемых сервисов (object storage, managed Kubernetes, secret management) и совместимость с открытыми стандартами для маппинга и XBRL.
- Какие подходы к воспроизводимости сборки и развёртывания предпочтительны?
- Ключевые практики - использование IaC и контейнеризации. Центральным является хранение конфигураций и артефактов в системах контроля версий и удалённых backend‑хранилищах с поддержкой версионирования. Убедитесь, что каждый шаг пайплайна детектирует и регистрирует версии маппингов и таксономий, а также поддерживает откат до предыдущей версии без потери данных.
- Как организовать управление секретами в рамках CI/CD?
- Рекомендуется хранить секреты во внешних секрет-менеджерах (Vault, облачный KMS) и предоставлять их пайплайнам через временные креденшиалы или интерфейсы API, не записывая секреты в логи и артефакты. Доступ к секретам должен быть ограничен ролью и периодически пересматриваться по принципу наименьших привилегий.
- Как обеспечить мониторинг и аудит процессов XBRL‑пайплайна?
- Необходимо центральное логирование, трассировка и сбор метрик времени ответа на каждом этапе. Логи должны быть неизменяемыми и привязанными к конкретной версии артефактов и пользователей. Мониторинг задержек между загрузкой данных и готовыми выходами критичен для регуляторных графиков.
- Какие тесты следует включить в пайплайн для проверки маппинга и таксономий?
- Тесты должны покрывать соответствие контекстов, единиц измерения и ссылок на таксономии. Регрессионные тесты на новые версии таксономий и маппингов предотвращают несовместимости. В рамках CI/CD желательно запускать открытые XBRL‑валидаторы и тестовые кейсы на наборе входных данных, близком к реальному.
- Как избежать риска регуляторных штрафов при обновлениях таксономий?
- Вводите версионирование таксономий и связывайте каждую версию с конкретной версией маппинга и пайплайна. Реализуйте строгие процедуры тестирования перед выпуском. Позволяйте откатываться к предыдущей рабочей версии и фиксируйте все изменения в регистре изменений.
- Какие риски связаны с мультиоблачной архитектурой и как их снижать?
- Основные риски включают различия в API, несовпадение интерфейсов и сложность согласования политик безопасности. Снижайте риски через единые контракты между сервисами, использование общих протоколов и стандартов, унифицированные образы и централизованный мониторинг.
- Какие практики обеспечения доступности и отказоустойчивости особенно важны?
- Разграничение окружений, географически распределённые кластеры, автоматическое масштабирование и регулярное тестирование аварийных сценариев. Важно иметь предусмотренный план отката и резервное копирование ключевых артефактов таксономий и маппингов.
- Как организовать миграции старых процессов в новую инфраструктуру?
- Разработайте дорожную карту миграции, включающую параллельное функционирование старых и новых пайплайнов, поэтапный переход на новые артефакты и тщательное тестирование на стейдж‑окружении перед выпуском. Документируйте каждую фазу миграции и поддерживайте обратную совместимость.
- Какая роль документации в инфраструктуре XBRL‑отчётности?
- Документация должна охватывать архитектурные решения, требования к средам, процедуры обновления таксономий и маппингов, политики секьюрити, регламенты аудита и инструкции по развёртыванию. Хорошая документация облегчает обучение сотрудников, ускоряет внедрение новых версий и обеспечивает устойчивость к кадровым изменениям.


