

Грани и уровни гранулярности: от детализированного к сводному
Гранулярность фактов - базовый параметр любой аналитической архитектуры. Она определяет, как детализированы данные, какие вопросы можно качественно ответить, и какие требования к производительности и управляемости будут предъявлены к системе. Неправильно выбранный уровень гранулярности приводит к противоречивым выводам, устаревшим агрегатам и избыточной сложности моделей. В рамках данной главы рассматриваются концептуальные основы гранулярности, архитектурные решения и практические подходы к внедрению, которые позволяют сохранить нужную бизнес-смысловую нагрузку данных при устойчивой производительности и управляемости.
В условиях быстрого роста объемов данных и разнообразия источников правильное соотношение детальности и сводности становится критерием конкурентоспособности. Внимание уделяется не только техническим механизмам, но и организационным практикам: ответственность за гранулярность распределена между доменами, вокруг данных формируются контракты и версии, а аналитика строится как продукт с ясной целью и владением. В финале главы приведены практические паттерны, сценарии внедрения и блок вопросов-ответов, помогающих удерживать аналитику от перегибов и противоречий.
- Определение грани и детализации: как грамотно отделять детальное событие от агрегированной сущности.
- Архитектурные схемы и модели: когда применять звезды, снежинки и хранилища lakehouse, как совмещать факты и измерения.
- Интеграция и управление изменениями: как обеспечивать совместимость источников, версионность и контроль качества.
- Практические паттерны и кейсы: типовые сценарии, которые помогают не «переломать» аналитику при росте данных.
Концептуальные основы гранулярности
Гранулярность фактов характеризует детальность событий, измерений и преобразований, которые хранятся в аналитическом окружении. В бизнес-терминах это означает способность отвечать на вопросы на разной глубине: от конкретной транзакции до сводного уровня за месяц или год. Ключевые термины здесь - "grain" и "granularity". Гранулярность задаёт набор полей, которые образуют уникальный факт в таблице фактов, и определяет, какие агрегации допустимы без потери смысловой точности.
- Гранулярность как контракт: она должна быть формализована на стадии ввода данных. Контракт описывает набор ключевых полей, наличие или отсутствие измерений, типы временных метрик и допустимые уровни агрегации.
- Влияние на метрики и валидность аналитики: слишком детализированные данные могут усложнить вычисления и привести к шуму в отчётах; слишком агрегированные - к потере контекста и дрессированию решений.
- Декларация фактов и размерность: фактовая таблица обычно имеет фиксированный grain, а размерности должны быть согласованы (conformed) для возможности сравнения и соединения разных доменов.
- Сложности сочетания источников: различные системы часто имеют разную гранулярность. Необходимо предусмотреть «канонический» уровень, к которому приводятся источники, и механизмы согласования изменений.
Чтобы иллюстрировать концепцию, рассмотрим простой пример. В онлайн-ритейле деталью может служить факт на уровне строки заказа (order_line) с полями: order_id, line_id, product_id, quantity, price, event_ts. Такой уровень позволяет получать точные данные по каждому товару в рамках каждой позиции заказа. Однако для аналитики на уровне дня и продукта может потребоваться агрегировать по day, product_id. В таком случае рационально держать базовый гранулярности как атомарный факт и дополнительно создавать агрегаты на ключевых уровнях (день, продукт, регион и пр.). Важно, чтобы агрегации соответствовали бизнес-вопросам и учли зависимые параметры - например сезонность, акции и изменения цен.
- Различие между атомарной и сводной грануляцией требует продуманного дизайна: атомарный уровень обеспечивает полноту, сводный - быстродействие и понятность.
- Важно сохранять возможность Drill-Down: аналитики должны иметь возможность подробно исследовать данные, если бизнес вопросы требуют детализации.
- Контроль согласованности: когда появляются новые источники или модификации правил агрегации, необходимы процедуры тестирования и регламент обновления.
Архитектура данных и схемы: как устроена гранулярность на уровне моделей
Архитектурно гранулярность реализуется в наборе моделей и схем, которые позволяют сохранять баланс между точностью и производительностью. Классические решения - звездообразная (star) и снежинка (snowflake) схемы, где факт-таблица держит определённый grain, а размерности содержат кросс-доменные символы, помогающие аналитикам формулировать группы и показатели. В современных условиях также применяются lakehouse-подходы и форматы таблиц типа Apache Iceberg или Delta Lake, которые поддерживают версионность, схему эволюцию и эффективное управление большими наборами данных.
- Факт-таблица и базовый grain: в рамках архитектуры определите уникальный набор ключей, который однозначно идентифицирует каждую запись факта. Для разных доменов этот набор может быть разным: продажи, логистика, взаимодействие с клиентами и пр.
- Дименсионные модели и конформированные размерности: единые «пользователь», «продукт», «регион» и пр. позволяют объединять факты из нескольких источников без потери смысла.
- Эволюция схемы и версия данных: в рамках больших проектов необходимы механизмы изменений схемы, где новая версия grain может добавлять поля или менять правила агрегации, но сохранять обратную совместимость.
- Управление временем: временные границы требуют чёткого определения роли времени - event_ts, transaction_date и т. д. При этом важно учитывать временные зоны и локализацию, чтобы агрегирования соответствовали бизнес-циклами.
Архитектурные паттерны включают:
- Canonical grain как базовый слой: атомарные записи с фиксированным grain, доступные для создания дополнительных агрегатов.
- Materialized views и pre-aggregation: создаются на основе канонического grain и служат для ускорения запросов без потери точности.
- Data vault как средство справляться с изменениями источников: отделяет изменения в источниках от бизнес-логики аналитики и упрощает миграции.
- Lakehouse по принципу schema-on-read и schema-on-write в зависимости от источника: гибкость для интеграции новых источников и стабильность для производства отчетности.
В качестве наглядного примера рассмотрим схему для ситуации с многоканальными продажами: онлайн-магазин, офлайн-точки продаж и мобильные каналы. Базовый факт может быть организован в виде таблицы фактов продаж на grain (order_id, line_id, product_id, store_id, channel_id, event_ts). Отдельно формируются агрегаты по дням, по регионам, по продуктам и по каналам. Разделение grain на атомарный и агрегатный позволяет не перегружать вычисления в режиме реального времени и сохранять гибкость для аналитики.
- Важная часть архитектуры - протоколы интеграции и качество данных: контракт на входе, DAT CONTRACTS, минимальные наборы обязательных полей, единые форматы дат и идентификаторов.
- Необходимо обеспечить согласование между источниками: если один источник обновляется более часто, чем другой, механизм консолидации должен учитывать задержку и временной сдвиг.
- Версионность: каждая итерация таблиц фактов и размерностей должна сопровождаться версией схемы и автоматическими тестами на совместимость.
## Пример: упрощённая схема для атомарного grain в SQL-подходе
CREATE TABLE fact_sales_atom (
  order_id BIGINT,
  line_id INT,
  product_id INT,
  store_id INT,
  channel_id INT,
  event_ts TIMESTAMP,
  quantity INT,
  price DECIMAL(10,2),
  total DECIMAL(12,2),
  PRIMARY KEY (order_id, line_id)
);

-- Пример агрегирования по дню и продукту
CREATE MATERIALIZED VIEW mv_daily_product AS
SELECT
  DATE(event_ts) AS day,
  product_id,
  SUM(quantity) AS total_quantity,
  SUM(total) AS revenue
FROM fact_sales_atom
GROUP BY DATE(event_ts), product_id;
Такие примеры демонстрируют, как можно держать канонический уровень данных и поддерживать быстрое аналитическое представление за счёт материализованных представлений, которые соответствуют конкретной бизнес-задаче.
Алгоритмы выбора уровня гранулярности и протоколы интеграции
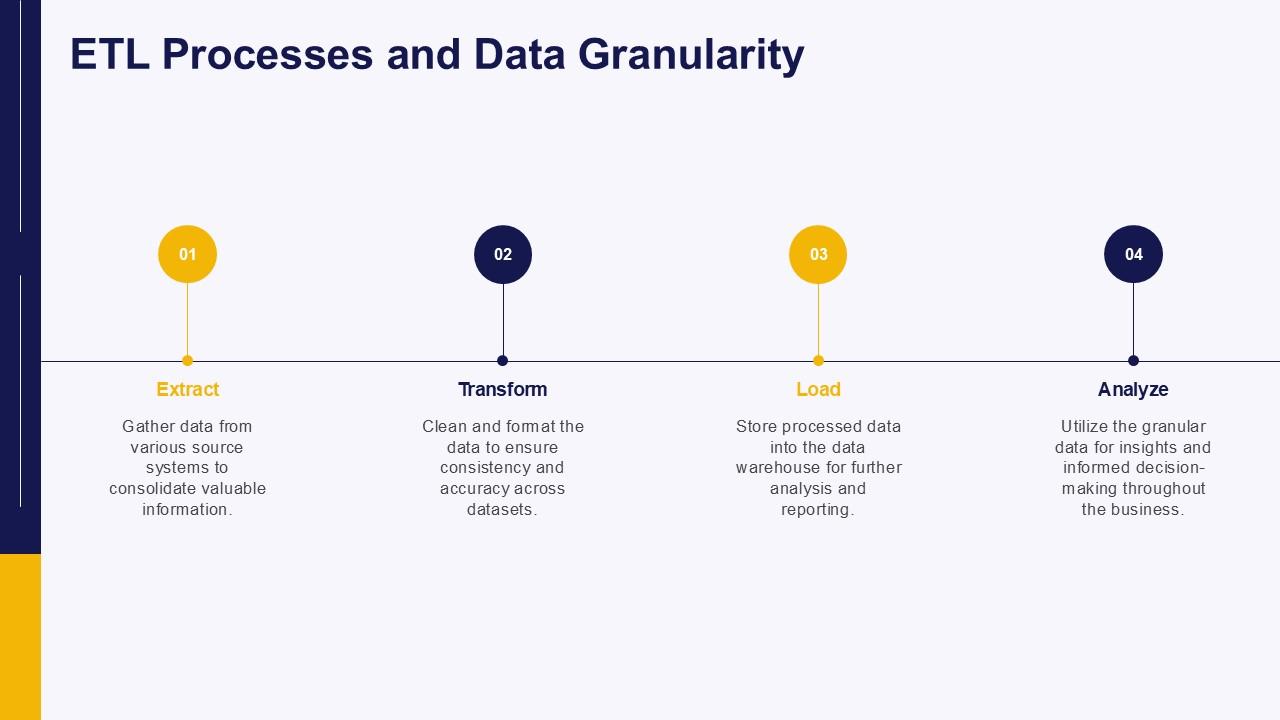
Опора на четкий алгоритм выбора уровня гранулярности позволяет минимизировать риски несоответствия между потребностями бизнеса и техническими возможностями. Этапы можно представить в виде последовательности решений и проверок.
-
Идентификация бизнес-вопросов и сценариев использования.
- Определите, какие вопросы аналитики должны быть решены в ближайшие 3-6 месяцев и на какие вопросы требуется drill-down.
- Разделите вопросы на категории: операционные, управленческие, стратегические.
-
Определение необходимых метрик и атрибутов.
- Выделите набор мер (quantities, revenues, margins) и атрибутов (product_id, store_id, region, channel).
- Уточните, какие меры являются детерминированными (например, цена продажи) и какие требуют агрегационных подходов (например, скользящие средние).
-
Установление базового grain.
- Выберите канонический уровень, который обеспечивает полноту источников и постоянство точности. Он может быть атомарным (например, event-level) или полутезисным (например, order-level с деталями позиции).
- Учитывайте частоту обновления источников и требования к задержке.
-
Определение ключей и группировок для агрегаций.
- Определите набор полей для группировки в сводных таблицах (day, product_id, region и т. д.).
- Оцените влияние на расчеты: какие агрегаты нужны в реальном времени, какие - в пакетной обработке.
-
Планирование версий и эволюции схем.
- Разработайте стратегию эволюции схемы: как добавлять новые поля, как поддерживать обратную совместимость.
- Введите систему контроля изменений, включая регрессионное тестирование и мониторинг.
-
Интеграционные протоколы и данные-контракты.
- Зафиксируйте требования к формату данных, обработке ошибок и задержках.
- Обеспечьте совместимость различных источников через канонический уровень.
-
Управление качеством и тестирование гранулярности.
- Разработайте тест-кейсы на согласованность агрегаций, сравнение atomic и aggregated представлений, проверку временной непротиворечивости данных.
-
Инструменты и операционные практики.
- Применяйте CI/CD для моделей данных, регистрируйте версии схем и контроля качества, используйте тестовые окружения и датасеты-демонстрации.
Чтобы конкретизировать концепции, рассмотрим сценарий многоканальных продаж. Если бизнес-задача требует анализа по дням и регионам, можно выбрать базовый grain как atomic для событий (order_line) и затем строить агрегаты: daily_sales_by_product, daily_sales_by_store, regional_revenue_summary и т. д. В случае, когда требуется сравнение по месяцам и группам клиентов, можно внедрить дополнительный агрегат по месцу и сегментам клиентов, сохранив атомарный уровень как источник правды.
- Важно помнить о зависимости между грануляциями: агрегаты должны ссылаться на конформированные размерности и поддерживать идентификаторы, чтобы корректно агрегировать данные из разных доменов.
- Роли и ответственности: бизнес-длои** - формулировка вопросов, инженерия - реализация и поддержка гранулярности, аналитика - верификация и интерпретация изменений.
- Управление изменениями: тщательно документируйте изменения грануляции, тестируйте влияние на существующие отчеты и дашборды, планируйте миграцию с минимальным прерывающим временем.
Если проект требует поддержки разных источников с различной гранулярностью, целесообразно применить следующий подход: держать чистый канонический grain и реализовать адаптеры входящих источников, приводящие их к каноническому уровню, а затем строить агрегаты на этом уровне. Такой подход минимизирует риск «разрыва» в аналитике и упрощает последующую эволюцию источников и моделей.
## Пример алгоритма сопоставления грани в рамках ingestion-пайплайна
def map_to_canonical_grain(source_record, canonical_grain_keys):
    """
    source_record: словарь с данными из источника
    canonical_grain_keys: набор ключевых полей канонического grain, например
        ['order_id', 'line_id', 'product_id', 'store_id', 'event_ts']
    """
    grain = {k: source_record.get(k) for k in canonical_grain_keys}
    ## Принудительная нормализация времени
    if isinstance(grain.get('event_ts'), str):
        grain['event_ts'] = parse_timestamp(grain['event_ts'])
    ## Проверка наличия обязательных полей
    missing = [k for k, v in grain.items() if v is None]
    if missing:
        raise ValueError(f"Missing fields for canonical grain: {missing}")
    return grain
Такой код иллюстрирует связь между источниками и каноническим уровнем данных. Реализация может быть гораздо более сложной в реальных системах, но базовый подход - гарантировать, что каждый источник приводится к единому grain и временному пространству с минимальной потерей информации.
Внедрение и эксплуатация: процессы и организационные изменения
Успешное внедрение гранулярности требует не только технических решений, но и управленческих практик и процессов. Ключевые элементы:
- Ответственности и роли: выделение роли Data Product Owner (DPO) для каждого домена, Data Engineer как исполнитель архитектуры гранулярности, Data Steward за качество и соответствие, аналитик как пользователь материала.
- Контракты на данные: формализованные договоры между поставщиком данных и потребителем. Контракты должны охватывать гранулярность, частоту обновления, ограничения на время задержки, требуемые поля и валидность.
- Версионирование схем: каждое изменение grain сопровождается версией схемы и тестами совместимости. Это снижает риск сломанных дашбордов и неподдерживаемых приложений аналитики.
- Управление качеством данных: dashboards по качеству данных, мониторинг задержек, пропусков и несостыковок между atomic и aggregated уровнями. Вводится SLA по доступности и полноте данных.
- Инструменты и процессы CI/CD: автоматическая проверка изменений в моделях данных, тестирование регрессионных сценариев, автоматическое развёртывание миграций схем и материалов, включая обновления в материализованных представлениях.
- Безопасность и доступ: учёт гранулярности в политике доступа. Более детальная гранулярность может потребовать ограничений на просмотр отдельных уровней данных на основе ролей.
Практическая реализация обычно включает организация data canvas и постановку задач в рамках data platforms. В современных условиях важно рассмотреть возможность использования "lakehouse"-платформ и инструментов версионирования схем, например, через механизм схем-реестров и паттернов для управления изменениями. Принципы остаются теми же: минимизация дубликатов, избегание противоречий между источниками и поддержка устойчивых сценариев анализа.
Паттерны реализации и кейсы
- Паттерн «канонический grain с набором агрегатов»: базовый атомарный grain сохраняется как источник истинности, а для бизнес-потребностей создаются агрегаты на уровне дня, региона, продукта и канала. Это сохраняет целостность данных и ускоряет оперативную аналитику.
- Паттерн «многоуровневые представления»: помимо фактов** - создаются декларированные представления для разных ролей пользователей, которые отражают их задачи: операционные операторы видят детальную загрузку, менеджеры - агрегаты по дням, а топ-менеджеры - сводные ключевые показатели.
- Паттерн «эволюции схемы через версионность»: при добавлении нового источника или изменении требований гранулярности - создаются новые версии схемы, старые версии остаются доступными для исторических запросов и регрессионного тестирования.
- Паттерн «управление зависимостями между доменами»: конформированные размерности позволяют объединять данные из разных доменов без потери точности. Важно регламентировать, какие поля размерностей являются общими и какие - специфичны.
- Паттерн «оптимизация запросов через materialized aggregates»: создание матричных представлений для наиболее частых запросов без потери гибкости. Это повышает производительность и снижает риск перегруженности баз данных.
Кейс. Электронная коммерция с несколькими каналами продаж: онлайн, офлайн и мобильное приложение. Базовый grain - atomic events продаж (order_id, line_id, product_id, store_id, channel_id, event_ts, quantity, price). Агрегаты строятся по дням и по продуктам: daily_sales_by_product, week_store_revenue и т. п. В реальных условиях для поддержания скорости аналитики применяют материализованные представления и периодическую перегенерацию агрегатов, чтобы отчеты и дашборды обновлялись по расписанию и обеспечивали корректные ответы на частые вопросы.
- При таком подходе критически важно обеспечить консистентность между atomic и aggregate слоями и сохранить возможность drill-down до атомарного а без потери контекста.
- В случае появления новых источников данные приводятся к каноническому grain через адаптеры в ingestion-пайплайне, а затем агрегируются на нужных уровнях.
- Управление изменениями - ключевой фактор успеха: заранее продуманные тесты на устойчивость, регрессионное тестирование и уведомления об изменениях в схемах.
Key takeaways
- Грани и гранулярность данных - это не просто техническое решение, а управляемый бизнес-выбор, требующий формализации контракта на данные и согласованности между доменами.
- Канонический канальный уровень и набор агрегатов позволяют сохранить точность и гибкость аналитики, уменьшая риск противоречий и перегрузки вычислительных систем.
- Архитектура данных должна поддерживать эволюцию и версионность схем, обеспечивая обратную совместимость и минимальные риски для существующей аналитики.
- Интеграции источников требуют стандартов: единые форматы дат, идентификаторов и правил агрегации. Контракты данных - основа предсказуемости.
- Практические паттерны - канонический grain вместе с агрегатами, materialized views и версионность схем - помогают управлять сложностью по мере роста объема данных.
- Организационная часть проекта должна предусмотреть роли, процессы тестирования, управления качеством и политики доступа на уровне гранулярности.
- Вопросы дрейфа гранулярности и изменений источников требуют заранее продуманной процедуры управления версиями, чтобы не нарушать аналитические выводы.
FAQ
- Что такое гранулярность фактов и зачем она нужна?
Гранулярность фактов - это уровень детализации, на котором записываются данные в фактовой таблице. Она влияет на точность аналитики, возможности drill-down и скорость запросов. Правильная гранулярность обеспечивает полноту бизнес-сценариев и позволяет строить агрегации без потери контекста. Неправильная гранулярность приводит к противоречиям между различными источниками, избыточной вычислительной нагрузке и трудностям в поддержке данных.
- Как определить базовый уровень гранулярности?
Определение начинается с бизнес-вопросов: какие параметры нужно сохранить на уровне событий, какую детализацию требуют аналитические сценарии и какие агрегаты нужны для оперативной аналитики. Затем следует определить канонический grain для фактов и набор ключевых размерностей. Важно учитывать частоту обновления источников, требования к задержке и потребности в drill-down. Реализации часто выбирают атомарный grain для гибкости и добавляют агрегаты на уровне дня, продукта, региона и канала.
- Какие риски связаны с слишком детальной гранулярностью?
Слишком детальная гранулярность ведет к большему объему данных, более сложному управлению качеством, меньшей производительности и сложной эволюции схем. Часто она приводит к трудностям с обновлением и поддержкой множества агрегатов, усложняет регрессионное тестирование и увеличивает риск рассинхронизации между источниками.
- Какие архитектурные паттерны помогают управлять гранулярностью?
Основные паттерны включают канонический grain с набором агрегатов, materialized views для ускорения запросов, data vault для управления изменениями источников и lakehouse-подходы, обеспечивающие схему как на запись, так и на чтение. Важно, чтобы архитектура поддерживала версионность схем и совместимость между доменами через конформированные размерности.
- Как обеспечить согласованность грануляции между доменами?
Согласованность достигается через конформированные размерности и единый канонический уровень granularity. Контракты на данные, регламент миграций схем и регрессионные тесты помогают предотвратить расхождения. Регулярный мониторинг качества данных и декларации об обновлениях между доменами снижает риск ошибок и противоречий в аналитике.
- Как управлять версионностью гранулярности?
Необходимо формализовать процесс версионирования схем: каждая модификация grain или добавление поля сопровождается новой версией схемы, тестами совместимости и регламентом миграций. Исторические данные должны сохраняться, а новые версии применяться плавно. В идеале организуется регрессионное тестирование, которое проверяет согласованность между атомарным и агрегированным слоями.
- Какие инструменты и подходы помогают держать гранулярность под контролем?
Полезны инструменты версионности схем (schema registry), CI/CD для моделей данных, тестовые окружения и наборы тестовых данных. В архитектуре можно использовать Apache Iceberg или Delta Lake для поддержки версионности и эволюции схем, а также инструментальные средства для построения агрегатов и регламентированного обновления данных.
- Как оценить влияние изменений гранулярности на аналитические отчеты?
Необходимо проводить регрессионное тестирование, сравнение ключевых метрик между старыми и новыми версиями зерен, проверку качества данных и верификацию бизнес-логики. Включение аналитиков в процесс изменений и документирование влияния на дашборды и отчеты поможет минимизировать риски и обеспечить понятность для пользователей.
- Какие методы тестирования подходят для гранулярности?
Рассматривайте тесты целостности (проверка уникальности и полноты ключей), тесты на согласованность агрегаций (сверка atomic и aggregated данных), временные тесты (правильность исторических значений), а также тесты на устойчивость к задержкам (как данные обрабатываются в условиях задержек входных данных).
- Как организовать ответственность и данные продукты в контексте гранулярности?
Назначайте Data Product Owner для домена, ответственную за формулировку вопросов, требований к гранулярности и качество данных. Data Engineer отвечает за реализацию архитектуры и пайплайнов, Data Steward - за качество и соответствие контрактам, аналитик - за проверку корректности выводов и интерпретацию изменений. Весь процесс должен быть поддержан документированными контрактами и планами миграции.
Глава охватывает ключевые аспекты, которые помогут не перегружать аналитику длинной цепочкой агрегаций и сложных схем, сохранив при этом гибкость и масштабируемость. Реальные проекты требуют сочетания архитектурной дисциплины, управленческих практик и глубокой вовлеченности бизнес-пользователей для достижения устойчивых и понятных аналитических решений.


