

Ландшафт потоковой передачи данных
Ландшафт потоковой обработки данных в 2023 году: продукты и облачные сервисы Apache Kafka, а также дополнительные и конкурентные решения с открытым кодом и SaaS
Потоковая передача данных - это новая категория ПО для обработки данных. Apache Kafka является стандартом, используемым более чем 100 000 организаций. Множество поставщиков предлагают платформы и облачные сервисы Kafka. Кроме того, появилось множество дополнительных движков для обработки потоков, таких как Apache Flink, и SaaS-предложения. А конкурирующие технологии, такие как Pulsar и Redpanda, пытаются занять свою долю рынка… В этой статье мы рассмотрим ландшафт потоковой обработки данных в 2023 году с целью обобщить существующие решения и тенденции рынка.

Потоковая обработка данных - новая категория ПО
Приложения, управляемые данными - это новый "черный цвет". Такой подход позволяет повысить ценность бизнеса за счет увеличения доходов, снижения затрат, уменьшения рисков или улучшения качества обслуживания клиентов.
Для обработки и анализа данных существует множество категорий ПО и платформ для работы с данными:
- Базы данных: Хранение и выполнение транзакционных рабочих нагрузок;
- Хранилище данных: Обработка структурированных исторических данных для создания повторяющихся отчетов и уникальных аналитических материалов;
- Озеро данных: Обработка структурированных и полу- или неструктурированных больших массивов данных с пакетной обработкой для создания повторяющихся отчетов;
- Lakehouse: Сочетание хранилища данных и озера данных для обработки данных на одной платформе;
- Потоковая обработка данных: Непрерывная обработка данных и обеспечение согласованности данных в различных парадигмах коммуникации вместо хранения и анализа данных в состоянии покоя.
Примеры использования потоковой передачи данных по степени важности для бизнеса
Варианты использования потоковой передачи данных существуют во всех отраслях:
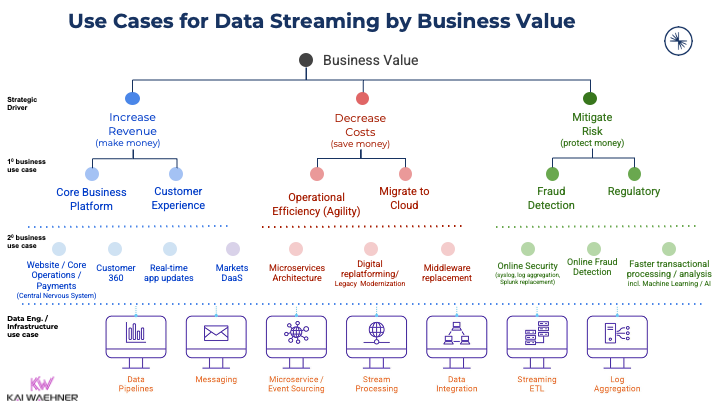
Повышение ценности бизнеса имеет решающее значение для любого предприятия. Учитывая большое количество потенциальных вариантов использования, неудивительно, что все больше и больше производителей ПО добавляют поддержку Kafka в свои продукты. Посмотрите в моем блоге примеры и архитектуры для Вашей отрасли или ознакомьтесь с примерами использования Apache Kafka в других отраслях.
Ландшафт потоковой передачи данных в 2023 году
Потоковая обработка данных - это отдельная категория ПО для платформ данных. Многие производители построили весь свой бизнес вокруг этой категории.
Как показывает практика, большинство поставщиков используют Kafka или реализуют его протокол, поскольку он уже стал стандартом.
За последние несколько лет в этой категории появились новые компании-разработчики ПО. А некоторые зрелые игроки рынка данных добавили поддержку потоковой передачи данных в свои платформы или экосистему облачных сервисов.
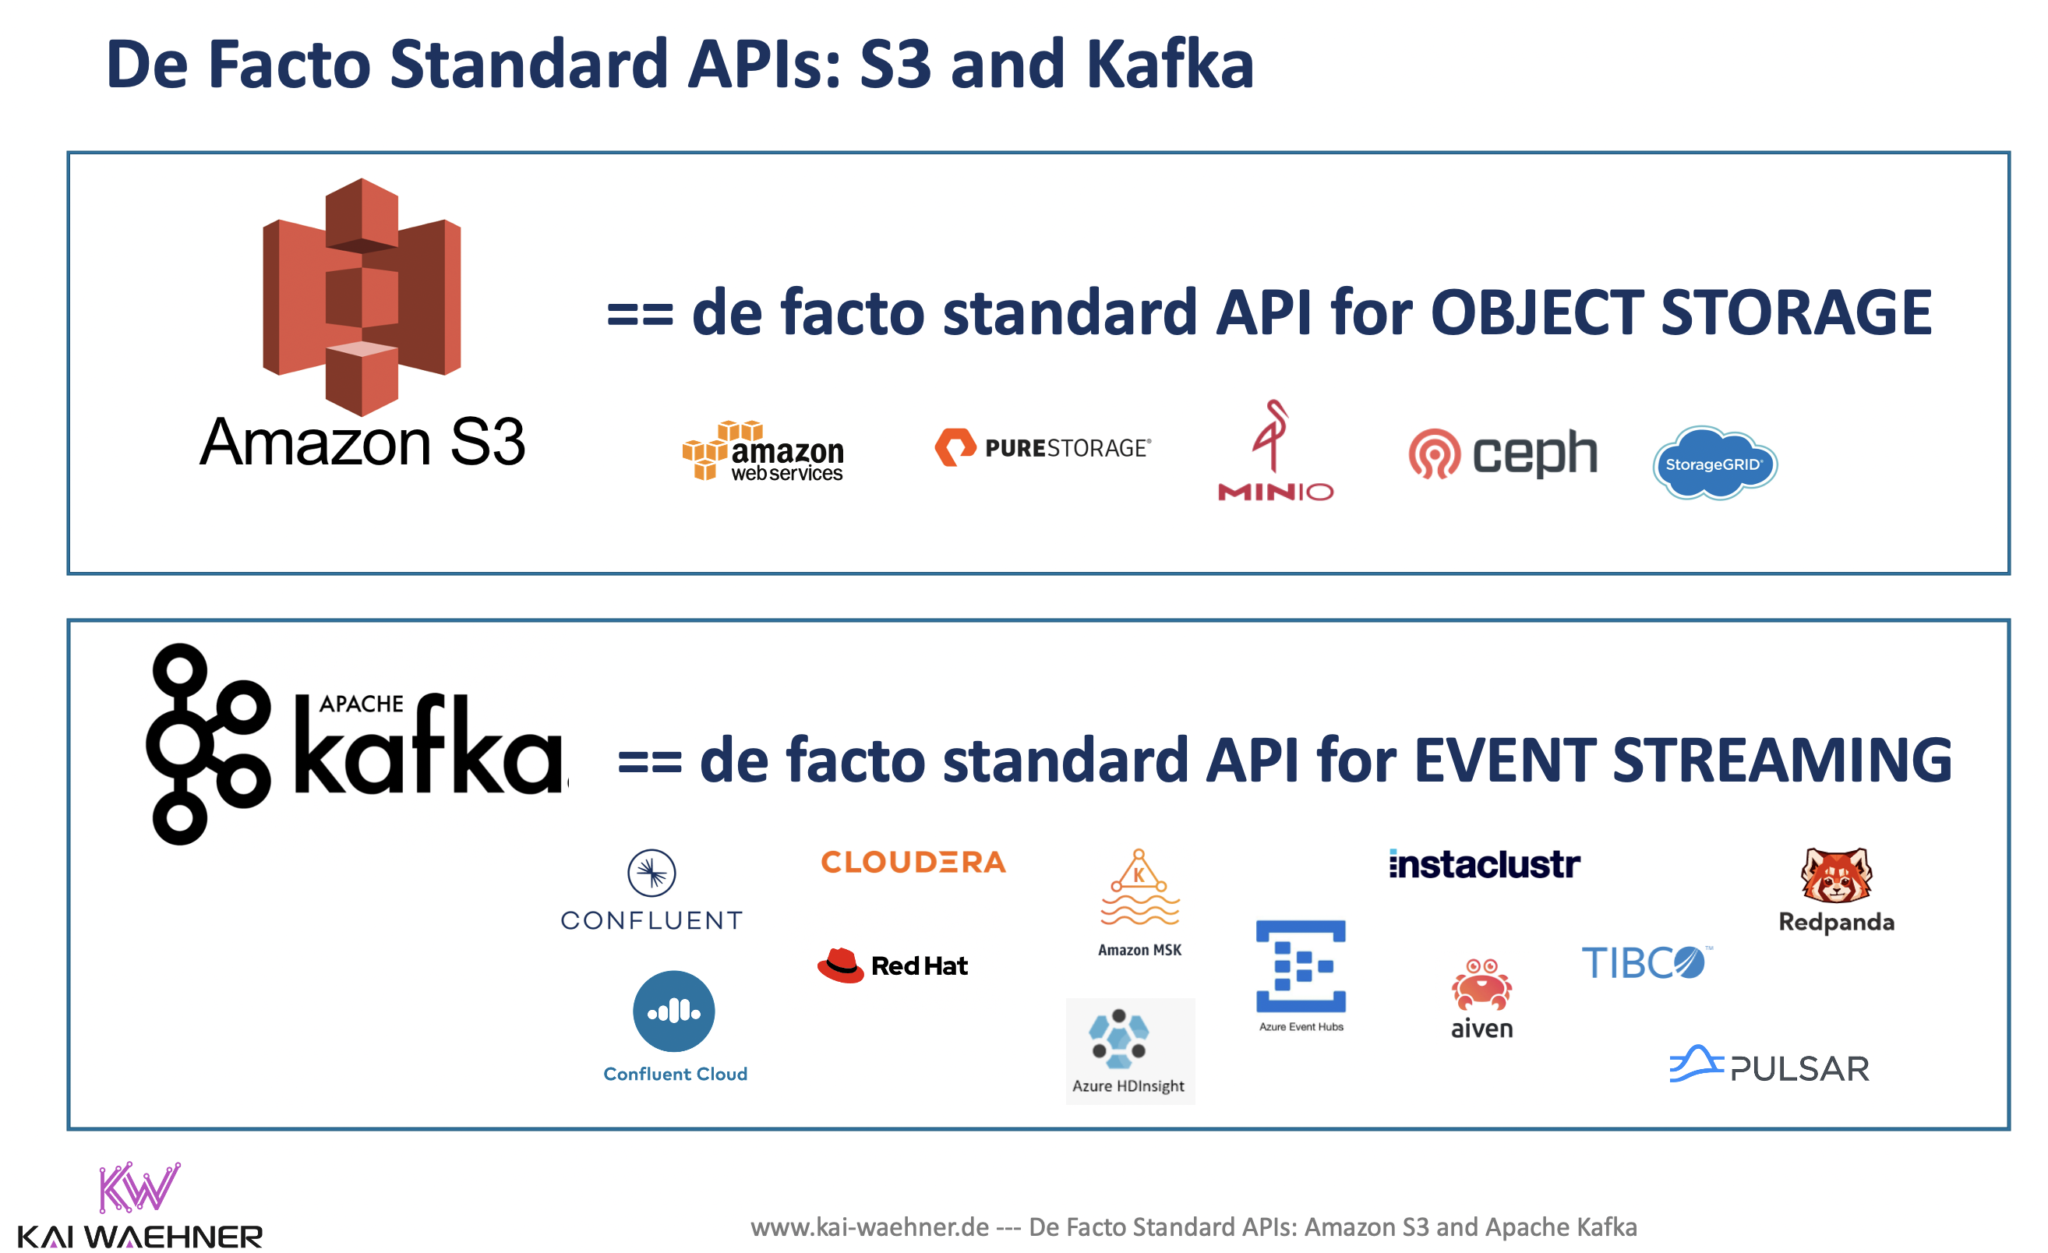
Apache Kafka является фактическим стандартом для потоковой передачи данных, как Amazon S3 является фактическим стандартом для хранения объектов S3. Большинство производителей ПО используют Kafka для своих платформ потоковой передачи данных. Однако существует не только Kafka... Некоторые поставщики используют только протокол Kafka (Azure Event Hubs) или же совершенно другие API (например, Amazon Kinesis).
Приведенный ниже ландшафт потоковой обработки данных 2023 года обобщает текущее состояние соответствующих продуктов и облачных сервисов:
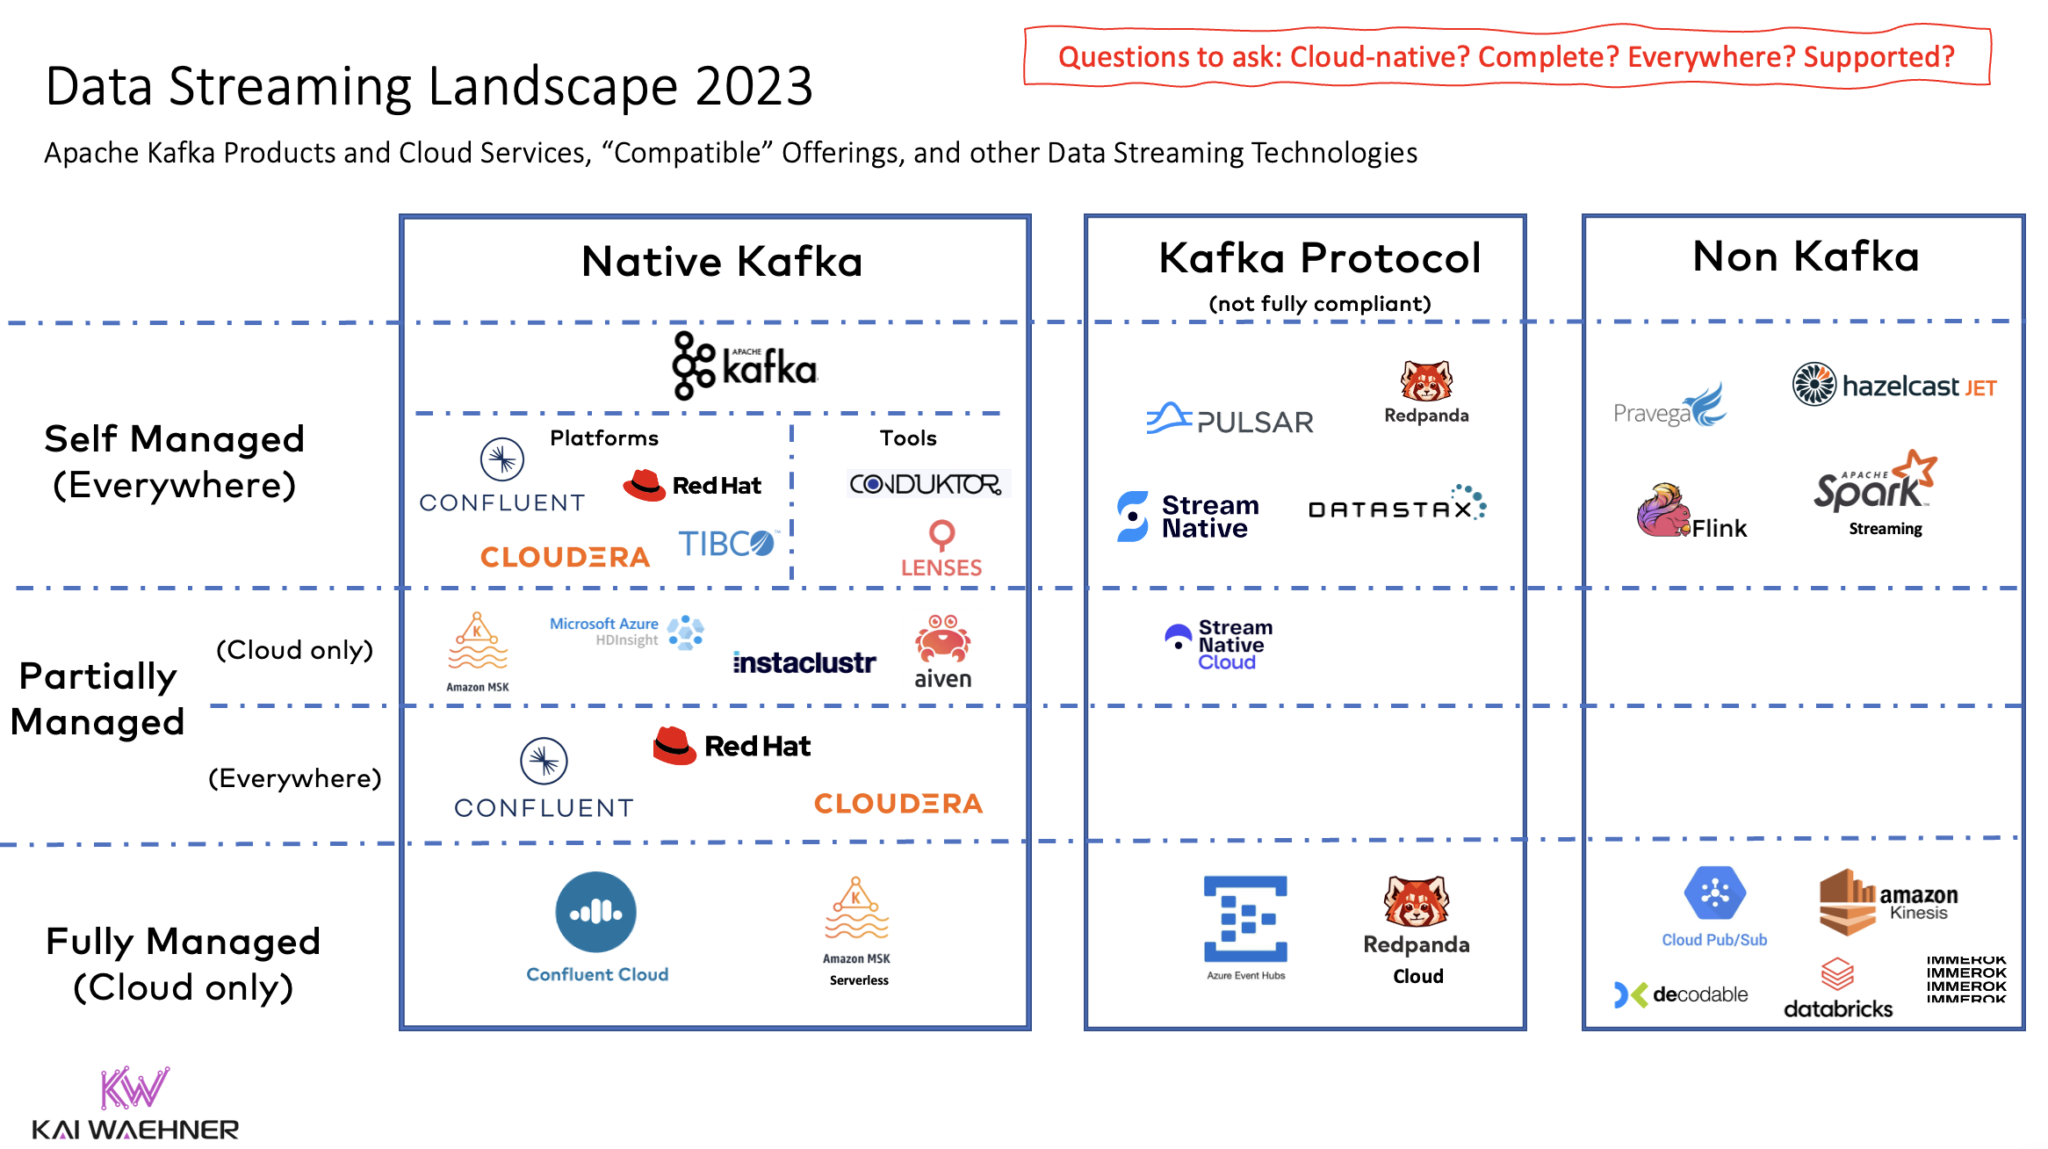
Обратите внимание: это не полный список фреймворков, облачных сервисов и поставщиков. И не официальное исследование ландшафта. Если Вашей любимой технологии нет на этой диаграмме, значит, я не видел ее в своих беседах с клиентами, перспективами, партнерами, аналитиками или более широким сообществом специалистов по потоковой передаче данных. Возможно, через год-два мы увидим на этой диаграмме гораздо больше логотипов, поскольку это еще только начало эры потоковой передачи данных.
Также следует отметить, что я сосредоточился на общей инфраструктуре потоковой передачи данных. Существуют ряд прекрасных решений для использования и анализа потоковых данных в конкретных сценариях, такие как базы данных временных рядов, системы машинного обучения или платформы наблюдаемости. Они дополняют друг друга и часто подключаются к потоковому кластеру "из коробки".
Критерии оценки платформ потоковой обработки данных
Я часто рекомендую использовать следующие четыре аспекта при рассмотрении различных фреймворков, платформ и облачных сервисов для оценки технологии для Вашего бизнес-проекта или стратегии архитектуры предприятия:
- Облачная «нативность»: Является ли решение масштабируемым вверх и вниз? Является ли оно полностью управляемым/ бессерверным или просто набором серверов, размещенных в облаке? Можно ли автоматизировать процесс разработки, эксплуатации и тестирования с помощью DevOps, GitOps, разработки на основе тестов и других подобных принципов?
- Полнота предложения: Предлагает ли решение все необходимые возможности? Потоковая передача данных требует не только обмена сообщениями или ввода данных. Следовательно, обеспечиваются ли в нем коннекторы, обработка данных, управление, безопасность, самообслуживание и т.д.?
- Где используется: Где можно использовать решение? Только в облаке? Поддерживаются ли все необходимые поставщики облачных услуг? Есть ли возможность развертывания в центре обработки данных или вне центра? Как можно обмениваться данными между регионами, облаками или центрами обработки данных? Какие сценарии использования поддерживаются (например, агрегация, аварийное восстановление, гибридная интеграция и т.д.)?
- Проверено ли предложение: Является ли решение зрелым и проверенным в боевых условиях? Имеются ли публичные тематические исследования для Вашего случая использования или отрасли? Осуществляет ли поставщик полную поддержку продукта? Каковы условия SLA? Исключены ли определенные функции из поддержки коммерческих предприятий? Очень жаль, что этот аспект необходимо оценивать. И тем не менее, некоторые поставщики предлагают облачные сервисы потоковой передачи данных и исключают при этом клиентскую поддержку.
Давайте более подробно остановимся на различных категориях и начнем с ведущей технологии: Native Apache Kafka...
Apache Kafka - стандарт для потоковой передачи данных
Начнем с лидера и фактического стандарта Apache Kafka и связанных с ним вендоров и SaaS-предложений. Apache Kafka стал стандартом де-факто для потоковой передачи данных, как Amazon S3 - стандартом де-факто для объектного хранилища:
Принятие Apache Kafka обществом специалистов по данным
Рост сообщества Apache Kafka за последние несколько лет впечатляет. Вот некоторые статистические данные, которые Джей Крепс представил на конференции по потоковой передаче данных "Current - The Next Generation of Kafka Summit" в Остине, штат Техас, в октябре 2022 года:
>100 000 организаций, использующих Apache Kafka
>41 000 участников встреч по Kafka
->32 000 вопросов на Stack Overflow
>12 000 Jiras для Apache Kafka
>31 000 открытых объявлений о вакансиях, запрашивающих навыки работы с Kafka
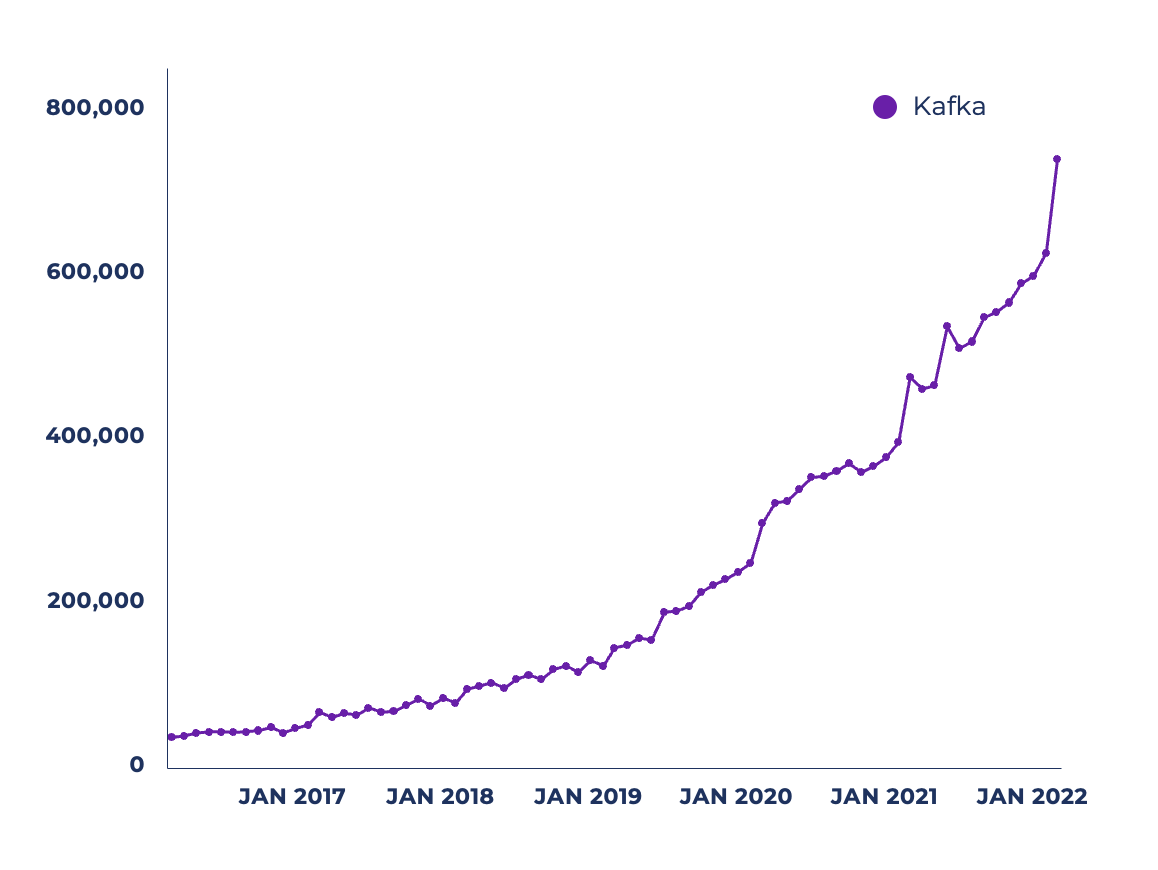
И посмотрите, как увеличилось число активных пользователей, загружающих клиентскую Java-библиотеку Kafka с помощью Maven:
Поставщики Apache Kafka: Самоуправляемые и облачные предложения
Новые компании, занимающиеся разработкой ПО, уделяют особое внимание потоковой передаче данных. В последние несколько лет на эту волну вышли и традиционные игроки, такие как IBM и Amazon. На верхнем уровне - если говорить упрощенно - существует три вида предложений для Apache Kafka:
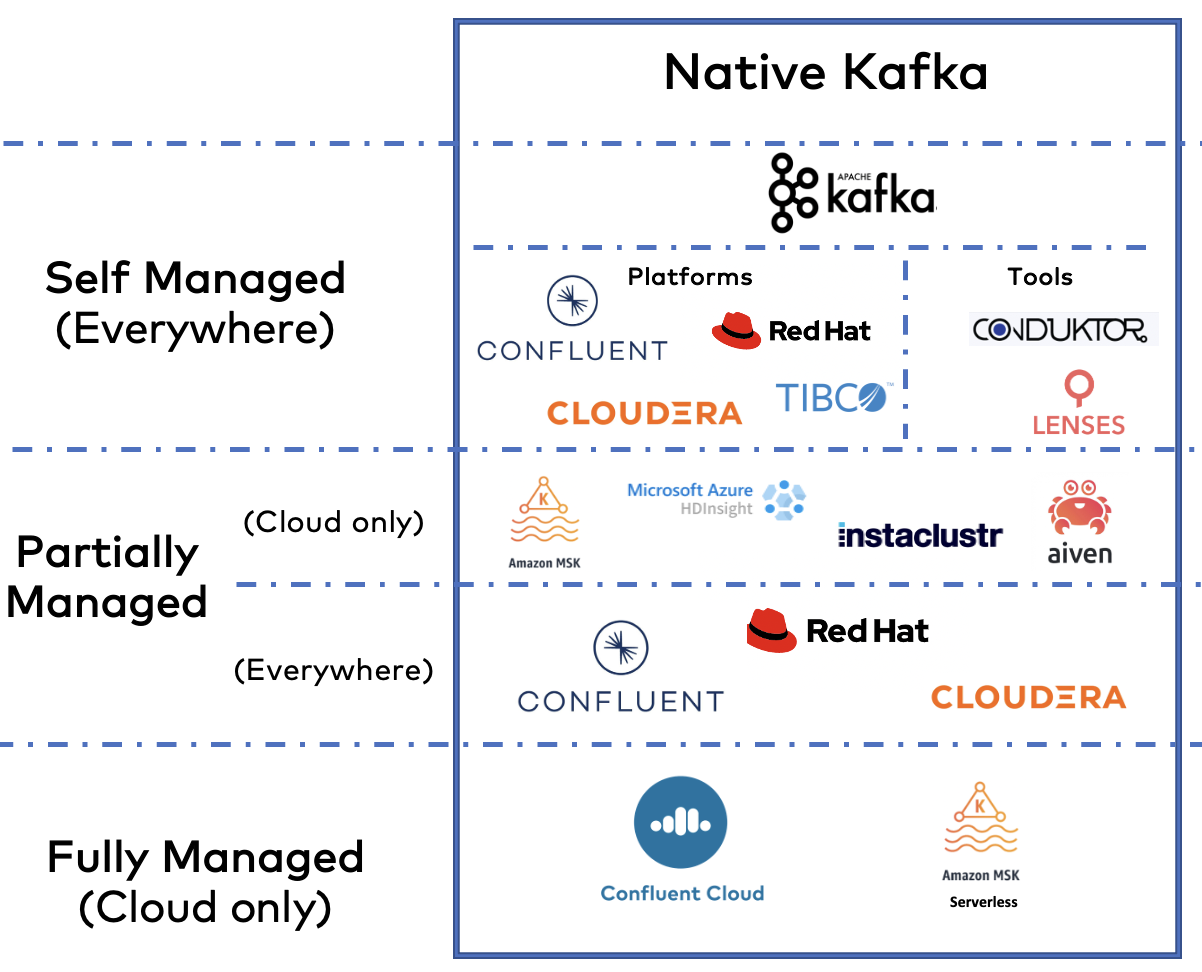
Ниже приведены краткие сведения о каждом поставщике:
- Apache Kafka: Стандарт де-факто для потоковой передачи данных. Открытый исходный код с обширным сообществом. Все поставщики, представленные в этом списке, опираются на этот проект (частично).
- Confluent: Обеспечивает потоковую передачу данных повсеместно благодаря платформам Confluent Platform (самостоятельное управление) и Confluent Cloud (полное управление и доступность у облачных провайдеров).
- Cloudera: Предоставляет Kafka в качестве самоуправляемого предложения. Ориентирована на объединение множества технологий обработки данных, таких как Kafka, Hadoop, Spark, Flink, NiFi и многие другие.
- Red Hat: предоставляет Kafka в виде частично управляемого облачного предложения и самоуправляемого Kafka на Kubernetes через OpenShift. Kafka является частью интеграционного портфеля, включающего другие фреймворки с открытым исходным кодом, такие как Apache Camel.
- TIBCO: предлагает Kafka для Linux и Windows. Странный продукт (как известно специалистам по Kafka, Kafka плохо работает под Windows) и минимум документации.
- AWS: Предлагает два отдельных продукта - Amazon MSK (частично управляемый) и Amazon MSK Serverless (полностью управляемый). Поддержка Kafka исключена из предложений MSK. AWS имеет сотни облачных сервисов, и Kafka является частью этого широкого спектра. Доступно только в облаках AWS.
- Instaclustr и Aiven: Частично управляемые облачные предложения Kafka у разных облачных провайдеров. Портфели продуктов предлагают различные хостинговые сервисы технологий с открытым исходным кодом. Instaclustr также предлагает (полу)управляемое предложение для локальной инфраструктуры.
- Microsoft Azure HDInsight. Часть инфраструктуры Hadoop в Azure. Не предназначена для других вариантов использования. Доступно только в облаках Azure.
- Lenses и Conduktor: инструменты для управления и мониторинга кластеров Kafka. Дополняют других поставщиков.
Это не сравнение. Это лишь список с некоторыми примечаниями. Вы можете сделать собственную оценку понравившихся Вам вендоров. Проверьте, что Вам нужно: Облако? Традиционная версия?
Совместимые с Kafka фреймворки и SaaS с открытым исходным кодом
Некоторые поставщики по разным причинам не полагаются на Apache Kafka с открытым исходным кодом, а создают собственные решения. Совместимость с протоколом Kafka ограничена (хотя маркетинг об этом не говорит). Это может создавать риск при эксплуатации существующих рабочих нагрузок Kafka на кластере, отличающихся по операциям и исполнению (что может быть как хорошо, так и плохо).
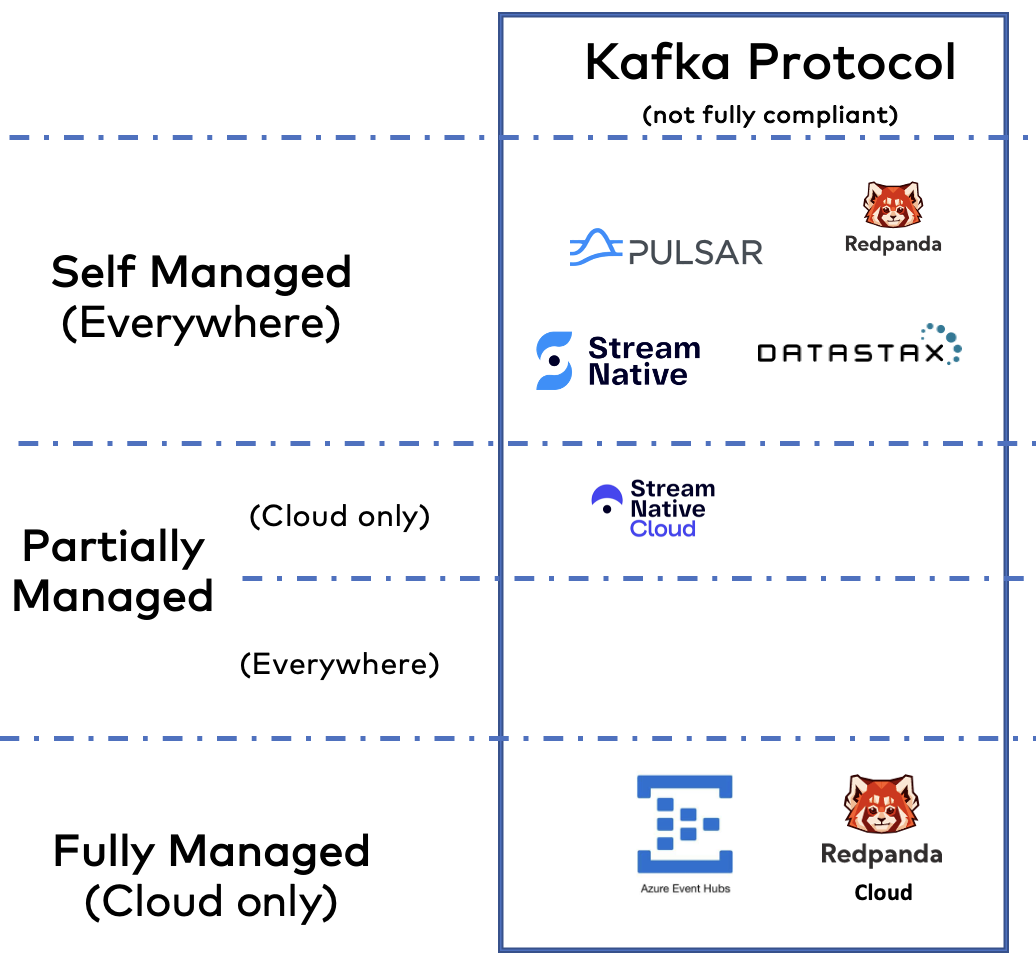
Вот несколько замечаний по каждому поставщику:
- Apache Pulsar: Главный конкурент Apache Kafka. Схожая история и примеры использования, но совершенно разная архитектура (Kafka представляет собой один распределенный кластер - после удаления зависимости от ZooKeeper в 2022 году), а Pulsar - три распределенных кластера (брокеры Pulsar, ZooKeeper, BookKeeper).
- StreamNative: Основной поставщик Apache Pulsar. Предлагает самоуправляемые и полностью управляемые решения. StreamNative Cloud для Kafka находится в стадии бета-версии и не готов к производству.
- DataStax: Предложение Pulsar, интегрированное в портфель продуктов, ориентированных на базы данных. Не совсем понятно, является ли продукт для потоковой обработки данных маркетинговым или нет. Если вы хотите попробовать облачный сервис Astra Streaming на базе Pulsar, то он отсылает вас к мультиоблачному DBaaS, построенному на Apache Cassandra.
- Redpanda: Новый участник рынка потоковой передачи данных, предлагающий самоуправляемые и полностью управляемые продукты. Интересный подход к реализации протокола Kafka на языке C++. Она может занять некоторую долю рынка, если сможет найти подходящие сценарии использования и дифференцирующие факторы. Сегодня я не рассматриваю Redpanda в качестве альтернативы нативному Kafka-предложению из-за ее ранней стадии зрелости и отсутствия дополнительных преимуществ для решения бизнес-задач по сравнению с Apache Kafka.
- Azure Event Hubs: Зрелый, полностью управляемый облачный сервис. Сервис выполняет одну задачу, и делает это очень хорошо: Ввод данных по протоколу Kafka (с ограниченной совместимостью). Таким образом, он не является полноценной потоковой платформой, а скорее сопоставим с Amazon Kinesis или Google Cloud PubSub. Доступна только в облаке Azure.
С осторожностью относитесь к заявлениям поставщиков. Большинство из них преувеличивают совместимость с протоколом Kafka. Кроме того, "бенчмаркетинг" (т.е. выбор "сладкого места" или нишевого сценария, где Вы работаете лучше конкурента) является излюбленным маркетинговым приемом для "доказательства" отличий от настоящего Apache Kafka.
Потоковая обработка данных - это не только Apache Kafka...
Хотя Apache Kafka и является стандартом для потоковой передачи данных, существует множество дополняющих и конкурирующих технологий.
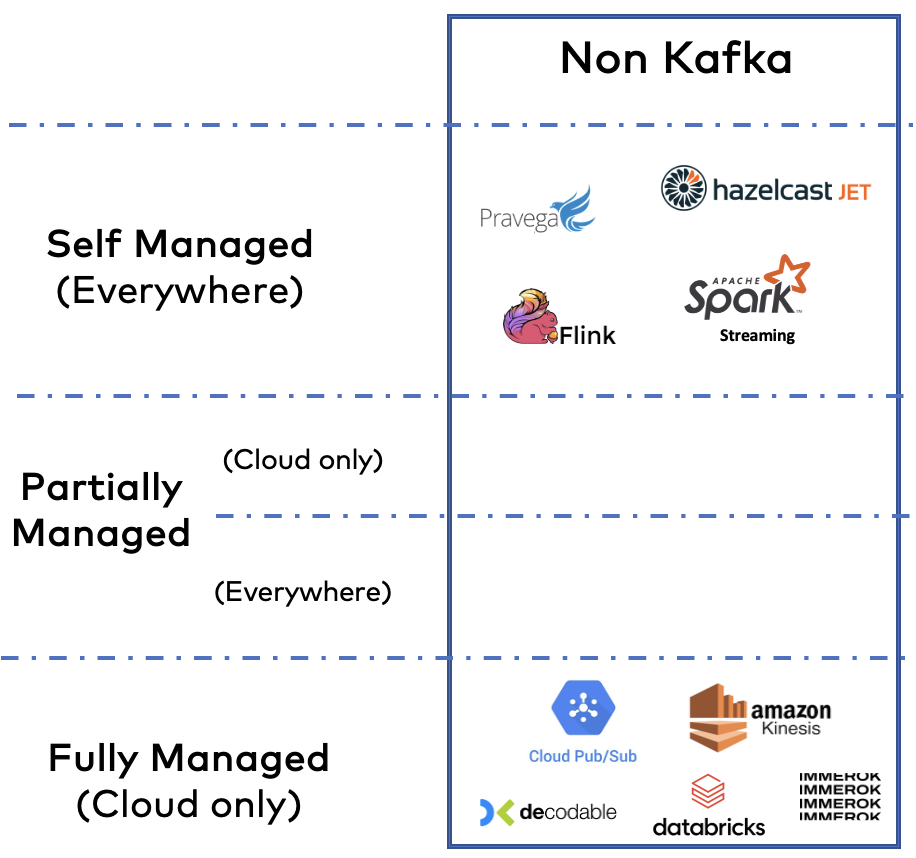
Еще больше технологий появляется благодаря росту этой категории ПО во всем мире и во всех отраслях. Это отличная новость. Потоковая передача данных будет развиваться и расти.
В рамках ландшафта потоковой передачи данных ситуация непростая, поскольку некоторые продукты дополняют и конкурируют с экосистемой Apache Kafka.
Некоторые технологии потоковой обработки данных успешно конкурируют с Kafka
Вот несколько основных конкурентов с открытым кодом и в облаке:
- Amazon Kinesis: Ввод данных в хранилища данных AWS. Зрелый продукт для решения конкретной задачи. Доступен только на AWS.
- Google Cloud PubSub: ингестирование данных в хранилища данных GCP. Зрелый продукт для решения конкретной задачи. Доступен только на GCP.
- Pravega и Hazelcast Jet: Фреймворки с открытым исходным кодом для обработки потоков. Я добавил их, чтобы показать, что в мире с открытым исходным кодом существуют не только Kafka и Flink. Правда, я не вижу их особого продвижения на рынке.
Amazon Kinesis и Google Cloud PubSub - отличные облачные сервисы, если Вы хотите "просто" собирать данные в определенное облачное хранилище. Если нет других сценариев использования, эти инструменты могут быть правильным выбором (если ценообразование Вас устраивают).
Apache Kafka - гораздо более гибкая и стратегически важная платформа для потоковой передачи данных. Многие проекты по-прежнему начинаются с приема данных и построения первого конвейера. Но предоставление доступа к тому же потоку событий для любого другого поглотителя данных или для мощной потоковой обработки с помощью таких инструментов, как Kafka Streams или Apache Flink, является существенным преимуществом.
Некоторые технологии потоковой обработки данных дополняют Kafka
Каждый фреймворк для обработки потоков или облачный сервис имеет свои компромиссы. Не существует единого решения, подходящего для всех случаев использования. Вот несколько зрелых и новых технологий, которые дополняют Apache Kafka:
- Apache Flink: Вместе с Kafka Streams (часть Apache Kafka) является ведущим фреймворком для обработки потоков с открытым исходным кодом. Расширенные возможности включают поддержку ANSI SQL и API для потоковых и пакетных рабочих нагрузок.
- Decodable и Immerok: два совершенно новых облачных сервиса. Очень ранняя стадия. Я все же добавил их, поскольку считаю, что это отличный стратегический ход - создать облачный сервис потоковой обработки данных на базе Apache Flink. Огромный потенциал, если его объединить с существующими инфраструктурами Kafka на предприятиях.
- Spark Streaming: Потоковая часть Apache Spark. Я до сих пор не уверен на 100 процентов. Для потоковой обработки лучше подходят Kafka Streams и Apache Flink. Однако огромная база установленных кластеров Spark на предприятиях расширяет их применение.
- Databricks: Ведущий поставщик Apache Spark. Занимается или, по крайней мере, пытается заниматься данными в реальном времени. Мне нравится эта платформа, но меня не убеждает история с "озером данных", когда "все делается в одном большом озере данных".
Apache Flink и Spark Streaming БЕЗ Kafka?
Большинство из этих технологий дополняют Apache Kafka. Но фреймворки для обработки потоков, такие как Flink, или облачные сервисы, такие как Databricks, НЕ нуждаются в Kafka в качестве входного слоя. Есть и другие варианты...
Flink, Spark могут «потреблять» данные из других потоковых платформ или непосредственно из хранилищ данных. Однако с последним следует быть осторожным: Если вы используете Flink или Spark Streaming для потоковой обработки, то все в порядке. Но если первым делом Вы считываете данные из объектного хранилища S3, то это уже данные в состоянии покоя. Не выполняйте потоковую обработку с данными в состоянии покоя.
Или, другими словами, не храните данные в базе данных или озере данных только для того, чтобы потом их «перевернуть». Почти все примеры и кейсы Spark Streaming, которые я видел в прошлом году на конференциях и встречах с заказчиками, выглядели именно так. Это антипаттерн для потоковой обработки!
Внесем ясность: в приложение потоковой обработки, построенное с использованием Kafka Streams, Flink и т.д., можно загружать данные из S3 или другого хранилища данных. Эти данные могут быть использованы в бэкенде с сохранением состояния для решения Ваших задач, например для обогащения. Приложение для обработки потоков - это не только передача данных в реальном времени. Оно также коррелирует эти данные в реальном времени с (уже поступившими) историческими данными. Это обычный подход для метаданных или бизнес-данных, которые обновляются не так часто (например, из ERP-системы SAP).
Почему Kafka Streams и KSQL отсутствуют в ландшафте потоковой передачи данных?
Я намеренно не включил Kafka Streams и KSQL в ландшафт потоковой обработки данных. Обе технологии являются нативными для Kafka технологиями обработки потоков.
Kafka Streams, как и Kafka Connect, является частью Apache Kafka с открытым исходным кодом. Поэтому при загрузке Kafka с сайта Apache в комплект поставки входит библиотека Java. Она уже включена в ландшафт потоков данных с логотипом Kafka. Вы всегда должны спрашивать себя, нужен ли вам еще один фреймворк, кроме Kafka Streams, для обработки потоков. Существенное преимущество: одна технология, один вендор, одна инфраструктура.
Многие поставщики исключают или не фокусируются на Kafka Streams и Kafka Connect и предлагают только неполную Kafka; вместо этого они хотят продавать свои собственные продукты для интеграции и обработки.
KSQL - это слой абстракции поверх Kafka Streams для обеспечения потоковой обработки с использованием потокового SQL. Отличный инструмент, также ориентированный на Kafka. Он поставляется с лицензией Confluent Community License и является бесплатным для использования. Поэтому, как и Kafka Streams, я рассматриваю его как часть Kafka и не стал явно выделять его в ландшафт потоковой обработки данных как отдельный продукт. Но вы должны оценить его в сравнении с Flink, Decodable и другими, конечно, для вашего случая использования.
Эра потоковой передачи данных еще только начинается...
Ландшафт потоковой передачи данных 2023 года показывает, как формируется новая категория ПО. Мы все еще находимся на очень ранней стадии. В большинстве бесед с заказчиками, партнерами и представителями сообщества я слышу такие высказывания:
"Мы видим ценность, но мы еще не доросли до этого - сейчас мы начинаем с создания первых конвейеров потоковой обработки данных и имеем дорожную карту на ближайшие годы для добавления более продвинутой потоковой обработки".
Потоковая обработка данных - это долгий путь, поскольку речь идет о смене парадигмы. Мы надеемся, что в обозримом будущем появится магический квадрант Gartner по потоковой обработке событий и волна Forrester по потоковой обработке данных. Создание новой категории требует времени. Но вы уже заметили, насколько больше аналитики Gartner, Forrester и других компаний уже пишут о потоковой передаче данных и различных вендорах?
Какие тенденции в области потоковой передачи данных и Apache Kafka в 2023 году Вы считаете наиболее актуальными и интересными для приведения данных в движение? Как выглядит Ваш корпоративный ландшафт для потоковой передачи данных?


