
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс по Apache Airflow и NiFi » Загрузка stage слоя DWH. Часть 1

Загрузка stage слоя DWH. Часть 1

В этом цикле статей я расскажу опыт внедрения инструмента Apache Nifi для формирования DWH. 

Данная статья посвящена первому этапу внедрения Apache NIFI - начальным потокам выгрузки, внедрению инкрементальной загрузки, и описанию существующей архитектуры.


Цели, задачи

Задача - организовать сбор данных от источников и заполнение DWH с применением Apache NIFI. Так как некая структура уже существовала, то появились обозначения:

  1. Старая архитектура - сбор данных от источников выполняется раз в сутки, ночью, инструмент - SSIS на MsSqlServer (да, в качестве хранилища применяется MSSql, но мы планируем переход на GreenPlum), все инициализируется джобами через Sql Server Agent.
  2. Новая архитектура - сбор данных от источников выполняется раз в сутки с помощью Apache NIFI, заполняются стейджинговые таблицы, потом все по старому - джоб, пакеты, SSIS…


Какие были трудности в старой архитектуре:

  1. Загрузка осуществлялась раз в сутки и в случае большого объема данных SSIS не справлялся с выгрузкой данных от источника, и джоб падал.
  2. С увеличением объема данных и количества выгружаемых сущностей времени на выгрузку и перестройку витрин стало не хватать.
  3. Не выполнялась инкрементальная загрузка.


Задачи новой архитектуры:

  1. Обеспечить загрузку данных по мере их изменения на источнике.
  2. Масштабировать нагрузку на большое количество таблиц.
  3. Обеспечить формирование витринного слоя на основе загружаемого инкремента.
  4. Разделить процессы загрузки и пересчета витрин.
  5. Обеспечить легкую миграцию на GreenPlum. 


Поток ETL

Основным источником данных является ЕРП “Галактика”, СУБД - Oracle. У нашей команды есть доступ к источнику и есть возможность разработки View. Так как в NIFI  есть встроенный механизм сохранения инкрементального поля при запросе (числовое поле или дата-время), решено было для каждой таблицы источника создавать два View - исторический и инкрементальный. Структура View одинаковая, отличие только в том, что для инкрементального представления данные извлекаются из журналов, срок журналирования от 2 недель до 1 месяца. В каждой таблице есть два числовых поля - дата и время изменения записи. Так как NIFI умеет хранить только возрастающие поля, а время является циклично зависимым, решили сделать инкрементальный ключ, объединив в одном поле дату и время изменения записи в числовом представлении.

Был разработан поток загрузки данных, который извлекает данные из таблицы источника, выполняет ряд преобразований и выполняет загрузку в целевую таблицу. Отмечу, что в основном поток разработал мой коллега Фархад, я подключился после решения инфраструктурных задач.
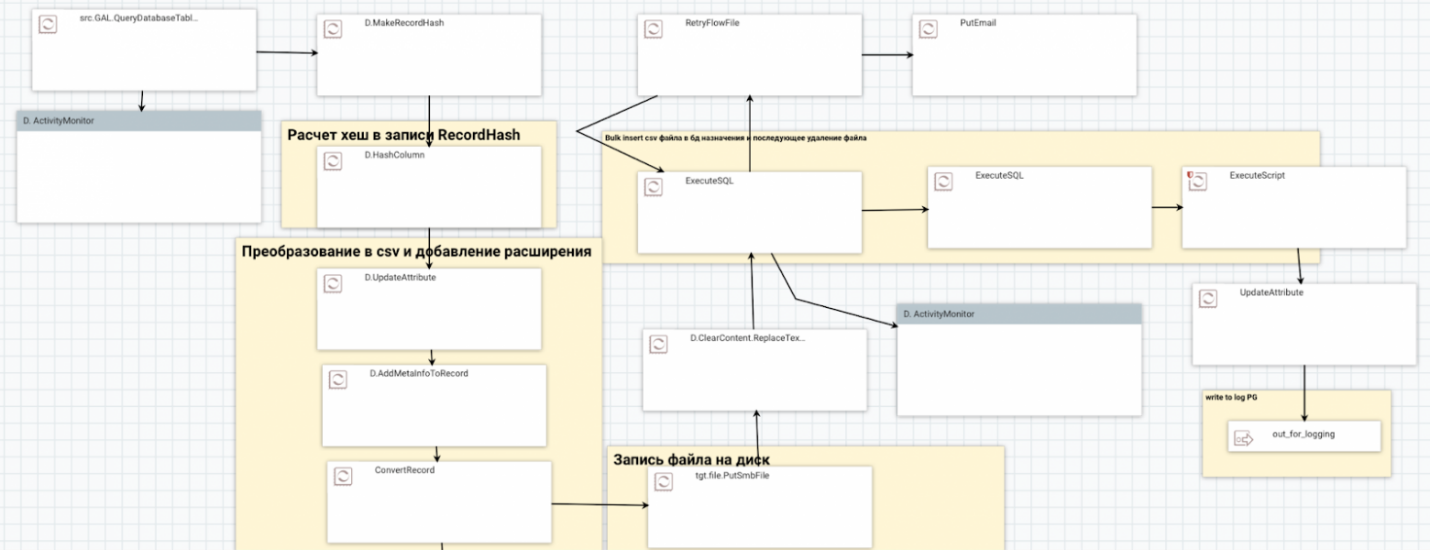

Рис. 1. Общий вид потока. Дает представление о направлении движении данных.


Рассмотрим подробнее, от запуска и до завершения.

На начальном этапе происходит извлечение данных с помощью процессора QueryDatabaseTable.
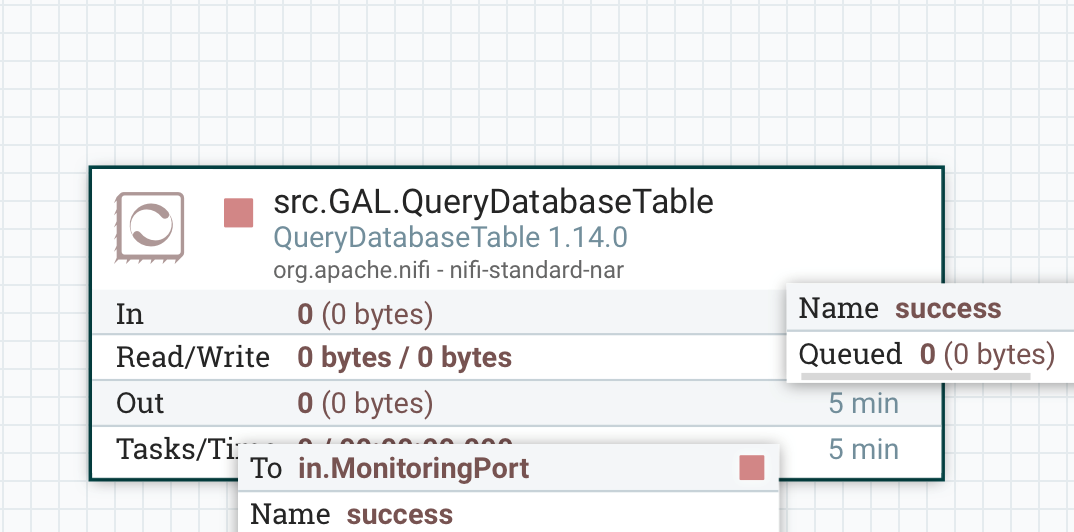

Рис. 2. Процессор QueryDatabaseTable - порождает поток и выполняет запрос к источнику.
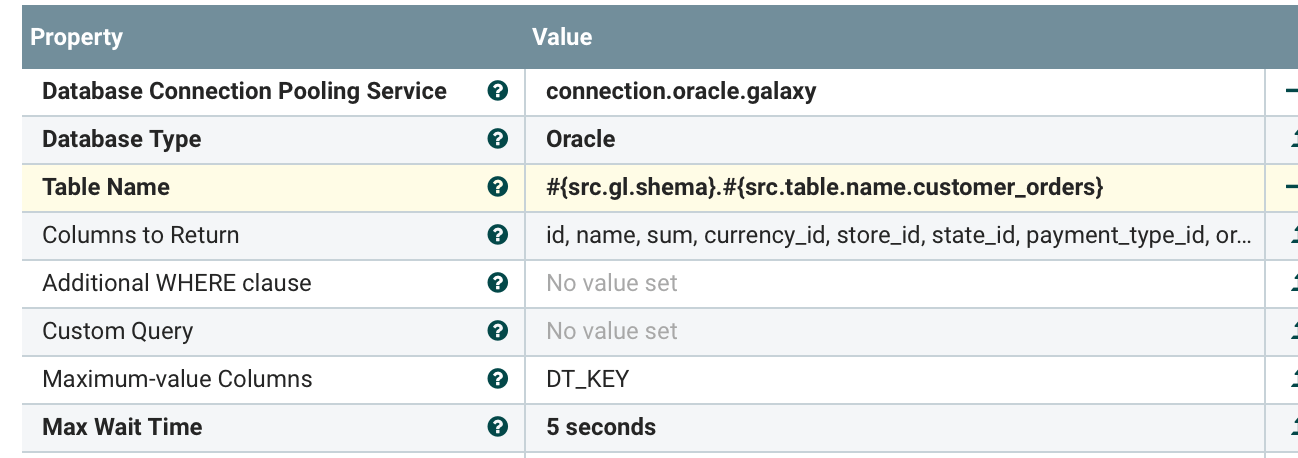


Рис. 3. Натсройки QueryDatabaseTable


В настройках указываем соединение, схему и таблицу, перечисляем поля (либо оставляем поле пустым, тогда будут выбраны все поля), и указываем имя поля в настройке Maximum-value Columns. NIFI при запросе вычислит максимум и сохранит его в своем состоянии. При следующей генерации запроса NIFI добавит условие “WHERE  DT_KEY > 1923929292929”, то есть подставит и имя поля и его предыдущее значение. Таким образом реализуется инкрменетальная выгрузка.

Далее необходимо выполнить ряд преобразований. Так как могут поступать данные, которые уже были введены в систему (например, при редактировании), надо понять, произошли ли изменения данных. В целях отслеживания мы рассчитываем хеш каждой записи, и если он будет отличаться, то требуется обновить данные в витринном слое.
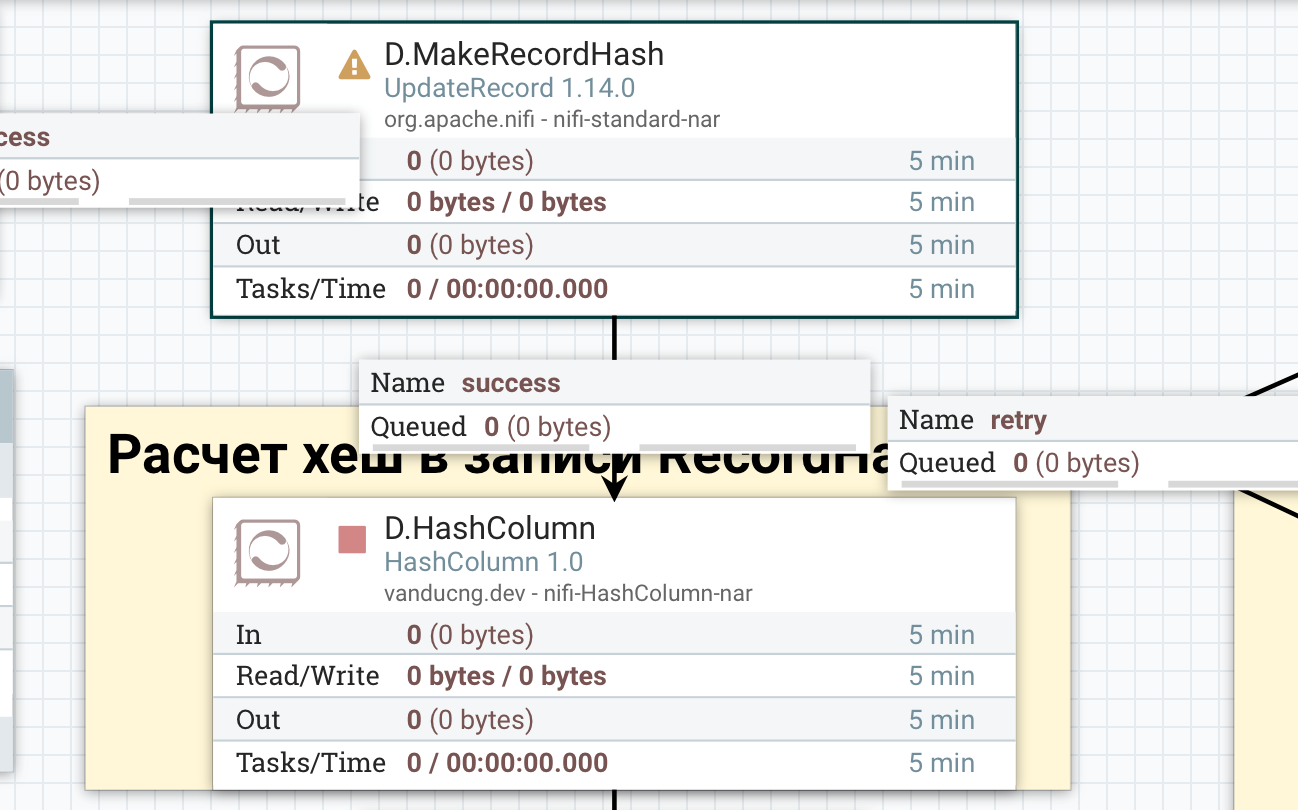

Рис. 4. Обновление данных и вычисление хэша


Сначала идет подготовка данных. Формируем новое поле с помощью Updaterecord, и вычисляем его хэш с помощью стороннего процессора HashColumn (спасибо автору за разработку, исходник в github). При дальнейшей разработки я решил максимально использовать штатные процессоры. В следующей части я покажу, как именно я заменил эту связку.
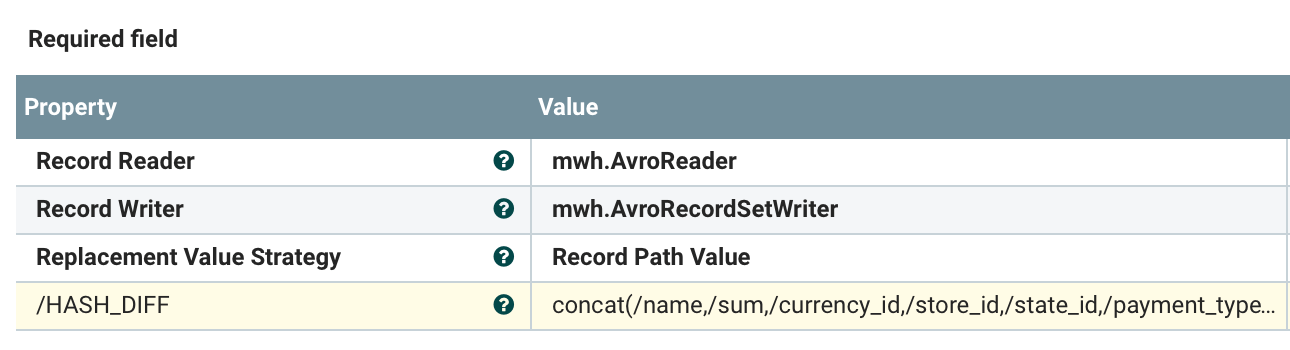

Рис. 5. Настройки UpdateRecord


В настройках UpdateAttribute указываем имя нового поля - HASH_DIFF, и правило его формирования - конкатенация значимых полей. В результате формируется новое поле, в котором будет строка, содержащая все поля. И процессор HashColumn вычислит хеш по заданному алгоритму и поместит значение в это же поле.
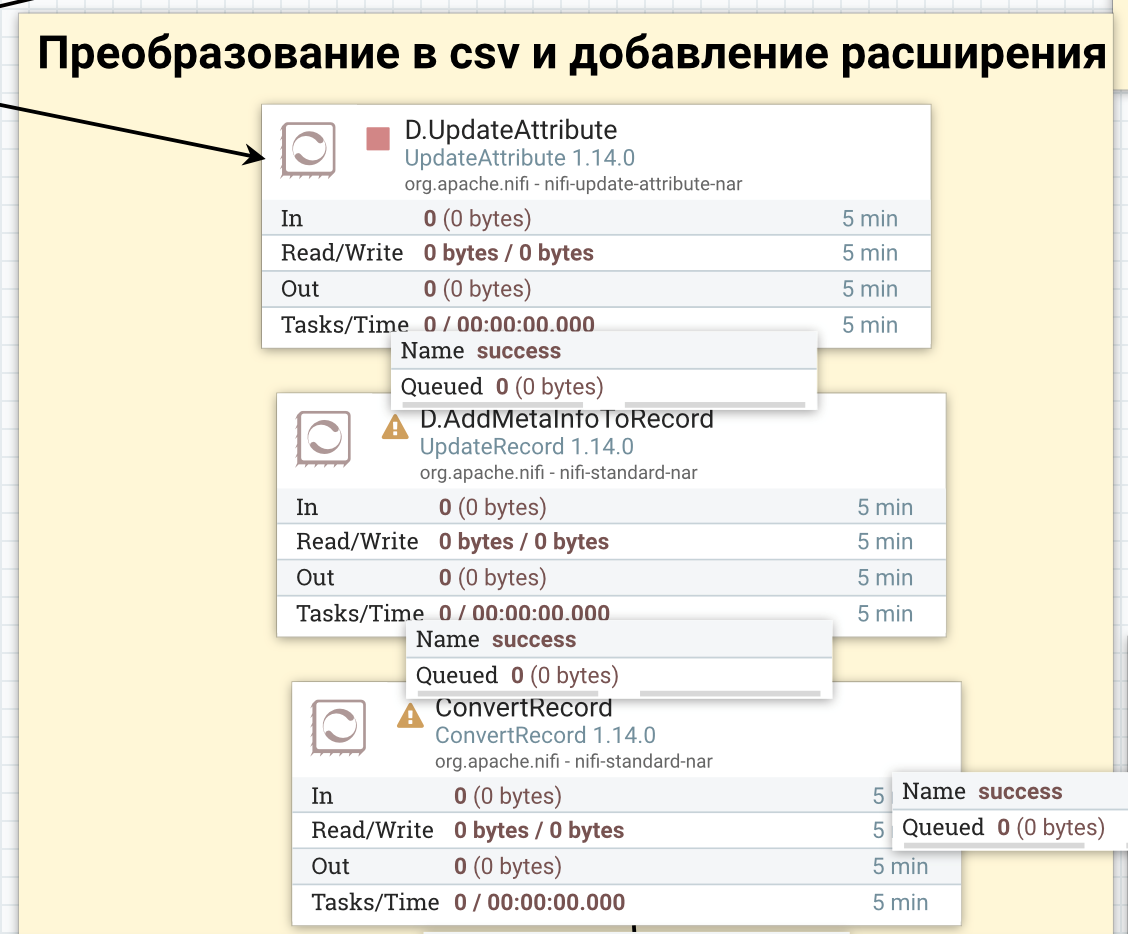

Рис. 6. Последовательность действия при преобразовании к CSV


Сначала идет формирование атрибутов, где атрибуту $filename присваивается текущее имя файла с расширением ".csv". Этот атрибут понадобится при сохранении файла. Далее добавляется мета-информация - в каждую запись вносим время выгрузки. Запись преобразуется к CVS-формату с помощью процессора ConvertRecord. В результате контент из формата "Avro" будет преобразован к "CSV", экранирование происходит в зависимости от настройки сервиса записи.
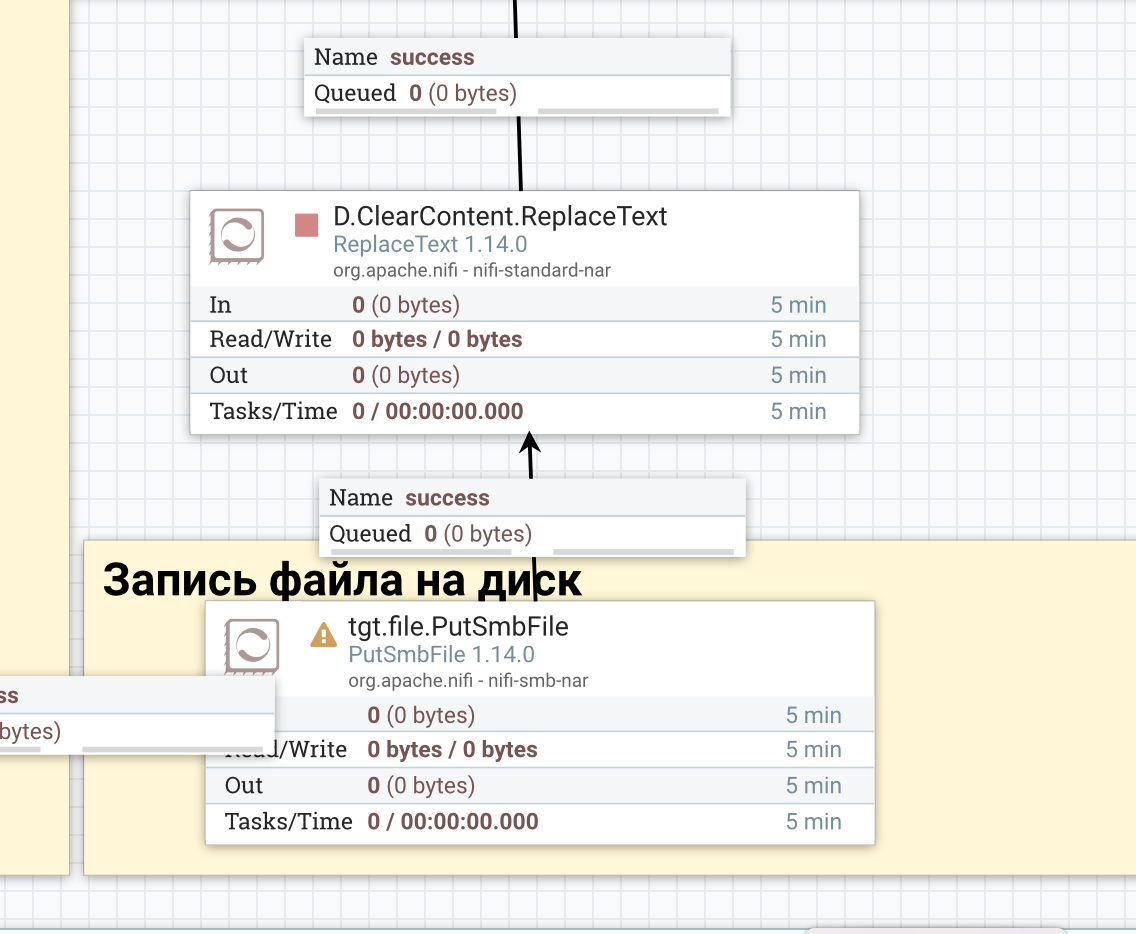

Рис. 7. Запись файла в сетевую папку и очистка контента


Полученный файл сохраняется на сетевую папку на сервере, где крутится целевой MS Sql с помощью PutSmbFile, и выполняем очистку контента. Это необязательный шаг, однако при работе было замечено, что при наличии контента последующий запрос сильно тормозит.

После записи на сервере выполняется запрос для вставки данных в таблицу с помощью компонента ExecuteSQL.
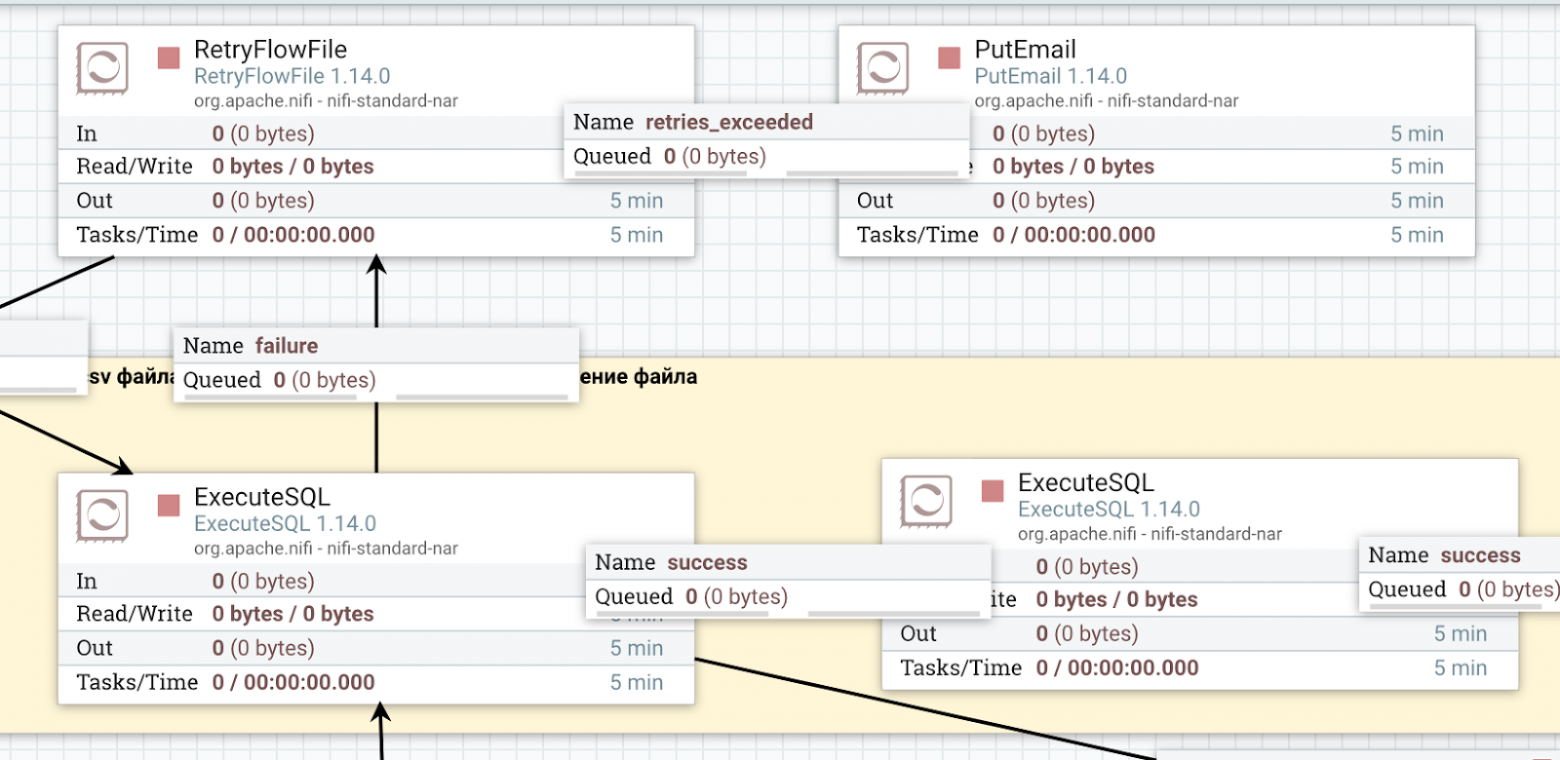

Рис. 8. Последовательность действий для внесения и удаления данных на сервере


Сам запрос имеет следующий вид:

BULK INSERT #{tgt.sql.schema}.#{tgt.sql.table.name.customer_orders}
FROM '#{local.folder.Bulk.Insert}${filename}'
WITH(FIRSTROW = 2, FIELDTERMINATOR = '~',ROWTERMINATOR = '0x0a',
     CODEPAGE = 65001, TABLOCK )


Как видно, на сервер передается имя файла для внесения в заданную таблицу, где схема и таблица определена в параметрах группы, а имя файла извлекается из атрибута.

В случае, если произошел сбой, поток отправляется на повтор, и в случае трех неудачных внесений формируется письмо об ошибке.

При удачном внесении выполняется хранимая процедура, удаляющая загруженный файл:

DECLARE
@deletefile NVARCHAR(MAX) , @cmd NVARCHAR(MAX)

set @deletefile = '${filename}'
set @cmd =
'xp_cmdshell ''del "#{local.folder.Bulk.Insert}\' + @deletefile  + '"''';
EXEC (@cmd)


Файл можно удалить и средствами NIFI, например через GetSmbFile, но в этом случае контент передается по сети обратно. Можно вызвать скрипт SSH или PowerShell, но это выдача дополнительных разрешений для пользователя NIFI.

Дальнейшие шаги являются служебными - формирование и запись лога, отправка уведомлений и т.д. 


Заключение

Данный поток позволил нашей команде обкатать инкрементальную загрузку, исключить загрузку данных от источника средствами SSIS, разделить процесс загрузки данных от процесса расчета витрин.

Достоинства:

  1. Простой поток, в котором отражены все этапы ETL - выгрузка, преобразования, загрузка.
  2. Легко масштабировать - сохранив в виде шаблона или положив в Registry, меняя переменные и список полей можно легко добавить новую таблицу.
  3. Легко мониторить - видно, какой поток упал, где ошибка.


Недостатки:

  1. Когда количество таблиц превысило 20, стало неудобно поддерживать это решение.
  2. Все запуски выполнялись примерно в одно и то же время, создавая сильную нагрузку на источник.
  3. При необходимости модификации приходилось вносить изменения во все потоки, в одном и том же месте.


Вторая часть

Автор: Иван Клименко, разработчик потоков обработки данных в компании Аскона.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Оптимизируем NiFi Flow. Настройка Load Balancing, подходы к Scheduling и выбор метода merge
Следующая статья →
Загрузка stage слоя DWH. Часть 2

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • Ситилинк

    Электронный дискаунтер «Ситилинк» — один из крупнейших онлайн‑ритейлеров России (3‑е место по объему онлайн‑продаж в рейтинге Data Insight и Ruward 2016 года E‑commerce Index TOP‑100, 8 место в рейтинге Forbes «20 самых дорогих компаний Рунета — 2017»). На рынке работает 9 лет.

    В ассортименте дискаунтера более 50 000 наименований компьютерной цифровой, бытовой и садовой техники, офисной мебели и других товарных категорий. Более 700 мировых брендов в портфеле. Около 4 000 сотрудников по всей России

  • В 2003 году Мерсико и пятью микрокредитными агентствами Мерсико было принято историческое решение о консолидации активов по всей территории Кыргызстана в целях образования национального финансового института по развитию сообществ - Компаньона. В октябре 2004 года Компаньон был зарегистрирован Национальным банком Кыргызской Республики.

  • «Синтека» — ведущий разработчик инновационных сервисов для строительной отрасли, который решает ключевые задачи автоматизации службы снабжения строительных компаний.

  • Novikov group – первый российский ресторанный холдинг, основанный в 1991 году. Это команда профессионалов под управлением Аркадия Новикова, реализующая широкий спектр услуг в сфере гостеприимства: от проведения event-мероприятия до управления рестораном, от установления стандартов сервиса до контроля качества готовой продукции, от построения бизнес-плана проекта до реализации франшизы.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.