

Загрузка stage слоя DWH. Часть 2
Статья посвящена параметризации NIFI-потока и информированию СУБД об окончании загрузки.
В первой части описан начальный поток, на котором отладили основную модель заполнения stage слоя. Основные принципы: инкрементальная загрузка, формирование служебного поля - хеша для сравнения изменений, загрузка в БД батчем (применительно к MSSQL через BULK INSERT).
Недостатки потока, выяснение в процессе эксплуатации:
- При росте количества источников сложность поддерживать актуальную версию возрастает.
- Начальным процессором является QueryDatabasetable, который не поддерживает входящие соединения. Таким образом, этот процессор мог работать только по одному заданному расписанию.
- Необходимость удаления CSV файла на сервере, откуда MSSQL может забирать данные с помощью BULK INSERT. В мем случае это локальная папка на сервере с MSSQL.
- Экранирование в CSV. В некоторых источниках были поля с очень объемными блоками текста, и экранирование фактически искажало информацию. Стали поступать жалобы от аналитиков о расхождениях при сверках. Само содержание по смыслу не менялось, но автоматические тесты выявляли расхождения с источником.
Для устранения был разработан один общий поток, принимающий на вход FlowFile, в атрибутах которого содержались сведения об исходной таблице и таблице назначения:
|
src.schema |
Исходная схема |
|
src.table |
Исходная таблица/представление |
|
src.table.incrementkey |
Имя поля с инкрементальным ключом |
|
tgt.schema |
Целевая схема |
|
tgt.table |
Целевая таблица |
Получение имен полей
Так как теперь неизвестно, какая именно таблица будет обрабатываться, потребовалось реализовать динамическое извлечение списка имен полей в таблице, для последующего составления правила конкатенации перед расчетом хеша.
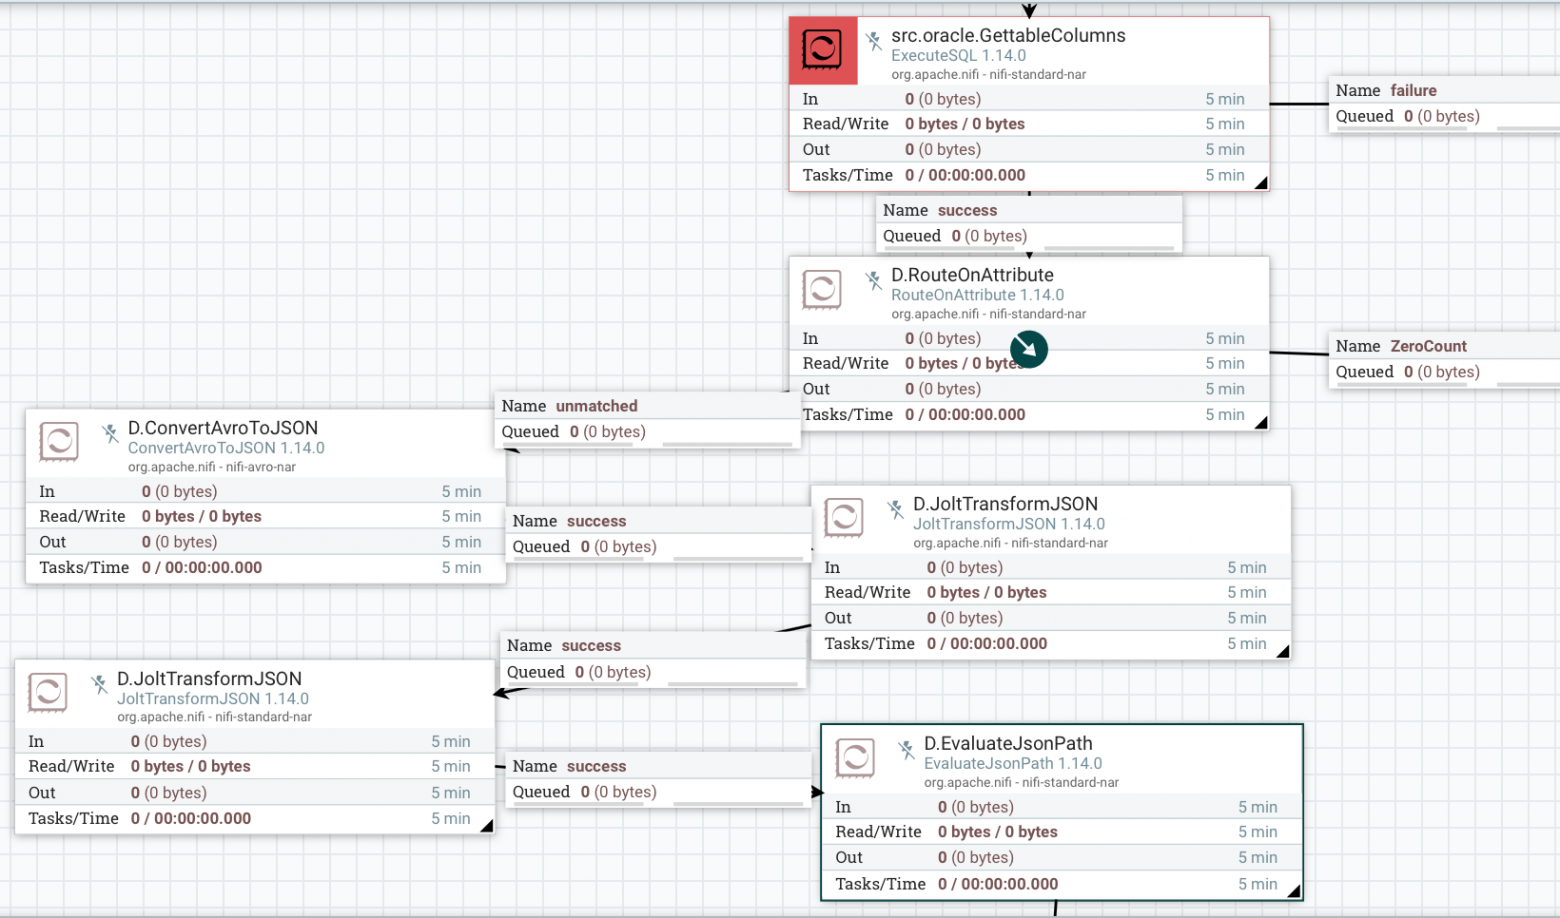
Рис.1. Получение имен колонок. Процесс получения имен полей
Формирование и выполнение запроса
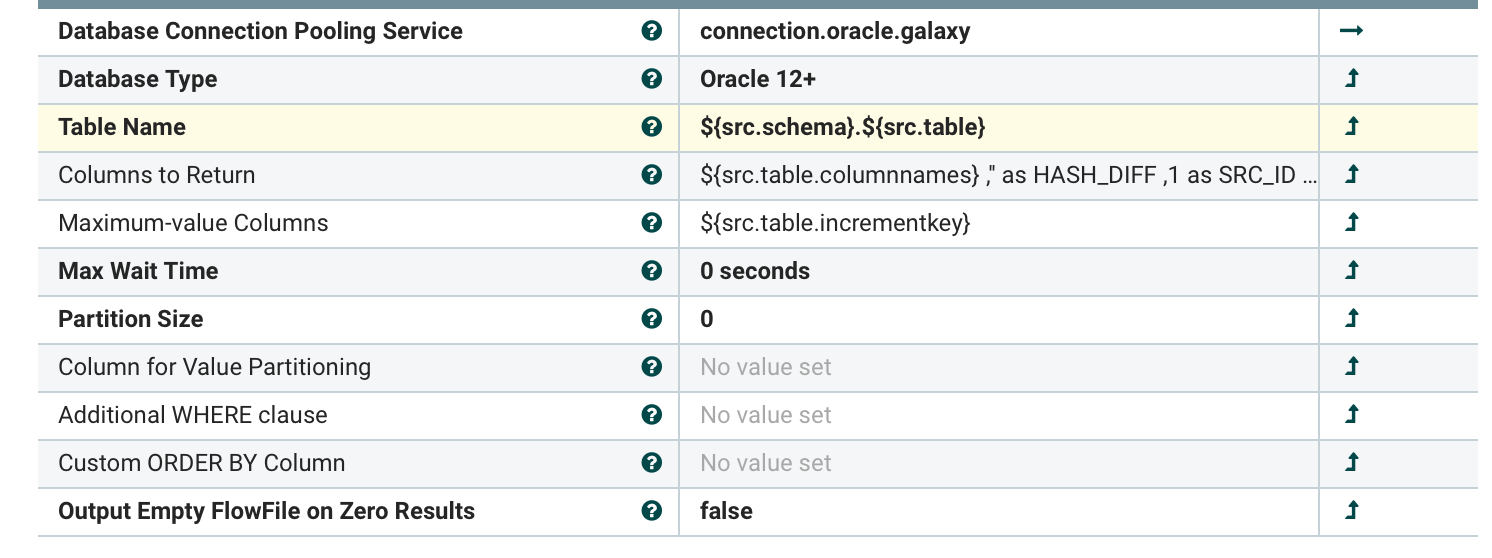
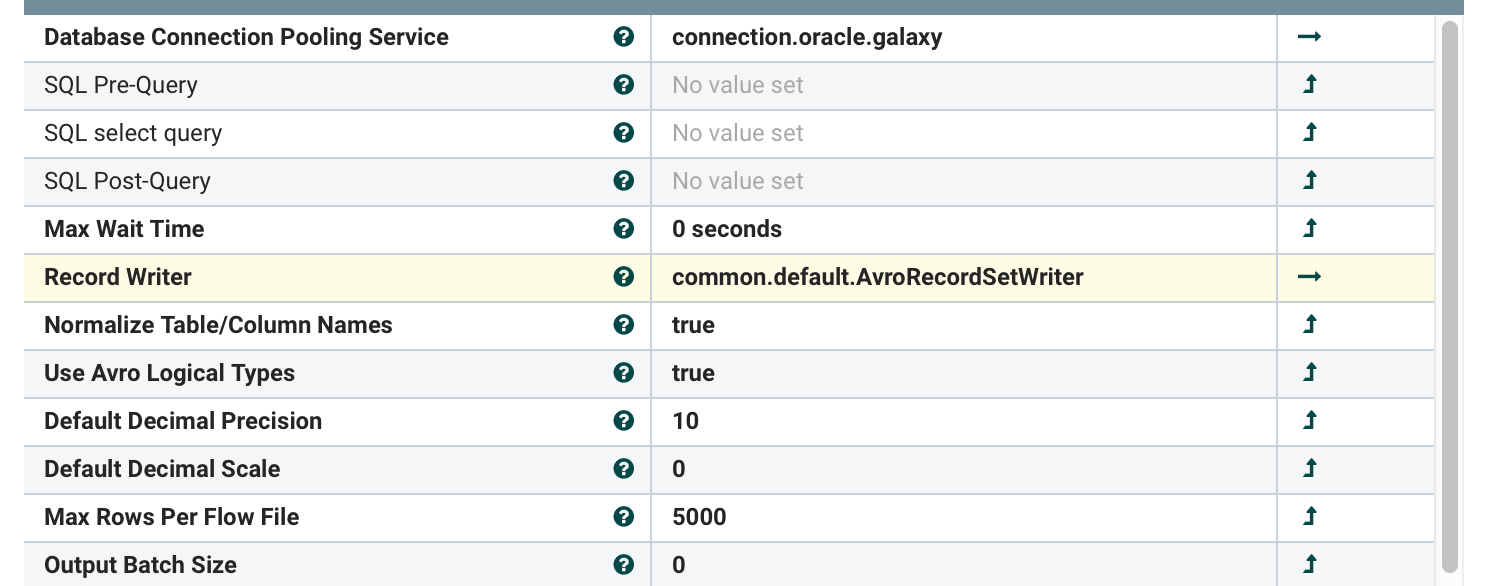
Для того, чтобы сгенерировать запрос, учитывающий наличие списка колонок и инкрементальный ключ удобно применять GenerateTableFetch. Для выполнения запроса применяется ExecuteSQLRecord. Проверка аналогично указаной ранее.
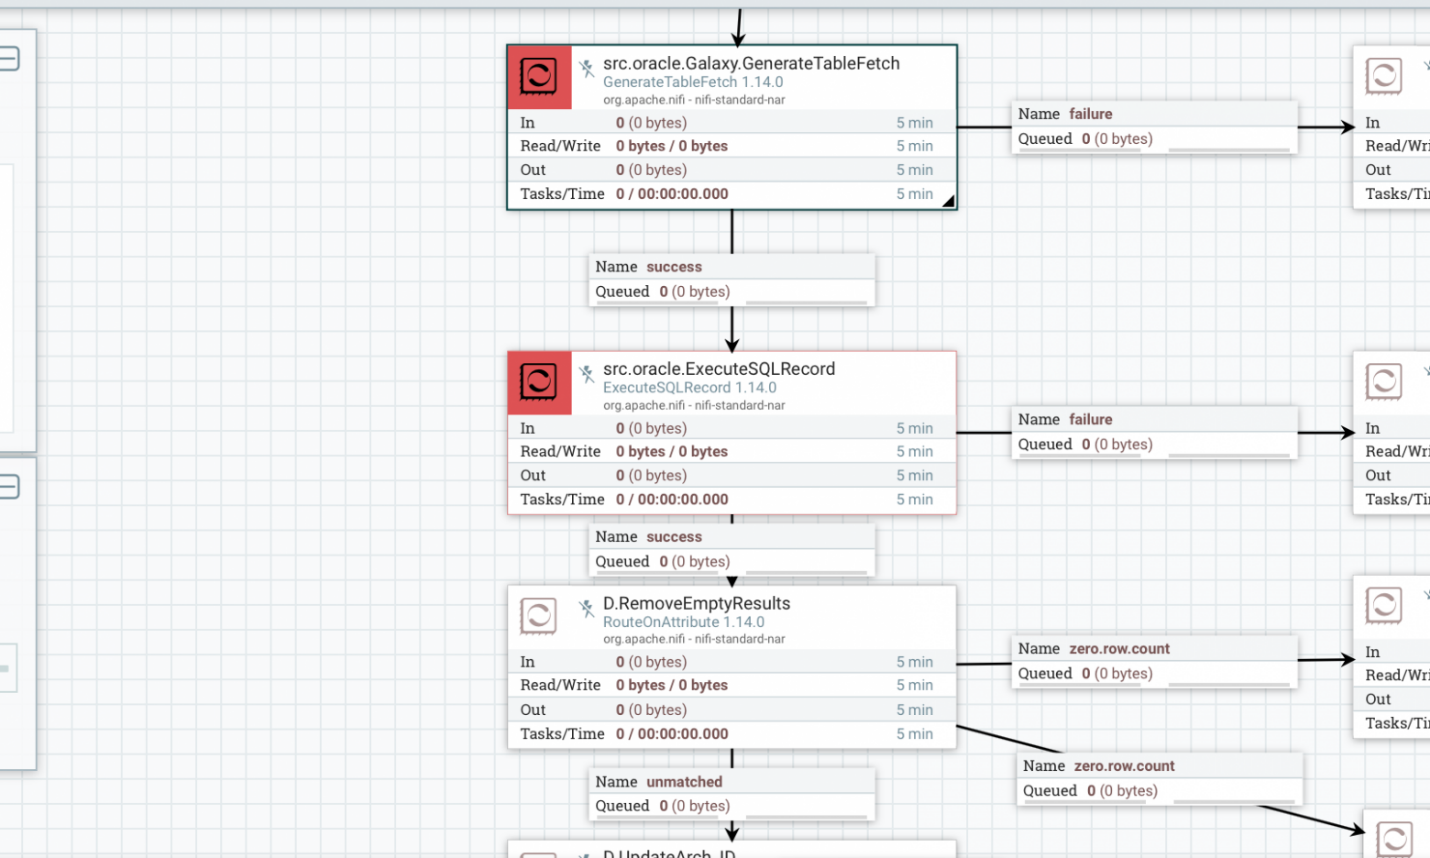
Рис. 2. Генерация и выполнение запросов. Настройки процессоров
Формирование служебных полей для stage слоя
На следующем этапе происходит заполнение служебных полей.
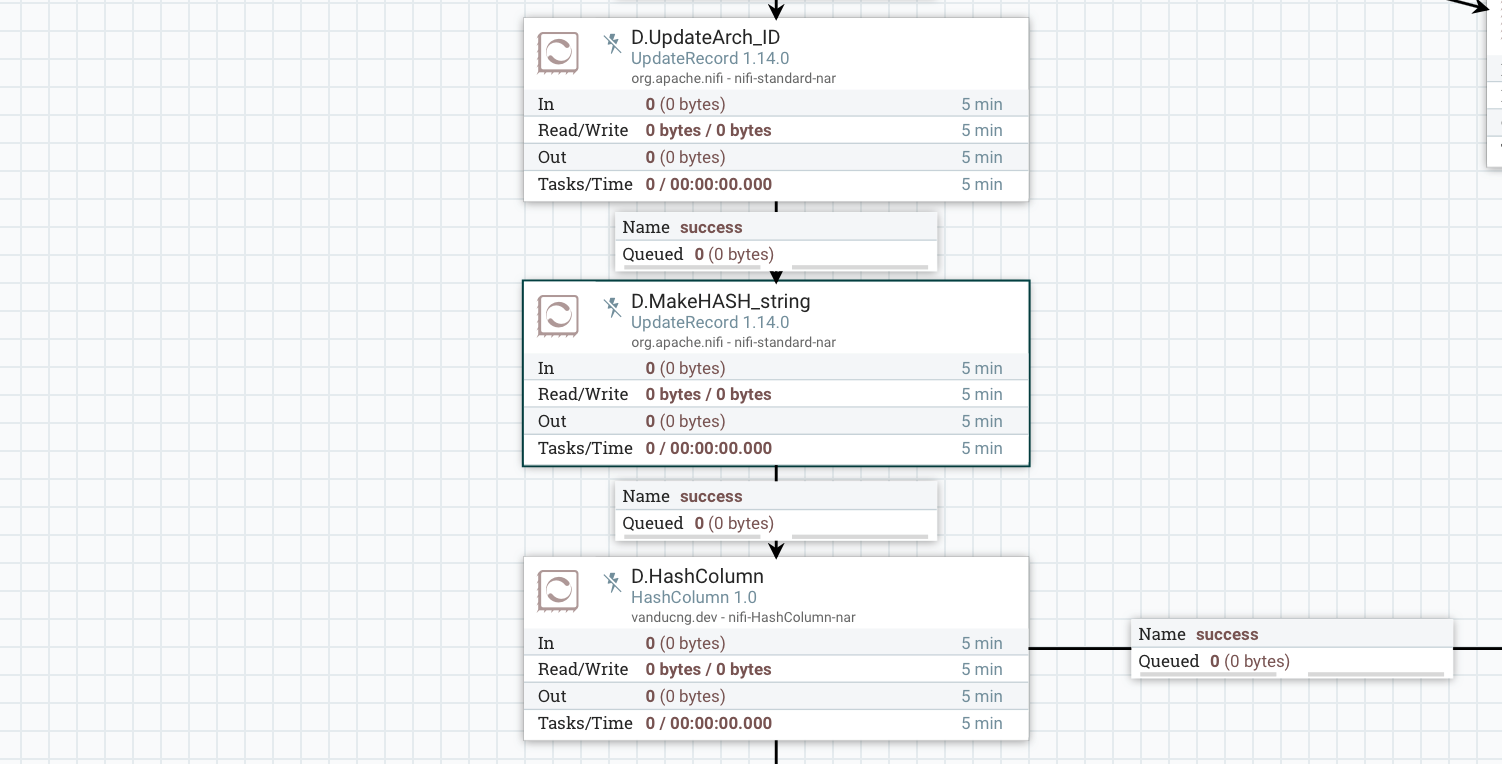
Рис. 3. Формирование служебных полей
Этот этап по сути такой же, как и в первой части статьи.
Однако, не зря же извлекали список колонок...
Внесение в целевую БД
После формирования служебных полей требуется внести данные. Для этого в NIFI есть прекрасный процессор - PutDatabaseRecord. Он берет записи, и применяя JDBC-соединение формирует запрос на вставку данных.
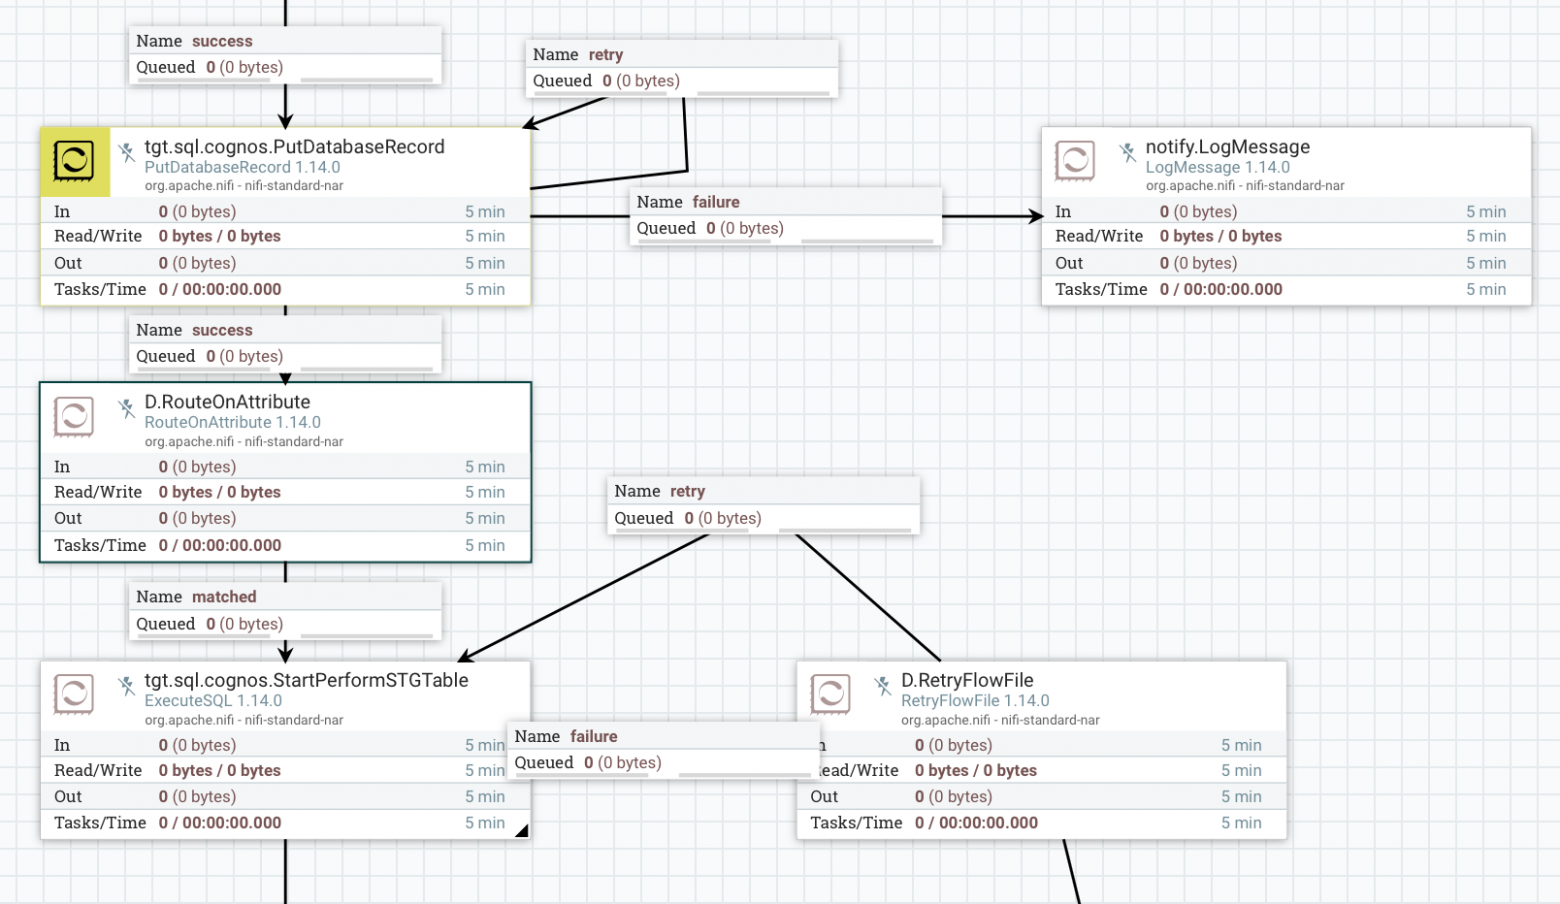
Рис. 4. Внесение данных в целевую БД и вызов служебной процедуры по завершению матча Настройка процессоров
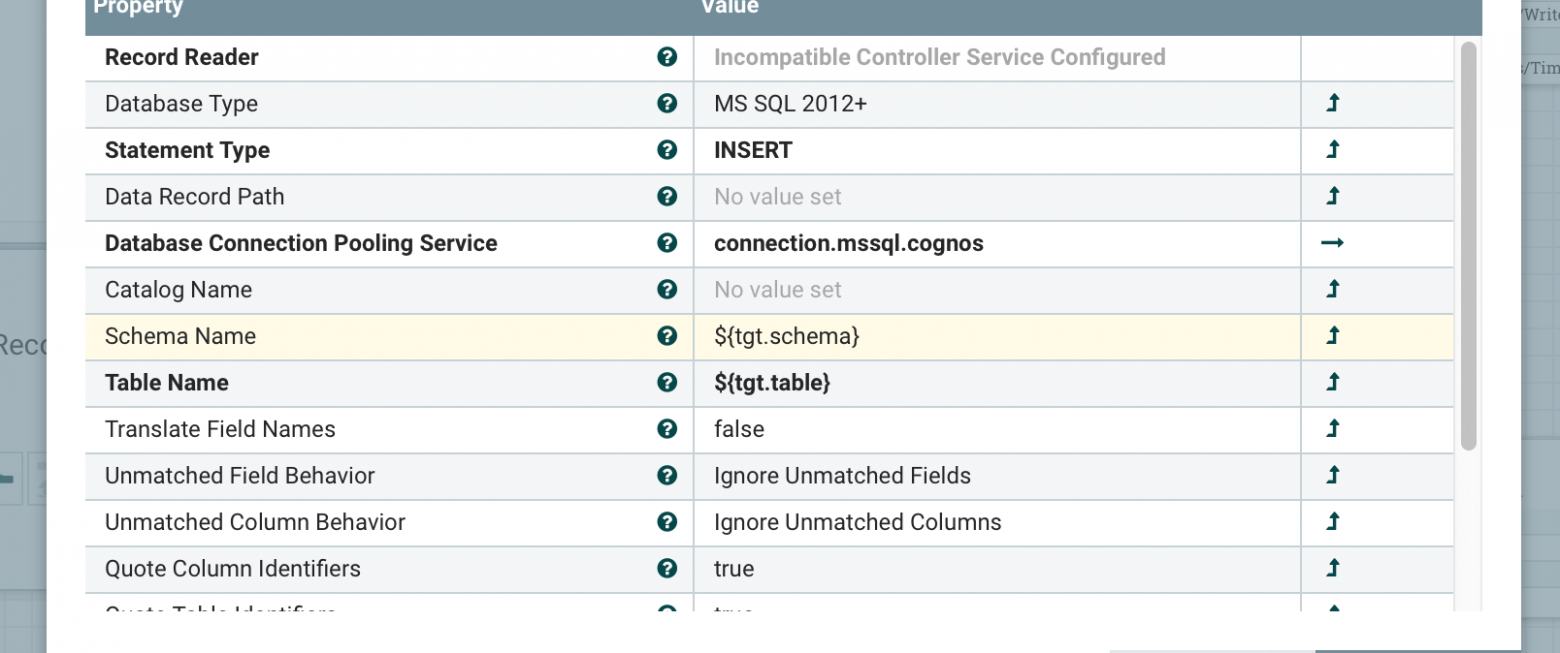
Стоит отметить, что PutDatabaseRecord пробует сформировать батчевую вставку средствами драйвера, т.е. данные будут идти пачкой, а не одной записью.
Замечено, что для корректной работы батчевой вставки требуется, чтобы порядок полей в записи совпадал с порядком полей в таблице. Также для MSSQL, если заменить тип "datetime" в таблице на "datetime2", то профайлере отображается, что батчевая вставка меняется на " BULK" вставку, то есть идет с той же скоростью, что и BULK INSERT, но по сети, без промежуточного файла.
Следующие этапы являются служебными - формирование логов, информирование и т.д.
Заключение
Итак, в результате у меня получился поток, способный принимать на вход имена таблиц в источнике, самостоятельно формировать правило для расчета хеша, и вносить в целевую таблицу со скоростью, сравнимую с BULK INSERT, и информировать целевую систему о завершении загрузки батча.
Достоинства:
- Поддержка потока стала гораздо проще.
- Внедрение новой таблицы - создание во внешней группе процессора GenerateFlowFile с заданными атрибутами и распсианием.
- Скорость внесения сопоставима с BULK INSERT.
Не обошлось и без неприятностей, которые выявились в процессе:
- Появился новый источник - MySQL, а поток заточен под Oracle.
- При многопоточном запуске обработки последний файл мог внестись раньше, чем все остальные. Это связано с тем, что в последнем файле обычно содержится меньше записей, чем порядок разбиения батча, и при расчете служебных полей он успевал проскочить. Партиции переключались, когда не все данные были залиты.
- В некоторых случаях от источника приходили поля типа FLOAT, и они неверно оторажались в Avro, то есть либо округлялись, либо сдвигались.


