

Метрики, SLO и SRE: SLIs, SLOs, их связь с бизнес-целями
Введение в контекст исследования SRE-практик через призму мониторига и бизнес-целей. В рамках курса «Prometheus с нуля» данная глава раскрывает, как метрики переходят из технического слоя в управляемые бизнес-решения: что такое SLIs и SLOs, как они вычисляются на инфраструктурном и прикладном уровне, как внедрять их в процессы разработки и эксплуатации, и каким образом связанные с ними концепции - error budget, burn rate и договоренности с бизнесом - влияют на приоритеты команд и качество сервиса.
Кратко о главе:
- Определение и роль SLI и SLO в контексте Reliability Engineering и бизнес-целей.
- Модели данных и методы расчётов в Prometheus для SLI/SLO, включая latencies и доступность.
- Практические подходы к внедрению SRE-практик: управление error budget, alerting и операционные процессы.
- Связь технических метрик с бизнес-метриками, приемы коммуникации со стейкхолдерами и управление рисками.
- Архитектурные решения и шаги по внедрению SLI/SLO в существующую экосистему мониторинга.
Архитектура и концепции: SLIs, SLOs, SLA и роль в бизнесе
SLI (Service Level Indicator) - показатель уровня сервиса, который объективно характеризует характеристику сервиса, важную для пользователей. SLO (Service Level Objective) - целевой уровень, который должен достигаться по конкретному SLI в заданном окне времени. SLA (Service Level Agreement) - юридически закреплённое соглашение об уровне сервиса между поставщиком и клиентом; SLO часто служит базой для SLA, но не обязательно совпадает с ним по формату и юрисдикции. Разграничение между этими понятиями важно для построения прозрачной договорённости внутри организации и с внешними пользователями.
SLIs выступают «мерами» качества сервиса: доступность, задержка ответа, доля успешных запросов, качество обработки транзакций и т. п. SLOs задают пороги по этим метрикам на фиксированные временные интервалы (например, 99.9% доступности в месяц, p95 задержки менее 300 мс). SLA же определяет, какие последствия наступят в случае их нарушения: штрафы, компенсации, перераспределение ответственности.
Эти концепции применяются в Prometheus как часть архитектуры мониторинга: метрики собираются, агрегируются и превращаются в SLI/SLO через правила расчётов и алерты. Ключевые принципы здесь:
- Выбор реальных пользовательских сценариев: какие запросы, какие конекции, какие пути критичности работают для бизнеса - именно они должны определяться как SLI.
- Прозрачность и валидируемость: SLIs должны быть воспроизводимыми и понятными для команды и стейкхолдерам.
- Разделение горизонтов: SLO на короткосрочные окна (например, 7 дней) и долгосрочные (30/90/365 дней) позволяют балансировать оперативность и стратегические цели.
С точки зрения архитектуры мониторинга SLIs/SLOs часто реализуются через три слоя:
- Метрики уровня инфраструктуры и приложений: latency, error_rate, availability, throughput.
- Логика расчётов SLI/SLO: вычисления по окнам времени, агрегации и нормализации для разных сценариев.
- Алерты и панель мониторинга: оповещения, графики, дашборды, связанные с бизнес-целями.
Понимание баланса между техническими метриками и бизнес-целями критично: техническая «красота» решений не имеет ценности, если она не отражает опыт клиента и коммерческие показатели. В дальнейшем мы рассмотрим, как это соотносятся в Prometheus и сопутствующих компонентах экосистемы.
Важные термины и взаимосвязь
- Availability (доступность): процент времени, в течение которого сервис способен обрабатывать запросы корректно.
- Latency (задержка): время ответа на запрос, часто выражается в квантилях (p95, p99) для устойчивости к выбросам.
- Error rate (уровень ошибок): доля ошибок среди всех обработанных запросов.
- Error budget (бюджет ошибок): допущенное количество ошибок или снижение доступности за заданный период, которое оставляет пространство для изменений и деградаций без потери доверия.
- Burn rate: скорость расходования error budget по отношению к времени; сигнал к действию при нехватке бюджета или его быстром расходовании.
- SLI/SLO/SLI-based contract: связь операционных показателей с договорённостями, участниками и бюджетами изменений.
Определение SLI и SLO: выбор метрик, формулы и пороги
Определение SLI и SLO - это не только технический выбор, но и управленческое решение, которое требует согласования с бизнесом, продуктовым менеджером и командами разработки и эксплуатации. При выборе метрик следует учитывать влияние на пользователя, характер сервиса и частоту изменений.
Ключевые принципы:
- Ориентация на пользовательский опыт: выбор метрик, которые соответствуют тому, что пользователь чувствует и замечает (например, время отклика, успешность транзакций, недоступность API).
- Устойчивость к выбросам: использовать квантильную статистику (p95, p99) и скользящие окна, чтобы исключить влияние кратковременных аномалий.
- Прозрачность и воспроизводимость: формулы должны быть документированы и понятны командам.
Формулы и типы SLIs:
- Availability SLI: отношение количества успешных запросов к общему числу запросов за окно времени.
- Latency SLI: пороговая задержка, обычно задаётся для квантилей (p95, p99) в пределах окна времени.
- Error rate SLI: доля ошибок среди всех запросов (или транзакций) за окно времени.
Пример формулы SLI на основе PromQL:
-
Availability SLI
sum(rate(http_requests_total{job="myservice", status=~"2.."}[5m])) / sum(rate(http_requests_total{job="myservice"}[5m])) -
Latency SLI для p95
histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket{job="myservice"}[5m])) by (le)) -
Error rate SLI
sum(rate(http_requests_total{job="myservice", status!~"2.."}[5m]))
/
sum(rate(http_requests_total{job="myservice"}[5m]))
Формулировка SLO должна включать порог и временное окно. Например:
-
SLO: Availability ≥ 99.9% за календарный месяц.
-
SLO: P95 latency ≤ 300 ms за 30 дней.
-
SLO: Error rate ≤ 0.1% за 7 дней.
Границы и допуски к данным:
- Погрешности измерения: задержки в сборе метрик, задержки в агрегации, потеря данных.
- Временные окна: выбор окна влияет на чувствительность к изменениям (кое окно - оперативно, но шумно; долгое окно - устойчиво, но менее чувствительно к резким изменениям).
- Резкость порогов: слишком жесткие пороги могут привести к частым ложным тревогам и «шуму» в процессе эксплуатации.
Уместно использование recording rules для SLI и SLO: предварительная агрегация и хранение результатов позволяет снизить нагрузку на графики и алерты, ускоряет ответ на инциденты и упрощает аудит. Ниже приведён пример записи правил, которые можно хранить в конфигурации Prometheus.
- **name**: sli_rstate
  rules:
  - **record**: sli_availability
    expr: (sum(rate(http_requests_total{status=~"2..", job="myservice"}[5m])) / sum(rate(http_requests_total{job="myservice"}[5m])))
  - **record**: sli_error_budget
    expr: 1 - sli_availability
  - **record**: sli_latency_p95
    expr: histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket{job="myservice"}[5m])) by (le))
Документация по выбору порогов и горизонтов должна строиться на бизнес-цели и пользовательском опыте, а не только на историческом поведении сервиса. Взаимодействие со стейкхолдерами помогает определить оттенки риска и наиболее значимые сценарии.
Реализация в Prometheus: интеграции, расчёты и алертинг
Prometheus задаёт основу для вычисления SLI/SLO и их мониторинга через мощный язык запросов PromQL и концепцию recording rules. Важными аспектами являются:
- Выбор источников данных: какие метрики и в каком объёме собираются с разных компонентов (приложения, инфраструктура, сетевые устройства, базы данных).
- Структура данных: единообразие метрик, единицы измерения, единицы времени; именование лейблов должно быть согласовано.
- Вычисления SLI/SLO: через PromQL или precomputed recording rules.
Ключевые шаги реализации:
- Определение целевых SLI/SLO с бизнес-операторами и разработчиками.
- Гарантия покрытия критичных путей пользователя в метриках.
- Создание recording rules для SLI/SLO, чтобы упростить запросы в дашбордах и алертах.
- Настройка алертинга через Alertmanager: реагирование на нарушение SLO в рамках предопределённых условий и временных окон.
- Интеграция с дашбордами Grafana или аналогичными инструментами для визуализации Jumps между техническими и бизнес-метриками.
- Нормализация и документирование: обеспечение прозрачности и доступности для всех стейкхолдеров.
Рассмотрим практические примеры конфигураций и запросов.
- Пример SLI и SLO через PromQL (availability, latency, error rate) и их запись через rules:
- **alert**: SLO_Breach_Availability
  expr: (sum(rate(http_requests_total{status=~"2..", job="myservice"}[5m])) / sum(rate(http_requests_total{job="myservice"}[5m])))  0.3
  for: 10m
  labels:
    severity: critical
  annotations:
    summary: "SLO breach: p95 latency above 300 ms"
    description: "95th percentile latency exceeds the SLO threshold for myservice in the last 5 minutes."

- **alert**: SLO_Burn_Rate_High
  expr: rate(1 - sli_availability[5m]) > 0.01
  for: 20m
  labels:
    severity: critical
  annotations:
    summary: "High burn rate of error budget"
    description: "Error budget is being consumed rapidly; escalate to engineering management."
Эти примеры демонстрируют связь между техническими метриками и бизнес-потребностями. В реальном проекте следует адаптировать формулы под конкретные сценарии сервиса и учесть сезонные колебания и резкие пиковые нагрузки. Важно поддерживать единый подход к вычислениям и обеспечить согласованность между командами разработки, эксплуатации и бизнес-стейкхолдерами.
Измерение latency через histogram_quantile требует настройки гистограмм в коде приложения и корректной маршрутизации через проставляемые метрики. Обычно пакет OpenTelemetry и соответствующий экспортёр собирают и отправляют данные в Prometheus, где histogram_quantile может быть применён.
Роль алертинга в контексте SLI/SLO:
- Алерты должны быть релевантными и предсказать нарушение SLO до критического состояния, чтобы дать командам время на решение.
- Важно избегать «алертий-шума» (false positives) за счёт калибровки порогов, учёта погрешностей, коррекции окна и Roma-bias.
- Разделение сценариев: автоматическое писем/сообщения в Slack для оперативной реакции и более формальные уведомления на стороны, ответственные за бизнес-решения.
Связь с бизнес-целями и операционная дисциплина SRE
SRE-принципы переводят технические показатели в бизнес-ценности. Взаимодействие между командой развития, командой эксплуатации и руководством строится через понятие «бюджета ошибок» (error budget) и «burn rate». Это позволяет определить, когда технические изменения могут повлечь риск для клиентов и когда необходима коррекция приоритетов.
- Error budget (бюджет ошибок) представляет собой допущенную долю нарушений SLO в заданном окне времени. Он служит «общей валютой» для дискуссий между функциями продукта, командами разработки и операциями. Если бюджет ошибок истощается быстрее, чем запланировано, приоритеты переключаются в сторону устойчивости и надежности, возможно, снижается выпуск новых функций до восстановления доверия.
- Burn rate (скорость расходования бюджета ошибок) - показатель темпа расходования бюджета ошибок. Он позволяет выявлять аномалии и предотвращать резкие деградации сервиса.
Практические шаги по внедрению бизнес-ориентированного подхода:
- Совместно с бизнес-стейкхолдерами определить критичные пользовательские сценарии и определить соответствующие SLIs.
- Согласовать пороги SLO и окна времени, которые отражают как требования к клиентам, так и возможности инженерного коллектива.
- Внедрить систему уведомлений, которая поддерживает «пороговую» эскалацию: когда SLO нарушается, приоритеты в команде перераспределяются для решения проблемы.
- Обеспечить прозрачность и видимость для бизнеса: предоставление регулярных отчётов, визуализаций и объяснений по каждому SLO.
- Внедрить практику «публичной» регистрации инцидентов и последующей коррекции в кодовой базе и архитектуре, чтобы снижать риск повторных нарушений.
В контексте Prometheus и экосистемы мониторинга:
- Использование recording rules для SLI/SLO упрощает коммуникацию с бизнес-стейкхолдерами, позволяя отделить техническую реализацию от бизнес-интерпретации.
- Grafana dashboards должны четко разделять технические показатели и business KPIs, чтобы стейкхолдеры могли видеть «как сервис ведет себя» в контексте бизнес-целей.
- Alertmanager обеспечивает сценарии эскалации и поддержку с точки зрения бизнес-процессов: кто получает уведомления и какие действия будут предприняты.
Архитектура: как внедрить SLI/SLO в сервис
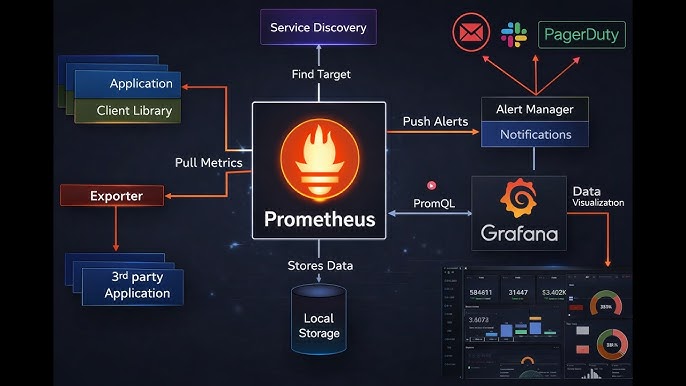
Ниже приводится упрощённая архитектура и практические шаги её реализации в рамках типичной микросервисной инфраструктуры с использованием Prometheus и базовых инструментов синхронного сбора метрик.
- Приложения и сервисы Instrumented: в коде приложений внедряются метрики через клиентские библиотеки или OpenTelemetry, собираются показатели latency, throughput, error_rate и т. п.
- Exporters/Agents: сбор метрик с инфраструктуры и внешних компонентов (база данных, кэш, очереди) через экспортёры.
- Prometheus: основной сборщик и хранилище временных рядов, с организованной схемой лейблов, единиц измерений и согласованной таксономией.
- Recording rules: предвычисление SLI/SLO, чтобы ускорить запросы и алерты.
- Alertmanager: маршрутизация алертов к ответственным людям и системам, поддержка политик эскалации, репортов и интеграций.
- Grafana/Dashboards: визуализация SLI/SLO и связанной бизнес-метрики, а также пользовательских сценариев.
- Встраиваемая аналитика: связь с бизнес-данными через единый «паблик-слой» показателей, чтобы обеспечить аудит и управление рисками.
Практическая памятка по внедрению:
- Начинайте с малого набора критичных сервисов и наборов SLO, которые отражают ключевые пользовательские сценарии.
- Распределяйте SLI по компонентам: клиентская часть, сервис, база данных и внешние зависимости; агрегируйте их на уровне сервиса.
- Устанавливайте умеренные пороги и рост устойчивости: избегайте слишком агрессивных скоростей изменения порогов, чтобы не провоцировать «маниакальные» изменения в графике.
- Периодически пересматривайте SLO по мере изменений бизнеса, пользовательского поведения и технологической архитектуры.
- Документируйте логику расчётов и связи между метриками, SLO и бизнес-решениями.
Пример архитектуры мониторинга для сервиса
Рассмотрим вымышленный сервис "ShopService" в контексте онлайн-торговли. Сервис имеет несколько микросервисов: Catalog, Cart, Payment иRecommendation. Основные SLI/SLO фокусируются на доступности и задержке критических путей.
- Категории метрик:
- Availability: акции 2xx ответов на REST-запросы к каждому сервису.
- Latency: p95 latency для каждого сервиса на критичных путях (Checkout, Payment).
- Error rate: доля 5xx/4xx ошибок по каждом критерию.
- Архитектура:
- Приложения instrumented через OpenTelemetry: сбор latency и статуса ответов.
- Prometheus как сервис мониторинга и база для SLI/SLO.
- Recording rules для SLI/SLO: агрегированные показатели по сервисам.
- Alertmanager: настройка оповещений на SLO-б breaches, burn rate и другие опасения.
- Grafana: дашборды по SLI/SLO, plus бизнес-метрики: конверсия, скорость обработки заказов, средняя стоимость заказа.
- Взаимодействие с бизнес-метриками:
- Установление связей между SLA и бизнес-целями: доступностьcritical path, задержка доставки и возвраты.
- Установление связей между SLA и бизнес-целями: доступностьcritical path, задержка доставки и возвраты.
Порядок действий для внедрения:
- Определить критичные пользовательские сценарии и требования к доступности и задержке.
- Выбрать набор метрик и настроить инструментарий мониторинга.
- Определить SLO по каждому сценарию и установить окна времени.
- Реализовать recording rules для SLI и SLO, а также алертинг.
- Внедрить панели Grafana и сделать отчёты для бизнес-целей.
- Регулярно анализировать и обновлять SLO в зависимости от изменений в продукте и пользовательском поведении.
Key takeaways
- SLIs, SLOs и burn rate - ключевые конструкции SRE, связанные с бизнес-целями и пользовательским опытом.
- Выбор SLI должен основываться на влиянии на клиента и реальных сценариях использования сервиса; применяйте квантильные метрики и надёжные оконные подходы.
- Преобразование SLIs/SLOs в recording rules и алерты в Prometheus снижает нагрузку на систему мониторинга и улучшает реакцию на инциденты.
- Бюджет ошибок представляет собой общую валюту для инженерной и бизнес-команды, помогающую управлять рисками и приоритетами.
- Связь мониторинга с бизнес-метриками требует прозрачности и совместной разработки порогов, а также документирования расчётных формул.
- Эффективная архитектура мониторинга поддерживает связь между техническими решениями и бизнес-целями, включая коммуникацию с заинтересованными сторонами и управление инцидентами.
FAQ
- Что такое SLI и чем он отличается от SLA?
- SLI - измеряемый показатель качества сервиса (например, доступность или latency). SLA - юридический документ, который описывает обязательства сервиса перед клиентами, включая последствия невыполнения. SLI является основой для формулирования SLA, но не обязательно совпадает по формату или срокам.
- Как выбрать SLI для моего сервиса?
- Выбирайте сценарии, которые действительно отражают качество пользовательского опыта: доступность критических путей, ответственность системы в рамках транзакций, время отклика, доля ошибок. Используйте квантильные метрики для устойчивости к аномалиям и обеспечьте согласованность понятий между командами.
- Какие метрики лучше использовать для latency в Prometheus?
- Используйте квантильные измерения через histogram_quantile на гистограммах времени обработки запросов. Это позволяет оценить p95/p99 latency. Важно корректно настроить bucket-метрики и убедиться в совместимости с единицами времени приложения.
- Как обеспечить согласованность порогов SLO между командами?
- Организуйте совместные сессии согласования SLO с участием продуктовой команды, инженерной и эксплуатационной. Документируйте формулы, окна времени и пороги, а затем закрепите их в официальной документации проекта. Регулярно пересматривайте и обновляйте пороги в ответ на изменения бизнеса и архитектуры.
- Что делать, если SLO нарушается регулярно?
- Прежде всего, анализируйте причины: инфраструктурные проблемы, кодовые изменения, внешние зависимости. Возможно, потребуется рост бюджета ошибок, изменение архитектуры или перераспределение ресурсов. Важно иметь план действий и eskalation-правила.
- Каковы лучшие практики по alerting в контексте SLO?
- Алртеры должны быть осуществимыми и своевременными. Используйте временные окна и две ступени оповещения: оперативные для инженеров, и бизнес-ориентированные уведомления для стейкхолдеров. Ограничьте шум за счёт порогов, которые учитывают погрешности измерений и устойчивость к нагрузке.
- Как связать SLO с бизнес-метриками?
- Включайте в дашборды бизнес-метрики, такие как конверсия, средний чек, скорость обработки заказов и др., и показывайте их в контексте SLO. Это позволяет увидеть влияние операционных решений на клиентский опыт и финансовые результаты.
- Что такое burn rate и как его рассчитывать в Prometheus?
- Burn rate - скорость расходования бюджета ошибок. В Prometheus её можно приблизительно оценить как rate(1 - SLI)[период], затем сравнить с порогом. Важна согласованность по окну и единицам измерений.ALERT: BurnRateHigh может триггериться, когда темп расходования бюджета превышает принятые лимиты.
- Какие ограничения есть у Prometheus для SLO?
- Prometheus хорошо подходит для расчётов SLA/SLO на основе history и квантильных измерений, но может потребовать дополнительной подготовки тепловых карт и длительной агрегации для больших объемов данных. В некоторых сценариях целесообразно дополнительно использовать долговременное хранилище (например, Cortex, Thanos) для обеспечения высокой доступности и исторической аналитики по большим временным окнам.
- Какие существуют альтернативы для реализации SLO помимо Prometheus?
- OpenTelemetry в связке с Prometheus-экспортёрами, а также специализированные решения по управлению SRE и SLA, как часть облачных сервисов. Однако для образовательной и практической ценности в рамках курса Prometheus рекомендуется сосредоточиться на Prometheus, Recording Rules, Alertmanager и Grafana как связке инструментов для определения и отслеживания SLO.


