

Prometheus с нуля: архитектура, модель данных и первые системы мониторинга
Prometheus является фундаментом современной observability-инфраструктуры, обеспечивая сбор и анализ метрик в виде временных рядов. Он позволяет быстро развернуть систему мониторинга, начиная от базового сбора метрик с приложений и инфраструктуры до построения первых алертов и дашбордов.
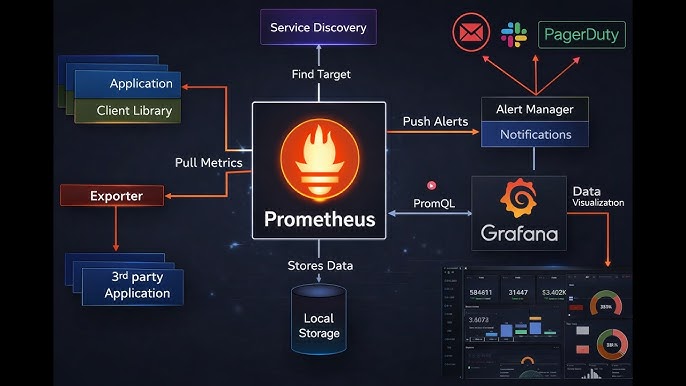
В этом разделе рассматриваются базовые принципы работы Prometheus: pull-модель, targets, exporters, service discovery и модель данных (time series, labels). Особое внимание уделяется настройке сбора метрик, работе с PromQL и построению первичных сценариев мониторинга.
Дополнительно раскрываются вопросы интеграции с Kubernetes, безопасности и CI/CD. Такой подход позволяет быстро перейти от “нулевой точки” к работающей системе мониторинга.
- Введение в мониторинг и ценность Prometheus для бизнеса
- Терминология и базовые концепции Prometheus
- Архитектура системы мониторинга: компоненты и взаимодействия
- Модель данных Prometheus: временные ряды, лейблы и метрики
- Форматы данных и стандарты: OpenMetrics и exposition
- Протоколы и безопасность: HTTP, TLS, базовые механизмы аутентификации
- Сбор метрик: pull-архитектура, targets и job definitions
- Источники данных: статические цели, Service Discovery, DNS
- Экспортеры: концепции и паттерны
- Узлы мониторинга и инфраструктура: node_exporter, blackbox_exporter
- Приложения и instrumentation: библиотечные и автоматические подходы
- Kubernetes и контейнерная экосистема: kube-prometheus-stack и Prometheus Operator
- Хранение метрик и долговременная архитектура: TSDB, retention, compaction
- Алертинг и маршрутизация: Alertmanager, правила и уведомления
- Метрики, SLO и SRE: SLIs, SLOs, их связь с бизнес-целями
- Основы PromQL: синтаксис, операторы и базовые функции
- Расчеты временных рядов: rate, increase, delta и оконные функции
- Продвинутые возможности PromQL и правила: recording_rules, агрегации по лейблам
- Практические запросы и сценарии по инфраструктуре и приложениям
- Визуализация и дашборды: Grafana, панели и панели для мониторинга
- Архитектурные паттерны мониторинга: federation, remote_write и sharding
- Безопасность, доступ и соответствие: RBAC, TLS, секреты и аудиторский след
- Тестирование конфигураций и мониторинга: promtool, unit-тесты, тесты CI
- CI/CD и инфраструктура как код для мониторинга: конфигурации как код, пайплайны
- Экосистема и интеграции: Pushgateway, Thanos, Cortex, Grafana Loki
- Реальные кейсы внедрения: отраслевые сценарии для разных организаций
- Риски, ограничения и типовые ошибки: типичные ловушки
- План зрелости мониторинга: путь от начального к продвинутому уровню
- Эксплуатационная модель: операции, инцидент-менеджмент, runbooks
- Этапы внедрения проекта: дорожная карта, фазы и критерии успеха
- Обучение команд и компетенции: роли и развитие навыков
- Миграции и обновления экосистемы: версии, совместимость, стратегий апгрейда


