

Хранение метрик и долговременная архитектура: TSDB, retention, compaction
Prometheus строит долговременное хранение на базе собственной временной базы данных TSDB. Эффективная структура хранения обеспечивает высокую пропускную способность записи, ускоренные запросы по временным диапазонам и разумную компрессию данных. Эта глава развивает концепцию архитектуры TSDB, объясняет роль WAL, блоков, индексов и механизма компакции, а также исследует политики retention и варианты долговременного хранения данных через локальные и удалённые хранилища.
Долговременное хранение в Prometheus - это не только сохранение данных ради архива. Это влияние на характеристики запросов, потребление дискового пространства и устойчивость к сбоям. Понимание того, как данные переходят из инпута в устойчивые блоки, какие параметры конфигурации управляют размером и временем жизни блоков, позволяет формировать эффективную стратегию мониторинга для проектов различного масштаба.
- Краткое содержание главы
- Архитектура TSDB: компоненты, путь данных от записи до блоков и их назначение.
- Физическая структура: WAL, head, блоки, индексы и компрессия.
- Политики retention: как задавать время хранения, влияние на хранение и запросы.
- Компакция и построение блоков: принципы, параметры настройки и влияние на производительность.
- Практические конфигурации и долгосрочное хранение: локальные хранилища против удалённых, сценарии интеграции и мониторинга.
Архитектура TSDB в Prometheus
TSDB в Prometheus реализует концепцию append-only хранилища с буферизацией на этапе записи и периодической компакцией данных в устойчивые блоки. Элементы пути данных включают запись в WAL, хранение в «head» и последующую фиксацию в блоки на диске. Важная идея: данные в head являются горячими - высокопроизводительная запись и быстрые поисковые операции на текущие временные диапазоны; старые данные консолидируются в блоки и переносятся в долговременное хранение на диске.
-
WAL обеспечивает надёжность и восстановление после сбоев: каждое новое значение сначала идёт в WAL, затем в рабочий пул, после чего периодически данные сериализуются в блоки.
-
Head (верхняя часть TSDB) содержит незавершённые и недавно поступившие данные, предоставляет быстрый доступ к текущим метрикам и минимизирует задержку записи.
-
Блоки данных - базовая единица долговременного хранения. Каждый блок покрывает определённый диапазон времени и включает:
- индекс, позволяющий быстро находить серии по меткам;
- компрессированные чанки с значениями метрик;
- метаданные блока (минимальное и максимальное время, размер, состояние компакции).
-
Компакция - процесс объединения близко расположенных по времени блоков в более крупные, что снижает количество файлов для чтения во время ответов на запросы с широкими временными диапазонами и уменьшает нагрузку на планирование чтения индексов.
Архитектура TSDB ориентирована на баланс между скоростью записи и эффективностью выборок. Ввод-вывод ограничивает задержку, но на практике важнее обеспечить устойчивую компрессию и минимальный объем операций чтения при сложных запросах. В рамках долговременного хранения необходимо учитывать влияние параметров retention и блок-дюрейшн на итоговую производительность.
Физическая структура: WAL, Head, блоки и индексы
План физического хранения можно рассмотреть как стек взаимосвязанных слоёв: WAL, Head и блоки. Каждая часть выполняет свою роль и имеет стратегические параметры конфигурации.
-
WAL (Write-Ahead Log)
- Обеспечивает дисциплину атомарности и устойчивость к сбоям. Каждое новое значение метрики сначала записывается в WAL, после чего попадает в память head и далее в дисковое хранилище.
- Размер сегментов WAL и скорость записи влияют на задержку записи и на возможность быстрого восстановления после сбоев. Большие сегменты снижают число операций на диск, но требуют большего времени восстановления.
-
Head
- Горячая часть TSDB, где происходят сегментация и форматирование входящих данных.
- Данные в head представляют собой серию временных рядов, каждый из которых хранится как набор чанков. В head существуют временные ограничения и конвергенции, чтобы оптимизировать дальнейшую компакцию и запись на диск.
- Запросы по текущим данным чаще обрабатываются быстрее, поскольку head располагается ближе к памяти и кэшам.
-
Блоки
- Фиксированные по времени файлы на диске, которые содержат как индекс, так и чанки значений.
- Блок имеет временной диапазон [minTime, maxTime], который определяет, какие записи в него попали.
- Индекс блока обеспечивает быстрый поиск по меткам и сопоставление серии с соответствующими чанками. Индекс обычно хранится отдельно и имеет собственный набор файлов внутри блока.
- Чанки внутри блока - это сериальные данные по метрикам; они обычно сжимаются для экономии пространства. Сжатие может применяться на уровне блока и внутри чанков, что снижает итоговый размер хранилища и ускоряет последовательное чтение.
-
Индексы и поиск
- Индекс позволяет быстро определить, какие чанки содержат данные для заданной метрики (сет метрик с определёнными лейблами).
- Поиск по диапазону времени и по метрикам выполняется через чтение соответствующих блоков и соответствующих чанков внутри блока.
Композиция WAL → Head → Блоки обеспечивает устойчивость к сбоям и высокую производительность. При этом блоки в статусе только разрешены к чтению и не изменяются после создания, что упрощает параллельное чтение и кэширование.
Политики retention и долговременная архитектура
Retention определяет, как долго хранить данные локально и какие объёмы дискового пространства выделять под историю событий. В Prometheus retention может задаваться в виде времени (например, 30d, 90d) и/или объёма (например, 500GB). Правильная настройка retention требует баланса между ценой хранения, желаемым горизонтом аналитики и нагрузкой на запросы.
-
Влияние retention на хранение
- Более длинный retention увеличивает потребление диска и может повлиять на скорость операций компакции и синхронной записи.
- Небольшая величина retention приводит к меньшему объему данных, но ограничивает возможность аналитических запросов на длительных диапазонах и истории поведения системы.
-
Взаимодействие retention с блоками
- Блоки создаются и удаляются в зависимости от политики retention, а также от параметров компакции. Удаление старых блоков освобождает место на диске и снижает нагрузку на поиск.
- Важна взаимосвязь retention и периодов компакции: длительная компакция может ускорить чтение по широким диапазонам, но требует больше времени на переработку данных при изменениях.
-
Роль локального vs удалённого хранения
- Локальное хранение TSDB обеспечивает минимальную задержку и автономную работу Prometheus, но ограничивает горизонты хранения и доступности в случае потери узла.
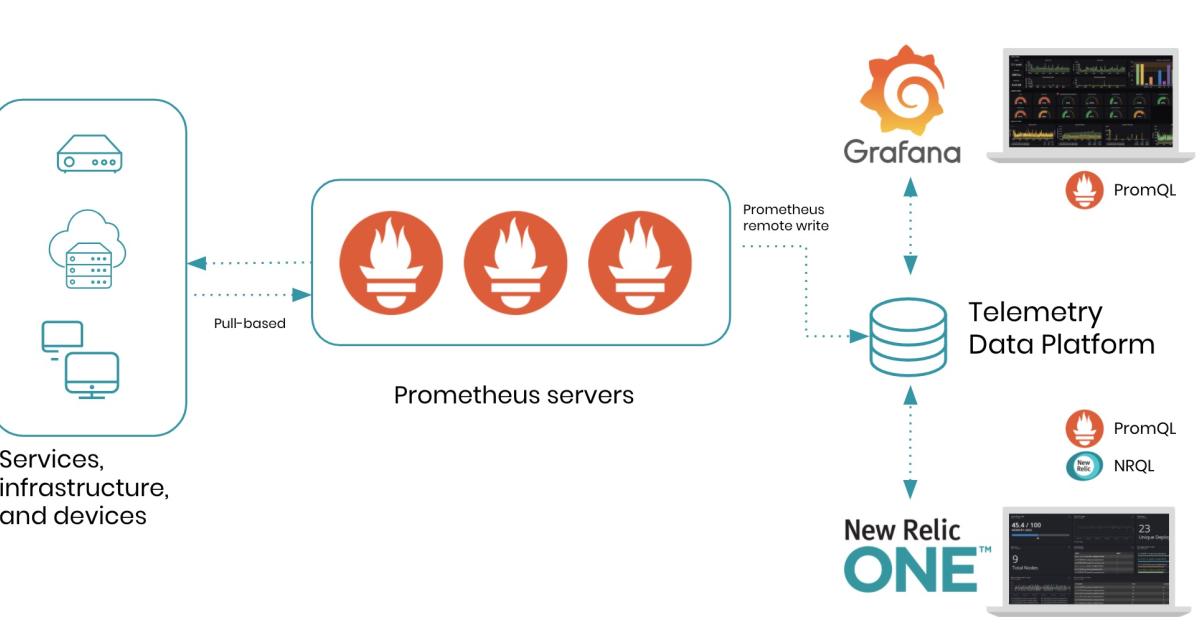
- Для долгосрочного хранения широко применяется удалённое хранилище через механизмы remote_write и/или интеграции с Thanos, Cortex и другими системами. В таких сценариях retention на локальном TSDB может быть сокращён, чтобы освободить место, а долгосрочная аналитика и архивы ведутся в удалённых хранилищах.
-
Применимость на практике
- Рекомендуется начинать с бизнес-объёма и целей мониторинга: какой горизонт анализа нужен для SLA/SLO и какова стоимость хранения. Далее настраиваются retention-теги и корректировки под рост объёма данных.
- Мониторинг хранения - неотъемлемая часть эксплуатации: контроль использования дискового пространства, числа блоков, плотности чанков и частоты компакции. Это помогает вовремя реагировать на перегрузки и корректировать параметры.
Компакция и построение блоков: принципы и влияние на производительность
Компакция - центральный механизм управляемости хранилища, который обеспечивает эффективную агрегацию данных, уменьшение числа файлов и ускорение запросов. В Prometheus компактор работает по временным блокам и аллоцирует их в фиксированном диапазоне времени.
-
Блочная структура и принцип компакции
- Блоки имеют фиксированные временные диапазоны. В процессе компакции соседние блоки объединяются в более крупные, чтобы формировать оптимальные диапазоны для запросов.
- Компактор выполняет перерасчёт индексов и чанков, создавая новые блоки и удаляя устаревшие. В результате возрастает вероятность того, что диапазоны запросов перекрываются меньшим числом блоков, что снижает IO и ускоряет поиск.
-
Влияние на запросы
- Меньшее число блоков и более крупные интервалы позволяют выполняться более эффективными обходами индексов и уменьшить время сканирования больших временных окон.
- Однако агрессивная компакция может повлечь за собой более долгие пики задержек записи и переработки блоков в периоды высокого ввода. Поэтому конфигурацию следует подбирать балансом между задержкой записи, временем компакции и производительностью запросов.
-
Параметры конфигурации компакции
- В Prometheus можно управлять целесообразными диапазонами блоков через параметры min-block-duration и max-block-duration (включая минимальный и максимальный размер блока). Эти параметры определяют границы, в рамках которых компактор группирует данные.
- Также настраиваются задержки и частота создания новых блоков, что влияет на задержку в записи и актуальность данных в блоках.
-
Учет резервных копий и удаления
- Поскольку блоки являются неизменяемыми после записи, удаление старых данных реализуется через удаление целых блоков. Это обеспечивает быстроту освобождения пространства и упрощает менеджмент версии данных.
- В сценариях удалённых хранилищ (remote_write) компакция на TSDB-уровне не отменяет необходимость периодической синхронизации в удалённое хранилище, где данные сохраняются дольше.
Настройки и эксплуатация: как управлять хранением
Эффективная работа долговременного хранения требует продуманной конфигурации и наблюдения за поведением TSDB.
-
Базовые настройки
- retention.time: задаёт время локального хранения данных (например, 30d, 90d). Эффект - старые блоки будут удаляться по мере приближения к порогу retention.
- retention.size: ограничение объема локального хранилища, если задано. Это обеспечивает контроль над использованием диска.
- min-block-duration и max-block-duration: задают диапазон длительности блоков, через которые проходит компактация. Они влияют на частоту создания блоков и их размер.
- allow-overlapping-blocks (если поддерживается версией): настройка поведения перекрывающихся блоков и конфликтов в процессе компакции.
-
Мониторинг и диагностика
- Важно отслеживать метрики TSDB, связанные с HEAD и блоками: нагрузку на WAL, размер head-файлов, количество блоков, среднее и максимальное время жизни блока, темпы удаления старых блоков.
- Контроль использования диска и скорости компакции помогает оперативно корректировать настройки, чтобы избежать перегрузки дискового массива и задержек в запросах.
-
Практические рекомендации
- Начинайте с разумного периода retention, соответствующего требованиям бизнеса и объему данных. По мере роста системы постепенно увеличивайте retention и корректируйте параметры блока.
- При необходимости обеспечения долгосрочного хранения - интегрируйте Prometheus с удалённым хранилищем: Thanos или Cortex, чтобы сохранять исторические данные в отдельном слое и не перегружать локальное TSDB.
- Регулярно тестируйте сценарии отказа: сбой узла Prometheus, перезапуск, сброс WAL. Убедитесь, что восстановление после сбоев работает за разумное время и данные остаются консистентными.
-
Практика и сценарии внедрения
- В небольших проектах можно стартовать с локального retention и ограниченным блоками, а затем подключать удалённое хранение для архивации и длительной аналитики.
- Для крупных инфраструктурных проектов целесообразно рассмотреть гибридные схемы: локальный TSDB для оперативной аналитики и удалённое хранение для архива, поддержки SLA и аудита.
Интеграции и долгосрочное хранение: сценарии и практики
Для обеспечения масштабируемости и соответствия требованиям к хранению данных часто применяется архитектура с удалённым хранением. Прямой локальный retention может быть ограничен ввиду ограничений дискового пространства и скорости доступа, поэтому интеграции с внешними системами являются распространённой практикой.
-
remote_write и remote_read
- remote_write позволяет перенаправлять поток метрик в внешние хранилища одновременно с локальным TSDB. Это обеспечивает сохранение истории и доступ к данным вне узла Prometheus.
- remote_read позволяет выполнять запросы к удалённому хранилищу как к источнику данных в рамках одного запроса PromQL, расширяя горизонты аналитики.
-
Популярные решения
- Thanos и Cortex - примеры решений с открытым исходным кодом, которые позволяют строить глобальные индексы и единое хранилище для нескольких инстансов Prometheus, обеспечивая долгосрочное хранение и масштабируемость.
- В рамках локальных цифровых архитектур можно рассмотреть интеграцию с облачными хранилищами через remote_store, чтобы выгружать данные в S3/Wasabi и др. С учётом задержек и стоимости доступа к данным, следует аккуратно подбирать параметры архивации и частоту выгрузок.
-
Архитектура будущего
- Гибридная архитектура, совмещающая быстрый локальный TSDB для оперативной аналитики и долговременное удалённое хранилище; запросы могут выполняться локально или через удалённые источники, в зависимости от диапазона времени и конкретной задачи.
- Выбор подхода во многом зависит от требований к задержкам, SLA, объёму данных и бюджета.
-
Управление изменениями и процессы
- Внедрение долговременного хранения требует обновления процессов мониторинга и изменений в политике обработки инцидентов: как мы восстанавливаем сервис после сбоев, как строится политика архивации, как осуществляется аудит старых данных.
- Рекомендована строгая процедура изменения retention и консервация изменений, чтобы избежать потери данных и несоответствия ожиданиям бизнеса.
Key takeaways
- TSDB Prometheus разделяет данные на head и устойчивые блоки; WAL обеспечивает надёжность записей и восстановление после сбоев.
- Блоки - это фундаментальная единица хранения; они содержат индекс и сжатые чанки данных и закрыты для изменений после создания.
- Компакция упрощает запросы по длительным диапазонам за счёт снижения количества блоков, но требует балансирования с задержками записи и нагрузкой на систему.
- Retention определяет горизонты анализа и влияние на дисковое пространство; его настройка должна учитывать требования к аналитике и доступность данных.
- Для масштабируемых сценариев и архивации целесообразна интеграция с удалёнными хранилищами (Thanos, Cortex) через remote_write/remote_read.
- Мониторинг параметров TSDB (head, блоки, компакция, удаление старых блоков) необходим для устойчивой эксплуатации.
- Правильная конфигурация требует итеративного подхода: начать с базовых значений, затем адаптировать под рост объёмов, скорость входа метрик и требования к аналитике.
FAQ
- Что такое TSDB в Prometheus и зачем она нужна?
TSDB - это специализированная временная база данных, оптимизированная под большой объём данных и частые запросы по диапазонам времени. Её архитектура разделяет данные на head (горячие, быстро пишущиеся данные) и блоки (устойчивые изображения данных), что обеспечивает баланс между высокой скоростью записи и эффективными запросами к длинной истории. WAL дополняет надёжность: данные сначала записываются в журнал перед записью в память и на диск, что упрощает восстановление после сбоев.
- Как работает компакция блоков и зачем она нужна?
Компакция объединяет соседние блоки в более крупные, чтобы уменьшить число файлов, упростить поиск и улучшить производительность чтения при запросах по широким временным диапазонам. Правильная настройка min-block-duration и max-block-duration позволяет контролировать баланс между задержкой записи и скоростью чтения, предотвращая чрезмерную частую переработку и перегрузку диска.
- Какие параметры retention стоит использовать в продакшене?
Начните с реального горизонта аналитики и доступного дискового пространства. Установите storage.tsdb.retention.time в диапазоне, соответствующем бизнес-требованиям, и при необходимости добавьте storage.tsdb.retention.size для контроля объёма. При внедрении удалённого хранения retention локального TSDB может быть сокращён, чтобы освободить место под архивные данные.
- Что даёт удалённое хранение через Thanos или Cortex?
Удалённое хранение обеспечивает глобальную долговременную аналитическую перспективу и устойчивость к потере локального узла. Thanos/Cortex позволяют строить единое глобальное хранилище из нескольких инстансов Prometheus, обеспечивая единый интерфейс запросов и единый архив данных.
- Как тестировать производительность хранения перед выпуском?
Планируйте нагрузочное тестирование с реалистичной скоростью входа метрик, проверьте влияние retention на дисковое пространство и на время компакции, проведите тесты восстановления после сбоев и мониторьте показатели HEAD и блоков. Прогон тестов поможет определить правильные пороги для min/max-block-duration и retention.
- Какие сигналы указывают на необходимость изменения конфигурации TSDB?
Увеличение задержек записи, медленная реакция на запросы при длинных диапазонах, рост использования дискового пространства без прироста полезной аналитики - все это сигналы к пересмотру параметров retention, размеров блоков и частоты компакции.
- Какой путь интеграции с удалённым хранением выбрать в зависимости от условий?
Для небольших и средних проектов - локальное хранение с умеренным retention и плановой интеграцией remote_write может быть достаточно. При необходимости глобального анализа исторических данных или повышения отказоустойчивости следует рассмотреть Thanos или Cortex для объединения данных и обеспечения долгосрочного архива.
- Что важно учесть при проектировании гибридной архитектуры хранения?
Необходимо учесть задержки доступа к удалённому хранилищу, стоимость хранения и обслуживания. В гибридном решении локальный TSDB обеспечивает оперативную аналитику, тогда как удалённое хранилище сохраняет историю на долгий срок. Важна корректная маршрутизация запросов и согласование времени жизни данных между уровнями.
- Какие ограничения существуют у локального TSDB?
Локальное хранилище ограничено физическим объёмом дисков и пропускной способностью узла. Большие горизонты retention или очень частая компактация могут увеличить задержки записи и нагрузку на диск. Поэтому для масштабирования часто применяется удалённое хранение и горизонтальное масштабирование через внешние решения.
- Какую роль играет мониторинг самого TSDB?
Мониторинг TSDB критично важен: он показывает нагрузку на WAL, размер head, активность компактора, количество блоков, скорость удаления старых данных и объём занимаемого диска. Эффективный мониторинг позволяет своевременно корректировать конфигурацию и поддерживать баланс между записью и чтением, а также между локальным и удалённым хранением.


