

План зрелости мониторинга: путь от начального к продвинутому уровню
Мониторинг на базе Prometheus является не только техническим инструментом, но и управленческой практикой. Зрелость мониторинга отражает способность организации видеть состояние системы, предвидеть проблемы и оперативно реагировать на инциденты через качественные метрики, четкие правила алертинга и эффективную архитектуру данных. Данная глава описывает план зрелости мониторинга по шагам: от базовой видимости к продвинутым практикам масштабируемости, автоматизации и инженерной культуре наблюдаемости. Рассматриваются архитектурные решения, модель данных, процессное оформление и практические паттерны внедрения, применимые к облачным и гибридным средам.
Глубина изложения ориентирована на технические аспекты: архитектуру, схемы взаимодействий, алгоритмы обработки данных, протоколы экспонирования и интеграции с экосистемой Prometheus. В тексте приведены принципы проектирования метрик, требования к качеству данных и пути эволюции инфраструктуры мониторинга в условиях роста объема источников данных, числа сервисов и требований к SLA.
- Краткое содержание главы
- Определение уровней зрелости мониторинга и их критериев.
- Архитектure Prometheus на разных стадиях, роль exporters, service discovery и Alertmanager.
- Модель данных: нейминг, лейблы, агрегации, качество метрик и управление временем.
- Практический план перехода: чек-листы, контрольные точки и примеры внедрения.
Контекст зрелости мониторинга
Зрелость мониторинга следует рассматривать как последовательность изменений в технологиях, процессах и культуре команды. В начале фокус усиливается на выживании системы под давлением инцидентов: видимость ограничена критичными сервисами, база метрик маленькая, алертинг реагирует только на простые пороги. По мере взросления организации переходят к системной архитектуре мониторинга: единая стратегическая модель метрик, стандартизованный процесс добавления метрик, качественный алертинг и оперативное обслуживание инцидентов с привязкой к Runbook и автоматическим реакциям.
В контексте Prometheus зрелость достигается не только за счет добавления узлов или источников метрик, но и через синхронизацию между технологической реализацией и организационными практиками. Важным элементом является согласование между командами разработки, инфраструктуры и эксплуатации: единые правила именования метрик, согласованные лейблы, понятные алерты и проверяемые dashboards. Такой подход позволяет не только накапливать данные, но и превращать их в управляемый актив, который упрощает планирование капитальных изменений, ускоряет устранение причин инцидентов и повышает устойчивость системы в целом.
От чего зависит зрелость: инфраструктура, процессы, данные
Зрелость мониторинга определяется тремя взаимосвязанными pillars: инфраструктурой сбора и хранения данных, процессами управления ими и качеством самих данных. Архитектурно Prometheus обеспечивает гибкую, масштабируемую модель сбора метрик через pull-трафик и экспозицию данных в формате Prometheus exposition. Однако реальная зрелость требует: продуманной стратегии хранения и retention, эффективной политики ретривала и апдейтов экспортеров, четкой политики именования и лейблинга, хорошо описанных runbooks, автоматизированной проверки метрик и непрерывного тестирования алертинга.
Данные на поверхности - это не только временные ряды. Это данные контекста: метки, которые описывают источник, окружение, версию сервиса, роль узла, регион и другие критически важные параметры. Наличие унифицированной модели лейблов позволяет проводить кросс-сервисный анализ, реплицировать данные в централизованные хранилища, строить сложные правила алертинга и формировать понятные дашборды. В результате достигается предсказуемость поведения мониторинга при масштабировании, обновлениях кода и миграциях инфраструктуры.
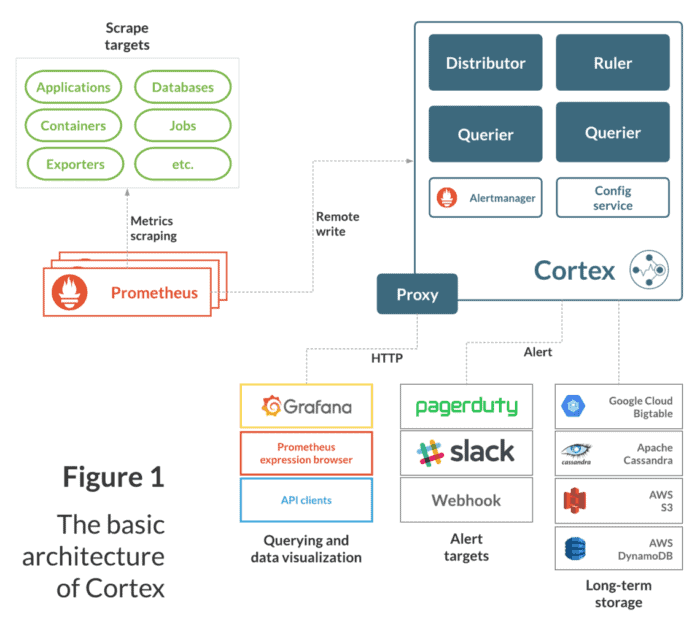
Архитектура мониторинга Prometheus и переходы между уровнями
Архитектура Prometheus складывается из нескольких ключевых компонентов: Prometheus сервер как сборщик временных рядов, TSDB как хранилище, exporters как адаптеры внешних систем к формату метрик, сервис-дискoвери и механизм alerting через Alertmanager, а также системы визуализации, такие как Grafana. На разных уровнях зрелости эти компоненты дополняются дополнительными паттернами: федерацией, remote_write/remote_read, расширенными правилами ретрансляции и автоматизацией разворачивания.
Важно помнить, что архитектура мониторинга - это не набор поделенных компонентов, а конвейер обработки данных от источников к действиям. На начальном уровне достаточно минимального набора источников: базовые сервисы и базовые метрики, простые правила алертинга и dashboards. По мере роста числа сервисов и окружений архитектура усложняется: внедряются промаршрутизированные слои для федерации, многократные кластеры Prometheus, кэширование и агрегирование на уровне внешних систем, а также расширение возможностей Alertmanager.
Архитектура на начальном уровне: базовая сборка и хранение
На старте задача состоит в создании минимального контура, который обеспечивает устойчивое наблюдение за критическими сервисами. Это включает в себя один или несколько prometheus-серверов, набор основных экспортеров (для примерных системных метрик, баз данных и очередей), простые правила алертинга и единую панель Grafana. В этом контексте важно установить базовые принципы именования метрик, единицы измерения и лейблы, чтобы предотвратить дублирование данных и неразбериху в запросах.
Технически базовая архитектура обеспечивает pull‑модель: Prometheus регулярно опрашивает источники метрик через HTTP exposition. Взаимодействие с Alertmanager позволяет централизовать алерты и маршрутизировать их в чаты, тикеты или сервисы инцидент-менеджмента. На этом уровне критически важно обеспечить устойчивость к сбоям: параллельность сборов, retries, тайм-ауты, базовые схемы ретенции и резервирования sowie мониторинг самого Prometheus.
Расширение архитектуры: масштабируемость, федерация и remote‑write
По мере роста числа сервисов и потребностей в долгосрочном хранении применяется федерация и удаленная запись в центральный система хранения. Федерация позволяет агрегировать данные по нескольким кластерам Prometheus, сохраняя независимость команд, но обеспечивая аналитическую консолидацию. Remote_write и remote_read позволяют отправлять данные в внешние хранилища для долговременного хранения, интеграции с аналитическими инструментами и резервирования. В агрессивной среде корпоративной инфраструктуры эти механизмы необходимы для поддержки многокластерных развертываний, разделения по окружениям (dev, staging, prod) и соответствия требованиям compliance.
При внедрении удалённой записи стоит учитывать задержку данных, стоимость хранения и согласованность. Выбор целевых хранилищ (например, собственное решение или облачный сервис) диктует требования к формату данных, инструментам запросов и мониторингу самого хранилища. В рамках архитектуры также расширяются механизмы service discovery: DNS- и конфигурационные сервисы, такие как Kubernetes SD, Consul, Zookeeper, облачные провайдеры, что позволяет снижать операционные нагрузки и повышать адаптивность к изменению топологий.
Интеграции и сервис-дискoвери: как эволюционируют
С ростом числа источников метрик требуется более структурированная диагностика источников. Service discovery становится основным способом обнаружения целевых услуг: Kubernetes, ECS, Mesos, открытые сервисы и прочие динамические окружения. Использование Kubernetes Service Discovery, файловых политик sd или сторонних решений позволяет автоматически подхватывать новые сервисы и перегонять метрики без ручной настройки.
Readers должны оценивать баланс между полнотой сбора и стоимостью. Например, добавление каждого нового экспортера должно сопровождаться контролируемым внедрением: проверкой качества метрик, дубликатов и корректной агрегации. В продвинутых сценариях применяются фильтры relabel_configs, чтобы обеспечить консистентность имён метрик и лейблов, исключить лишние данные и привести набор метрик к единой схеме.
Алгоритмы и протоколы: pull против push, Prometheus exposition format, service discovery
Основной протокол экспонирования - Prometheus exposition format, передающий данные по HTTP. Протокол не требует модификаций сервисов, что упрощает интеграцию и уменьшает нагрузку на источники. Тем не менее, в некоторых случаях, особенно для нестандартных приложений или отсутствующих экспортерах, применяются push-gateway или кастомные адаптеры. Выбор подхода должен отражать характер приложения, частоту обновления метрик и требования к задержкам в мониторинге.
Service discovery является ключевой технологией в динамичных средах. Kubernetes позволяет широко использовать sd через kubernetes_sd_configs, а для гибридных архитектур применяются dns_sd, file_sd и Consul. Важным аспектом является корректная re-labeling: перемещение источников в нужные группы, удаление нерелевантных метрик, нормализация имен и единиц измерения. Обоснованная конфигурация reduces шум и упрощает последующую агрегацию и анализ.
## Пример упрощенной конфигурации scrape_config с Kubernetes SD и relabeling
scrape_configs:
  - **job_name**: 'kubernetes-pods'
    kubernetes_sd_configs:
      - **role**: pod
    relabel_configs:
      - **source_labels**: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
        action: keep
        regex: true
      - **source_labels**: [__meta_kubernetes_pod_annotation_prometheus_io_path]
        target_label: __metrics_path__
      - **source_labels**: [__meta_kubernetes_pod_name]
        target_label: instance
Такой подход позволяет динамически адаптироваться к изменениям в кластере и сводит к минимуму ручное администрирование конфигураций. Однако он требует тестирования изменений конфигурации и автоматизированных проверок целевой видимости.
Архитектура алертинга и панели
Alertmanager обеспечивает маршрутизацию, сглаживание тонких колебаний и дженерикацию оповещений. В зрелой среде Alertmanager должен поддерживать сложные схемы уведомлений, включающие маршруты по окружениям, сервисам и приоритетам, а также интеграцию с инцидент-менеджментом. Панели наблюдения обычно строятся в Grafana, но в зрелой практике они дополняются тестами метрик и сериям Dashboard-as-Code, чтобы обеспечить повторяемость и контроль версий.
Разумная архитектура алертинга включает определение порогов на основе базовых метрик и их корректную агрегацию. Важна практика дезагрегации, когда уведомления по одному инциденту приходят из нескольких источников, но общий контекст сохраняется. Эффективная политика уведомлений требует документированных Runbooks, автоматического эскалирования и тесной связи с процессами пост-инцидентного анализа.
Модель данных и метрики: качество и консистентность
Модель данных Prometheus строится вокруг временных рядов, идентифицируемых набором метрик и лейблов. Ключевые вопросы касаются нейминга, согласованности и того, как метрики разворачиваются по сервисам и окружениям. На продвинутой стадии зрелости требуется сформированная схема именования метрик, единицы измерения, подход к лейблам и правила агрегации.
Нейминг метрик и единицы измерения
Единицы измерения должны быть единообразны в рамках всей организации. Это обеспечивает корректные аггрегации, сравнение по сервисам и ускоряет принятие решений. Принцип «одна метрика - одно назначение» снижает путаницу и увеличивает надёжность анализа. Важно устанавливать совместимые суффиксы и префиксы: например, cpu_seconds_total, http_requests_total, memory_usage_bytes. Для кастомных метрик следует избегать дублирования по уже существующим именам, чтобы не создавать сложные ментальные модели в командах.
Лейблы и агрегации: структура контекста и масштабируемость
Лейблы служат контекстуальным атрибутам ранжирования и фильтрации. Роль лейблов - давать контекст источника и окружения без перегрузки метрик. Чрезмерное использование лейблов приводит к высокой кардинальной сложности и ухудшению производительности запросов. Оптимальная практика - использовать ограниченный набор стабильных лейблов, например: environment, service, instance, region, version. В рамках зрелости следует внедрить политики по созданию и обновлению лейблов, включая механизмы предотвращения дублирования и стандартизированные правила агрегации (sum, avg, max, min) с привязкой к сегментам.
Управление метриками и временными рядами
План зрелости предусматривает контроль сохранности временных рядов, retention политики и управление агрегацией на уровне кластера. В начале можно ограничиться локальным хранением и меньшим количеством временных рядов, но затем нужно внедрять стратегии с сжатиями, roll-ups и долговременным хранением через remote_write в централизованные хранилища. Важно обеспечить мониторинг собственных временных рядов: количество индивидульных метрик, частота обновления, пропуски и дубликаты. Эти метрики сами по себе требуют мониторинга, чтобы избежать «молчащих» проблем и потери данных.
Протокол экспонирования и совместимость
Понимание формата экспонирования - ключ к совместимости между источниками и потребителями данных. Протокол Prometheus обеспечивает эффективное извлечение метрик, однако совместимость версий exposition format, корректности типизации и единиц измерения остаются важными темами. При переходах между версиями и миграциях следует проводить тесты совместимости, регрессионное тестирование и миграционные планы, чтобы избежать потери данных и неожиданных сбоев в алертинге.
План зрелости: стадии и практики
Построение плана зрелости мониторинга можно разделить на стадии: начальный уровень, средний уровень и продвинутый уровень. Каждая стадия предполагает конкретные практики, требования к сбору данных, керни процессов и критерии выхода на следующий уровень.
Начальный уровень: базовая видимость, сбор критичных метрик
На старте фокусируются на базовой видимости критичных сервисов. Основной набор метрик - это показатели доступности, задержек и ресурсов. Важны стабильная конфигурация scrape configs, минимальная сеть и доступ к данным. Алгоритм внедрения подразумевает создание единого окна захвата для основных сервисов и устранение пропусков в критических цепочках. Необходимо выстроить простую архитектуру alerting по приоритетам с понятной маршрутизацией в командах.
В рамках практических шагов стоит рассмотреть:
- создание единого реестра критических сервисов и базовых метрик;
- внедрение базовых exporters для сервисов и инфраструктуры;
- настройка простого Alertmanager и базовых алерт-правил;
- запуск dashboards в Grafana, фокус на простоту и понятность.
С точки зрения процессов на этом уровне возможны экспериментальные подходы: локальные стенды, сбор обратной связи и документирование базовых runbooks. Важным является внедрение контроля версий конфигураций и базовых тестов на предмет корректности метрик.
Средний уровень: качество метрик, структурированность
Средний уровень предполагает систематизацию сбора, улучшение качества данных и расширение зоны наблюдения. Здесь внедряются:
- конвенции по именованию и лейблам на уровне всей организации;
- добавление новых источников данных через экспортёры или instrumentation;
- централизованное хранение и управление политиками retention;
- более сложные правила алертинга и модные паттерны панелей;
- внедрение тестирования метрик и состоянии Dashboard код-ревью.
Практически это означает, что команда должна определить единые правила по метрикам: какие сервисы измеряются, какие метрики собираются, каковы пороги алертинга и каковы требования к качеству обновления. В архитектуре может появиться модуль федерации и переход к распределенной схеме сбора, если оркестрация растет. Нюансы здесь включают правильную настройку уровней гранулярности и предиктивной аналитики через Grafana и внешние инструменты BI.
Продвинутый уровень: масштабируемость, automation и IaC
На продвинутом уровне мониторинг становится частью DevOps-практик и архитектурной устойчивости. Основные направления:
- автоматизация разворачивания и обновления мониторинга через инфраструктурный код (IaC);
- применение GitOps-практик для изменения конфигураций мониторинга и уверенная роль в CI/CD;
- продвинутая федерация и multi-tenancy, с изоляцией и четким разделением данных по окружениям;
- продвинутые стратегии хранения и анализ долгосрочных данных (remote storage, cold storage);
- тестирование метрик, алертинга и dashboards как часть CI-пайплайна;
- мониторинг самой инфраструктуры Prometheus, включая аптайм, сборку новых версий и обновление экспортеров.
Продвинутый уровень требует культуры автоматического тестирования метрик, построения runbooks на основе инцидентов и внедрения аналитики для выявления системных проблем, а не отдельных сервисов. Архитектуру следует рассматривать как сеть взаимосвязанных компонентов, где отказ в одном месте может быть компенсирован за счет резервирования и ретабилизации данных.
Применение в реальных сценариях и типичные ловушки
Реальные сценарии Monitor maturity включают управление облачными средами, миграции приложений, работающих в гибридной архитектуре, обработку сезонных пиков нагрузки, compliance и безопасность метрик. Популярные ловушки на этапах зрелости: дубликаты метрик, несогласованность лейблов, слишком агрессивное хранение, избыточное число exporters без контроля качества, неэффективные алерты и перегрузка операторов. Предотвращение таких проблем требует внедрения процессов аудита метрик, тестирования конфигураций и дисциплины в отношении изменений.
Инструменты и практики перехода между уровнями
Переход от уровня к уровню затрагивает как техническую часть, так и организационные процессы. В этом разделе описаны ключевые практики для эффективного роста.
Автоматизация инсталляций
Развертывание мониторинга должно быть повторяемым и версионируемым. Использование IaC (например, Terraform, Helm charts) позволяет быстро поднимать тестовые окружения и производственные кластеры с единым набором метрик, экспортёров и правил алертинга. Важной частью является автоматическое тестирование конфигураций и интеграционных тестов, чтобы предотвращать регрессию после изменений.
Конвенции по именованию и labeling
Унифицированные конвенции по именованию метрик и лейблам критичны для согласованности аналитики и упрощения масштабирования. Например, общие лейблы environment, service, instance, region, version должны применяться повсеместно и документироваться. В практике стоит внедрять governance‑процедуры: ревью изменений, проверка на дубликаты и регламент по миграциям старых метрик на новые naming conventions.
Непрерывная проверка метрик и алертинг
Необходимо развивать процессы тестирования метрик и алертинг как часть CI/CD. Это включает в себя:
- регрессионное тестирование на предмет корректности порогов и агрегаций;
- симуляцию инцидентов и проверку того, как система уведомляет нужные команды;
- автоматизированную ревизию dashboards и их соответствие текущей архитектуре;
- мониторинг самой системы мониторинга: задержки, пропуски, производительность запросов и статус удаленных хранилищ.
Эти практики помогают поддерживать высокий уровень качества данных и скорость реакции в реальных условиях эксплуатации.
Обеспечение устойчивости и эксплуатации
Ни один уровень зрелости не будет устойчив без правильной эксплуатации и дисциплины в отношении обновлений и отказоустойчивости.
Релизная дисциплина и мониторинг самой инфраструктуры Prometheus
Необходимо обеспечить мониторинг самих компонентов Prometheus: аптайм, сборку новой версии, совместимость режимов хранения и модули удаленного хранилища. Релизная дисциплина должна включать регламент обновления, тестирование на тестовых окружениях и план откатов. В рамках практик следует внедрить мониторинг обновлений экспортёров и модулей, чтобы минимизировать риск несовместимости или падения сбора метрик.
Архитектура отказоустойчивости и масштабирования
Для обеспечения высокой доступности следует рассмотреть:
- мульти-кластерные развёртывания Prometheus;
- резервирование TSDB, миграции и синхронизацию между узлами;
- высокопроизводительные механизмы федерации и remote storage;
- план устойчивости к сбоям инфраструктуры: резервирование сетей, отказоустойчивость узлов и автоматическое переназначение источников метрик.
Такой подход снижает риск потери данных и обеспечивает непрерывность мониторинга даже при выходе из строя отдельных компонентов.
Наблюдаемость процессов и качества данных
Помимо видимости инфраструктуры, зрелая эксплуатация включает наблюдаемость процедур: как команда работает с мониторингом, какие процессы соблюдаются в течение жизненного цикла сервиса и как качество данных поддерживается в рамках всего портфеля сервисов. Включение в практику регламентов по тестированию, аудиту и управлению версиями метрик обеспечивает долгосрочную устойчивость и прозрачность процессов.
Key takeaways
- Зрелость мониторинга - это сочетание архитектурных решений, качества данных и организационных процессов, которые позволяют переходить от реагирования на инциденты к предиктивному управлению состоянием систем.
- Архитектура Prometheus должна расти пропорционально сложности среды: от базового сбора к федерации, remote storage и сложной схемы алертинга.
- Модель данных требует строгого подхода к неймингу, единицам измерения и лейблам, чтобы обеспечить эффективность агрегаций и аналитики.
- Плавный переход между стадиями достигается через внедрение стандартов, IaC, GitOps и тестирования метрик и алертинга.
- Интеграции и сервис-дискoвери в динамичных средах - ключ к устойчивому мониторингу в условиях масштабирования и изменений топологии.
- Управление качеством данных и устойчивость инфраструктуры мониторинга - обязательные элементы любой зрелой практики мониторинга.
- Эффективная культура мониторинга требует четких runbooks, документации и постоянной оптимизации процессов вместе с технологическими решениями.
FAQ
- В чем разница между начальным и продвинутым уровнем зрелости мониторинга?
Начальный уровень фокусируется на базовой видимости критических сервисов, простом алертинге и минимальном наборе метрик. Продвинутый уровень предполагает единые конвенции по именованию и лейблам, автоматизацию разворачивания мониторинга, multi-cluster и remote storage, продвинутые сценарии алертинга и тестирования. Разница - в уровне стандартизации, масштабируемости и вовлеченности процессов.
- Какую роль играет service discovery в зрелом мониторинге?
Service discovery позволяет автоматически находить новые сервисы и инфраструктурные сущности, устраняя необходимость ручной настройки. Это критично в динамических средах, таких как Kubernetes, облачные окружения и микросервисные архитектуры. Правильная конфигурация discovery обеспечивает устойчивую сборку метрик и минимизирует пропуски.
- Как выбрать между федерацией и remote storage?
Федерация подходит для агрегации метрик из нескольких кластеров Prometheus и упрощения аналитики в рамках централизованной панели. Remote storage необходим для долговременного хранения, масштабирования и интеграции с аналитическими пакетами. В реальных условиях применяют сочетание: федерация для локального анализа и remote storage для архивации и кросс-кластерного анализа.
- Какие паттерны применяются для нормализации лейблов и нейминга?
Правила должны быть документированы и применяться ко всем сервисам. Рекомендуется фиксировать набор стабильных лейблов (environment, service, instance, region, version) и следовать единым шаблонам наименований метрик. Это упрощает агрегацию, фильтрацию и сравнение между сервисами и окружениями.
- Какие практики тестирования метрик и алертинга считаются обязательными?
Обязательны регрессионные тесты для новых метрик и правил алертинга, тесты на корректность порогов, симуляции инцидентов, проверка совместимости новых конфигураций с существующими дашбордами и runbooks. Включение мониторинга метрик мониторинга в CI/CD позволяет обнаружить дефекты до внедрения в продакшн.
- Что является критичным при переходе на IaC и GitOps в мониторинге?
Необходимо обеспечить версионирование конфигураций и инфраструктуры мониторинга, автоматическое тестирование новых изменений, детальное журналирование и возможность отката. GitOps позволяет вернуть текущее состояние мониторинга в известную рабочую конфигурацию в случае проблем, что существенно снижает риск простоя.
- Какие типичные ловушки на стадии зрелости?
Дубликаты метрик, несогласованность лейблов, чрезмерная детализация метрик, перегрузка алертами, несогласованные пороги и слабая связь между runbooks и практиками реагирования. Предотвращение требует аудита метрик, регламентов по миграции (когда меняются naming conventions), и регулярной проверки соответствия текущей архитектуре.
- Какие преимущества дает переход к продвинутому уровню в контексте DevOps?
Продвинутый уровень обеспечивает тесную интеграцию мониторинга в CI/CD, автоматизацию разворачивания и обновления конфигураций, масштабируемость и предсказуемость. Это позволяет быстрее реагировать на изменения в инфраструктуре и сервисах, улучшает устойчивость операций и снижает время восстановления после инцидентов.
- Какие технические риски сопровождают переход между уровнями?
Риски включают задержки в внедрении новых экспортеров, конфликт версий exposition format, проблемные миграции лейблов, а также сложности в управлении хранением данных. Подход с тестированием, staged rollout и документированными планами миграции минимизирует эти риски.
- Какие практики стоит внедрить в первую очередь при росте среды?
В первую очередь - единые конвенции по именованию и лейблам, настройка базового набора алертинга и dashboards, а также автоматизация разворачивания мониторинга через IaC. Это создаст прочную базу для постепенного расширения с меньшими операционными издержками и более предсказуемым качеством данных.


