

Мониторинг производительности и устойчивости сервисов: SLA/SLI, латентность и tail latency
Производительность и устойчивость современных сервисов - ключевые параметры качества цифровых продуктов. Глава посвящена тому, как через SLA/SLI/SLO, латентность и tail latency строить надежную observability-архитектуру в рамках Prometheus, Grafana, Alertmanager, Loki и OpenTelemetry. Рассмотрены методы измерения, архитектурные решения, требования к интеграциям и практические примеры реализации в Kubernetes и микросервисной среде. В центре внимания - как превратить латентность в управляемый риск, как внедрять алертинг и как строить понятные для команд SLO-дашборды и отчеты.
Кратко о сути: SLA и SLI задают ожидаемое качество сервиса для пользователей и бизнес-целей; латентность (особенно tail latency) требует внимания к распределению задержек и к моделям пользовательского опыта. Эффективная observability здесь опирается на хорошо спроектированную метрику- и трассировочную архитектуру, согласованные принципы именования и агрегации метрик, а также на тесное взаимодействие между Prometheus, OpenTelemetry, Grafana, Loki и Alertmanager.
- Определение SLA/SLI/SLO и связь с пользовательским восприятием
- Метрики латентности и tail latency (p50, p95, p99) и их сбор
- Архитектура сбора метрик и интеграций в Prometheus/OpenTelemetry/Grafana/Loki
- Практика построения SLO, алертинга и тестирования устойчивости
Концептуальные основы SLA, SLI и латентности
SLA (Service Level Agreement) - договор между поставщиком и клиентом, задающий ожидаемое качество сервиса и последствия его невыполнения. SLA строится на наборе SLI (Service Level Indicators) - конкретных индикаторах уровня сервиса. SLO (Service Level Objective) - целевом значении для каждого SLI на заданном интервале времени. В контексте микросервисов и data-платформ ключевые SLI обычно включают латентность отклика, пропускную способность и долю успешных операций. Разделение на несколько SLI помогает избежать ложной оптимизации одного параметра за счет других.
Латентность как индикатор качества характеризуется не только средним значением задержки, но и распределением, особенно tail latency. При проектировании пользовательского опыта значимы пессимальные хвосты: p95, p99, p99.9 и далее. Набор percentile-метрик позволяет увидеть, насколько редко происходят критические задержки, и как они зависят от контекста запроса (service, endpoint, статус операции, нагрузка, регион) и от свойств сети.
Важно понимать, что tail latency не равна просто высокому p99; она часто связана с редкими, но значимыми задержками из-за ошибок кэширования, очередей, блокировок в синхронном коде, зависимостей или ограничений в инфраструктуре. Эту связь необходимо учитывать при постановке SLO и выборе подходов к устранению узких мест.
SLI для латентности можно строить на основе percentile-емпирических оценок. Одним из наиболее распространённых подходов является использование гистограмм задержек: метрика http_request_duration_seconds_bucket (или аналогичная) аккумулируется в виде гистограммы, затем применяется функция histogram_quantile для вычисления требуемого процента (например, p95, p99). Пример концептуальной формулы:
histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket[5m])) by (le))
Эта формула возвращает 95-й перцентиль времени ответа по сумме всех слоёв сервиса за последние 5 минут. Для p99 аналогично:
histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (le))
Непременное уточнение: такие расчёты требуют согласованных метрик времени начала и конца запроса, единообразного разделения по сервисам/эндпоинтам и корректного учёта статусов (например, фильтрации по успешности). В дополнение к latency-перцентилям следует учитывать SLI по доле успешных запросов (success rate), чтобы контролировать как качество ответа, так и возможность деградации.
SLI по успешности может быть выражено через коэффициент завершённых операций без ошибок за интервал времени:
sum(rate(http_requests_total{status!~"5.."}[5m])) / sum(rate(http_requests_total[5m]))Такой показатель часто называется error-rate SLI и дополняет latency-ориентированные SLI, образуя более полноценную картину устойчивости.
SLI и SLO должны быть прозрачны для команд и согласованы с бизнес-целями. Например, в контексте платёжной системы SLO может звучать так:
- p95 latency ≤ 250 ms для 99% запросов в течение последнего месяца;
- error rate ≤ 0.1% за период 7 дней.
Такие параметры позволяют планировать капитальные решения и оперативные меры, ограничивая риск проседаний в пользовательском опыте.
Архитектура сбора метрик и интеграций
Эффективное наблюдение - это не набор метрик, а связанная архитектура сборки, агрегации и анализа данных. В рамках Prometheus/OpenTelemetry/Grafana/Loki/Alertmanager она строится вокруг трех связанных слоёв: инструментирования на уровне сервисов, агрегации и хранения метрик и логов, а также представления и алертинга.
- Инструментирование кода и трассировка
- Привязка к каждому критическому эндпоинту детерминированной латентности и статуса выполнения. Использование OpenTelemetry для единообразной сбивки timings, baggage/trace context и корреляции между логами, метриками и трассировками.
- В качестве практики рекомендуется внедрять атрибуты, которые позволяют сегментировать латентность по сервисам, регионам, A/B-группам и типу операции. Это облегчает последующий анализ tail latency по сегментам.
- Пример концептуального подхода к измерению задержки в коде (псевдокод, не привязан к языку):
Timer t = tracer.startTimer("http_request_latency", { "service": "payments", "endpoint": "/charge" })
// обработка запроса
t.stop({ "status": statusCode, "region": region })
- Метрики и гистограммы
- Использование гистограмм для задержки: http_request_duration_seconds_bucket с предопределёнными bucket-границами. Важно выбирать bucket-границы, охватывающие ожидаемую задержку и tail-latency диапазоны.
- Применение histogram_quantile для вычисления перцентилей: p50, p95, p99. В дополнение к ним полезны агрегаты по статусу или по сервисам для быстрого сравнения сегментов.
- Интеграции и поток данных
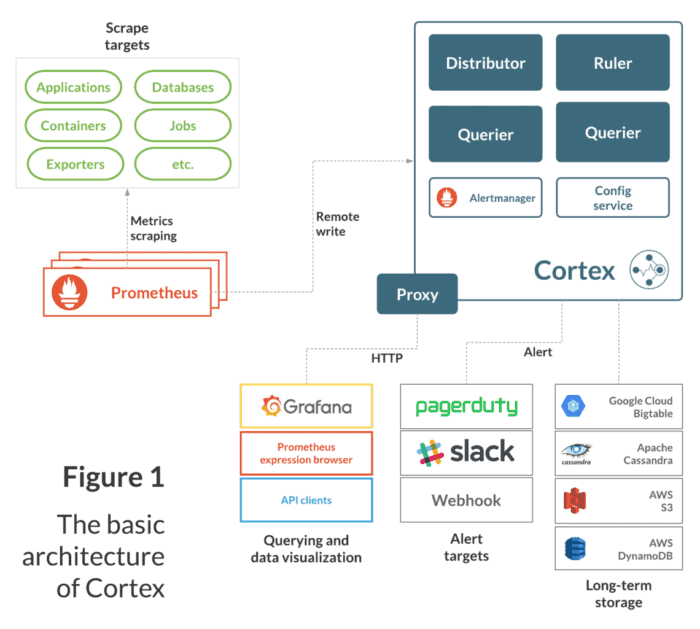
- Prometheus как основной сборщик метрик и хранилище временных рядов. Для глобальных сценариев возможно использование remote_write к долговременному хранилищу.
- OpenTelemetry Collector как единая точка входа для трассировок, метрик и логов, с экспортёрами в Prometheus, Jaeger/Tempo/Grafana Loki и другие источники.
- Grafana используется для визуализации и построения SLO-дашбордов, а Alertmanager - для управления алертами и маршрутизацией уведомлений.
- Loki хранит логи и позволяет осуществлять корреляцию по trace_id/transaction_id с метриками и трассировками, что особенно важно для tail-latency анализа.
- Конвенции именования и единообразие
- Придерживайтесь единых правил именования метрик: префиксы сервиса, тип метрики (latency, request_count, error_rate), лейблы (service, endpoint, region, version).
- Гистограммы должны иметь bucket boundaries, согласованные во всей архитектуре. Это позволяет сравнивать p95/p99 между сервисами и средами (dev/stage/prod).
- Интеграции с OpenTelemetry и аналитикой
- OTLP-потоками собираются метрики, трасировки и логи в единую систему, снижающую затраты на интеграцию и обеспечивающую трассируемость tail-latency сцен.
- В Grafana можно строить SLO-дэшборды с подсветкой нарушений, burn-rate-метриками и тенденциями во времени.
Пример некоторых конфигурационных идей и запросов (концептуальные, без привязки к конкретной реализации языка):
# Пример вычисления p95 latency за 5 минут
histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket[5m])) by (le, service, endpoint))
# Пример вычисления доли успешных запросов
sum(rate(http_requests_total{status=~"2..|3.."}[5m])) / sum(rate(http_requests_total[5m]))
# Пример оповещения о задержке в p99
## ALERT LatencyP99High
IF histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (service)) > 0.5
FOR 10m
LABELS { severity="critical" }
## ANNOTATIONS {
summary="Высокая p99 задержка для {{ $labels.service }}",
description="P99 latency выше порога 0.5s на протяжении 10 минут"
}
Измерение латентности в Kubernetes и микросервисной среде
Ключевая сложность tail latency в Kubernetes состоит в динамическом масштабировании, множестве зависимостей и сетевых особенностях окружения. Некоторые паттерны и практики, которые существенно снижают tail latency:
- Разделение сервисов на мелкие функциональные единицы с определённой ответственностью и ограничение общих очередей через принципы bulkhead и ограничение одновремённых соединений.
- Использование service mesh (например, Istio, Linkerd) для маршрутизации и контроля задержек. Мейнстрим - это прозрачные трасы, наблюдаемость сервис-меш, retries и timeouts. Однако чрезмерные retries могут ухудшить tail latency; нужно тщательно настраивать политику повторных попыток и тайм-ауты.
- Введение кэширования на стыке сервисов и в настольных местах, где возможно, с учётом валидности кэш-данных и стиля обновления.
- Корреляция между логами, метриками и трассировками через trace_id/transaction_id - ключ к нахождению узких мест в tail latency.
На уровне инфраструктуры важно поддерживать согласованную стратегию по времени и задержкам, чтобы SLO корректно отражали реальное пользовательское ожидание. В Kubernetes удобно использовать узлы/поды, которые имеют ограничение по CPU/mMemory и возможность перераспределения подов в случае перегрузки, а также мониторинг очередей и ожидания в сервисах.
Практика построения SLA/SLO и алертинга
- Постановка SLO и таргетов
- Выберите 2-4 критичных SLI: latency p95/p99 для ключевых эндпоинтов, latency для 2xx/3xx статусных ответов, и error rate.
- Определите SLO: например, 99% запросов к платежному API должны удовлетворять p95 ≤ 200 ms за rolling window 30 дней; error rate ≤ 0.1% за 7 дней.
- Установите burn rate и SLO-время: burn rate показывает, как быстро “сжигается” запас ошибок в текущем периоде, и позволяет заранее реагировать на ухудшение.
- Управление алертингом
-
Разделение оповещений по важности и контексту: критичные алерты направляйте в оперативные смены, предупреждения - в страницы мониторинга и RSS/пуш-уведомления для инженерной команды.
-
В Alertmanager настройте маршруты по лейблам сервиса, регионам, версиям и степеням критичности. Пример базового маршрута:
route:
  receiver: on-call
  group_by: ['alertname', 'service']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 12h
receivers:
- **name**: on-call
  email_configs:
  - to: oncall@example.com
-
Примеры условий для алертов на tail-latency:
ALERT LatencyP99High
IF histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (service)) > 0.5
FOR 10m
LABELS { severity="critical" }
## ANNOTATIONS {
  summary="P99 latency высокая для {{ $labels.service }}",
  description="P99 задержка выше порога 0.5 сек более чем 10 минут"
}
- Управление ролью и эскалацией
- Установите четкую эскалацию в зависимости от того, какие SLO нарушаются и какие последствия у клиента. Важно специфицировать не просто проблему, а бизнес-риски и ожидаемую реакцию.
- Тестирование устойчивости и проверки SLO
- Проводите регулярные тесты устойчивости и связанные с tail-latency сценарии (chaos engineering) в средах staging. Это позволяет проверить, что SLO сохраняются под стрессом и что алерты работают корректно.
- Используйте прогонку данных (synthetic transactions) и сценарии имитации задержек в областях, где tail-latency потенциально может подрасти.
- Дашборды и отчеты
- Постройте SLO-дешборды в Grafana, показывающие p50/p95/p99 по сервисам, а также burn rate и текущий статус SLO. Включайте сегменты по регионам и версиям, чтобы оперативно видеть, где требуется вмешательство.
- Включайте корреляцию с логами Loki и трассировками OpenTelemetry для глубокого анализа tail-latency случаев.
Реализация и эксплуатация: практические паттерны и кейсы
- Эффективная практика - начинать с малого: определить 2-3 критичных SLI, собрать их в Prometheus и начать постепенную настройку алертинга. По мере накопления данных расширяйте набор SLI, однако не перегружайте команду лишними штрафами и предупреждениями.
- Tail-latency troubleshooting часто начинается с трассировок: обнаружение цепочек зависимостей, задержек внутри каждого сервиса и очередей. Corrrelation через trace_id позволяет быстро выбрать направление расследования: сеть, внутренняя задержка, внешний зависимый сервис.
- Применяйте защитные паттерны: bulkheads, ограничение параллелизма, разумное кэширование, резервные маршруты и graceful degradation, чтобы снизить tail-latency за счёт устойчивости всей цепи.
- Реализация в Kubernetes должна учитывать лимиты ресурсов и качество QoS. Рекомендованы политики лимитов CPU/memory, горизонтальное автоскейлинг, а также мониторинг задержек в окружении на уровне нод, сетевых маршрутов и зависимости.
Key takeaways
- Tail latency - критический индикатор устойчивости сервисов; важно измерять p50/p95/p99 и связывать их с SLO.
- SLA/SLI/SLO должны быть согласованы с бизнес-целями и технической архитектурой; SLI по задержке и успешности операций формируют целевые пороги.
- Архитектура наблюдения в Prometheus/OpenTelemetry/Grafana/Loki/Alertmanager требует согласованных правил именования метрик, гистограмм задержек и корреляции между метриками, трассировками и логами.
- Инструментирование кода и трассировка должны быть единообразны и минимизировать конфликт между сервисами и окружениями.
- Алгоритмы расчета перцентилей через histogram_quantile позволяют точно оценивать tail-latency и формировать информативные SLO/Alert-пороги.
- Аллерты должны быть понятны и адресованы конкретной оперативной группе; маршрутизация в Alertmanager должна минимизировать шум и обеспечивать своевременную реакцию.
- Чёткие дашборды по SLO, burn rate и детализации по сегментам (сервис, регион, версия) повышают качество принятия решений и ускоряют устранение причин деградации.
FAQ
- Что такое tail latency и зачем он важен в observability?
Tail latency - это скрытые за средним значением задержки случаи сильной задержки отдельных запросов. Он критически влияет на пользовательский опыт, потому что пользователи вспоминают не среднюю задержку, а случившиеся редкие задержки. Для бизнес-метрик tail-latency определяет риск SLA и помогает выявлять узкие места в цепочке вызовов, не оставляя без внимания редкие, но разрушительные задержки.
- Как выбрать пороги SLO для latency?
Начните с анализа исторических данных и пользовательского опыта. Выберите p95 или p99 как целевые пороги, учитывая характер сервиса и бизнес-риски. Пример: p95 latency ≤ 200 ms для критичных операций; p99 ≤ 500 ms. Важно устанавливать пороги, которые соответствуют реальному пользовательскому ожиданию и держать их в рамках бизнес-ограничений.
- Какие метрики использовать для SLI по латентности?
Основной метрикой служит перцентили задержки (p50, p95, p99) через histogram_quantile на гистограмме задержек. Дополнительно полезны p90 и p99. В качестве дополнительного SLI можно учитывать среднюю задержку и долю успешных запросов (error rate), чтобы получить более полную картину устойчивости.
- Как связать OpenTelemetry и Prometheus в единую систему?
OpenTelemetry собирает трассировки, метрики и логи, а Collector маршрутизирует их в Prometheus (метрики), Grafana/Loki (логистика) и систему трассировок (Jaeger/Tempo). Такая интеграция облегчает корреляцию между задержкой, трассировкой и логами и упрощает поиск корня проблем tail-latency.
- Какие паттерны используются для снижения tail-latency в Kubernetes?
Основные паттерны: ограничение параллелизма и очередей (bulkheads), корректная настройка retries и тайм-аута, кэширование, деградация в случаях перегрузки, горизонтальное масштабирование и оптимизация зависимостей. Сервис-меш помогает управлять задержками и наблюдаемостью, но требует аккуратной настройки retry/timeout политик, иначе может усилить tail-latency.
- Как you выстроить алертинг для SLA?
Определите роли и маршруты в Alertmanager на основе сервисов, регионов и критичности. Привяжите алерты к SLO burn rate и к конкретным порогам latency/ошибок. Убедитесь, что алерты содержательны: сообщайте идентификатор трасы, узлы/сервисы и шаги для восстановления.
- Что важно учесть при корреляции логов и метрик?
Связывайте логи и метрики по trace_id/transaction_id и используйте корреляцию между trace и log-подсказками. Loki обеспечивает быстрый поиск по логу, а OpenTelemetry позволяет увидеть трассировку и точки задержки. Это ускоряет диагностику tail-latency и уменьшает время на устранение причин.
- Какие практики помогают в долгосрочной эксплуатации SLA/SLI?
Регулярно пересматривайте SLO в связи с изменениями продукта и пользовательских потребностей; проводите периодические ревью алертинга; внедряйте Chaos Engineering для проверки устойчивости; держите актуальные дашборды и автоматические тесты на соответствие SLO; обучайте команды работе с tail-latency и корреляцией между данными.
- Когда стоит рассмотреть расширение набора SLI?
Если появляются новые сервисы или новые критические бизнес-процессы, либо когда существующие SLO перестают отражать пользовательский риск. Расширение SLI должно сопровождаться обновлением архитектуры наблюдаемости, изменений в алертинге и корректировке целевых порогов.
- Какую роль играет tail-latency в планировании capacity?
Tail-latency влияет на требования к запасу мощности и задержки в сеть. При планировании capacity следует учитывать пиковые задержки в tail-частях нагрузки и обеспечить баланс между SLA и стоимостью инфраструктуры. Прогнозирование с учётом tail-latency помогает заранее определять, когда перегрузку следует предотвращать, а когда необходимо расширение кластера.


