

Платформы данных 3 поколения: Первый взгляд на Microsoft Fabric
Эволюция
В конце 2019 года в Synapse Analytics было интегрировано хранилище данных Azure SQL Data Warehouse в виде "выделенных пулов SQL". В Synapse появились дополнительные возможности бессерверной аналитики и аналитики Больших данных.
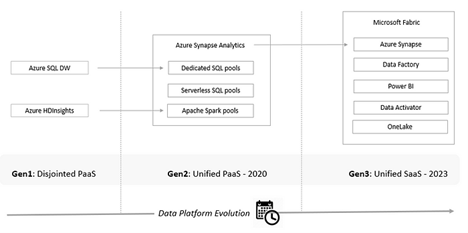
Microsoft Fabric, находящаяся в стадии Public Preview, представляет собой самый настоящий прорыв в сфере платформ данных в облаке Azure, объединяющую множество PaaS-сервисов в единую SaaS-платформу. Это сквозная унифицированная аналитическая платформа, предназначенная для инженеров, специалистов по обработке данных, бизнес-аналитиков и бизнес-пользователей. Компоненты новой платформы представлены двумя основными типами:
- Уже существующие, хорошо известные сервисы, такие как Synapse Analytics, Data Factory и Power BI, которые, тем не менее, были модернизированы;
- Новые сервисы, такие как Data Activator и OneLake.
Про Data Activator пока нечего сказать, поскольку этот сервис еще не доступен для предварительного просмотра. Его назначение - мониторинг источников данных.
Также доступен OneLake, которая является основной концепцией Fabric, представленной как "OneDrive для данных".
OneLake для всех
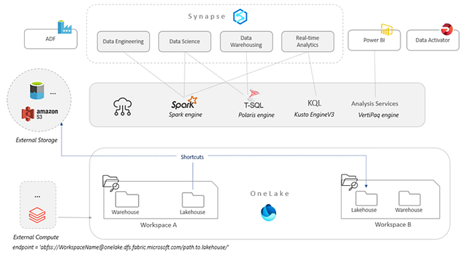
Построенный на базе Azure Data Lake Storage (ADLS) Gen2, OneLake можетохватывать регионы, поэтому он представляет собой логическое озеро данных, фронтэнд к нескольким учетным записям хранения, управляемый из-под капота. Каждый арендатор Azure AD имеет ровно один OneLake.
Следует отметить следующие особенности OneLake:
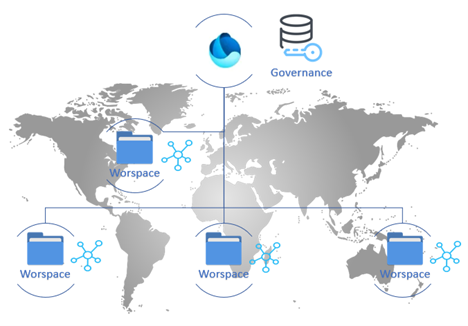
Во-первых, в OneLake можно создать любое количество рабочих пространств (по сути, верхних папок в озере, которые отображаются в виде контейнеров), каждое из которых будет иметь свои регионы, политики доступа и отдельный биллинг. Каждое рабочее пространство может содержать несколько озер, хранилищ, файлов и т.д. и представляет собой отдельный домен или область проекта, где команды могут совместно работать над данными. Управление безопасностью в рабочем пространстве осуществляется централизованно с помощью ролей.
Во-вторых, OneLake поддерживает мгновенное монтирование существующих хранилищ с помощью функции Shortcut. Ярлыки - это объекты OneLake, которые позволяют легко обмениваться данными между пользователями и приложениями без необходимости перемещения и дублирования информации (zero-copy). Ярлык похож на символическую ссылку, по сути, это указатель на данные, хранящиеся в других местах, например, в других хранилищах, внешних озерах данных или даже в хранилищах других облачных провайдеров, таких как Amazon S3.
В –третьих, файлы, представляющие таблицы в OneLake, хранятся в открытой, ACID-совместимой системе, что позволяет улучшить взаимодействие с другими системами. Если точнее, то в верхней папке Lakehouse есть несколько типичных подпапок:
- Подпапка /Files, в которой хранятся необработанные файлы в различных форматах, например, csv, json и т.д;
- Подпапка /Tables, в которой хранятся обработанные файлы в формате Delta.
Отметим, что Delta - это, по сути, языково-агностический формат Parquet с колоночным хранением и журналом транзакций, называемым Delta log.
Lakehouse vs. Warehouse
Когда мы создаем Lakehouse, автоматически создается и ряд следующих элементов:
- Хранилище днных;
- Конечная точка SQL для этого Lakehouse, которая использует тот же движок, что и хранилище, чтобы открыть таблицы Delta для запросов T-SQLA
В хранилище данных пользовательские таблицы хранятся в формате Delta. Любой движок, способный читать таблицы Delta Lake, сможет выполнять запросы к этим таблицам.
Решение о том, использовать ли хранилище или озеро данных, в конечном счете, сводится к типу выполняемой работы и к тому, кто ее выполняет. Озера и хранилища также могут быть объединены, например, в еще одно хранилище, как это показано ниже.
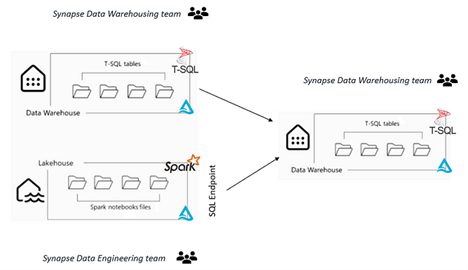
Распространенным сценарием является реализация архитектуры Medallion , когда файлы обрабатываются по возрастанию уровня качества: от необработанных (бронза), консолидированных (серебро) и затем очищенных (золото) слоев. При этом доступ к сгенерированным золотым таблицам Delta, предназначенным для потребления, может осуществляться в хранилище с помощью T-SQL через конечную точку SQL, даже если они расположены во внешних озерах данных (благодаря ярлыкам).
Отметим, что, хотя запросы T-SQL могут выполняться на озерах, таблицы, созданные с помощью Spark, не могут быть обновлены с помощью T-SQL. Как и в "старом" Synapse Serverless, функциональность DML (вставка/обновление/удаление) не поддерживается. Обходным решением будет повторное создание этих таблиц в хранилище с помощью CTAS (CREATE TABLE AS SELECT).
Аналогично, таблицы, созданные с помощью T-SQL, могут быть прочитаны Spark, но не изменены. Для записи им необходимо создать эквивалентные таблицы в своих средах.
Это ограничение кажется несколько странным. Поскольку данные в конечном итоге хранятся в формате Delta, так ли уж сильно отличаются хранилища Fabric от озерных хранилищ Fabric? Другие конкурирующие сервисы, также объединяющиеся в единые аналитические платформы, такие как Databricks или Snowflake, похоже, не имеют такой проблемы.
Заключение
Поскольку каждое рабочее пространство представляет собой независимый домен внутри одного логического хранилища, Fabric обеспечивает централизованное применение политик соответствия и настроек безопасности, одновременно позволяя распределять права собственности на данные в организациях.
Помимо блокировки со стороны поставщика, другой основной проблемой SaS-решений в целом является то, что они поставляются с собственным мнением о том, как все должно работать, что приводит к ограничению возможностей настройки, потере контроля и гибкости. Продукты SaS обеспечивают определенные точки интеграции, но они, как правило, не могут предложить такой же уровень гибкости и расширяемости, как PaaS-сервисы. Для одних это может быть хорошо, для других - не очень.
При этом было бы несправедливо характеризовать Fabric как только лишь ребрендинг существующих сервисов. Была проведена значительная работа над базовыми движками (например, над движком Synapse Polaris), чтобы сделать их более производительными, а также над новой Delta-native природой хранилищ. Например, механизмы Fabric теперь могут создавать v-упорядоченные файлы Delta. V-упорядочивание это оптимизация записи, обеспечивающая быстрое чтение.
Однако с точки зрения маркетинга решение использовать термин "Fabric" не самое удачное, поскольку он пересекается с другими сервисами (Azure Service Fabric) и может вызвать некоторую путаницу.
Кстати, в ближайшее время (?) MS Fabric будет дополнен сервисом Azure OpenAI в виде Copilot. Согласно MS, С помощью Fabric на базе искусственного интеллекта пользователи смогут использовать разговорный язык для "создания потоков данных и конвейеров данных, генерации кода и целых функций, построения моделей машинного обучения или визуализации результатов". Любопытно посмотреть, насколько хорошо это будет работать на самом деле.
В основном данная статья была посвящена обзору OneLake, поскольку он лежит в основе платформы Fabric. На момент написания статьи Fabric все еще находится в стадии Public Preview, а это значит, что информация, представленная в этой статье, может оказаться неточной.


