

Строительные блоки современной платформы данных
Руководство для начинающих по лучшим в своем классе инструментам и возможностям по созданию платформы данных
Если Вы загуглите "современная платформа данных", то сразу же на Вас выльются тонны рекламы и объявления от множества компаний, утверждающие, что именно они являются единственной настоящей платформой данных. Не очень-то и результативный запрос, не правда ли?
Так что же такое современная платформа данных?
Вкратце скажу так, современная платформа данных - это набор инструментов и возможностей, которые, будучи объединенными вместе, позволяют организациям достичь золотого стандарта - организации, в корне ориентированной на данные.
В этой статье я расскажу, что именно означает современная платформа данных. Сюда входят три основные характеристики, шесть фундаментальных строительных блоков и новейшие инструменты для работы с данными, о которых всем нам просто необходимо знать.
3 основные характеристики современной платформы данных
Учитывая масштабы и сложность данных, современной платформе данных уже недостаточно просто обрабатывать и хранить данные. Она должна двигаться и адаптироваться быстрее, чем когда-либо, чтобы успевать за разнообразием данных и их пользователей. Существует три основных характеристики, которые делают платформу данных действительно "современной".
Обеспечение возможности самообслуживания для различных категорий пользователей
Одним из ключевых аспектов современной платформы данных является возможность ее интуитивного использования широким кругом пользователей. Если кто-то хочет использовать данные в своей работе, он должен иметь возможность легко найти нужные ему данные.
Это означает, что платформа должна позволять всем пользователям:
- Легко находить и анализировать данные в рамках платформы;
- Понимать контекст, связанный с данными, например, описание столбцов, историю и происхождение данных;
- Извлекать информацию из данных с минимальной зависимостью от команды разработчиков данных или ИТ-специалистов
Обеспечение "гибкого" управления данными
Одной из основных проблем, связанных с унаследованными платформами данных, является их сложность. Чтобы получить доступ к данным, обычно требуется настройка трудоемких ETL-задач. Нужно изменить данные или сделать небольшой запрос? Запускается длительный неповоротливый процесс...
Современные платформы данных призваны изменить эту ситуацию. Хорошо построенная современная платформа позволяет принимать решения, основанные на данных, со скоростью развития бизнеса.
Два фундаментальных принципа, на которых базируются современные платформы данных, - это доступность и эластичность:
- Доступность: Данные уже доступны в озере или хранилище данных. Современные озера и хранилища данных разделяют хранение и вычисления, что позволяет относительно дешево хранить большие объемы данных;
- Эластичность: Вычисления базируются на облачной платформе, что обеспечивает эластичность и автомасштабируемость. Например, если конечные пользователи потребляют наибольшее количество данных и аналитики в пятницу во второй половине дня, то должна быть предусмотрена возможность автоматического масштабирования вычислительной мощности в пятницу во второй половине дня, чтобы обеспечить пользователям отличную работу, и последующего снижения масштаба в течение нескольких часов.
Гибкость, быстрая настройка и оплата по факту
Современные платформы данных далеки от сложных локальных реализаций эпохи Hadoop. Они создаются в условиях облачных технологий, что означает, что их можно настроить за несколько часов, а не лет.
Современная платформа предполагает следующее:
- Легко настраиваемая - без длительного процесса продажи, демонстрационных звонков и циклов внедрения. Просто войдите в систему, оплатите картой и работайте!
- Оплата по мере использования - никаких предварительных платежей и миллионных лицензионных отчислений. Современный стек - это передача полномочий в руки потребителя, т.е. оплата только за то, что Вы реально используете;
- Plug and play - современный стек данных будет продолжать развиваться и внедрять инновации, лучшие из лучших инструментов не обеспечивают "блокировки", как инструменты старой эпохи, а построены на открытых стандартах и API, что позволяет легко интегрировать их с остальными компонентами стека.
Ключевые строительные блоки современной платформы данных
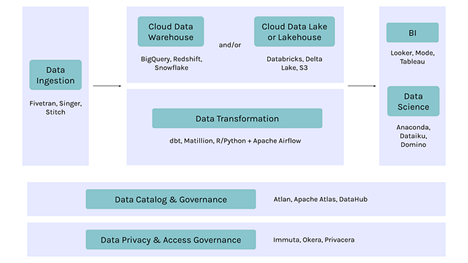
Ввод данных
Ввод данных - это, скорее всего, тот шаг, с которого Вы начинаете построение современной платформы данных, т.е. задаетесь вопросом: как получить данные из различных источников данных и ввести их в основной слой хранения данных?
Вот несколько основных современных инструментов для работы с данными:
- SAAS инструменты: Fivetran, Hevo Data, Stitch
- Open-source инструменты: Singer, StreamSets
- Пользовательские конвейеры ввода данных, построенные на основе таких механизмов, как Airflow
Современное хранение и обработка данных
Уровень хранения и обработки данных является основой современной платформы данных. Хотя эта архитектура до сих пор развивается, сейчас принято выделять 3 вида инструментов или фреймворков:
Хранилища данных (data warehouse): Краеугольным камнем этой архитектуры является современное хранилище данных. Как правило, именно такие системы выбирают аналитики, поскольку они оптимизируют скорость вычислений и обработки данных.
К числу основных инструментов для работы с хранилищами данных относятся BigQuery, Redshift, а также Snowflake.
Озера данных (data lake): Архитектура озера данных подразумевает хранение данных в объектном хранилище, например Amazon S3, в сочетании с инструментами для их обработки, такими как Spark. Эти относительно недорогие системы хранения часто используются для хранения огромных объемов необработанных или даже неструктурированных данных.
Ключевые инструменты:
- Хранение данных: Amazon S3, Azure Data Lake Storage Gen2, Google Cloud Storage
- Движки обработки данных: Databricks или Spark; Athena, Presto, или Starburst; Dremio
Новая тенденция: озерные хранилища данных (data lakehouse)! Одна из тенденций этого года – долгожданное объединение хранилищ и озер данных. Это позволит объединить разрозненные системы, созданные большинством компаний за последнее десятилетие.
Data lakehouse – это система, сочетающая в себе функции управления данными, такие как ACID-транзакции и сбор данных об изменениях из хранилища данных, с недорогим хранением данных в озере данных.
Современная трансформация данных
Сегодня мы видим два основных варианта реализации уровня трансформации данных. Для компаний с архитектурой, ориентированной на хранилища данных, основным выбором для преобразования данных стали такие инструменты, как dbt, использующие для трансформации собственный SQL. Другой распространенной реализацией является использование Airflow в качестве механизма оркестровки в сочетании с пользовательской трансформацией на языке программирования, например Python.
Вот некоторые ключевые инструменты для преобразования данных:
- С помощью хранилища данных: dbt, Matillion
- С помощью движка оркестрации: Apache Airflow + Python, R, or SQL
Современная аналитика данных и BI
Дашборды существуют уже давно, но в рамках более крупных современных платформ данных создаются новейшие инструменты BI и аналитики. Как правило, это платформы самообслуживания, позволяющие пользователям не просто просматривать графики и диаграммы, а исследовать данные.
Современные инструменты BI Looker, Mode, Redash, Sigma, Sisense, Superset и Tableau.
Современные каталоги данных и data governance
Несмотря на то, что современная платформа данных в некоторых областях является высокоразвитой (сверхбыстрая, легко масштабируемая, мало накладных расходов), она все же до сих «испытывает» определенные трудности с обеспечением открытости и доверия к данным.
Поскольку метаданные сами по себе становятся Большими данными, то можно с уверенностью сказать, что мы находимся в самом разгаре скачка в области управления метаданными; в ближайшие 18-24 месяца это пространство ожидает значительное количество инноваций… Недавно я написал об идее Data Catalog 3.0: новая эра ПО, которая будет построена на основе принципа совместной работы, ключевого для современного рабочего места, заимствуя принципы Github, Figma, Slack, Notion, Superhuman и других современных инструментов, которые сегодня широко распространены.
Вот некоторые ключевые инструменты для современной каталогизации и управления данными:
- SAAS инструменты: Atlan
- Open-source инструменты: Atlas от Apache, DataHub от LinkedIn, Amundsen от Lyft
- Внутренние инструменты: Dataportal от Airbnb, Nemo от Facebook , Databook от Uber
Современное управление конфиденциальностью и доступом к данным
Наконец, по мере развития инструментария современных платформ данных одной из основных задач становится возможность управления контролем конфиденциальности и управления доступом во всем стеке. Хотя все только еще начинается, в последнее время в этой области появились новые игроки и разработчики, предлагающие инструменты, которые могут выступать в качестве механизма предоставления прав для применения политик конфиденциальности и безопасности во всем стеке данных.
Вот некоторые ключевые инструменты для управления конфиденциальностью данных и доступом к ним:
- SAAS сервисы: Immuta, Okera, Privacera
- Open-source движки: Apache Ranger
Другие современные инструменты обработки данных, о которых следует знать
Перечисленные выше возможности и инструменты являются базовыми уровнями современной платформы данных. Однако каждая компания использует данные по-своему, поэтому многие из них добавляют дополнительные уровни и инструменты для конкретных случаев использования.
Средства обработки данных в режиме реального времени
Компании, которым требуется обработка данных в режиме реального времени, обычно добавляют к своей платформе данных два дополнительных типа инструментов:
- Потоковые конвейеры , работающие в режиме реального времени: Confluent, Kafka
- Аналитика в режиме реального времени: Druid, Imply
Инструменты для работы с данными
Компании, перешедшие от BI и аналитики к мощной предиктивной аналитике и аналитике на основе науки о данных, часто добавляют в свой стек данных специальный инструмент (или инструменты) для науки о данных:
- Рекомендовано учеными в области данных: Jupyter Notebooks
- Другие: Dataiku, DataRobot, Domino, SageMaker
Коллекторы событий
Компании, имеющие значительное цифровое присутствие, часто добавляют коллекторы событий для регистрации и хранения внешних событий. Такие инструменты, как Segment и Snowplow являются ключевыми дополнениями к их стеку обработки данных.
Инструменты по обеспечению качества данных
Эта область еще только зарождается, но в настоящее время в ней наблюдается большая активность. В целом мы видим несколько аспектов качества данных, включенных в стек данных: проверка качества данных при профилировании, правила качества, основанные на бизнес-ориентированности, а также фреймворки модульного тестирования в конвейере.
- Профилирование данных: В настоящее время этот вид профилирования все больше распространяется на средства каталогизации и управления данными, такие как Atlan, или на фреймворки профилирования с открытым исходным кодом, такие как Amazon Deequ.
- Модульное тестирование: Такие фреймворки, как open-source Great Expectations появляются и развиваются, позволяя писать модульные тесты как часть самих конвейеров данных.