

Типы архитектуры платформ данных
Насколько хорошо они способно удовлетворить потребности именно Вашего бизнеса? Дилемма выбора.
В изобилии инструментов для работы с данными, представленных на рынке в настоящее время, безусловно, легко потеряться. Интернет пестрит мнениями (зачастую достаточно умозрительными) о том, какие же инструменты данных следует использовать и в каком случае, и как сделать наш стек данных современным в этом году. Какие инструменты для работы с данными являются лучшими? Кто является лидером в этой области? Как правильно их выбрать? Эта статья посвящена тем, кто находится в прострации, и при этом все же мечтает построить лучшую в мире платформу данных.
Так что же такое "современный стек данных" и насколько он современен?
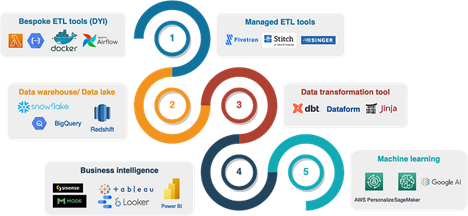
Это набор инструментов, используемых для работы с данными. В зависимости от того, что мы собираемся делать с ними, эти инструменты могут включать в себя следующее:
- управляемый конвейер данных ETL/ELT
- облачное управляемое хранилище данных/озеро данных в качестве места назначения данных
- инструмент преобразования данных
- платформа бизнес-анализа или визуализации данных
- возможности машинного обучения и науки о данных
Иногда совершенно неважно, насколько он современен.
Действительно, если наш BI-инструмент суперсовременный, с разработанными на заказ OLAP-кубами для моделирования данных и интеграцией с git, но он не может вывести отчет в электронное письмо, то это не имеет абсолютно никакого значения.
Зачастую именно эти мелочи имеют решающее значение. Наиболее важными являются потребности бизнеса и требования к конвейеру данных.
На приведенной ниже диаграмме показан путь данных и выбор соответствующих инструментов, которые необходимо использовать на каждом этапе работы с данными.
Redshift, Postgres, Google BigQuery, Snowflake, Databricks, Hadoop, Dataproc, Spark или Elastic Map Reduce?
Какой продукт выбрать для платформы данных?
Это зависит от ежедневных задач, которые Вы планируете решать с помощью данных, от архитектуры обработки и хранения данных, а также от того, что больше всего подходит именно Вам для решения всех этих задач.
Типы архитектуры платформ данных
Помнится, всего пару лет назад Интернет просто бурлил историями типа "Hadoop мертв". Наблюдался заметный сдвиг в сторону архитектуры хранилищ данных. В 2023 году, похоже, все будут одержимы потоковой передачей данных в режиме реального времени и масштабируемостью, а Spark и Kafka скоро станут лидерами по популярности.
Так кто же из них лучше? Кто является лидером и какие инструменты работы с данными выбрать? Как выбрать?
Как я понял, все оценки очень субъективны, их следует рассматривать с большой доли критики. Что действительно важно, так это то, насколько эти инструменты соответствуют именно Вашим бизнес-требованиям.
Хранилище данных
Бессерверный распределенный SQL-движок (BigQuery, Snowflake, Redshift, Microsoft Azure Synapse, Teradata.). Это архитектура данных SQL-first, при которой данные хранятся в хранилище данных, при этом Вы можете свободно использовать все преимущества использования денормализованных наборов данных. Это наилучшим образом подходит для аналитики, работающей с Большими Данными.
Большинство современных решений для хранилищ данных могут обрабатывать структурированные и неструктурированные данные и действительно очень удобны, если большинство Ваших пользователей – это аналитики данных с хорошими навыками работы с SQL. Современные хранилища данных легко интегрируются с решениями для бизнес-аналитики, такими как Looker, Tableau, Sisense или Mode, которые также во многом опираются на ANSI-SQL. Он не предназначен для хранения изображений, видео или документов. Однако с помощью SQL можно делать практически все и даже обучать модели машинного обучения.
Data lake (Databricks, Dataproc, EMR)
Тип архитектуры, при котором данные хранятся в облачном хранилище, т.е. AWS S3, Google Cloud Storage, ABS. Конечно, лучше всего использовать его для хранения изображений, видео или документов, а также для любых других типов файлов (JSON, CSV, PARQUET, AVRO и т.д.), но для анализа данных пользователям придется написать определенный код.
Наиболее распространенным языком программирования для решения этой задачи является Python с большим количеством доступных библиотек. Другим популярным вариантом может стать JAVA, Scala или PySpark.
Код дает удивительные преимущества. Это высочайший уровень гибкости в обработке данных. Наши пользователи просто обязаны знать, как это делать!
Lakehouse
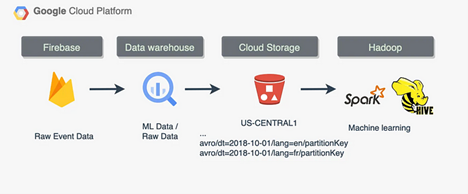
Сочетание архитектуры хранилища данных и озера данных. Представляет собой лучшее из двух миров и служит на благо как программистам, так и обычным бизнес-пользователям, например, аналитикам данных. Она позволяет выполнять интерактивные SQL-запросы, оставаясь при этом экстремально гибкой в плане настройки. Большинство современных решений для хранилищ данных позволяют выполнять интерактивные запросы к данным, хранящимся в озере данных, т.е. к внешним таблицам. Один конвейер данных может выглядеть, например, так:
Data mesh
Data mesh - это децентрализованный подход, позволяющий компании самостоятельно управлять данными и выполнять межгрупповой/междоменный анализ данных, а также совместно использовать эти данные.
Каждое подразделение может обладать различными навыками программирования, например, на SQL или Python, а также различными требованиями к рабочей нагрузке с данными (гибкая обработка данных по сравнению с взаимодействием SQL-запросов). При этом каждое подразделение может выбрать собственное решение по созданию хранилища данных/озера данных, но при этом сможет обмениваться данными с другими подразделениями без каких-либо перемещений данных.
Реляционные и нереляционные системы управления базами данных
Реляционная система управления базами данных (РСУБД) хранит данные в таблице, состоящей из строк и столбцов, связывающих элементы данных. Популярными реляционными базами данных являются PostgreSQL, MySQL, Microsoft SQL Server и Oracle. NoSQL-базы поддерживают не только простые транзакции, в то время как реляционные базы данных поддерживают и сложные транзакции с объединениями. Базы данных NoSQL используются для работы с данными, поступающими с высокой скоростью. Популярными базами данных NoSQL являются:
- Базы данных документов: MongoDB и CouchDB
- Базы данных с ключами-значениями: Redis и DynamoDB
Хранилище данных имеет аналогичную столбцовую структуру, как и RDS, оно является реляционным. Данные также организованы в таблицы, строки и столбцы. Однако они отличаются тем, что в базе данных данные организованы и хранятся по строкам, а в хранилище данных - по столбцам, что облегчает аналитическую обработку в режиме онлайн (OLAP), в то время как в базе данных используется обработка транзакций в режиме онлайн (OLTP). Например, AWS Redshift поддерживает подходы как к хранилищу данных, так и к озеру данных, что позволяет получать доступ и анализировать большие объемы данных.
Хранилище данных предназначено для анализа данных, в том числе больших объемов исторических данных. Использование хранилища данных требует от пользователя создания заранее определенной, фиксированной схемы, что существенно помогает при анализе данных. Таблицы должны быть простыми (денормализованными) для вычисления больших объемов данных.
Таблицы и соединения в базах данных RDS сложны, поскольку они нормализованы. Итак, основное различие между традиционной базой данных и хранилищем данных заключается в том, что если традиционная база данных предназначена и оптимизирована для записи данных, то хранилище данных предназначено и оптимизировано для реагирования на аналитику. Вы захотите использовать базу данных, когда запустите приложение и вам нужно будет быстро получить текущие данные. В RDS хранятся текущие данные, необходимые для работы приложения.
Вам решать, на чем остановить свой выбор.
BI стек
Современный стек данных должен включать в себя BI-инструменты, помогающие моделировать и визуализировать данные. Некоторые полезные перечни приведены ниже. Конечно, это не полный список, но это наиболее популярные BI-инструменты, доступные на рынке по состоянию на 2023 год:
Looker Data Studio (Google Looker Studio)
Ключевые особенности:
- Бесплатная версия, ранее называвшаяся Google Data Studio. Это отличный бесплатный BI инструмент с поддержкой сообщества;
- Большая коллекция виджетов и диаграмм;
- Большая коллекция коннекторов данных, поддерживаемых сообществом;
- Идеальное преобразование отчетов в электронные письма;
- Бесплатные функции управления данными;
- Поскольку это бесплатный инструмент сообщества, он имеет немного недоработанный API
Looker (платная версия)
Ключевые особенности:
- Широкие возможности моделирования данных и самообслуживания. Отлично подходит для средних и крупных компаний;
- Возможности API
Tableau
Ключевые особенности:
- Впечатляющие визуальные эффекты;
- Приемлемая цена;
- Запатентованный движок VizQL, обеспечивающий интуитивную аналитику данных;
- Связь со многими источниками данных, такими как HADOOP, SAP, DB Technologies, что значительно повышает качество анализа данных;
- Интеграция со Slack, Salesforce и т.д.
AWS Quicksight
Ключевые особенности:
- Пользовательские отчеты по электронной почте;
- Бессерверность и простота управления;
- Надежный API;
- Бессерверное автомасштабирование;
- Ценообразование с оплатой по факту использования
Power BI
Ключевые особенности:
- Интеграция с Excel;
- Мощные возможности ввода и подключения данных;
- Дашборды на основе данных Excel;
- Широкий выбор визуальных и графических средств
Sisense (бывший Periscope)
Sisense - это комплексная платформа для анализа данных, которая обеспечивает доступность обнаружения и анализа данных как для клиентов, так и для сотрудников с помощью встраиваемой масштабируемой архитектуры.
Ключевые особенности:
- Коннекторы данных практически для всех основных сервисов и источников данных;
- Для нетехнических пользователей обеспечивается возможность работы без кода, хотя платформа также поддерживает Python, R и SQL;
- Интеграция с Git и создание пользовательских наборов данных;
- Дорогая, поскольку основана на модели оплаты за лицензию на одного пользователя;
- Некоторые функции находятся в стадии разработки, например, доставка отчетов по электронной почте и рендеринг отчетов
ThoughtSpot
Ключевые особенности:
- Естественный язык запросов
Mode
Ключевые особенности:
- CSS-дизайн для приборных панелей;
- Функции совместной работы, позволяющие быстро создавать прототипы до перехода на премиум-план;
- Поддержка Git
Metabase
Ключевые особенности:
- Отличный вариант для начинающих, очень гибкий инструмент;
- Имеет docker, что позволяет сразу же запустить его в работу;
- Аналитика самообслуживания
Redash
Ключевые особенности:
- API
- Написание запросов в их естественном синтаксисе;
- Использование результатов запросов в качестве источников данных для объединения различных баз данных
Некоторые из этих инструментов имеют бесплатные версии. Например, Looker Data Studio - бесплатная версия с базовыми функциями дашбордов, такими как электронная почта. Некоторые функции являются платными, например, моделирование данных, оповещения и интеграция с git.
Все они являются отличными инструментами со своими плюсами и минусами. Некоторые из них более удобны в использовании, некоторые могут предложить более надежные API, функции CI/CD и интеграцию с git. Для некоторых инструментов эти функции доступны только в платной версии.
Заключение
Современные приложения, управляемые данными, требуют наличия базы данных для хранения текущих данных приложения. Поэтому если у Вас есть приложение, которое необходимо запустить, рассмотрите архитектуру OLTP и RDS.
Озера данных, хранилища, дома-озера и базы данных имеют свои преимущества и служат для разных целей.
Компании, которым требуется аналитика Больших данных, выполняющая сложные SQL-запросы к историческим данным, могут предпочесть дополнить свои базы данных хранилищем данных (или "озером"). Это делает стек данных гибким и современным.
В общем, ответ всегда один и тот же: выбирайте самое недорогое или то, что лучше всего сочетается с Вашим стеком данных.
Попробуйте, и Вы убедитесь в том, что реляционная база данных может быть легко интегрирована в платформу данных. Неважно, будет ли это озеро данных или хранилище данных - разнообразные коннекторы позволят легко и беспрепятственно извлекать нужные Вам данные.
Однако есть несколько моментов, которые необходимо учитывать.
Главное здесь - попробовать инструменты работы с данными, чтобы понять, насколько они соответствуют требованиям нашего бизнеса.
Например, некоторые BI-инструменты могут предлагать только цены с оплатой за одного пользователя, что не очень подходит в случае, если нам необходимо предоставлять приборную панель внешним пользователям.
Если есть какие-то преимущества в плане экономии, то, возможно, лучше хранить инструменты обработки данных у того же поставщика облачных вычислений, где находится стек разработки.
Можно проверить, не дублируется ли функциональность инструментов, например, действительно ли нам нужно BI-решение, которое будет выполнять моделирование данных в собственном OLAP-кубе, когда мы уже делаем это в хранилище данных?
Моделирование данных имеет очень большое значение!
Действительно, оно определяет, как часто мы будем обрабатывать данные, что неизбежно отразится на стоимости обработки.
Переход к озеру или хранилищу данных будет зависеть в первую очередь от квалификации ваших пользователей. Решение для хранилища данных обеспечит большую интерактивность и сузит наш выбор до продукта, ориентированного на SQL (Snowflake, BigQuery и т.д.).
Озера данных предназначены для пользователей с навыками программирования, и мы хотели бы выбрать продукты на языке Python, такие как Databricks, Galaxy, Dataproc, EMR.
Полезные ссылки
- https://www.mckinsey.com/capabilities/mckinsey-digital/our-insights/how-to-build-a-data-architecture-to-drive-innovation-today-and-tomorrow
- https://aws.amazon.com/emr/
- https://cloud.google.com/learn/what-is-a-data-lake
- https://medium.com/towards-data-science/data-pipeline-design-patterns-100afa4b93e3
- https://www.snowflake.com/trending/data-architecture-principles


