

Физическое хранение и вычисления: как Doris обрабатывает данные
Doris проектируется как распределенная аналитическая база данных, ориентированная на real-time аналитику. В центре внимания находится эффективное физическое хранение и связанное с ним вычисление: как данные представляются на диске, как они читаются и конвертируются в результаты запросов, какие механизмы поддерживают консистентность и отказоустойчивость, и как эти механизмы влияют на производительность аналитических сценариев. В этой главе раскрываются ключевые концепции физического уровня Doris: структура хранения, формат данных на диске, механизмы чтения и обработки, а также жизненный цикл данных от момента загрузки до устаревания и удаления.
Doris отделяет вычисления от хранения и распараллеливает их по нескольким узлам. Каждая копия данных хранится в том виде, который оптимизирован под аналитические запросы: колоночное представление, возможность быстрого сканирования конкретных столбцов и эффективные техники сжатия. Важной частью является единица хранения под названием tablet, которая далее делится на Rowset и относится к конкретной таблице. Концепции базового rowset и Delta-rowset позволяют поддерживать семантику инкрементных изменений без немедленной переработки всего существующего храненного объема. Эти подходы создают баланс между вставками в реальном времени, обновлениями архивной части данных и необходимостью устойчивого и предсказуемого чтения больших объемов данных.
Чтобы понять физическую сторону Doris, важна последовательность взаимосвязанных слоев: от физического расположения данных на диске до скоринга и оптимизации чтения, включая индексы, фильтры и кодирования. Рассмотрим, как эти слои работают вместе для обеспечения высокой скорости сканирования и анализа.
- Краткое содержание главы
- Архитектура хранения в Doris: tablet, rowset, базовый и дельтовой наборы, как данные физически размещаются на диске.
- Форматы и компрессия: колоночарование, кодирование значений, словари, фильтры и способы экономии места.
- Чтение и вычисления: векторизованное выполнение, конвейеры чтения, оптимизация памяти и кэширования.
- Жизненный цикл данных: нагрузка, компакция, удаление и поддержание согласованности.
Архитектура физического хранения Doris
Данные в Doris физически разделены на shard-единицы, которые называют tablet. Каждый планшет является логической частью конкретной таблицы и хранит данные в формате колонок, оптимизированном под сканирование больших столбцов. Таблеты размещаются на нескольких узлах (BE - backend), что обеспечивает распределение нагрузки и масштабируемость.
Главная идея состоит в том, что данные внутри планшета группируются в Rowset. Rowset представляет собой упорядоченный набор файлов на диске, и существует различие между базовым Rowset и Delta-Rowset. Базовый Rowset отражает устойчивую, сводную копию данных на момент последней полной компактации. Delta-Rowset содержит инкрементальные изменения: новые вставки, обновления и удаление строк. Во время выполнения запроса движок способен «мерджить» базовый Rowset с актуальными Delta-Rowset, чтобы получить консистентную картину данных без необходимости повторной загрузки и перерасчета всего объема.
Такой подход позволяет оптимизировать нагрузку на диске и поддерживать непрерывность доступа к свежим данным, не прерывая аналитические запросы. В процессе чтения Doris применяет зоны зонального филтра и вспомогательные индексы (например, Bloom-фильтры) на уровне Rowset, чтобы быстро исключать irrelevant-страницы и уменьшать объёмы сканируемых данных.
- Важно помнить: планшеты и Rowset не являются абстрактной концепцией, они отображают реальное размещение данных на носителях и влияют на планирование запросов и распределение вычислений. Эффективность архитектуры хранения напрямую зависит от того, как данные разделены по планшетам и как часто происходят изменения между базовым и дельтовым набором.
Форматы и структура данных на диске
На диске Doris сохраняет колоночный формат, который позволяет пропускать целевые столбцы при сканировании и очень быстро применять агрегации и фильтры. Каждую колонку хранит автономно, что облегчает компрессию и кэширование. Внутренние кодирования применяются на уровне отдельной колонны: словари, Run-Length Encoding (RLE), битовые маски и другие техники компрессии, адаптированные под распределенные рабочие нагрузки.
Компрессия и кодирование служат нескольким целям:
- снижение объема памяти и дискового пространства;
- ускорение передачи по сети между BE и FE и между узлами кластера;
- сокращение объема чтения и обработки за счет снижения объема данных, попадающих в конвейер.
Данные в Rowset упакованы в файловой системе колонно-ориентированного типа, что позволяет Дорису быстро считывать только те столбцы, которые необходимы для конкретного запроса. Дополнительные фильтры, такие как Bloom-фильтры и зоновое индексирование (Zone Maps), используются для раннего отсечения участков данных, не попадающих в выборку, что особенно полезно в больших таблицах с разбивкой по диапазонам значений.
Как именно организованы файлы на диске, можно описать так:
- базовый Rowset содержит устойчивую копию данных на момент последней полной компакции;
- Delta-Rowset аккумулирует вставки и изменения, которые будут применены к базовому набору в процессе времени;
- структура колонок развернута по файлам, соответствующим каждому столбцу, с отдельными блоками кодирования и сжатия;
- метаданные содержат минимальные описания: схемы колонок, типы данных, ссылки на Rowset, порядок столбцов и информацию об актуальности Rowset.
Эти механизмы сочетаются с механизмами контроля версий и метаданными FE (Frontend), которые позволяют восстанавливать корректную последовательность изменений и поддерживать консистентность при выполнении запросов в условиях распределенного выполнения.
Чтение и вычисления: как Doris обрабатывает аналитические запросы
Дорис строит вычисления вокруг концепции векторизованного выполнения и пакетного чтения. Векторизация означает работу с колонарными векторами значений: каждая операция - арифметика, сравнение, агрегация - применяется к массиву значений столбца, а не к отдельной строке. Такой подход позволяет:
- увеличить пропускную способность процессоров за счет SIMD-инструкций;
- снизить расход памяти за счет последовательного доступа к памяти;
- ускорить выполнение сквозных операторов, таких как сканирование, фильтрация, агрегации, соединения.
В процессе выполнения Doris читает только необходимые Rowset и колонки, поддерживая фильтры, находящиеся на этапе чтения. Например, для диапазонного скана значения в колонке могут быть отфильтрованы на уровне Zone Map еще до извлечения конкретных страниц данных, что экономит как CPU, так и IO.
Кроме того, Doris применяет различные техники оптимизации на раннем этапе конвейера:
- предикаты фильтруются как можно раньше, чтобы не обрабатывать лишние строки;
- используются Bloom-фильтры для пропуска неверных ключей в join-операциях;
- предусмотрена поддержка фильтрации по суперпользовательским функциям и выражениям, которые компилируются и выполняются в векторном режиме.
Уровни кэширования и буферизации играют важную роль в поддержании низких задержек на повторных запросах и высоких скоростей чтения для повторно используемых данных. В Doris возможно кэширование часто запрашиваемых колонок в памяти узла исполнения, что позволяет существенно снизить задержку для аналитических сценариев реального времени.
Понимание того, как данные читаются из Rowset, помогает оптимизировать запросы: например, выборочные сканы по ключу могут избегать полного пр scans, если диапазон ключей ограничен и зона карта (Zone Map) хорошо скоординирована с требуемыми столбцами.
Жизненный цикл данных: загрузка, компакция, удаление
Физическое хранение любит предсказуемый жизненный цикл данных. Doris поддерживает инкрементальные вставки, обновления и удаления через механизм Delta-Rowset и периодическую компакцию, которая преобразует совокупность Delta-Rowset в более эффективную форму в базовом Rowset. Это важно для обеспечения консистентности и сохранения эффективности сканирования при длительной эксплуатации.
-
Загрузка данных. В Doris загрузкам предшествуют этапы валидации схемы, распределение по Tablet и распределение файлов по узлам. Для реального времени часто применяется потоковая загрузка, которая консолидируется в Delta-Rowset с минимальной латентностью. В сценариях больших загрузок применяется пакетная загрузка, которая затем синхронизируется с существующими Rowset и репликами.
-
Компакция. Периодическая компакция объединяет Delta-Rowset с базовым Rowset, формируя новый базовый набор данных и уменьшая количество объектов на диске. Компакция уменьшает фрагментацию и упрощает длительные запросы. В процессе компакции Doris аккуратно управляет версионностью, чтобы клиенты, работающие с данными в реальном времени, не столкнулись с видимыми несогласованностями.
-
Удаление и tombstones. Удаление строк и фиксация изменений отражаются в Delta-Rowset через специальные маркеры. Время от времени такие изменения применяются к основному набору данных через процесс винтовой очистки и перераспределения памяти. Эффективная обработка удалений критична для поддержания точности запросов и экономии места.
-
Жизненный цикл и доступность. Doris реализует стратегию репликации и распределения нагрузки так, чтобы потеря одного узла не приводила к недоступности данных. Файлы и метаданные дублируются на нескольких BE-узлах и в рабочих пространствах объекта-складирования (OSS/HDFS/S3). При этом функциональность чтения остается прозрачной для пользователей; запросы продолжают обслуживаться за счет другого узла, пока пропавший узел восстанавливается.
Консистентность, отказоустойчивость и управление метаданными
Консистентность данных достигается через координацию между FE и BE, а также через контроль версий Rowset и поддержание согласованности между базовым и дельтовым состоянием. Метаданные таблиц, структур и их состояний хранятся в сервисе метаданных FE, который обеспечивает версионирование и восстановление состояний в случае сбоев. В режиме распределенного выполнения Doris применяет стратегии отказоустойчивости на уровне репликации данных, чтобы обеспечить доступность и целостность результатов анализа даже при частичных сбоях.
Контроль над схемами и данными включает:
- управление версиями схем таблиц и столбцов;
- отслеживание зависимостей между Rowset и планшетами;
- механизмы отката изменений и восстановления после сбоев;
- контроль консистентности трансакций и режимов чтения.
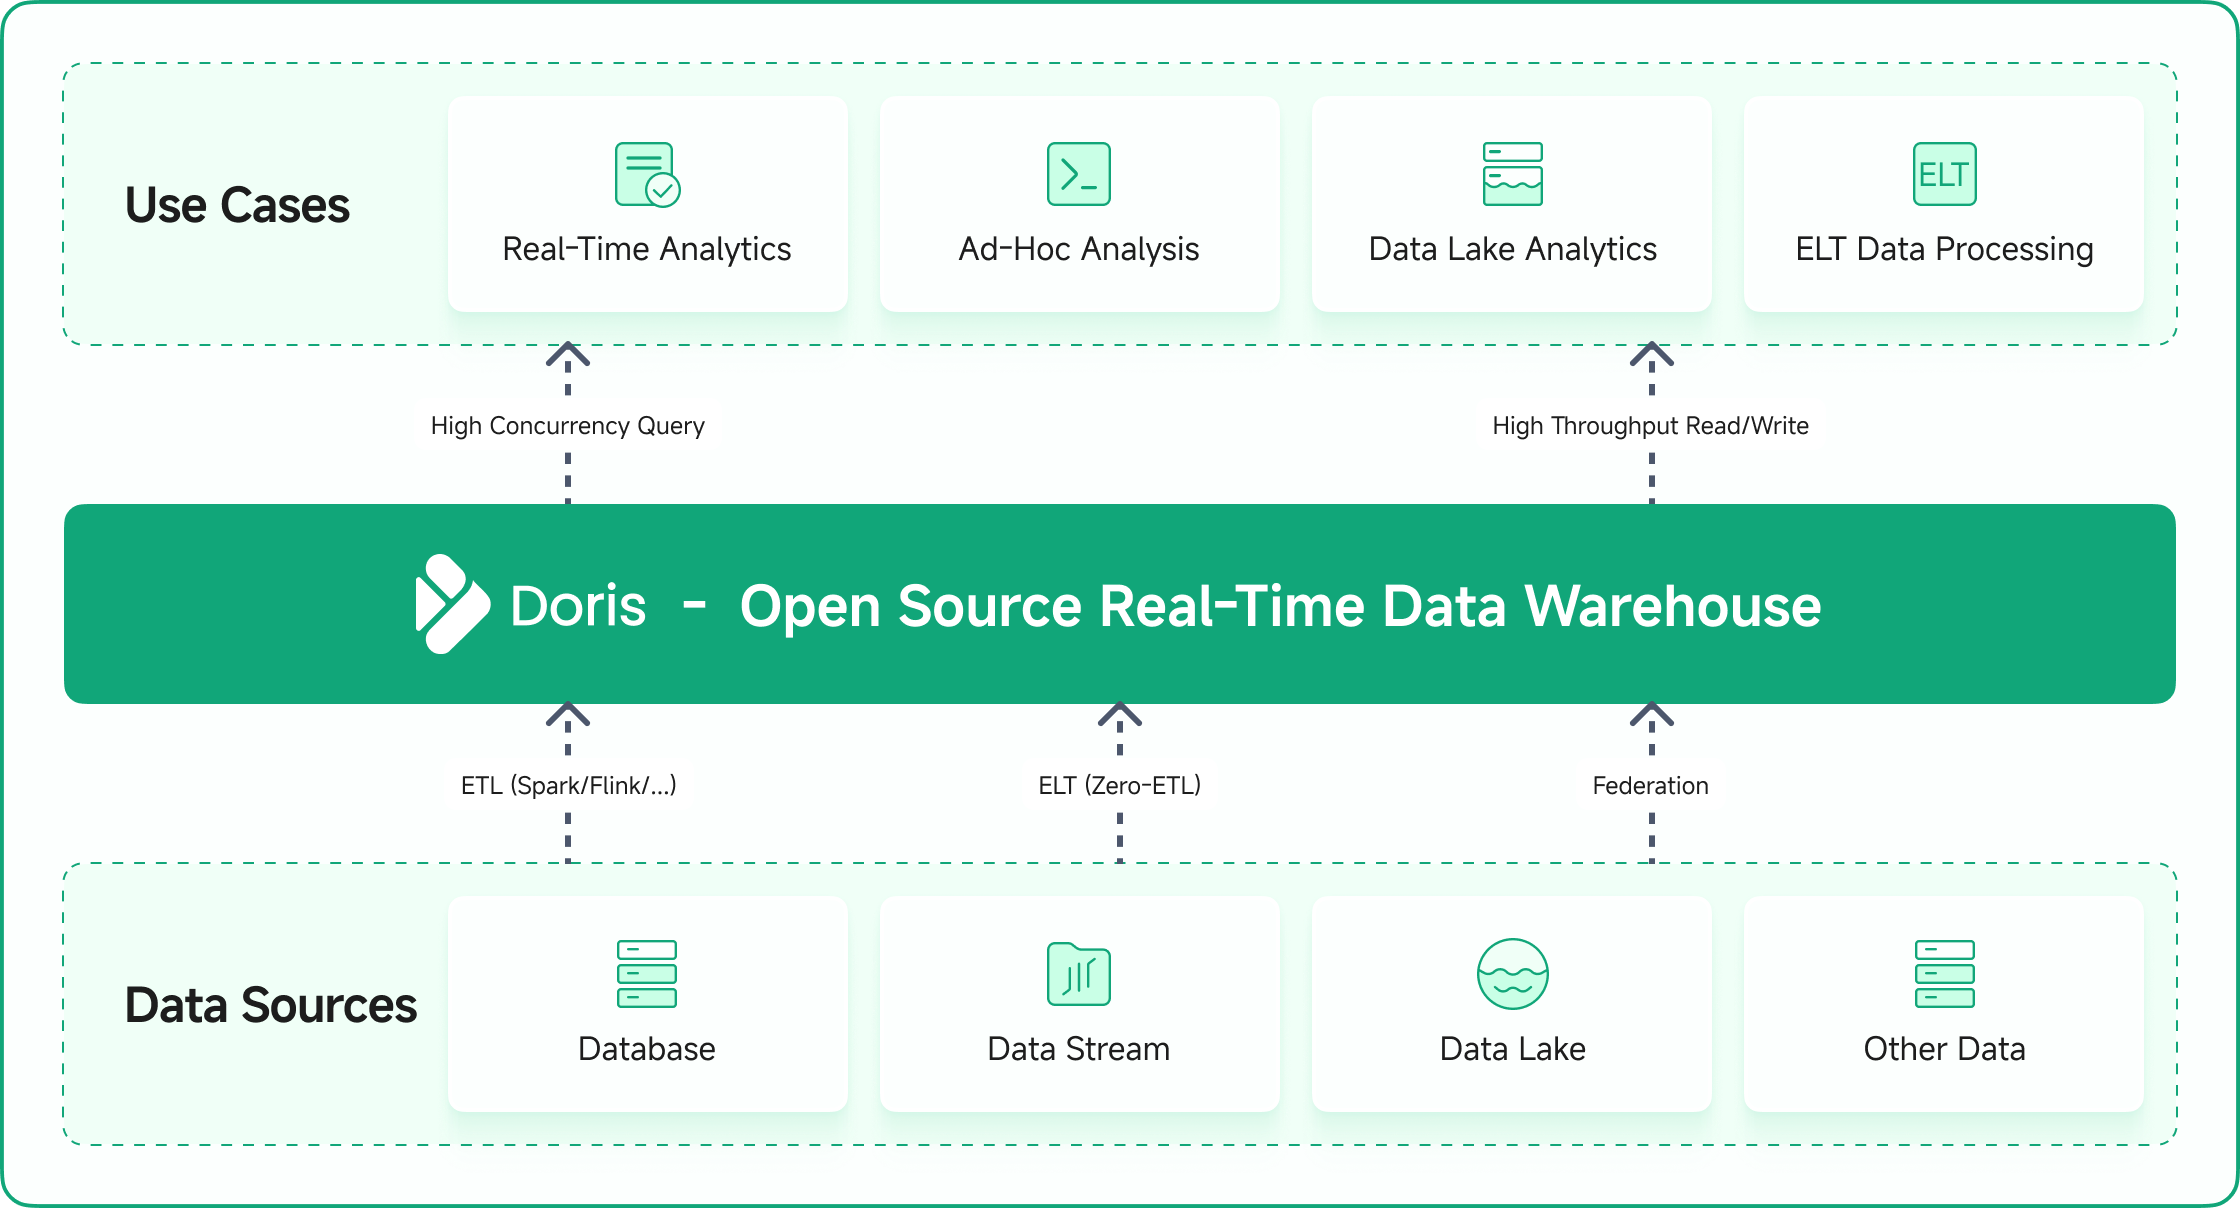
Интеграция с хранилищами объектов (HDFS, S3 и т. п.) обеспечивает долговременное хранение данных и устойчивость к выходу из строя отдельных дисков или узлов. Doris поддерживает оптимальные пути чтения и записи в зависимости от выбранного хранилища, включая режимы с высокой пропускной способностью и режимы с упором на низкую задержку для реального времени.
Интеграции и эксплуатационные аспекты
Практическая эксплуатация Doris требует ясного понимания того, как физическое хранение влияет на производительность и устойчивость систем. Важные аспекты включают настройку параметров, связанных с хранением и сжатием, выбор подходящих политик компакции, конфигурацию индексов и фильтров, а также мониторинг характеристик IO и использования памяти. Интеграции с системами мониторинга и алертинга позволяют держать под контролем задержки выполнения, пропускную способность сканов, уровень фрагментации и частоту компакций.
С точки зрения практики внедрения, ключевые шаги включают:
- определение стратегий разбиения таблиц на планшеты и распределение нагрузки;
- выбор стратегий компрессии и кодирования, подходящих под тип данных и workload;
- настройку полей Bloom-фильтров и Zone Maps для ускорения фильтрации;
- настройку политики джобы по инкрементной загрузке и регулярной компакции;
- обеспечение резервирования и восстановления данных через выбранное хранилище и репликацию.
Оптимальные параметры зависят от характера аналитических нагрузок: частоты вставок, объема данных, необходимой задержки и типа запросов (сканирование, join, агрегация). В продвинутых сценариях рекомендуется строить профили нагрузки, использовать тестовые стенды и проводить постоянный мониторинг коэффициента сжатия, количества Delta-Rowset и частоты компакций, чтобы сбалансировать скорость ingest и скорость чтения.
Key takeaways
- Doris хранит данные в планшетах, разделяемых на базовые и дельтовые Rowset, что обеспечивает быстрое внедрение изменений без потери доступности.
- Колоночный формат хранения и эффективные кодирования позволяют уменьшать размер данных и ускорять сканирование для аналитики.
- Векторизованное выполнение и раннее применение предикатов уменьшают объем обрабатываемых данных и улучшают производительность.
- Жизненный цикл данных, включая компакцию и обработку tombstones, поддерживает консистентность и управляемость большой загрузки.
- Интеграции с объектными хранилищами и продуманная архитектура транзакций обеспечивают устойчивость к сбоям и гибкость внедрения.
- Оптимизация параметров под конкретные рабочие нагрузки и регулярный мониторинг являются ключами к достижению реального времени и предсказуемой производительности.
- Важное значение имеет согласованность метаданных и координация между FE и BE для надёжной работы кластеров Doris.
FAQ
- Что такое Tablet и Rowset в Doris и зачем они нужны?
- Tablet - это логическая единица хранения таблицы, распределенная по серверам. Rowset - набор файлов, хранящих данные в колонно-ориентированном виде. Разделение на базовый Rowset и Delta-Rowset позволяет эффективно поддерживать как исторические данные, так и поток изменений без частой переработки всего объема данных.
- Как Doris обеспечивает быструю обработку запросов на больших объемах данных?
- Doris применяет векторизованное выполнение, где операции работают на колоннарных векторах значений, использует Zone Maps и Bloom-фильтры для раннего исключения данных, и читает только необходимые колонки. Это сокращает IO и повышает пропускную способность сканов.
- Какие форматы данных используются на диске и как выбираются кодирования?
- На диске данные хранятся колонно-ориентированно. Каждая колонка может использовать словари, RLE и другие кодирования в зависимости от типа данных и распределения значений. Компрессия (например, LZ4, Zstd) снижает размер и ускоряет чтение через менее затратное I/O.
- Как работает инкрементальная загрузка и обработка изменений?
- В процессе ingest сначала записываются новые данные в Delta-Rowset. Затем в рамках жизненного цикла выполняется компакция, которая объединяет Delta-Rowset с базовым Rowset, создавая обновленную устойчивую копию. Это обеспечивает баланс между свежестью данных и эффективностью чтения.
- Какие механизмы обеспечивают консистентность и устойчивость Doris?
- Doris поддерживает координацию между FE и BE и хранение метаданных в сервисе метаданных. Репликация и управление версиями Rowset позволяют восстанавливать состояние после сбоев, а регулярные проверки целостности и контроль версий схем помогают избежать несогласованностей.
- Какие хранилища поддерживает Doris для физического хранения данных?
- Doris поддерживает локальные файловые системы и хранилища объектов, такие как HDFS и S3-совместимые сервисы. Это обеспечивает гибкость в выборе места хранения и устойчивость к сбоям узлы.
- Как настраивать параметры хранения для реальной производительности?
- Важны параметры кодирования и компрессии, политики компакции, размер Delta-Rowset, настройка Bloom-фильтров и Zone Maps, а также коэффициенты репликации и балансировка нагрузки между планшетами и узлами. Рекомендуется строить профиль нагрузки и проводить нагрузочные тесты перед продвинутой эксплуатацией.
- Как Doris оптимизирует память и кэширование при выполнении запросов?
- Doris использует кэш колонок, читаемых повторно, и эффективное управление памятью в конвейере выполнения. Кэширование снижает задержки на повторные запросы и ускоряет агрегации и сканирования.
- Что важно учитывать при интеграции Doris в существующую инфраструктуру?
- Важно согласовать стратегии загрузки данных (streaming vs. batch), обеспечить совместимость форматов данных и контролировать требования к хранению, мониторингу и резервному копированию. Также следует планировать переход между различными уровнями хранения (горячие и холодные данные) для оптимального соотношения цена/производительность.
- Какие сценарии лучше всего подходят для Doris в реальном времени?
- Аналитика в реальном времени, требующая быстрых сканов и агрегаций по большим объемам данных, например мониторинг событий, финансовая аналитика, операционный BI с задержкой в рамках секунды или нескольких секунд. Архитектура хранения Doris обеспечивает необходимую скорость и предсказуемость для подобных нагрузок.


