

Репликация, консистентность и гарантии доставки
Репликация в Apache Kafka является базовым механизмом обеспечения долговечности и отказоустойчивости потоковых систем. Эта глава раскрывает, как устроены лидеры и копии, что такое ISR и how it works на практике, какие гарантии доставки можно достичь и как они зависят от конфигурации и архитектуры интеграционных цепочек. Рассматриваются аспекты консистентности и взаимодействие между продюсерами, брокерами и потребителями, а также практики эксплуатации и мониторинга для устойчивых конвейеров данных.
В современном потоке данных репликация - это не только вопрос сохранности записей, но и часть общей стратегии обеспечения согласованности сквозных процессов: от инвариантов в источниках до целей-потребителей и систем sinks. В этой главе особое внимание уделяется тому, как архитектура Kafka влияет на задержку, пропускную способность и риски потери данных, какие режимы доставки доступны и какие комбинации настроек обеспечивают требуемый уровень устойчивости в реальных условиях эксплуатации.
- Архитектура репликации в Kafka: лидеры, follower, ISR, выбор лидера, влияние на устойчивость.
- Гарантии доставки и уровни согласованности: at-least-once, at-most-once, exactly-once, роль транзакций и изоляций.
- Практики эксплуатации: конфигурации min.insync.replicas, acks, replication.factor, мониторинг ISR и план реагирования на сбои.
- Интеграционные паттерны: конец-конца Exactly-Once в потоковых конвейерах, паттерны с Kafka Connect и внешними системами.
- Риски и операционные подходы: разделение мозга, задержки репликации, корректное управление обновлениями конфигураций и резервами.
Архитектура репликации
Каждый разделярный вопрос репликации в Kafka строится вокруг идеи: каждый раздел (partition) топика имеет одного лидера и один или несколько последователей. Репликацияfactor определяет общее число копий раздела, включая лидера. Взаимодействие продюсеров и брокеров строится по схеме «лидер принимает запись, затем реплики копируют её» - это обеспечивает устойчивость к сбоям отдельных брокеров.
- Лидер и копии: клиентские записи поступают к лидеру раздела. Лидер записывает данные в свой локальный журнал и реплицирует их к последователям. Последователи осуществляют вытягивание (fetch) журналов и поддерживают копию на уровне блока данных. Такой подход позволяет быстро продолжать обработку после сбоев, не дожидаясь восстановления всех копий.
- ISR - In-Sync Replicas: совокупность реплик, которые синхронно отстаивают лидера и не отстают от него по логу на заданный порог времени. Эти реплики являются «живыми» в момент записи и важны для гарантии доставки. Если копия перестает быть синхронной, она удаляется из ISR до устранения проблемы.
- Репликационные потоки и консистентность: лидер отвечает за согласование записи, после того как она подтверждена необходимым числом копий в ISR, запись считается частично или полностью подтвержденной. Этот механизм напрямую влияет на гарантии доставки и устойчивость к сбоям.
- Вопросы выбора лидера и восстановления: при отказе лидера происходит репликация и лидерство выбирается из числа реплик в ISR. Если ISR опустится ниже порога min.insync.replicas, новые записи с acks=all могут быть отвергнуты, чтобы не нарушить гарантии.
Архитектура репликации тесно связана с параметрами конфигурации: replication.factor задаёт число копий раздела, min.insync.replicas определяет минимальное допустимое число копий в ISR, а acks управляет уровнем подтверждений со стороны лидера к продюсеру. В современных версиях Kafka возможно различное поведение в зависимости от инфраструктуры: классическая реализация на основе ZooKeeper, а также развитие архитектуры на базе KRaft, где управление координацией постепенно переносится в новый механизм. Эти различия влияют на операционные практики, но базовые принципы лидера, копий и ISR остаются общими.
Алгоритмы и протоколы репликации
На практическом уровне репликация выполняется через механизм отправки логов лидером и последующего копирования этим логов на follower. Лидер обеспечивает последовательность записей и их консистентность относительно последних позиций в журнале. Репликационные задержки зависят от сетевой задержки, скорости записи и конфигурации fetch/append-процессов на брокерах. В рамках протокола важно понимать понятие «постоянной» или «периодической» фиксации лога и момент, когда запись становится видимой потребителям.
- Протокол доверенности и подтверждений: продюсер выбирает режим acks, чтобы определить, на каком уровне будет подтверждаться запись. Режим acks=all (или acks=-1 в некоторых реализациях) требует подтверждений всех реплик в ISR, что повышает устойчивость к потере данных, но может увеличить задержку.
- Разделение и координация версий: если в системе возникают задержки или проблемы со связью, ISR может изменяться, и это напрямую влияет на способность системы поддерживать гарантии. В таких условиях рекомендуется оперативно переустановить параметры и обеспечить достаточный запас копий в ISR для поддержания требуемой устойчивости.
- Лог-архитектура и секции журнала: разделы хранят данные в виде сегментов и маркеров «high watermark» и «end offset» помогают определить, какие записи безопасны для потребления и какие еще находятся в процессе репликации.
Гарантии доставки и консистентность
Гарантии доставки в Kafka формируются на пересечении поведения продюсеров, брокеров и потребителей. Основные режимы:
-
At-most-once: запись может быть потеряна в случае повторных отправок или ошибок. Этот режим достигается без дополнительных гарантий в части подтверждений и может иметь место, когда требуется минимальная задержка.
-
At-least-once: в большинстве сценариев конфигурация приводит к возможности дубликатов, но обеспечивает доставку всех сообщений. Это достигается, например, через упрощенные режимы подтверждений и ретрансляцию.
-
Exactly-once: достигается за счет использования Idempotent Producer и Transactional API. Idempotent Producer предотвращает дублирование на уровне записи, а транзакции позволяют объединить записи и смещение потребителей в единый атомарный блок. Поддержка end-to-end exactly-once во всех сценариях требует внимательного проектирования источников, обработчиков и нагрузок на sinks.
-
Idempotent producer: включение идемпотентности исключает дублирование при повторных попытках записи в тот же раздел. Это особенно критично в случае с ретрансляциями или временными сбоями сети.
-
Транзакции и atomic writes: transactional.id и API beginTransaction/commitTransaction позволяют группировать несколько отправок в одну транзакцию на разных разделах и темах. В случае успешной транзакции все записи становятся видимыми потребителям и подтверждаются к потребителям после выполнения commit.
-
Read_committed и outbox-паттерны: потребители могут выбрать isolation.level=read_committed, чтобы видеть только подтвержденные транзакциями данные. Однако end-to-end exactly-once требует синхронизации с внешними системами и иногда дополнительных механизмов (outbox, idempotent sinks).
Важно отметить нюанс: achieving exactly-once на уровне Kafka не означает автоматически отсутствие дубликатов на внешних системах. Внешние источники и sinks должны поддерживать соответствующую идемпотентность или использовать паттерны повторной обработки (idempotent writes, deduplication, смещение и т.д.). Для многих escenarios оптимальным является баланс между гарантией и сложностью реализации.
Консистентность и изоляция
Концептуально Kafka реализует последовательную запись в журнале (лог) и поддерживает порядок внутри раздела. Вопрос консистентности - это отношение между лидером и копиями в ISR. Потребители читают данные в порядке записи и могут рассчитывать на слабую или сильную последовательность в рамках одного раздела.
- Read_uncommitted vs Read_committed: потребители могут видеть записи до их завершения в рамках транзакций, если изоляция не установлена в режим read_committed. Для критически важных интеграционных процессов рекомендуется изоляция read_committed.
- Offsets и консистентность: механизм смещений потребителей влияет на повторное воспроизведение при повторном потреблении. В сценариях Exactly-Once требуется аккуратное управление offsets, часто через транзакции и партнёрство с обработчиками потоков (stream processors) и sinks.
Реализация, конфигурация и эксплуатация
Эффективная реализация гарантий и консистентности требует продуманной конфигурации и мониторинга.
- replication.factor: разумная величина, как правило 3 или более, чтобы выдержать отказ одного брокера без потери данных. В сочетании с min.insync.replicas это создаёт устойчивую базу для режимов acks=all.
- min.insync.replicas: задаёт минимальное число реплик в ISR, которое должно быть «живым» для успешности записи с acks=all. При падении числа копий ниже этого порога записи будут отвергаться, что защищает от потери данных в условиях частичного отказа.
- enable.idempotence и transactional.id: включение идемпотентности полезно повсеместно; транзакции позволяют группировать операции и обеспечивать атомарность между разделами и темами.
- isolation.level: по умолчанию read_uncommitted, но для Exactly-once и цепочек с двойной записью рекомендуется read_committed.
Пример конфигурации продюсера для обеспечения Exactly-once semantics:
## Properties props = new Properties();
props.put("bootstrap.servers", "kafka-broker1:9092,kafka-broker2:9092");
props.put("enable.idempotence", "true");
props.put("acks", "all");
props.put("transactional.id", "txn-processor-1");
Producer producer = new KafkaProducer(props, new StringSerializer(), new StringSerializer());
producer.initTransactions();
На стороне потребителя для поддержки изоляции можно указать:
Properties props = new Properties();
props.put("group.id", "data-consumers");
props.put("isolation.level", "read_committed");
props.put("enable.auto.commit", "false");
Такие настройки позволяют снизить риск обработки непроверенных данных и обеспечить более предсказуемые результаты на стороне потребителя.
Практики устойчивых конвейеров данных
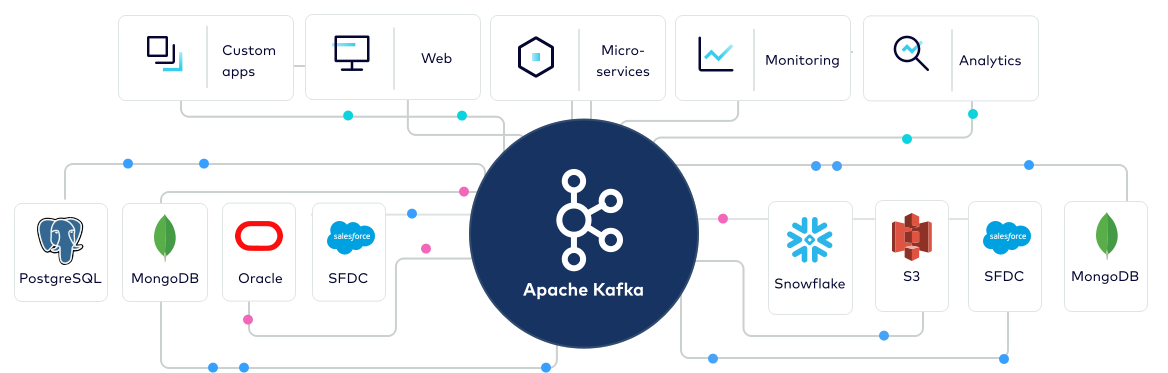
- End-to-end exactly-once требует согласованной реализации на всех звеньях конвейера: источники, потоковая обработка и sinks. Часто применяется паттерн outbox: отправка изменений сначала в локальный outbox и только затем в Kafka, а затем повторная запись из outbox в целевые системы.
- Kafka Connect и Debezium: эти инструменты поддерживают режимы, близкие к Exactly-once в рамках возможностей конкретной версии. Важно помнить, что внешние СУБД или хранилища всё равно могут быть источником дубликатов без дополнительных мер.
- sinks и idempotent writes: важно проектировать sinks так, чтобы повторные попытки не приводили к неконсистентному состоянию. В идеале - idempotent write к целевой системе или использование уникальных идентификаторов и дедупликации на стороне принимающей системы.
Эксплуатация и мониторинг
Мониторинг состояния репликации и консистентности - неотъемлемая часть эксплуатации.
- ISR monitoring: размер ISR и темп лагов служат индикаторами надёжности. Наблюдают: lag metrics, lag in ms, number of partitions with under-replicated replicas.
- Инструменты: kafka-topics.sh --describe для статуса разделов, JMX-метрики брокеров, системы мониторинга (Prometheus/Grafana) с соответствующими метриками по lag, replication, throughput.
- Реакции на сбои: если ISR упал ниже min.insync.replicas, необходимо скорректировать конфигурацию, либо увеличить число копий, либо снизить требования к согласованности. В реальных кластерах часто применяют стратегии подмножества нагрузок и перераспределения партиций.
Оперативная практика предполагает также план по эскалации и обновлениям. При плановых обновлениях кластера разумно иметь резервные копии/бэкапы и проверять сценарии failover. В современных системах рекомендуется поддерживать тестовую среду для проверки полного цикла от записи до sinks и обратно, чтобы снизить риски в проде.
Паттерны интеграции и практические выводы
- Паттерн «exactly-once» в интеграциях часто достигается на уровне продюсера и sink-слоя, но не всегда во внешних системах. Важно проектировать архитектуру так, чтобы любые повторные обработки не приводили к некорректному поведению.
- Использование транзакций в продюсере и режимов read_committed в потребителях позволяет снизить вероятность повторной обработки и ошибок консистентности.
- При проектировании конвейеров данных полезно закладывать idempotentность на уровне целевых хранилищ и реализаций sinks; этот подход минимизирует риски дублирования.
- Встроенная интеграция через Kafka Connect и Debezium полезна для упрощения построения конвейеров, но требует внимательного подхода к режиму доставки и совместимости версий.
Key takeaways
- Репликация в Kafka строится вокруг лидера и копий раздела, ISR обеспечивает актуальность копий и надёжность данных.
- Гарантии доставки зависят от режимов acks, min.insync.replicas и использования идемпотентности и транзакций.
- Exactly-once достигается через идемпотентность продюсера и транзакции, но энд-ту-эндExactly-once требует согласованных паттернов между источниками, обработкой и sinks.
- Конфигурации replication.factor, min.insync.replicas и acks влияют на устойчивость к сбоям и задержку; баланс между долговечностью и производительностью выбирается под задачу.
- Мониторинг ISR и lag является критическим для своевременного обнаружения проблем и предотвращения потери данных.
- В интеграциях следует проектировать sinks и источники с учетом идемпотентности и возможностей дедупликации.
- Эффективная архитектура репликации требует частых ревизий конфигураций и планов реагирования на сбои, включая сценарии обновления и масштабирования кластера.
FAQ
- Что такое ISR и почему он важен для гарантии доставки?
ISR (In-Sync Replicas) - это набор реплик раздела, которые синхронно поддерживают журнал лидера. Они предоставляют гарантии, что запись получит подтверждение только тогда, когда она присутствует на всех репликах из ISR, что обеспечивает устойчивость к сбоям и согласованность. Если копия выходит из ISR, она больше не учитывается при подтверждениях, до тех пор пока не догонит лидера. В случае снижения числа копий в ISR ниже min.insync.replicas, новые записи с acks=all могут быть отклонены, чтобы предотвратить потерю данных.
- Как выбрать правильный режим доставки (at-most-once, at-least-once, exactly-once) для проекта?
Выбор зависит от критичности потери данных и требований к задержке. At-most-once подходит для не критичных событий; at-least-once обеспечивает доставку, но может привести к дубликатам; exactly-once максимально детерминирован, но требует использования идемпотентности и транзакций. В реальных системах часто выбирают компромисс: производитель с acks=all и идемпотентностью, потребители с read_committed и стратегиями дедупликации на sinks.
- Какие ключевые параметры конфигурации влияют на устойчивость к сбоям?
replication.factor, min.insync.replicas и acks - на устойчивость и задержку; enable.idempotence и transactional.id - на поддержку Exactly-once; isolation.level на потребителях - на видимость записей; lag и ISR-мониторинг - на оперативное реагирование на проблемы.
- Как работает лидерская переаттестация при отказе лидера?
Если лидер выходит из строя, один из реплик в ISR становится новым лидером через механизм выборов. Новому лидеру нужно догнать журнал, после чего продолжать обслуживать запросы. Если ISR опустился ниже min.insync.replicas, производители, требующие acks=all, могут начать отклонять новые записи, чтобы предотвратить потерю данных.
- Можно ли гарантировать Exactly-once при работе с внешними sinks (например, базами данных)?
Да, но это сложнее: требуется интеграция на уровне источника, обработчика и sinks с использованием транзакций и идемпотентной записи. Часто применяют паттерны outbox, дедупликацию на целевых системах и внимательно продумывают порядок операций в sink-программах. End-to-end exactly-once зависит от возможностей внешних систем.
- Какие практики мониторинга наиболее важны для репликации?
Важны метрики ISR-размер, lag по репликам, количество Partition с under-replicated, задержки записи и обработка ошибок. Инструменты вроде kafka-topics и внешние мониторы (Prometheus/Grafana) помогут обнаруживать аномалии, планировать перераспределения и проводить безопасные обновления кластера.
- Что делать при росте задержек репликации?
Диагностика: проверить сетевые задержки, нагрузку на брокеры, балансировку лидеров, увеличение replication.factor для критических разделов или настройку min.insync.replicas в зависимости от критичности. Также полезно рассмотреть перераспределение партиций и добавление брокеров.
- Какой роли играет Zookeeper и как она меняется в контексте KRaft?
Исторически ZooKeeper координировал кластер Kafka. Современные версии развивают KRaft как замену ZooKeeper, упрощая управление и повышая управляемость. Это влияет на аспекты лидера, координации и конфигураций, но базовые принципы репликации, ISR и гарантии остаются.
- Какие ограничения существуют у транзакций в Kafka Connect и Debezium?
Connectors и Debezium поддерживают режимы транзакций для части операций, но полный end-to-end Exactly-once требуется согласованная реализация между Kafka и целевыми системами. В некоторых случаях возможно использование транзакций на стороне производителей и потребителей, однако внешние системы могут ограничивать возможности дедупликации и атомарности.
- Какие лучшие практики существуют для обновления конфигураций кластера без потери данных?
Выполнение изменений в тестовой среде, планирование обновления по частям кластера, постепенная замена лидеров и перераспределение партиций, мониторинг ISR и задержек во время обновления. Важно иметь резервный план и реплики для быстрого восстановления после ошибок, чтобы минимизировать риск потери данных и прерываний в сервисах.


