

Apache Kafka с нуля
Apache Kafka помогает строить системы, где данные передаются не пакетами раз в несколько часов, а непрерывным потоком событий. Это важно для онлайн-банкинга, ритейла, телекома, цифровых сервисов, аналитики в реальном времени и интеграции приложений, которым нужно быстро реагировать на изменения.
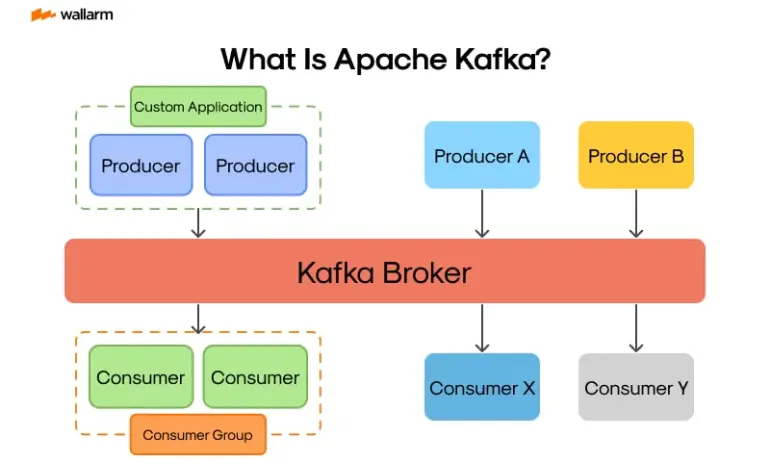
Описание начинается с базовой архитектуры Kafka: брокеры, кластеры, топики, партиции, offset, consumer groups, репликация, гарантии доставки, KRaft и ZooKeeper. Дальше раскрываются производители и потребители событий, ретраи, идемпотентность, управление доступом через TLS, SASL и ACL, а также работа со схемами данных через Avro, JSON, Protobuf и Schema Registry.
Материал подходит для первого системного знакомства с Kafka и постепенно выводит к production-сценариям: Kafka Connect, Kafka Streams, ksqlDB, CDC, интеграция с Apache Flink и Spark Structured Streaming, мониторинг, нагрузочное тестирование, эксплуатация, масштабирование и переход к зрелой event streaming-платформе.
- Введение: потоковая обработка данных и роль Apache Kafka
- Основные термины и концепции: событие, поток, журнал и параллелизм
- Контекст применения Kafka: бизнес-кейсы и ценность потоковых данных
- Архитектура Kafka: брокеры, кластеры, режимы хранения (KRaft и Zookeeper)
- Структура данных: топики, разделы (партиции) и сегменты
- Репликация, консистентность и гарантии доставки
- Модели потребления: потребители, группы потребителей, offset management
- Производители: API, конфигурации, идемпотентность и ретраи
- Соединение и безопасность: TLS, SASL, ACL и политика доступа
- Схемы данных и форматы: AVRO, JSON, Protobuf, Schema Registry
- Мониторинг и операционная телеметрия: метрики, алерты, dashboards
- Конфигурация кластера: балансировка нагрузки, ISR, min.insync.replicas
- Kafka Connect: источники и приемники данных, коннекторы
- Потоковая обработка на базе Kafka Streams: KStream, KTable и архитектура
- KSQL/ksqlDB: SQL-подход к потокам и агрегации
- Интеграционные шаблоны: Pub/Sub, Event Sourcing, CQRS в контексте Kafka
- Архитектурные паттерны потоковых интеграций: CDC, Change Data Capture
- Интеграция с фреймворками обработки: Apache Flink, Apache Spark Structured Streaming
- Архитектура данных в рамках данных потоковой платформы: data mesh, data fabric
- Архитектура миграций тем и конверсий форматов: стратегии и инструменты
- Практические кейсы: онлайн-банкинг, телеком, ритейл и цифровые сервисы
- Риски, ограничения и типовые ошибки: что нужно ожидать и как предотвращать
- Тестирование Kafka-архитектур: нагрузочное тестирование, интеграционные тесты, chaos testing
- Эксплуатация и операционная модель: SRE, SLA, аварийные планы
- Развертывание и управление в облаке: Kubernetes, Helm, контейнеризация
- Масштабирование, зрелость и эволюция платформы: дорожная карта развития
- Управление данными и комплаенс: ретенции, архивы, политика хранения
- Управление качеством данных: валидность, семантика и эволюция схем
- Миграции и внедрение: чек-листы, этапы проекта и переходные планы
- Экосистема Kafka: коннекторы, интеграционные фреймворки и облачные сервисы
- Практическая реализация: шаги от требований до продакшна
- Путь к зрелости: KPI, метрические показатели и управление изменениями


