

Основные термины и концепции: событие, поток, журнал и параллелизм
В рамках курса по Apache Kafka с нуля важнейшую роль играет четкое понимание базовых терминов и концепций. Эти понятия являются строительными блоками для проектирования потоковых систем, интеграции данных и архитектур событийного обмена. Понимание событийной модели, порядка сообщений и механизмов параллелизма позволяет формировать устойчивые и масштабируемые решения без лишних артефактов и рисков потери данных.
Смысловая цель главы - соединить теоретические основы с архитектурной реализацией в Kafka: какие данные считаются событиями, как формируется поток и журнал, и каким образом достигается параллелизм без нарушения порядка внутри критически важных единиц обработки. В материале подчеркиваются принципы консистентности, компромиссы между задержкой и гарантиями доставки, а также практические последствия выбора конфигураций и стратегий интеграции.
- Определение и взаимосвязь понятий: событие, поток и журнал, их роль в архитектуре Kafka.
- Механизмы параллелизма через партиционирование, сегменты журнала и порядок обработки.
- Принципы обеспечения порядка, консистентности и эффективности при росте объема данных.
- Архитектурные паттерны интеграции и влияние концепций на дизайн потоковых систем.
Событие, поток и журнал: базовые понятия
Событие в контексте Kafka - это фиксированное изменение состояния системы или факт, который произошёл в реальном времени и имеет смысл для последующей обработки. События представляют собой записи журнала, несущие ключевые данные: идентификатор события, время возникновения, полезную нагрузку и, при необходимости, ключ для маршрутизации. В этом смысле событие - это не просто текст или бинарная строка, а форма записи о произошедшем изменении, которая должна быть воспроизведена и сохранена для дальнейшей обработки.
Поток - это непрерывная, потенциально бесконечная последовательность событий. В рамках Kafka поток трактуется как логически связанный набор событий, привязанный ко времени и контексту бизнес-операций. Важная характеристика потока - временная упорядоченность, которая не означает жесткой линейности во всем мире, но гарантирует последовательность внутри конкретных единиц обработки. Потоковые системы работают именно с этим последовательным, но потенциально бесконечным набором данных.
Журнал в Kafka представляет собой Append-Only log - не изменяемый набор записей, который накапливается по мере поступления новых событий. Журнал разбит на разделы (партиции) и хранится на диске в виде последовательностей записей с возрастающими смещениями (offset). Каждая запись имеет смещение в рамках своей партиции, временную метку и полезную нагрузку. Журнал обеспечивает детерминированную повторяемость обработки: повторное потребление может воспроизводить ранее зафиксированные события, если това настроено соответствующим образом. Архитектура журнала поддерживает retention-политики: время жизни или размер журнала, после чего старые данные удаляются или перерабатываются.
Понимание различий между этими понятиями помогает в конструировании устойчивых к сбоям потоковых решений. В частности, важно осознавать, что:
- событие - единичная единица изменений, которая может иметь смысл только в контексте потока;
- поток - последовательность событий, где важна относительная хронология и контекст;
- журнал - долговременная, неизменяемая запись всех событий, обеспечивающая воспроизводимость и аудируемость.
Время играет ключевую роль в обработке событий. Внутри Kafka различают несколько временных концепций: event time (время возникновения события), ingestion time (время получения события брокером) и processing time (время обработки потребителем). Различие между этими аспектами влияет на возможность корректной агрегации по окнам, корреляцию событий и точность аналитических результатов. При проектировании схем событийной модели следует уделять внимание поддержке схемы типов данных и эволюции форматов без потери совместимости.
Пояснение по партиционированию и ключам: ключ записи определяет к какой партиции будет направлено событие. Такой подход обеспечивает распределение нагрузки по параллельным цепочкам обработки и позволяет сохранить относительный порядок внутри каждой партиции. Взаимосвязь между потоком и журналом становится очевидной: поток - это логический конструкт, состоящий из одного или нескольких журналов (партиций), где каждый журнал обеспечивает свой уникальный упорядоченный набор записей.
Стратегия коллегиального проектирования включает явное управление схемами, деталями времени и политики хранения. Эволюционные изменения форматов требуют совместимости (backward, forward и full compatibility) на уровне схем, чтобы новые версии систем не ломали существующие интеграции и потребителей.
Параллелизм в Kafka: сегменты, партиции и консистентность
Параллелизм в Kafka коренится в концепции партиций. Каждая партиция - это независимый упорядоченный лог, который может быть обслуживаем несколькими потребителями в рамках одного консумерного кластера. Поскольку порядок записей сохраняется внутри партиции, разделение журнала на несколько партиций позволяет реализовать параллельную обработку сообщений без нарушения взаимного порядка внутри каждой части журнала.
Ключевые механизмы параллелизма:
- Партиционирование: выбор партиции для каждой записи осуществляется по ключу или по стратегической схеме, что обеспечивает равномерное распределение нагрузки между брокерами и позволяет обрабатывать данные параллельно.
- Разделение потока на параллельные ветви: потребители, входящие в одну группу, назначают собой набор партиций. Каждый потребитель обрабатывает свою долю партиций, что позволяет параллельно обрабатывать записи из разных партиций.
- Межпартитонный порядок: порядок сохраняется только внутри конкретной партиции. Между партициями порядок не гарантируется, что следует учитывать при проектировании агрегаций и корреляции событий.
- Сегменты журнала: журнал в партиции разбит на сегменты для управления ростом файла и политиками хранения. Это снижает задержку при удалении старых записей, ускоряет поиск индексов и упрощает управление ресурсами.
Важно помнить: увеличение числа партиций повышает потенциал параллелизма, но не всегда линейно улучшает производительность. Связь между количеством партиций и задержкой потребителей зависит от характеристик нагрузки, числа потребителей в группе и архитектуры потока. В некоторых сценариях увеличение числа партиций может привести к усложнению консумерских схем и усложнить управление состоянием транзакций и угловых окон. Поэтому проектировщик должен балансировать между желаемой степенью параллелизма и сложностью согласования состояний и ошибок повторной отправки.
Из практических соображений следует помнить, что параллелизм должен сочетаться с корректной стратегией обработки ошибок и повторной попытки. В случаях, когда обработка требует глобального порядка или согласованности между бизнес-сущностями, важно реализовать внешние механизмы корреляции и идентификации событий, чтобы обеспечить консистентность на уровне приложения. Kafka, как платформа, предоставляет гибкие настройки и расширяемые паттерны, но ответственность за архитектурные решения возлагается на проектировщика и команду разработки.
Репликация и консистентность дополнительно влияют на параллелизм. В каждом разделе партиции существует лидер и набор реплик-случайных копий. Репликация обеспечивает отказоустойчивость; лидер задаёт порядок записей и отправляет данные подписчикам. В сценариях с плохим соединением или задержками следование исчерпывающим политикам ISR (in-sync replicas) может приводить к выбору нового лидера и перераспределению нагрузки, что требует устойчивой обработки сбоев на уровне приложений.
Архитектура журнала и порядок обработки сообщений
Журнал Kafka - это основной элемент архитектуры. Каждая партиция журнала - это упорядоченная последовательность записей, доступная для потребителей. Уникальная величина внутри партиции - offset - служит маркером позиции потребителя и обеспечивает точную репродукцию событий при повторном потреблении.
Ключевые аспекты архитектуры журнала:
- Append-only: записи добавляются в конец журнала без изменений существующих записей. Это обеспечивает детерминированную упорядоченность и устойчивость к повторным попыткам.
- Offset и глобальная идентификация: смещение внутри партиции уникально для каждой записи и фиксирует позицию в потоке. Потребители сохраняют свое место, чтобы не пропускать данные и не дублировать обработку.
- Тempo времени и индексация: журнала используется индексирование и временные метки, что позволяет быстрый доступ к записям по диапазонам времени или по ключам.
- Retention и удаление: правила хранения могут быть time-based (например, 7 дней) или size-based (например, 500 ГБ per-topic). Это поддерживает управляемость хранилищ и балансы задержек и ёмкости.
- Compaction и чистка: для некоторых топиков возможна политика compaction, которая удаляет избыточные записи по ключу, оставляя наиболее свежие значения. Это полезно для хранилищ состояния и CDC-подходов.
- Эволюция схем: изменение форматов и структур события требует осторожного управления совместимостью, чтобы потребители могли адаптироваться без прерывания работы.
Порядок в журнале тесно связан с архитектурой партиций. Внутри партиции порядок записей гарантирован и не может быть нарушен, даже если запись дублируется или повторная отправка происходит из-за сбоев. Внешний порядок между различными партициями не гарантируется и может зависеть от распределения нагрузки и задержек в сети. Поэтому при проектировании событийной модели следует заранее определить, какие операции требуют глобального порядка, а какие допускают независимую обработку.
Элементы времени и времени жизни данных накладывают ограничения на клиентские приложения. Встроенная поддержка временных окон, агрегаций и обработок времени требует понимания различий между event time и processing time. Для корректной аналитики и аудита полезно внедрять единообразную схему маркировки, стандартные форматы серий и совместимые схемы типов данных. В противном случае задержки или рассинхрон между источниками и потребителями могут привести к неверной интерпретации потоков и потере важных корреляций.
Протоколы взаимодействия и согласование
Коммуникации в Kafka основаны на двоичном протоколе, который определяет форматы запросов и ответов между клиентами (поставщиками и потребителями) и брокерами. Протокол охватывает операции записи (produce), чтения (fetch), управление смещениями (offset), запросы метаданных и координацию между брокерами. В контексте архитектуры он обеспечивает:
- Гарантии доставки: уровень аcks, режимы ретрансляции и возможности Idempotent Producers, которые исключают дубликаты в условиях повторных попыток.
- Изоляцию и консистентность: транзакционные механизмы (transactional producers) позволяют достигать приблизительно одному из сценариев Exactly-Once Semantics (EOS) на уровне топиков и групп потребителей.
- Репликацию и лидерство: для каждой партиции существует лидер и несколько follower-реплик. Репликация идёт по журналу потребителей и координируется через контроллер, который может выбрать лидера и поднимать консенсус для новой конфигурации.
- Внедрение KRaft и Zookeeper: ранее Kafka опирался на Zookeeper для координации. Современная дорожная карта предусматривает переход к Kafka Raft (KRaft) как встроенному механизмуподтверждения консенсуса, что упрощает архитектуру и снижает зависимость от внешних сервисов.
Протоколы также затрагивают настройку безопасности и аутентификацию: SASL, TLS и механизм авторизации ACL. В проектировании потоковых систем критично учитывать шифрование, контроль доступа и аудит. При выборе режимов безопасного соединения следует учитывать требования к соответствию, регулятивные также потребности в скорости передачи.
Кроме того, взаимодействие между консьюмерами и брокерами требует специальных паттернов: автокоммит смещений vs ручной контроль, режимы чтения и фильтрации, стратегии повторной обработки и ка idempotence на уровне приложения. Эффективная обработка EOS, где потребители и источники корректно согласуют изменения и не допускают дублирующих записей, требует разработки архитектуры, которая учитывает согласование контекстов операции и визуализацию состояния данных.
Примеры типичных сценариев интеграции включают использование Confluent Schema Registry и формат Avro для обеспечения совместимости между сервисами, а также применение Kafka Connect для интеграции внешних систем и источников изменений (CDC). В открытом контексте можно упоминать такие продукты, как Apache Kafka и Confluent Platform; в целях реализации и совместимости - 1-2 примера. Важно согласовать совместимость изменений в схеме и определить режимы обратной совместимости, чтобы потребители не требовали немедленного обновления, когда данные меняются.
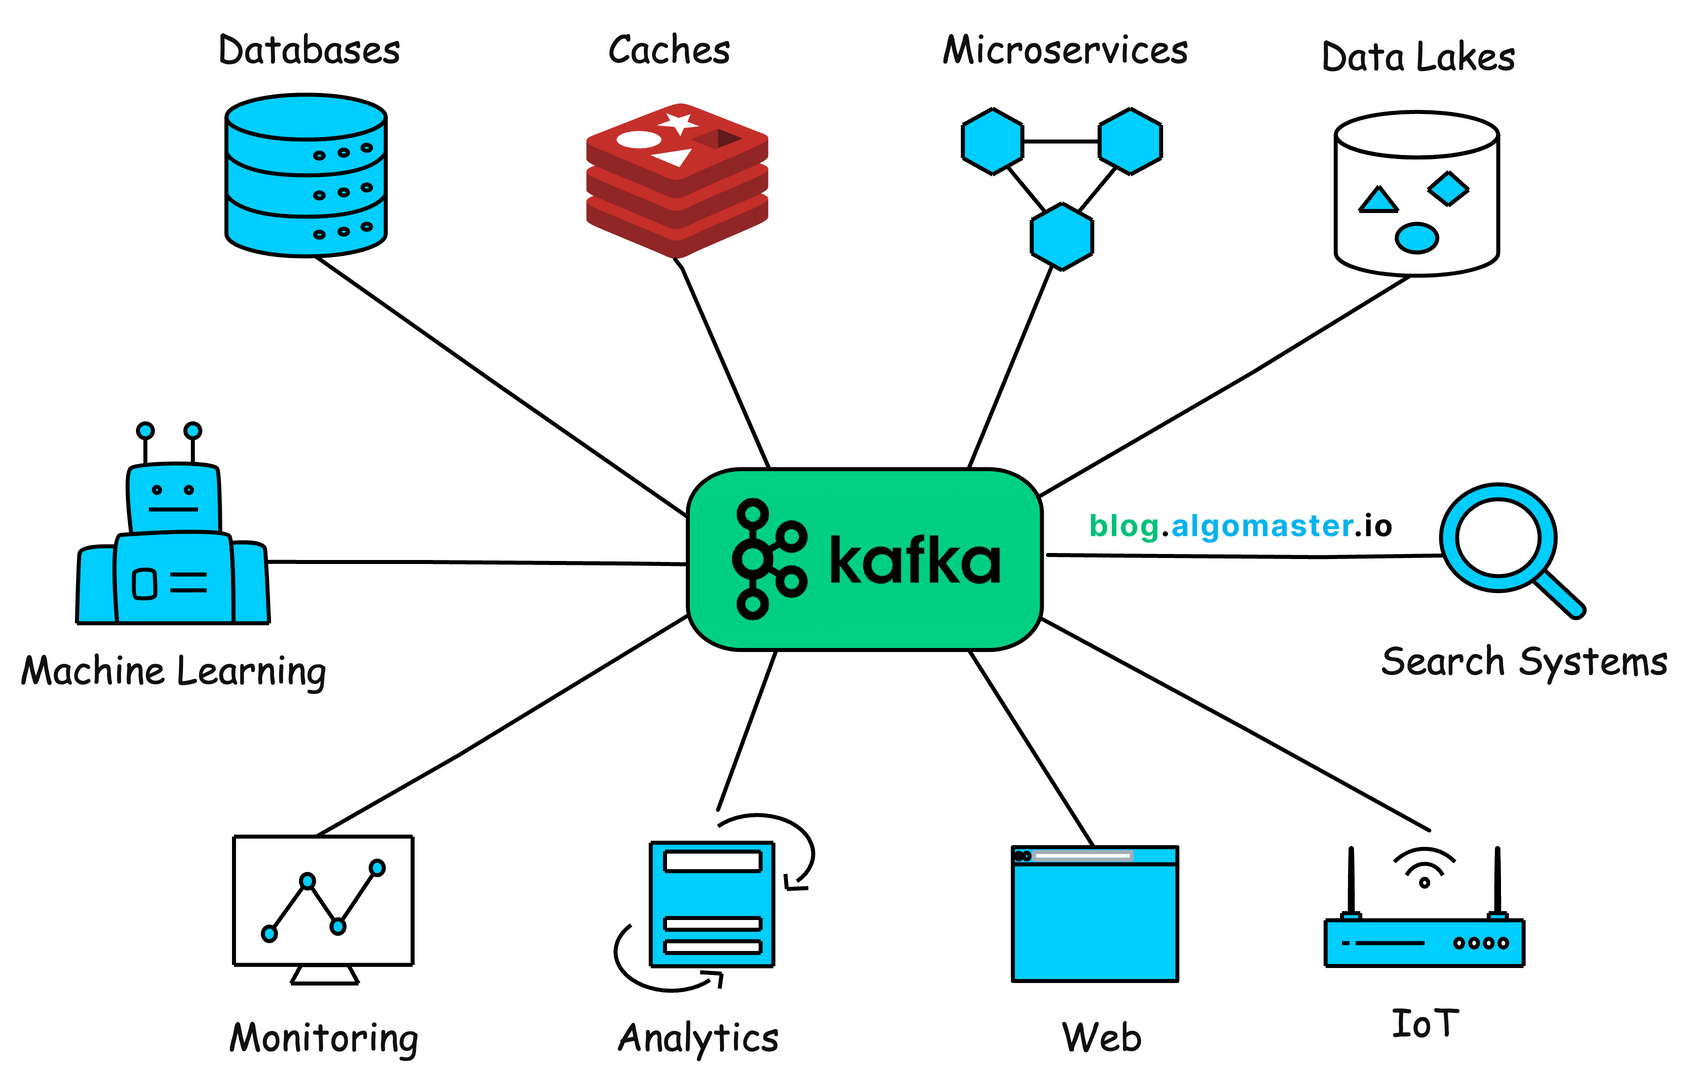
Практические схемы интеграции и дизайн потоковых систем
Системы, работающие на базе Kafka, требуют согласованных паттернов интеграции и проектирования потоков, чтобы обеспечить предсказуемую доставку и устойчивость. Ниже приведены ключевые концепты и принципы:
- Архитектура событий и микроархитектура сервисов: каждый сервис публикует события в топики и потребляет события от других сервисов, что позволяет строить loosely coupled и масштабируемые системы. Важна идентификация доменных событий и согласование форматов данных.
- Выбор ключа и маршрутизация: ключ записи определяет партицию, что влияет на параллелизм и последовательность. Корректная выборка ключей снижает вероятность переработок и конфликтов, особенно на уровне транзакционной обработки.
- Управление временем и окнами: для аналитики и агрегаций по событиям требуется поддержка окон и обработка времени (event time vs processing time). Использование правильной временной модели уменьшает рассинхрон между источниками и потребителями и позволяет корректно интерпретировать последовательности.
- Совместимость форматов: внедрение схем и продуманная эволюция форматов данных повышают устойчивость к изменениям в доменной модели. Архитектор должен заранее определить политики совместимости и стратегии миграции схем.
- Интеграционные паттерны: CDC, Change Data Capture, event sourcing и CQRS - распространенные подходы к поточным обработкам. Для интеграции источников изменений часто применяются коннекторы и конвейеры обработки, которые позволяют непрерывно синхронизировать данные между системами.
- Обеспечение EOS и Idempotence: для критичных операций целесообразно внедрять idempotent producers и транзакционные паттерны. Это минимизирует риск дубликатов при повторных попытках и позволяет корректно обрабатывать повторные сообщения в рамках одного гранулярного контекста.
- Наблюдаемость и мониторинг: ключевые метрики включают задержку поставки, задержку потребления, количество переработанных записей, время жизни журнала и займов ресурсов. Наблюдаемость обеспечивает раннее выявление аномалий, снижающих доступность и качество данных.
- Безопасность и комплаенс: конфигурации безопасного доступа, аудит и шифрование на уровне транспортного уровня - важные элементы архитектуры, особенно в условиях регуляторных требований к данным и приватности.
Факторы выбора в проектах связаны с архитектурной стратегией и бизнес-целями. При этом одной из ключевых практик является выработка четкой модели данных и схемного пакета, который позволяет сервисам эволюционно расширяться без прерывания работ. В реальных проектах применяются национальные и международные подходы к управлению схемами, совместимости и обработке событий. Примеры открытых инструментов, которые часто оказываются полезными в рамках продуктовой архитектуры, включают:
- Apache Kafka и Confluent Platform - базовые инструменты для организации потоков, обработки, консолидирования изменений и передачи данных между системами.
- Schema Registry - компонент для контроля версий схем и обеспечения совместимости между производителями и потребителями.
- Kafka Connect - платформа для интеграции внешних источников и приемников данных без необходимости писать собственные коннекторы с нуля.
С учётом необходимости поддержки гибкости и масштабируемости, рекомендуется реализовывать концепции модульной архитектуры: сервисы должны иметь четкие входы и выходы в виде топиков, а бизнес-логика - отделяться от инфраструктурной части, чтобы упрощать тестирование, мониторинг и обновление сайтов.
Key takeaways
- Событие - это фиксированное изменение состояния; поток - непрерывная последовательность событий; журнал - неизменяемый Append-Only лог с сохранением порядка внутри партиции.
- Параллелизм достигается через партиции: каждую партицию обрабатывает отдельный потребитель, порядок сохраняется внутри партиции, между партициями он не гарантирован.
- Журнал обеспечивает детерминированную повторяемость и управляемость хранения: смещение, ретENTION, компакция и политика сегментов.
- Взаимодействие клиентов опирается на протокол Kafka, репликацию и консенсус-подходы (в частности, переход к KRaft в будущем), а также на режимы обеспечения доставки, idempotence и EOS.
- Интеграционные паттерны требуют продуманной схемы данных и совместимости форматов, использования схем Registry, а также осознания различий между event time, ingestion time и processing time.
- Архитектура должна балансировать между требованиями к задержке, пропускной способности и обеспечениями согласованности для устойчивого роста потоковых систем.
- Безопасность, мониторинг и аудит являются неотъемлемой частью проектирования потоковых систем на базе Kafka.
- Эволюция схем и форматов данных должна идти через продуманную стратегию совместимости и миграции без прерывания бизнеса.
- Выбор паттернов интеграции и стратегий обработки данных требует учета реальных нагрузок, требований к точности и своевременности данных, а также устойчивости к сбоям.
- В рамках проекта стоит уделить внимание архитектурной дисциплине: распределение ответственности между сервисами, четкие границы топиков и согласованные подходы к обработке ошибок.
FAQ
Вопрос: Что считается событием в Kafka и как это связано с топиками?
Событие в Kafka - это единица изменений, которая передается в систему как запись журнала. Каждое событие публикуется в топик и распределяется по партициям. Смысл топика - агрегировать единую ленту событий для конкретной предметной области; партиции же позволяют распараллеливать обработку и сохранять упорядоченность внутри каждой части журнала.
Вопрос: Какой смысл у потока и чем он отличается от топика?
Поток - это логически связанный набор событий, который может состоять из одного или нескольких топиков-партиций. Топик представляет собой физическую единицу хранения и маршрутизации, тогда как поток - концепция бизнес-контекста, который охватывает набор взаимосвязанных событий.
Вопрос: Что такое журнал и зачем он нужен?
Журнал - это непрерывный, неизменяемый append-only лог записей, который обеспечивает воспроизводимость и аудитность обработки. Он дает возможность без потерь повторно читать данные, управлять задержками и реализовывать разные режимы доставки.
Вопрос: Как Kafka реализует параллелизм и какие ограничения?
Параллелизм достигается за счет партиционирования журналов: разные партиции обрабатываются параллельно, однако порядок сохраняется только внутри каждой партиции. Между партициями порядок не гарантирован, что требует аккуратного проектирования агрегаций и корреляций.
Вопрос: Какие механизмы обеспечивают порядок и консистентность?
Порядок внутри партиции поддерживается записью в возрастающий offset; консистентность достигается через лидеров и репликацию, ISR и протокол согласования. Для EOS необходимы транзакционные механизмы и idempotent-производители, а также аккуратная обработка смещений потребителями.
Вопрос: Что такое сегменты журнала и зачем они нужны?
Журнал разбит на сегменты для удобного управления хранением, быстрого доступа и эффективной очистки старых записей. Это позволяет применять политики retention и компакцию без влияния на производительность новых записей.
Вопрос: Какие технологии дополняют Kafka в архитектуре потоковых интеграций?
В продолжении Kafka часто применяются Schema Registry для контроля версий схем, Kafka Connect для интеграции источников и приемников, а также формат AVRO или Protobuf для совместимости данных. Эти инструменты улучшают совместимость между сервисами и упрощают эволюцию форматов.
Вопрос: Когда стоит рассмотреть переход к Kafka KRaft вместо Zookeeper?
Переключение на Kafka KRaft имеет смысл в долгосрочной перспективе, когда требуется упрощение архитектуры, отказ от внешнего координатора и упрощение операций. KRaft реализует консенсус на уровне самого брокера и уменьшает зависимость от Zookeeper, что упрощает обновления и управление кластером.
Вопрос: Какие паттерны интеграции наиболее эффективны в рамках IData-инфраструктуры?
Эффективные паттерны включают CDC-источники для реального времени изменений, event sourcing для отслеживания изменений в доменных моделях и CQRS для разделения команд и запросов. Важна внимательная настройка схем, режимов доставки и обеспечения идемпотентности потребителей.
Вопрос: Какие практики мониторинга и безопасного взаимодействия рекомендуются?
Рекомендуются детальные метрики задержек, throughput, ISR-статуса, ошибок повторных попыток и доступов. Безопасность достигается за счет TLS, SASL, ACL и аудита. Наблюдаемость должна охватывать как инфраструктуру брокеров, так и поведение приложений-потребителей и производителей.


