

Архитектура Kafka: брокеры, кластеры, режимы хранения (KRaft и Zookeeper)
Kafka занимает уникальное место в современном стеке обработки данных как платформа для потоковой передачи и интеграции событий. Его архитектура, построенная вокруг распределённых логов, обеспечивает горизонтальную масштабируемость, устойчивость к сбоям и последовательность обработки. В данной главе рассмотрены важнейшие концепции архитектуры Kafka, различия между режимами хранения Zookeeper и KRaft, а также принципы реализации и эксплуатации кластеров в условиях реального производства.
Краткое введение
Kafka строится вокруг идеи непрерывного журнала (log) для каждой партиции топика. Этот журнал - устойчивое упорядоченное море данных, которое сохраняется на диске и реплицируется между брокерами. Центральную роль в координации кластера играет механизм выбора лидера для каждой партиции, а также набор постоянно синхронизируемых копий, обеспечивающих отказоустойчивость. Переход от модели с Zookeeper к режиму KRaft (Kafka Raft) представляет собой эволюцию в сторону более упрощённой и управляемой архитектуры, где распределение метаданных и механизм консенсуса реализованы внутри самого брокера с использованием протокола Raft. В этом переходе важно понимать влияние на согласованность, задержки и операционные процессы перехода, включая миграцию существующих кластеров и совместимость клиентов.
- Архитектура Kafka как платформа для потоковой передачи: базовые принципы, слои абстракции и взаимодействие компонентов.
- Брокеры, топики и партиции: структура данных, распределение нагрузки и роль лидера.
- Режимы хранения: Zookeeper vs KRaft** - что меняется в архитектуре и управлении кластером.
- Надёжность и эксплуатация: репликация, ISR, контрольная плоскость и процессы обновления.
- Практические соображения интеграции и мониторинга: безопасность, совместимость клиентов, операционные практики.
Архитектура Kafka как движок потоковой передачи данных
Kafka реализует потоковую обработку через непрерывный журнал, который хранится на диске и структурирован в последовательности сегментов. Каждый сегмент представляет собой файл лога, внутри которого записи упорядочены по времени и сохраняются в неизменяемом виде. Права на запись в лог принадлежат конкретной партиции топика и назначаются лидер-брокером этой партиции. Фактическое чтение и запись происходят через сетевые протоколы, обеспечивающие согласованность и последовательно-упорядоченное телодвижение данных между продюсерами и консьюмерами.
Ключевые принципы здесь просты, но критичны для производительности и надёжности:
- линейная запись событий в порядке их поступления обеспечивает детерминированное восстановление и воспроизведение;
- параллельность достигается за счёт разделения на партиции топика, позволящей независимым меню продюсеров и консьюмеров работать одновременно;
- репликация между брокерами обеспечивает отказоустойчивость, но требует согласованности и задержек, связанных с консенсусом.
Понимание этих принципов важно при проектировании архитектуры потоковой системы и выборе параметров кластера: фактор репликации, число партиций на топик, размер сегментов, политики хранения и retention. Взаимосвязь между производительностью продюсеров и потребителей и временем задержки в конвейере во многом определяется именно структурой лога и тем, как организован доступ к нему.
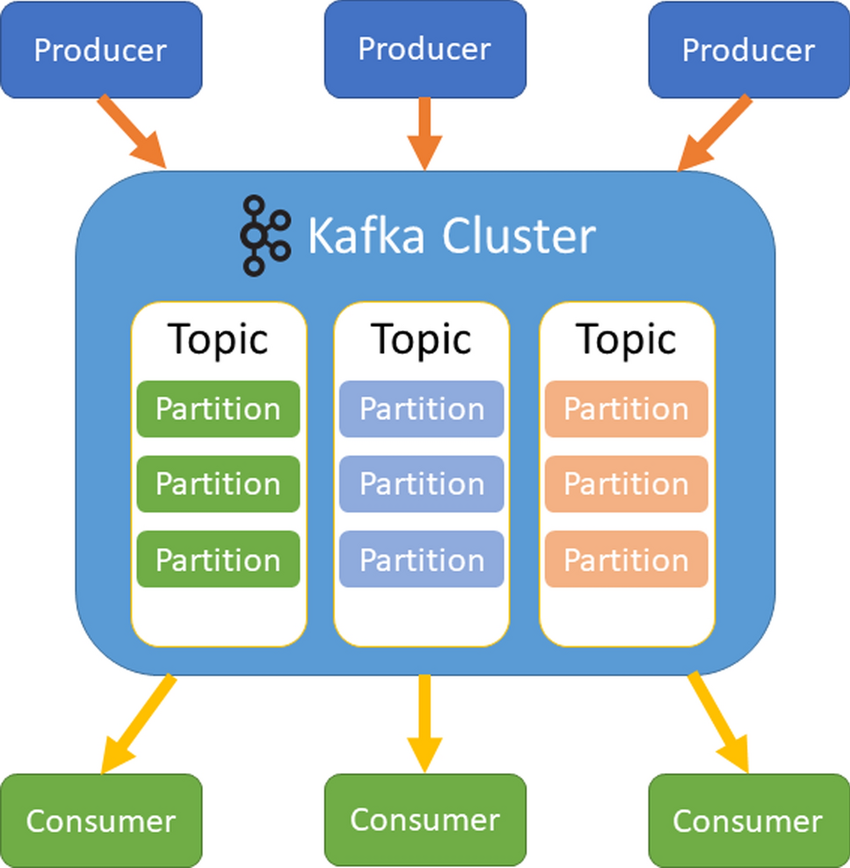
Брокеры, топики, партиции: структура данных и динамика
Карта данных в Kafka во многом определяется тремя фундаментальными сущностями: брокер, топик и партиция. Брокер - это узел кластера, который отвечает за хранение части логов, обработку клиентских запросов и координацию с другими брокерами. Каждый брокер может хранить данные по нескольким топикам и их партициям, причём каждая партиция имеет свой независимый лог на диске и уникального лидера среди кластерных брокеров.
Топик представляет собой логическую единицу организации данных. Он состоит из одной или более партиций, каждая из которых - независимый упорядоченный журнал. Разделение на партиции позволяет распараллеливать обработку и обеспечивает масштабируемость. Кроме того, параметры ретенции и доступности задаются на уровне топика, что позволяет балансировать требования по задержке и объёму данных.
Репликация добавляет ещё один слой сложности и надежности. Для каждой партиции задаётся фактор репликации - число копий лога, которое хранится на разных брокерах. Одну копию можно назвать лидером, остальные являются копиями-подписчиками (follower replicas). Лидер отвечает за запись новых событий и обслуживание запросов продюсеров, в то время как follower реплики служат копиями для чтения и последующего восстановления. В каждом моменте времени существует один лидер, который гарантирует последовательность и согласованность данных в партиции. Остальные реплики следуют за лидером, поддерживая своё состояние в синхронизации.
Важно помнить, что лидер не только управляет записью, но и координирует обмен данными между репликами. Время задержки между лидером и follower-репликами влияет на скорость синхронизации и устойчивость к сбоям. Если лидер выходит из строя, один из встраившихся follower становится новым лидером через процесс выбора лидера, который поддерживается протоколом консенсуса внутри кластера.
Режимы чтения и записи подчиняются определённой политике согласованности: продюсеры могут использовать атрибуты idempotence и транзакционные механизмы для обеспечения Exactly-Once Semantics (EOS) в пределах заданной топологии. Консьюмеры, в свою очередь, читают последовательности из лидера партиции, и их смещения (offsets) обновляются согласно групповой логике потребления. Эффект на задержку зависит от числа партиций, объёмов репликаций и конфигураций потребления (например, размер группы консьюмеров, режим авто-commit).
Из этого следует, что архитектура зависит от качественной настройки топиков: количество партиций влияет на параллелизм и задержку, фактор репликации - на надёжность, retention - на доступность архивов и скорость восстановления после сбоев. Практическая инженерия требует грамотной балансировки между этими параметрами в зависимости от требований к задержке, объёму данных и доступности.
Режимы хранения: Zookeeper и KRaft - эволюция управления кластером
Исторически Kafka использовал Zookeeper как сервис координации и метаданных кластера. Zookeeper отвечал за хранение информации о брокерах, лидерах партиций, настройках конфигурации и событиях изменения состава кластера. Контроллер кластера - один из брокеров - выбирался через взаимодействие с Zookeeper и управлял election-процессами лидеров, что создавало центральную точку ответственности за согласованность и устойчивость к сбоям.
Однако, с развитием требований к упрощению эксплуатации и уменьшению задержек в управлении, появился режим KRaft. В KRaft управление метаданными перемещено внутрь самого подхода к брокерам с использованием Raft-консенсуса. Такой подход устраняет внешний сервис управления и минимизирует количество точек отказа, связанных с сетью и согласованием. В реальности это означает, что:
- все метаданные, включая информацию о брокерах, топиках, партициях и лидерах, находятся в логах кластера и синхронизируются через протокол Raft между контроллер-подобными узлами (созданными внутри брокеров).
- упрощается архитектура развертывания, устраняется необходимость в поддержке дополнительного Zookeeper-сервиса, что снижает сложность эксплуатации.
- переход требует внимательного планирования миграций: совместимость старых клиентов, корректная миграция конфигураций, сохранение/перенос существующих метаданных и согласование поведения на протяжении перехода.
С точки зрения архитектуры появляются две важные грани: во-первых, радикально уменьшается внешняя зависимость кластера от стороннего сервиса координации; во-вторых, становится возможной более быстрая эволюция протоколов консенсуса и управление состоянием кластера в рамках Raft-логов. В реальных производственных системах выбор режима хранения - часть стратегического решения: Zookeeper может быть предпочтителен для существующих кластеров, требующих обратной совместимости, в то время как KRaft чаще выбирается для новых инсталляций и миграций, где важна упрощённость эксплуатации и оптимизация задержек на уровне управляющих потоков.
Переход между режимами хранения - это, прежде всего, вопрос планирования обновлений, сохранения совместимости клиентов и мониторинга изменений в характеристиках задержек и пропускной способности. В рамках учебной практики полезно рассмотреть три уровня деятельности:
- проектирование кластера с учётом целей по задержке, нагрузке и доступности;
- выбор режимов хранения в зависимости от наличия поддержки Zookeeper в инфраструктуре и уровня риска;
- миграции и обновления кластеров с минимальными простоями и корректной защитой данных.
Кластер и управление состоянием: контроллер, выбор лидера, репликационные протоколы
В любой распределённой системе, ориентированной на журнальный подход, критично эффективное управление состоянием кластера. В Kafka это достигается за счёт нескольких взаимосвязанных механизмов: контроллера кластера, механизма выбора лидера по партициям, и протоколов синхронизации между лидерами и follower-репликами.
Контроллер кластера - виртуальная фигура управления, которая отвечает за распределение ролей лидеров по всем партициям, обработку изменений состава кластера и координацию действий фолловеров. Его роль особенно критична во время изменений: добавления новых брокеров, удаления устаревших, а также во время сбоев, когда требуется переназначение лидеров. Эффективная реализация контроллера требует высокой согласованности и быстрого обнаружения изменений, чтобы минимизировать время, в течение которого партиции не имеют лидера (не подвергаются обслуживанию).
Лидеры по партициям осуществляют запись и обслуживание запросов продюсеров на конкретной копии лога. Следующие за лидером реплики (ISR - In-Sync Replicas) - это копии данной партиции, которые находятся в синхронизации и готовы подхватить статус лидера в случае сбоя. Следование ISR - критически важный механизм для обеспечения устойчивости и консистентности. Любая запись, чтобы считаться подтверждённой и безопасной, должна попасть в журнал лидера и реплицироваться до завершения соответствующих операций в ISR.
Протоколы репликации и консенсуса обеспечивают баланс между задержкой и надёжностью. В рамках Zookeeper-подхода лидеры и данные реплицируются через механизмы, контролируемые Zookeeper, а в KRaft их координацию выполняют Raft-группы внутри кластера. В обоих случаях критически важно уметь:
- корректно определить и поддерживать состояние ISR, чтобы предотвращать выбор лидерства на неподготовленных копиях;
- минимизировать задержку репликаций за счёт эффективного алгоритма обмена логами;
- адаптировать политику подтверждений продюсеров (acks) под требования по задержке и целостности данных.
Эти механизмы требуют тщательного мониторинга и операционных практик: журналирование операций управления, аудит изменений конфигураций, регулярный аудит соответствия лидеров и ISR, а также эффективная обработка ошибок и кризисных сценариев. В практическом плане следует учитывать, что чрезмерно длинные ISR влияют на пропускную способность и задержку, тогда как слишком агрессивная политика лидерства может привести к частым срывам доступности. Выбор параметров должен соответствовать целям конкретного сегмента приложений: критически важные системы требуют более строгого контроля над репликацией и подтверждениями.
Надёжность, консистентность и задержки: репликация, ISR, дисковые логи, сегменты
Надёжность данных и их консистентность в Kafka достигаются за счёт нескольких взаимодополняющих факторов:
- дисковая устойчивость логов: каждый сегмент лога записывается на диск с использованием последовательной записи и контроля целостности (CRC). По мере заполнения сегмента он закрывается и открывается новый сегмент, что позволяет управлять размером логов и эффективностью чтения.
- репликация и ISR: как уже упоминалось, лидеры синхронизируют копии на follower-репликах. Состояние ISR играет роль как индикатор готовности к переносу лидерства и выполнению безопасной записи. В случае снижения синхронности копий они остаются в ISR до исправления, после чего могут быть исключены из группы реплик.
- порядок и детерминированность: каждая партиция имеет упорядочённый журнал, и записи следует читать в порядке их появления на лидере, что обеспечивает предсказуемость при воспроизведении. В рамках EOS важна возможность согласованной записи в топиках и управляемой атомарности транзакций продюсерами, что требует дополнительной координации между сегментами и партициями.
- управление задержками: задержки складываются из времени ожидания подтверждения записи на лидерe и времени репликации до follower-реплик. В реальной системе задержка зависит от пропускной способности сети, нагрузки на диски и числа партиций. Правильная настройка величины segment.max.ms, retention policies, а также параметров fetch и produce helps держать баланс между задержкой и долговечностью.
Практике эксплуатации требует постановки чётких целевых метрик: latency, throughput, message durability (например, подтверждения на уровне acks=all), частота обновления лидеров, средняя задержка репликации. Важной частью является мониторинг по метрикам вывода журналов, состоянию ISR и задержкам на уровне продюсеров и консьюмеров. В условиях реального применения крайне важно рассчитать запас прочности к сбоям: сколько реплик критично оставлять в ISR, какова вероятность потери данных в случае одновременных сбоев, и какие уровни ретенции соответствуют регуляторным требованиям и бизнес-целям.
Экосистема и интеграции: протоколы, безопасность, мониторинг, операционная готовность
Архитектура Kafka не ограничивается только самой платформой; значительный эффект на успех проекта оказывают экосистема инструментов и практик эксплуатации. В этом контексте важны три слоя: взаимодействие клиентов через Kafka-проtokoly, безопасность и контроль доступа, а также наблюдаемость и мониторинг.
Клиентские протоколы и API: Kafka предоставляет набор протоколов и клиентских библиотек для разных языков. Важно понимать, что последовательность и семантика доставок зависят от выбранной конфигурации продюсера и консьюмера, включая опции idempotence, транзакций и режимов обработки ошибок. Эффективная архитектура потоков требует корректной настройки потребительских групп, смещений и повторных попыток для обеспечения требуемого уровня надёжности при минимальной задержке.
Безопасность и доступ: в больших организациях требуется надёжная аутентификация и авторизация, шифрование трафика и управление правами доступа. В Kafka поддерживаются различные механизмы аутентификации (SASL), шифрования TLS и контроля доступа на уровне топиков и групп (ACL). Эти инструменты работают не только для защиты данных, но и для разделения ролей между командами разработки, аналитики и операций.
Мониторинг, операционные практики и контроль версий: эффективное управление кластером требует наблюдения за здоровьем брокеров, метаданными, задержками и потреблением. Инструменты мониторинга обычно покрывают метрики по задержкам записи и чтения, размеру логов, загрузке CPU и IO, а также по состоянию кластера и ISR. Непрерывное улучшение эксплуатационных процессов включает автоматическую масштабируемость, обновления без простоя и тестовые сценарии обновлений, которые проверяют совместимость с клиентами и сохранность данных.
Интеграция и экосистемные компоненты: в составе архитектуры часто применяют коннекторы Kafka Connect, потоки обработки (Kafka Streams), интеграционные слои для передачи данных между различными системами (БД, хранилища данных, системы очередей). В рамках архитектуры важно продумать разделение ответственности между продюсерами и консьюмерами, а также организовать конвенции именования топиков, управление схемами и версионированием контрактов данных.
Соблюдение баланса: для эффективной эксплуатации целесообразно рассмотреть минимально достаточную аудиторию средств безопасности и мониторинга, не перегружая инфраструктуру и не добавляя избыточной сложности. В рамках учебной практики полезно сопоставлять готовые готовые решения, например, открытые коннекторы и инструментальные комплекты от известных сообществ и компаний, обеспечивающие единую стратегию мониторинга и безопасности.
Key takeaways
- Архитектура Kafka основана на распределённых логах, лидерстве по партициям и репликации, что обеспечивает масштабируемость и устойчивость к сбоям.
- Топики делятся на партиции, что даёт параллелизм и управляемую задержку; фактор репликации задаёт баланс между надёжностью и потреблением ресурсов.
- Режим хранения Zookeeper и новый KRaft различаются по архитектуре управления метаданными: KRaft упрощает архитектуру за счёт встроенного консенсуса на основе Raft.
- Контроллер кластера, лидерство и ISR критично влияют на доступность и согласованность данных; их корректная настройка требует ясной операционной стратегии.
- Надежность достигается через детерминированность журналов, устойчивую репликацию и продуманную политику подтверждений; задержки зависят от конфигураций и инфраструктурных условий.
- Экосистема Kafka (Connect, Streams) и аспекты безопасности и мониторинга - важная часть эксплуатационной готовности.
- Планирование миграций между режимами хранения, а также интеграция с существующей инфраструктурой, требуют аккуратного подхода к совместимости и тестированию.
FAQ
- Что такое брокер Kafka и зачем нужен кластер?
Брокер Kafka - это узел, который хранит часть логов и обслуживает запросы продюсеров и консьюмеров. Кластер строится из нескольких брокеров, которые совместно хранят данные и обеспечивают доступность в случае сбоев. Кластер позволяет масштабировать пропускную способность за счёт параллельной записи и чтения по партициям, а также обеспечивает устойчивость через репликацию и выбор лидера.
- Как работают топики и партиции?
Топик - логическая единица данных, разделённая на партиции. Каждая партиция - упорядоченный журнал, ведущийся лидером. Реплики синхронизируются между брокерами, чтобы обеспечить доступность и защиту от потери данных. Потребление и запись становятся параллельными по партициям, что позволяет достигнуть высокой пропускной способности без нарушения порядка внутри каждой партиции.
- Чем отличается Zookeeper от KRaft и зачем переходить на KRaft?
Zookeeper осуществлял координацию кластера и хранение метаданных через внешний сервис. KRaft - встроенный консенсус-слой на основе Raft, который размещает управление метаданными внутри самого кластера, уменьшая внешние зависимости и улучшая задержку. Переход на KRaft упрощает архитектуру, ускоряет эволюцию протоколов и повышает управляемость, хотя требует надлежащего планирования миграции и совместимости клиентов.
- Как работает лидерство и ISR?
Лидер по партиции отвечает за запись и доставку данных. Реплики в ISR синхронизированы с лидером и считаются готовыми к переносу лидерства при сбоях. Промежуточные решения по смене лидера происходят через контроллер кластера; правильная настройка ISR снижает риск потери данных и обеспечивает надёжное восстановление после сбоев.
- Какие стратегии используются для обеспечения надёжности и консистентности данных?
Основные стратегии - репликация с корректной настройкой фактора репликации, удержание данных на дисках с учётом ретенции, а также поддержку транзакций и EOS для точной доставки данных. Важно мониторить состояние ISR, задержки, и параметры конфигурации, чтобы своевременно выявлять отклонения и принимать меры.
- Какие проблемы возникают при масштабировании и как их решать?
Проблемы включают увеличение задержек из-за ростa числа партиций, балансировку нагрузки между брокерами, и сложность обновления кластера. Решения включают стратегическую настройку числа партиций на топик, правильную балансировку по брокерам, использование плавных процессов обновления, и продуманную миграцию между режимами хранения (при необходимости).
- Как выбрать параметры кластера для конкретной предметной области?
Выбор параметров зависит от требований к задержкам, объёму данных, и необходимой надёжности. Рекомендовано начинать с разумного FactorReplication, числа партиций на топик и политики retention, затем подогнать их под фактическую нагрузку через тестирование и мониторинг.
- Какие практики эксплуатации важны для устойчивого кластера?
Регулярное обновление системы, мониторинг здоровья брокеров иISR, тестирование восстановления после сбоев, и планирование миграций между режимами хранения. Важна документация процессов управления кластером, четкие политики резервного копирования и детальные сценарии реагирования на инциденты.
- Как мигрировать существующий Zookeeper-кластер на режим KRaft?
Миграция включает: подготовку инфраструктуры, создание параллельного контура управления без простоя, миграцию метаданных и конфигураций, тестирование совместимости клиентов и функций, а затем безопасное переключение на новую архитектуру. Важно иметь четкие пайплайны тестирования, дорожную карту и обратную совместимость с существующими продюсерами и консьюмерами в течение перехода.
- Какие шаги предпринять для обеспечения совместимости клиентов во время миграции?
Необходимо проверить версию клиентской библиотеки, сигнатуры API и поддерживаемые конфигурации. В процессе миграции целесообразно сохранить каналы связи с предыдущей версией, обеспечить тестовую среду для проверки EOS и транзакций, а также планировать возврат к исходной конфигурации в случае непредвиденных проблем.


