

Apache Kafka для Data Engineer
Apache Kafka — основа для event-driven архитектуры и потоковой интеграции данных, когда системам нужно обмениваться событиями почти в реальном времени. Такой подход помогает уйти от жёстких точечных интеграций, снизить зависимость между сервисами и построить более гибкую data-платформу для аналитики, микросервисов, CDC-сценариев и streaming-пайплайнов.
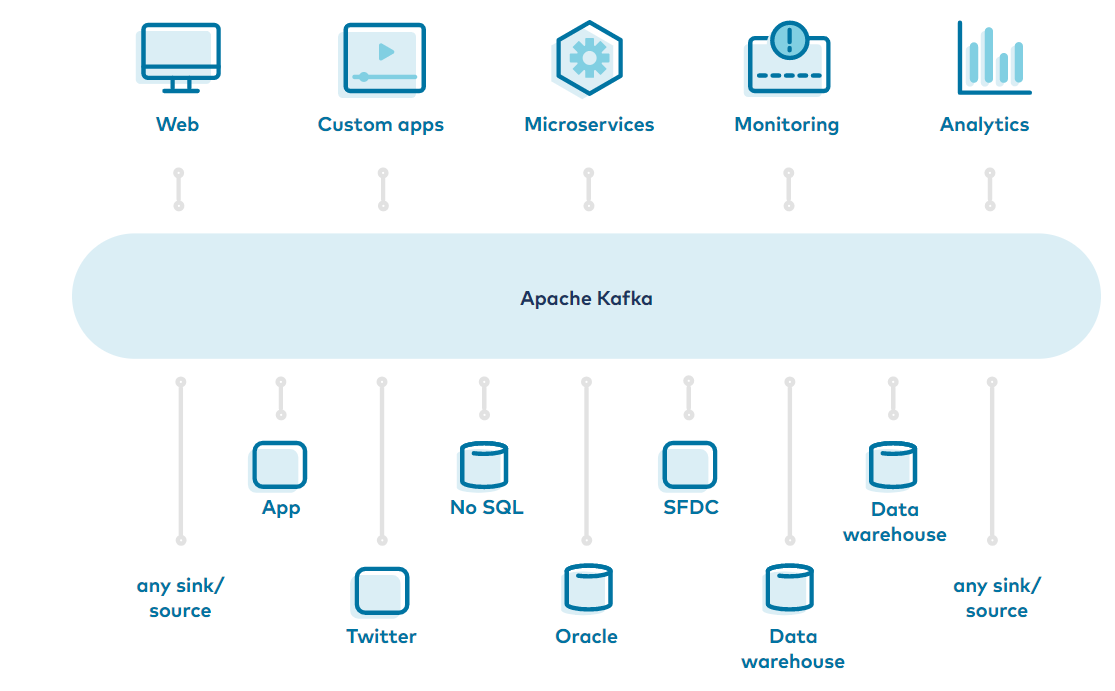
Описание охватывает практическую работу дата-инженера с Kafka: проектирование топиков и партиций, выбор форматов событий, Schema Registry, Avro, JSON, Protobuf, Kafka Connect, Kafka Streams, ksqlDB и интеграцию с Flink, Spark, Trino, Snowflake, BigQuery и lakehouse-архитектурой. Важная часть — качество данных, lineage, governance, транзакционность, идемпотентность и управление схемами при развитии потоковой платформы.
Такой материал полезен командам, которые хотят внедрять Kafka не как “очередь сообщений”, а как полноценную платформу событийных данных: с мониторингом, SLO, безопасностью, disaster recovery, инфраструктурой как кодом, понятной операционной моделью и дорожной картой развития.
- Стратегическое основание: роль потоковых данных и Kafka в цифровой трансформации
- Основы Apache Kafka: архитектура, принципы и ключевые компоненты
- Терминология и базовые концепции: топики, разделы, смещения, ретенш и репликация
- Архитектура событийно-ориентированных систем: pub/sub, event-driven, event sourcing, CQRS
- Форматы данных и схемы: Avro, JSON, Protobuf, Schema Registry
- Потоковая интеграция данных: источники, коннектора, CDC и sink-ориентации
- Архитектурные паттерны потоковой обработки: Lambda, Kappa и stream-first подходы
- Проектирование потоковых пайплайнов: идемпотентность, транзакционность продюсеров, оконные вычисления
- Инструменты экосистемы: Kafka Connect, Kafka Streams, ksqlDB
- Интеграция с аналитическими системами: Spark, Flink, Trino, Snowflake, BigQuery
- Управление данными и их качеством: governance, lineage, data quality metrics
- Безопасность и соответствие: аутентификация, авторизация, TLS, секреты, аудит
- Архитектура хранения и конфигураций: топики, retention, compaction, cleanup policies
- Производительность и масштабирование: конфигурации, sizing, partitioning, replication, ISR
- Мониторинг и наблюдаемость: метрики, трассировка, логи, надёжность и SLO в Apache Kafka
- Тестирование потоковых пайплайнов: юнит и интеграционные тесты, тестовые среды
- Миграции и эволюция схем: совместимость backward/forward, миграции схем событий
- Эксплуатационная модель и устойчивость: runbooks, инцидент-менеджмент, DR, backup
- Облачные решения и развёртывания: управляемые сервисы, гибридные инфраструктуры
- Контейнеризация и инфраструктура как код: Kubernetes, Helm, GitOps
- Архитектура для data lakehouse и аналитики: пайплайны к lakehouse
- Архитектурные решения для микро-сервисов: событие как контракт, fan-out/fan-in
- Практические кейсы по отраслям: финансы, телеком, розница, производство
- Риски, ограничения и типовые ошибки: anti-patterns и уроки
- План внедрения и зрелость платформы: дорожная карта и модель зрелости
- Организация команд и компетенции: роли, навыки, обучение
- Итоговый проект: capstone design и дорожная карта внедрения


