

Итоговый проект: capstone design и дорожная карта внедрения
Эта глава посвящена практическому capstone-проекту по Apache Kafka: от формулирования бизнес-целей и выбора источников данных до проектирования архитектуры, реализации потоковой интеграции и планирования внедрения в продакшн. В центре внимания - создание устойчивой event-driven платформы, способной обеспечивать качественную обработку потоков, интеграцию с аналитическими системами и управляемость на протяжении всего жизненного цикла решения.
capstone-проект представляет собой связку методологии и техники: он требует четкого описания требований, детального описания архитектуры, продуманной дорожной карты внедрения, набора паттернов обработки и надежной системы мониторинга и управления качеством данных. В контексте курса он становится финальным стендом, на котором демонстрируются навыки проектирования, реализации и эксплуатации в рамках реального клиентского контекста.
- Архитектура, паттерны и интеграции
- Дорожная карта внедрения и управление изменениями
- Контроль качества данных, безопасность и операционная устойчивость
- Взаимодействие Kafka с аналитическими системами и инструментами BI/аналитики
Краткое содержание главы
- Определение контекста проекта, бизнес-целей и критериев успеха capstone
- Архитектура событийной платформы на базе Kafka: принципы, компоненты и безопасность
- Этапы дорожной карты внедрения: от пилота к продакшн-эксплуатации
- Реализация паттернов потоковой интеграции и взаимодействие с аналитикой
- Управление качеством данных, мониторинг, тестирование и риск-менеджмент
Контекст проекта и цели
capstone-проект начинается с бизнес-кейса: какие события насыщают cenário, какие данные являются источниками, какие аналитические задачи требуют неотложной обработки в реальном времени. В рамках проекта требуется перейти от абстрактной концепции к конкретным артефактам: функциональные требования, контракт данных, архитектурные чертежи, набор пайплайнов, тестовые планы и дорожная карта внедрения.
Основная цель состоит в создании устойчивой, масштабируемой и управляемой потоковой инфраструктуры на базе Apache Kafka, способной:
- ingest-ировать данные из разнотипных источников (базы данных, сервисы, файл-логи, IoT-устройства);
- обеспечивать последовательную и повторяемую обработку с поддержкой Exactly-Once Semantics;
- унифицировать данные через схему и контракт данных, чтобы минимизировать риск несовместимости downstream;
- передавать данные в хранилища и аналитические системы для моделирования, отчетности и мониторинга бизнес-показателей;
- обеспечить мониторинг, алертинг, тестирование и план перехода в продакшн с минимальным риск-дрифт-эффектом.
Важной частью является определение KPIs для capstone: доля онлайн-данных, задержка обработки, пропускная способность, точность данных, время восстановления после сбоя и соответствие требованиям безопасности и комплаенса. Эти метрики должны быть встроены в архитектуру на раннем этапе и поддерживать управление изменениями через конфигурацию и автоматизацию.
Архитектура и принципы event-driven с Kafka
Архитектура, основанная на событиях, предполагает, что все значимые изменения состояния системы публикуются как сообщения в темах Kafka и обрабатываются любым потребителем, используя принципы строгой контрактности и единообразия данных.
Основные принципы:
- разделение источников событий и их формирования: источники публикуют события в тематические каналы, потребители обрабатывают их независимо и повторно;
- устойчивость к изменению требований: поддержка схемы, совместимость версий и эволюции контрактов;
- масштабируемость и локализация задержек: распределение по партициям, параллельная обработка;
- обеспечение консистентности на уровне единицы работы: транзакционные продюсеры и источники, возможность Exactly-Once Semantics;
- прозрачность и управляемость: наблюдаемость, трассировка и соблюдение политики доступа.
Компоненты архитектуры:
- Kafka cluster: брокеры, темы, партиции, фактор повторения, политика хранения и чистки;
- продюсеры и консюмеры: формирование и потребление событий; репликация и устойчивость к сбоям;
- коннекторы и источники данных: Kafka Connect (Source/Sink), Debezium для CDC, кастомные коннекторы;
- обработка потока: Kafka Streams, ksqlDB, Flink** - выбор зависит от сложности трансформаций и требований к латентности;
- схема и контракт данных: Scheme Registry (Avro/JSON), версионирование и эволюция схем;
- данные в аналитике и хранилищах: lakehouse/хранилища (S3, HDFS), data warehouse (Snowflake, BigQuery, Redshift) и BI-инструменты;
- безопасность и управление доступом: TLS, SASL/OAuth, ACLs, шифрование и аудит.
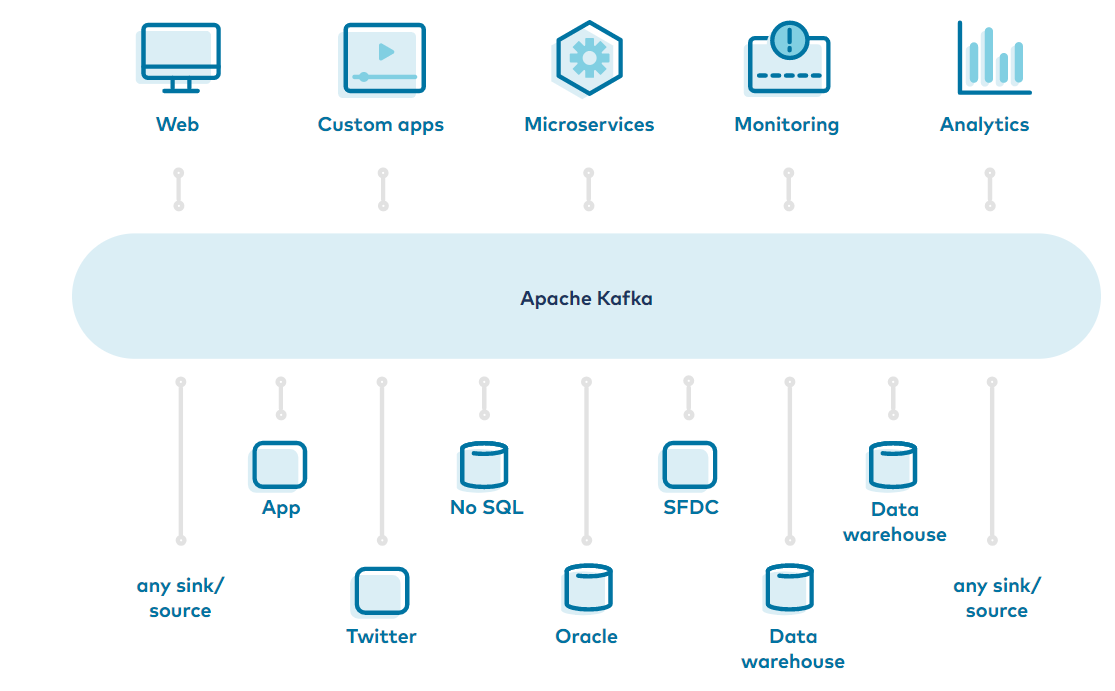
Архитектура должна содержать слои: источники данных, транспортный слой (Kafka), обработку и трансформацию, хранение и аналитическую потребность. Важный аспект - обеспечение idempotence на производителях и корректная работа транзакций, чтобы повторные попытки не приводили к дубликатам или неконсистентности downstream.
Важно помнить: не существует единственно верной схемы для всех кейсов. Выбор паттернов зависит от латентности, объема данных, требований к консистентности и нормативной среды. В capstone проекте целесообразно показать несколько сценариев интеграции (например, CDC из OLTP-систем в Data Lake и последующая агрегация в Data Warehouse) и обосновать выбор конкретных механизмов.
## Пример упрощенной конфигурации для транзакционного продюсера (Java/Kafka Clients)
## Примечание: пример иллюстрирует включение idempotence и транзакций.
## Properties props = new Properties();
props.put("bootstrap.servers", "kafka1:9092,kafka2:9092");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("enable.idempotence", "true");
props.put("acks", "all");
props.put("transactional.id", "txn-capstone-project-001");
try (Producer producer = new KafkaProducer(props)) {
    producer.initTransactions();
    producer.beginTransaction();
    // send records
    producer.send(new ProducerRecord("topic-raw-events", key, value));
    producer.commitTransaction();
} catch (ProducerFencedException | OutOfOrderSequenceException | SecurityException e) {
    producer.abortTransaction();
}
В рамках capstone-проекта целесообразно дополнительно рассмотреть схему развёртывания: использование Schema Registry для обеспечения эволюции контракта, а также внедрение политики совместимости (BACKWARD, FORWARD, FULL) в зависимости от целей.
Дорожная карта внедрения capstone проекта
Этапы дорожной карты должны быть четко структурированы и привязаны к бизнес-целям, а также к критериям приемки проекта.
-
Подготовительный этап
- формулировка целей, выбор кейсов и бизнес-правил;
- аудит источников данных, текущей инфраструктуры и уровней качества;
- определение стандартов безопасности и комплаенса, создание рабочей группы и ролей;
- набор инфраструктурных элементов: кластер Kafka, коннекторы, схему данных, тестовую среду.
-
Пилотный этап
- реализация 1-2 бизнес-сценариев с критическими требованиями к задержке и точности;
- внедрение базового пайплайна: источник → Kafka → несложная обработка → хранилище;
- внедрение мониторинга и начальные проверки качества данных.
-
Этап расширения
- масштабирование пайплайнов на несколько доменов и источников;
- внедрение CDC и более сложной обработки (агрегации, оконные вычисления);
- расширение кластеров Kafka и коннекторов; оптимизация параметров;
- формирование единого контракта данных и интеграции со схемами данных.
-
Этап эксплуатации и перехода в prod
- выпуск регулярных обновлений, управление версиями схем, бэкапы и DR-планы;
- расширение мониторинга, корректировка SLA и политики доступа;
- обеспечение устойчивости к сбоям и тестирование восстановления;
- внедрение CI/CD и автоматизации развёртывания инфраструктуры.
-
Этап совершенствования
- оптимизация лайнинга данных, снижение задержек, улучшение качества данных;
- внедрение дополнительных инструментов анализа и кросс-аналитики;
- формирование широкого портфеля кейсов и регламентов, направленных на устойчивое развитие.
Риски и зависимости должны быть явно прописаны: задержки в поставке источников, несовместимости схем, ограниченная пропускная способность сети, затраты на лицензии для аналитических систем, требования к безопасной обработке PII и т. п. В разделе дорожной карты следует связать бизнес-цели с техническими артефактами: какие артефакты создаются на каждом этапе, какие метрики используются для оценки прогресса и как будет происходить управление изменениями.
Реализация паттернов потоковой интеграции и взаимодействия с аналитикой
В capstone-проекте применяются структурированные паттерны интеграции, которые позволяют обеспечить управляемую и расширяемую потоковую обработку с чистым границами между источниками, обработкой и хранилищами.
-
Источник данных и коннекторы
- Kafka Connect выступает как мост между источниками и темами Kafka. Source-коннекторы аккумулируют данные в Kafka, Sink-коннекторы вытаскивают данные в целевые хранилища и аналитические платформы.
- Debezium может выступать как CDC-двигатель для OLTP-систем, позволяя минимизировать латентность и поддерживать актуальность данных.
-
Обработка потока и трансформации
- Kafka Streams обеспечивает локальные и масштабируемые преобразования внутри потока, включая оконные вычисления, агрегации и соединения (join) между потоками.
- ksqlDB предоставляет SQL-подход к обработке потоков и быстрое создание трансформаций без ручного кодирования; подход удобен для прототипирования и мониторинга.
- Выбор инструмента зависит от требований к латентности, сложности трансформаций и команды разработки.
-
Контракты данных и эволюция схем
- Schema Registry обеспечивает централизованное управление схемами и эволюцию контрактов. В capstone проекте важно закрепить правила совместимости (Backward/Forward/Full) и процедуры миграции.
- Поддержание строгой типизации данных (Avro/JSON) снижает риск ошибок при интеграции между источниками и потребителями и повышает прозрачность данных для аналитики.
-
Интеграция с аналитикой и хранилищами
- На этапе проектирования следует выбрать целевые хранилища: data lake (например, S3) и/или data warehouse (Snowflake, BigQuery, Redshift). Набор подключений к аналитическим инструментам и BI-уровня должен быть согласован с требованиями к скорости обновления и уровню консистентности.
- Важно определить «единую точку истины» для критических событий и механизм передачи обновлений в аналитические системы. Это позволяет снизить дублирование и развязанность потоков.
-
Управление качеством данных и тестирование
- Нормализация и стандартизация схем, контрактов и правил обработки помогают поддерживать качество в масштабе. Регулярные проверки качества, валидаторы схем, тестовые данные и сценарии регрессии - неотъемлемая часть продакшн-эксплуатации.
- Набор тестов должен покрывать как unit-тесты трансформаций, так и интеграционные тесты между источниками, Kafka и хранилищами.
-
Безопасность и соответствие
- TLS и SASL (например, SCRAM) для транспорта и аутентификации, ACLs и роль-based access control дают необходимую защиту. Потребители и источники должны иметь ограниченный набор прав доступа.
- Обеспечение соответствия требованиям по защите данных (PII, регулирование) требует применения методов маскирования, анонимизации и мониторинга доступа.
Примеры практических трэков реализации:
- Реализация 1-2 сценариев CDC через Debezium и загрузка в Data Lake с последующей агрегацией в Data Warehouse.
- Построение паттерна трансформации с использованием Kafka Streams или ksqlDB для оконной агрегации по часам и дневным итогам.
- Внедрение схем и совместимости, обеспечение эволюции контракта без прерываний.
Чтобы проиллюстрировать настройки, ниже приведено краткое пояснение к конфигурации транзакционных продюсеров и как это влияет на консистентность данных.
Управление качеством данных, безопасность и операционная устойчивость
В capstone проекте необходимо продемонстрировать подходы к контролю качества данных, мониторингу и обеспечению устойчивости всей системы.
-
Контроль качества
- валидаторы схем, тесты входных данных и согласование контракта между производителем и потребителем;
- регулярные проверки качества данных на каналах передачи и в хранилищах.
-
Эволюция схем
- стратегия совместимости, план миграций и процедура отката;
- мониторинг изменений контрактов и влияние на downstream-потребителей.
-
Безопасность и комплаенс
- шифрование в транзите и на покое, аудит доступа, управление секретами;
- соответствие регуляторным требованиям и политикам приватности.
-
Мониторинг и наблюдаемость
- метрики задержек, lag потребителей, пропускная способность, количество сообщений и ошибки;
- трассировка событий и корреляция по трассам через OpenTelemetry, Prometheus и Grafana;
- алгоритмы автомасштабирования на основе метрик потребления и пропускной способности.
-
Эксплуатация и восстановление
- сценарии отказоустойчивости: резервирование кластера, DR-планы, регулярные бэкапы данных;
- тестирование восстановления и проверки устойчивости к сбоям.
Key takeaways
- Capstone-проект по Kafka требует четко сформулированной бизнес-цели, выборов источников, архитектуры и проверок качества данных.
- Архитектура event-driven строится вокруг Topics, партиций, репликаций и схем, где Kafka выступает транспортным слоем, а обработка - Streams/SQL-инструментами.
- Внедрение должно опираться на дорожную карту с фазами: подготовка, пилот, масштабирование, эксплуатация и совершенствование.
- Концепции CDC, Debezium, Schema Registry и коннекторов позволяют строить устойчивые и эволюционные потоки данных.
- Контроль качества, безопасность и мониторинг - краеугольные камни продакшн-платформы: без них сложно достигнуть требований по SLA.
- Интеграция с аналитикой требует заранее протестированных коннекторов к хранилищам и инструментам BI, а также единых контрактов данных.
- Правильная реализация транзакционных и idempotent-взаимодействий обеспечивает Exactly-Once Semantics и уменьшает риски дубликатов.
FAQ
- Каковы цели capstone проекта и как он соотносится с бизнес-целями?
Capstone-проект призван показать способность спроектировать и внедрить end-to-end потоковую архитектуру на базе Kafka, которая напрямую поддерживает бизнес-цели, такие как своевременная доставка данных, точность аналитики и снижение задержек. Он связывает требования бизнеса с техническими артефактами: контракты данных, архитектурные чертежи, пайплайны и план перехода в продакшн. Оценка происходит по критериям реализации, устойчивости, тестирования и способности к масштабированию.
- Какие критерии успешности capstone-проекта?
Успех измеряется по согласованным SLA/OLAs, уровню латентности и задержкам потока, точности обработки, уровню доступности кластера Kafka, покрытию тестами, качеству данных и способности системы к масштабированию. Дополнительно оценивается документирование архитектуры, план внедрения и готовность к эксплуатации.
- Как выбрать реальный бизнес-кейс для capstone?
Важно выбрать кейс с ясной бизнес-ценностью и конкретными отказами от текущей архитектуры. Предпочтение отдается сценариям, где требуется интеграция нескольких систем, высокая частота обновления данных и возможность демонстрации кросс-доменных пайплайнов (OLTP → Kafka → Data Lake/ warehouse → аналитика). Наличие реальных ограничений по latency и требованиям к качеству данных поможет обосновать выбор паттернов и решений.
- Какие архитектурные решения чаще всего применяются в capstone?
Часто применяются архитектуры с CDC через Debezium, источники данных через Kafka Connect, обработка через Kafka Streams или ksqlDB, хранение результатов в Data Lake и/или Data Warehouse, а также использование Schema Registry для эволюции контрактов. Важно показать баланс между задержкой обработки и сложностью трансформаций, а також обеспечить надежность через транзакции и idempotent-производители.
- Как обеспечить Exactly-Once Semantics в рамках пайплайна?
Основные подходы: использование транзакционных продюсеров в Kafka, единая точка производителей, поддержка idempotence на уровне продюсеров, а также применение транзакций в обработке (например, совместные транзакции между Kafka Streams и внешними системами через средства коннекторов). Важно обеспечить согласованность между источниками и потребителями, а также корректную обработку повторных попыток.
- Как планировать миграцию в продакшн и минимизировать риск?
Необходимо развернуть пилотную среду для проверки работоспособности, внедрить поэтапную миграцию, обеспечить откат и резервирование, а также определить KPI и метрики для контроля перехода. Важна документация ограничений и зависимостей, а также согласование с бизнес-интересами и юридическими требованиями.
- Какие метрики мониторинга стоит включить в архитектуру?
Latency (end-to-end), processing lag, throughput (msgs/sec), error rate, retention/compaction status, producer/consumer TPS, availability, и качество данных (попытки ошибок, несовместимости схем). Эти метрики следует объединять в панели наблюдения (Prometheus/Grafana) и сопровождать алертами по порогам.
- Как тестировать потоковые пайплайны?
Включаются unit-тесты трансформаций и интеграционные тесты пайплайна (источник → Kafka → обработчик → хранилище). Необходимо выделить тестовые среды, синтетические данные и контроль версий схем. Для тестирования можно использовать эмуляцию кластеров Kafka и локальные окружения, а также негативные сценарии и тесты на устойчивость к сбоям.
- Какие риски чаще всего встречаются и как их минимизировать?
Основные риски - задержки на источниках, несоответствие схем, рост нагрузки, проблемы с секретами и безопасностью, сложности с миграцией в продакшн и управлением изменениями. Минимизация достигается через ранний дизайн контрактов, enforced schemas, продуманное планирование изменений, тестирование и мониторинг, а также резервирование инфраструктуры.
- Как организовать взаимодействие с аналитической командой и BI?
Важно обеспечить наличие единых схем и контрактов, согласование форматов данных и времени обновления, выбрать совместимую стратегию загрузки в хранилища и обеспечить надежную интеграцию коннекторов с аналитическими системами. Регулярные ревью архитектуры и согласование требований аналитики помогают избежать расхождений и ускоряют внедрение.
Глава представляет собой сочетание архитектурной концепции и практических шагов: от постановки бизнес-задач до конкретной реализации и эксплуатации. В capstone проекте ключевой целью является демонстрация способности проектировать, внедрять и поддерживать устойчивую потоковую инфраструктуру на базе Apache Kafka, обеспечивая надежную интеграцию с аналитическими системами и позволяя бизнесу оперативно принимать решения на основе данных в реальном времени.


