

Активация Data Mesh
Пример масштабирования совместной работы с данными: управление данными сразу в 60 командах специалистов по работе с данными - воплощение в жизнь data mesh.
Основанная в 1982 году компания Autodesk, выпустившая известнейшую систему автоматизированного проектирования, на сегодняшний момент является одним из лидеров в области "облачных" технологий, предлагающих десятки продуктов и услуг, необходимых самым разным пользователям - от СМИ до крупных промышленных компаний. Ее годовая прибыль составляет 5 млрд. долларов, а численность сотрудников - около 14 000 человек.
В этой статье Вы найдете основные моменты нашей беседы с Марком Кидвеллом (Mark Kidwell), главным архитектором данных компании Autodesk. Основная ее часть посвящена тому, как команда разработчиков справилась с задачей масштабирования совместной работы и управления данными в 60 группах специалистов по данным и создала подходящую для них data mesh.
"Многие знают компанию Autodesk как производителя AutoCAD (системы автоматизированного проектирования и черчения). Но компания уже достаточно давно вышла за эти рамки. Безусловно, это - наши корни, но теперь мы предоставляем различное ПО и даем возможность использовать различные передовые технологии ", - говорит Марк Кидвелл, главный архитектор данных, Autodesk.
В основе этой масштабной трансформации - от создателя AutoCAD до технологического лидера Nasdaq 100 - лежит принятие решений, которое основывается на применении современных технологий в области данных, таких как Atlan и Snowflake.
Аналитическая платформа данных Autodesk
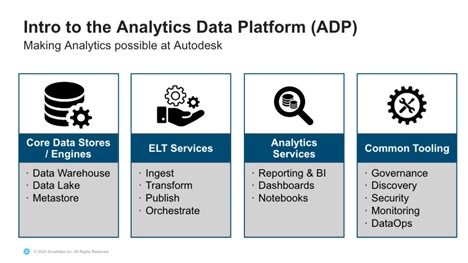
Несмотря на то, что основная миссия группы аналитических платформ заключается в обеспечении аналитической деятельности, ее обязанности гораздо шире. К ним, в частности, относится поддержка ряда основных хранилищ данных, озер данных и метахранилищ. Для координации всех используемых сервисов специалисты используют набор общих инструментов, позволяющих управлять данными, контролировать их безопасность и выполнять различные процессы DataOps.
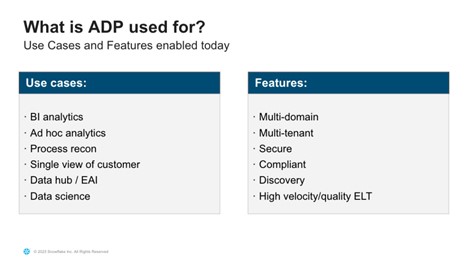
«Мы используем как BI аналитику, так и множество других специализированных решений", - говорит Марк. "Мы также используем нашу платформу для согласования процессов и для интеграции большого количества данных. Мы даем возможность командам «продвигать» данные в последующие системы. И, наконец, любимые всеми темы - искусственный интеллект и математическое моделирование - также являются частью нашей платформы".
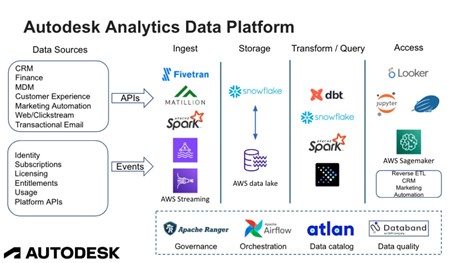
Аналитическая платформа Autodesk основана на типичных корпоративных системах, таких как CRM, HR, финансовые системы и т.д. Уникальными для Autodesk являются данные, связанные с их продуктами и услугами, такие как подписки и лицензии. Поскольку компания ориентирована на облачные вычисления, большинство этих систем и источников данных работают на основе API, что требует использования таких инструментов, как Fivetran, Matillion, AWS Streaming и Apache Spark.
"Мы используем комбинацию озера и хранилища данных. Наше хранилище данных - Snowflake, озеро данных - AWS, и, конечно же, все технологии для выполнения преобразований, запросов и аналитики располагаются «сверху» них", - говорит Марк. "Мы также внедрили многие другие современные инструменты и технологии, входящие в современный стек данных".
К ним оносятся Looker, PowerBI, Notebooks и AWS Sagemaker, а также инструменты Reverse ETL.
Data Mesh – от концепта к воплощению в жизнь
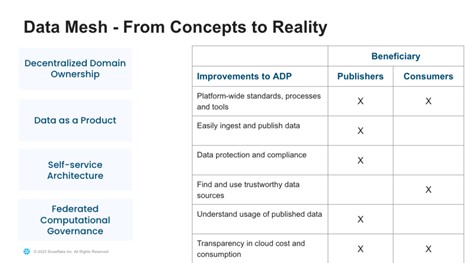
В ходе своей предыдущей работы команда аналитической платформы добилась прогресса в реализации 4 ключевых принципов Data Mesh, но для дальнейшего воплощения этих концепций в жизнь команда приступила к анализу «пробелов», чтобы определить, где можно улучшить ситуацию. Команда Марка начала составлять карту потенциальных улучшений для двух ключевых аудиторий: Производителей и Потребителей.
Доменно-ориентированное владение данными
Первый принцип гарантирует, что технология и команды, отвечающие за создание и потребление данных, смогут расширяться по мере роста количества источников, сценариев использования и потребления данных.
"У нас была долгая история поддержки доменов данных и различных команд, работающих на платформе, владеющих этими доменами. Они действовали относительно независимо и, возможно, даже слишком независимо", - говорит Марк. "Настоящей проблемой для нас стало нахождение данных, которые владельцы этих доменов внесли в систему. И если Вы, как потребитель, обращались с аналитическим вопросом, то они часто отвечали, что понятия не имеют о существовании того или иного актива, а также о том, как его можно найти".
Данные как Продукт
Второй принцип обеспечивает возможность находить и понимать данные безопасным, соответствующим определенным требованиям способом в различных доменах.
"Последовательное определение продукта данных означало определение того, что должны делать команды с точки зрения определения требований к продукту, или того, что они должны делать с точки зрения выполнения контрактов на данные и SLA", - пояснил Марк. "Мы должны были перейти от команд, которые просто получали данные, к командам, которые продуманно публиковали данные на платформе и думали о том, ЧТО эти данные значат для их потребителей".
Инфраструктура самообслуживания
Третий принцип гарантирует, что сложность создания и эксплуатации продуктов данных будет абстрагирована от доменных команд, упрощая тем самым создание и потребление данных.
"Существует множество способов определения самообслуживания. Можно сказать, что мы приблизились к этому принципу, когда у нас появился Spark, и люди смогли писать коды самостоятельно ", - пояснил Марк. "Но даже если бы Вы использовали все эти инструменты напрямую, нет никакой гарантии, что Вы получите одинаковые результаты. Разные команды могут использовать их, и в результате получать совершенно разные продукты данных. Поэтому мы хотели убедиться, что мы не только используем самообслуживание на уровне инструментов, но и предоставляем фреймворки или другие компоненты для многократного использования".
Федеративное управление процессами обработки данных
Четвертый и последний принцип обеспечивает взаимодействие и поведение data mesh как экосистемы, поддерживая высокие стандарты качества и безопасности данных, а также позволяет пользователям извлекать пользу из агрегированных продуктов данных.
"Мы не могли продвигаться вперед по многим направлениям, которые были важны для нас, пока у нас не было более надежной системы управления. Это привело к появлению ряда рабочих потоков и более четкому определению различных ролей, использующих платформу".
Определение рабочих потоков для поддержки Производителей и Потребителей
Команда Autodesk начала с формального определения ролей производителей, потребителей и команды платформы, а затем определила направления их работы. Наибольший приоритет был отдан тем направлениям, которые будут полезны производителям, включая стандарты для всей платформы, а также процессы и инструменты, необходимые для удобного ввода и публикации безопасных данных.
Работа с потребителями была направлена на обеспечение доверия, гарантирующего, что конфиденциальные данные могут быть переданы на платформу, и что у них есть инструменты, необходимые для поиска и применения данных. Наконец, рабочие потоки платформы данных обеспечили команде Марка возможность соблюдения стандартов качества, а также понимание потребления продуктов данных и связанных с этим затрат.
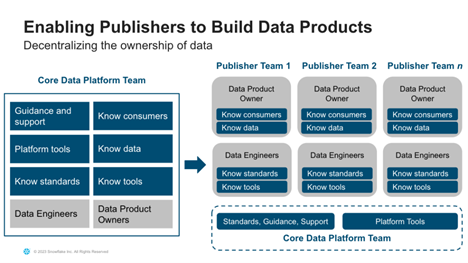
Команда аналитической платформы отвечала за проектирование данных и определение требований к продуктам, а также знала инструменты и потребителей для создаваемых продуктов данных. Но для того чтобы обеспечить масштабное использование данных, каждой команде, занимающейся публикацией, необходимо было освоить эти навыки.
"Мы не масштабируем эту систему путем увеличения основной команды. Мы должны были дать возможность другим командам делать все эти вещи", - пояснил Марк. "Это означает, что вместо того, чтобы [только] основная команда разработчиков платформы знала и использовала инструменты для непосредственного предоставления продуктов, мы должны были дать возможность командам производителей иметь своих собственных владельцев продуктов данных и своих собственных инженеров по данным".
В каждой производственной команде Autodesk необходимо определить владельца продукта и дата- инженеров. Владельцы продуктов должны были обеспечить понимание требований потребителей, а дата-инженеры должны были обладать необходимым опытом использования инструментов платформы и обеспечивать высокие технические стандарты. Повторяя этот процесс в каждой производственной команду команда аналитической платформы обеспечила инструментарий, стандарты и возможности, необходимые для успешной работы каждой производственной группы.
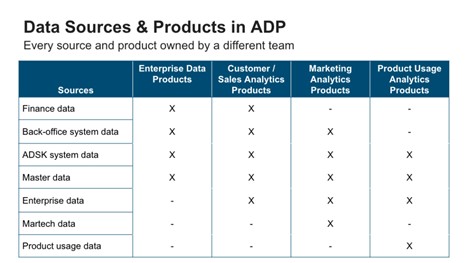
Всего два года спустя компания Autodesk успешно подключила десятки источников данных и создала множество продуктов данных, причем все они были предоставлены либо отдельными командами, либо комбинациями команд, создающих источники данных из нескольких областей, таких как данные о предприятии и использовании продуктов.
“С момента начала реализации инициативы самообслуживания с 2021 года мы получили в общей сложности 45 сценариев использования. Мы не смогли бы этого сделать, если бы у нас была только одна основная команда по обработке данных и только одна основная команда по производству данных”.
Марк Кидвелл, главный архитектор данных, Autodesk


