

Как теневые команды по работе с данными создают огромную задолженность по данным
Темная сторона быстрого вывода продукта данных на рынок
Гонка за трансформацию в компанию, управляемую данными
Лидеров и руководителей, стремящихся обеспечить демократизацию данных и увеличить их влияние на деятельность организации, всегда волновало следующее:
- Специалисты по работе с данными, которых они нанимают. Они должны обладать достаточным опытом для работы с текущим стеком данных, но при этом быть готовыми к появлению новых технологий;
- Стек данных. Он должен обеспечивать правильную работу всех звеньев жизненного цикла данных - от их приема и хранения до обслуживания и потребления;
- Поддержка со стороны топ-менеджмента. Руководители высшего звена должны обеспечивать достаточное финансирование, чтобы взять под контроль два вышеперечисленных аспекта и способствовать проведению качественных преобразований в области данных.
При соблюдении этих трех пунктов команды по работе с данными вполне могут получить все необходимые им данные, качественно обработать их и сделать доступными для безопасного и эффективного использования в организации.
Какие изменения произошли в сфере данных?
- Появление Больших данных способно превратить небольшой и структурированный набор данных в неконтролируемый ком данных. Этот сдвиг создал множество проблем в организации озер данных. Модели данных и разработка схем для хранилищ данных стали намного сложнее. Можно даже утверждать, что хранилище данных утратило свое первостепенное назначение;
- Увеличение количества источников данных. Раньше данные в основном поступали из операционных систем в операционный склад данных (ODS) благодаря процессам ETL, затем, проходя процесс CDC (Change Data Capture), они попадали в хранилище данных. Сегодня традиционный ETL практически не применяется (за исключением организаций, находящихся на ранних стадиях работы с данными). Помимо операционных систем данные поступают из API сторонних производителей. События на стороне сервера и клиента также собираются с помощью таких инструментов, как Snowplow;
- Увеличение числа потенциальных сценариев использования, которые расширились благодаря появлению новых типов данных, таких как изображение и звук, новых моделей НЛП, CV и машинного обучения, которые можно установить на ноутбук с помощью простой pip, а также за счет появления облачных провайдеров, позволяющих командам по работе с данными обрабатывать данные и обучать модели с использованием мощных CPU и GPU;
- Диверсификация потребителей данных - результат многолетних инвестиций в демократизацию данных в организациях и огромного ажиотажа вокруг искусственного интеллекта. Команды по работе с данными теперь поддерживают маркетинг, продажи, финансы, отдел кадров и многие другие подразделения.
Что осталось неизменным?
- Необходимость в сотрудничестве специалистов по работе с данными. Требующая преобразований трансформация мира данных усиливает необходимость в совместной работе инженеров-программистов, инженеров по обработке данных и специалистов по анализу данных. Никогда еще эти группы специалистов по работе с данными не были так разделены между собой, как сейчас. Инженеры-программисты (SWE) по-прежнему не участвуют в аналитическом цикле и при этом производят большую часть данных, поступающих в озеро. Инженеры по обработке данных стали посредниками в этом процессе, «потребляя» данные от SWE, у которых нет стимула предоставлять корректные данные. Ученые по данным, близкие к бизнесу, вынуждены искать пути преодоления проблем взаимодействия и самостоятельно разрабатывать решения, используя (или не используя) качественные данные;
- Важность понимания бизнес-контекста. Для создания эффективных продуктов на основе данных все задействованные команды должны иметь четкое представление об исходном домене, генерирующем данные, а ткже обладать знаниями в области бизнеса. Сегодня специалисты по данным должны глубже понимать сам бизнес, если они действительно хотят, чтобы их продукты на основе данных успешно внедрялись в организации;
- Время получения инсайтов. С появлением agile-методологии организации считают, что доступ к данным должен предоставляться максимально быстро. Гораздо быстрее, чем раньше. Тем не менее, большинство команд, работающих с данными, по-прежнему сталкиваются с проблемами доступа к данным, необходимым для построения ML-моделей, отчетов и дашбордов.
Организации, накапливающие все эти сложности, создают «монстра», которого я называю теневой командой по работе с данными.
Различные команды по работе с данными
Существует три способа организации практики работы с данными, которые зависят от размера и степени зрелости экосистемы данных в компании. Последний вариант - децентрализованные команды по работе с данными - является первым шагом к внедрению data mesh.
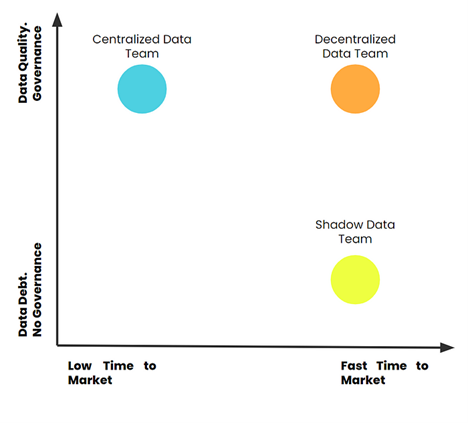
Централизованные команды по работе с данными наиболее распространены в современных организациях. Свободы действий меньше, поскольку data governance осуществляется достаточно жестко. Все данные централизованы. Команды «гиперспециализированы» в области технологий. Все изменения проходят специальный процесс проверки. Тем не менее, бизнес-потребители остаются неудовлетворенными...
Теневые команды по работе с данными — подобная схема также очень распространена в наши дни. Это когда ученые по данным занимаются инжинирингом данных «поверх» работы самих дата-инженеров. Или когда организации в первую очередь нанимают ученых по данным, а не дата-инженеров. В таком случае надлежащая инфраструктура данных попросту не может быть построена.
Децентрализованные команды по данным — подобная схема обусловлена переходом к data mesh, когда группы специалистов по работе с данными получают возможность работать независимо, не отрицая при этом наличие центрального органа, обеспечивающего data governance.
В этой статье я расскажу только о теневых командах по работе с данными. В последующих статьях будут приведены различия между всеми тремя схемами.
Теневые команды по работе с данными. Что это такое?
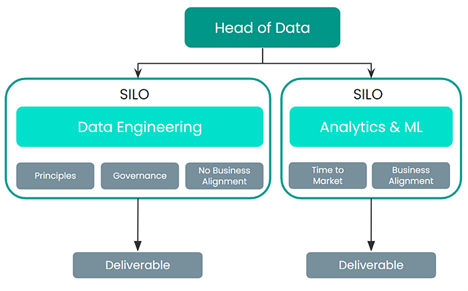
Модель теневых команд по работе с данными описывается созданием новых команд (состоящих из специалистов по работе с данными), реализующих инициативы по работе с данными для достижения лучшего времени выхода продуктов данных на рынок.
Новые технологические платформы для обработки данных, такие как dbt, используются аналитическими командами, чтобы "заменить работу дата-инженеров ".
Заинтересованные стороны довольны таким решением, поскольку инициативы запускаются в производство в минимальные сроки, что создает ложное представление о том, что работать с данными "легко".
Создание хорошей практики работы с данными в данном случае невозможно. Здесь нет никаких правил. Главное в данном случае - как можно быстрее получить желаемый результат.
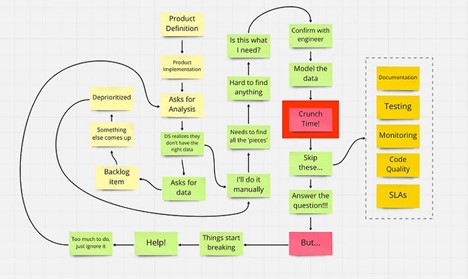
Как мы к этому пришли?
- Появляется бизнес-запрос на новую функцию или продукт данных;
- Специалисты по данным начинают изучать этот запрос и выясняют, что либо нужных им данных нет, либо они не доступны;
- Специалисты по данным запрашивают новый конвейер данных для дата-инженеров;
- Дата-инженеры, имея огромный пул запросов, тратят от нескольких недель до нескольких месяцев на обработку этого запроса;
- На специалистов по обработке данных оказывают давление, требуя предоставить новую функцию/продукт как можно быстрее;
- Специалисты по исследованию данных решают не ждать и обращаются напрямую к исходным системам и базам данных сторонних производителей, создавая конвейер SQL или dbt, в котором нет производственных стандартов, лучших практик CI/CD и четкой ответственности;
- Специалисты по исследованию данных привыкают к такому положению дел, и в итоге в организации образуется огромный долг по данным.
Каковы последствия?
Ценой быстрого выхода на рынок в данном случае является долг по данным. Он проявляется через некоторое время и имеет следующие последствия:
- Непоследовательные и ненадежные данные;
- Высокие затраты на обслуживание;
- Сложность устранения проблем с данными;
- Сложность обеспечения ответственности сотрудников за генерируемые ими данные;
- Ненадежные модели машинного обучения;
- Дополнительные расходы, связанные с необслуживаемыми конвейерами, таблицами и дублирующимися данными;
- Усложненная навигация по озеру и хранилищу данных.
В этом случае команда дата-инженеров теряет свой авторитет, поскольку руководство видит результаты, полученные без их участия. Трудно предугадать негативные последствия в долгосрочной перспективе, когда они еще не видны…
А через несколько лет, когда начнут проявляться побочные эффекты, сделать шаг назад будет очень сложно.
Даже если руководитель отдела данных захочет провести значительные изменения, бизнес к этому моменту уже привыкнет быстро получать продукты данных и расставаться с этим преимуществом точно не захочет.


