

Практические кейсы: ETL и аналитика больших данных в бизнесе
Эта глава нацелена на системное понимание того, как Apache Spark применяется в реальных бизнес-задачах для ETL-процессов и аналитики больших данных. Рассматриваются архитектура кластера, паттерны конвейеров, выбор форматов хранения, обработка потоков и инструменты обеспечения качества данных. Переход от теории к реализации сопровождается конкретными примерами пайплайнов, сценариями внедрения и практическими рекомендациями по мониторингу и эксплуатации.
В рамках главы приводится баланс между архитектурными аспектами и практическими решениями, подкрепляющий выбор подходов для разных бизнес-кейсов: от подготовки lakehouse до оперативной аналитики и поддержки решений на основе ML.
Краткое содержание главы
- Архитектура Spark и паттерны для ETL-пайплайнов: планирование, память, shuffle, источники и хранилища.
- Конвейеры ETL на DataFrame/Spark SQL: очистка, нормализация, обогащение и загрузка в lakehouse.
- Аналитика больших данных и бизнес-метрики: агрегации, оконные функции, cohort-аналитика и KPI.
- Эксплуатация и качества данных: мониторинг, тестирование, управление версиями, интеграции и операционные практики.
Архитектура Spark: от драйвера к исполнителям
Архитектура Spark строится вокруг взаимодействия драйвера и исполнительных процессов в кластере, что обеспечивает масштабируемую обработку больших данных. Драйвер курирует планирование задач, строит физические планы исполнения и координирует обмен данными между исполнительными узлами. Исполнители (executors) выполняют задачи на узлах кластера, а менеджеры кластера (Cluster Manager) предоставляют ресурсы и управляют жизненным циклом приложений: YARN, Kubernetes или Standalone-кластер. Влагодшаются данные через DataFrame и Dataset-высокоуровневые абстракции поверх RDD-с использованием оптимизатора Catalyst и механизма выполнения Tungsten, что позволяет эффективную компиляцию планов и низкоуровневую оптимизацию памяти.
-
Основные компоненты и их взаимодействие. SparkContext и SparkSession являются точкой входа в API; Catalyst осуществляет оптимизацию запросов, а Tungsten отвечает за эффективную работу памяти и вычислений на JVM. Обмен данными между задачами реализуется через Shuffle Manager, что влияет на производительность операций соединения и агрегаций. Подключение к источникам данных и запись в хранилища делегируются формату и провайдерам интерфейсов Spark: Parquet, ORC, JSON, JDBC и др.
-
Модели выполнения: RDD, DataFrame и Dataset. RDD сохраняют гибкость, но менее эффективны по памяти и оптимизации. DataFrame и Dataset дают возможность применения Catalyst и автоматическую оптимизацию, в то время как Dataset обеспечивает типобезопасность. Понимание различий позволяет проектировать пайплайны, в которых критично важна производительность и надежность.
-
Управление памятью и производительность. Эффективная работа памяти требует балансирования между памятью для выполнения (execution memory) и памятью для хранения промежуточных данных (storage memory). В современных реализациях используется концепцияUnified Memory Manager, а также возможность off-heap памяти для крупных задач. Важной частью являются параметры планирования и shuffle-привязок, минимизация переработки данных и уменьшение объема shuffle-данных.
from pyspark.sql import SparkSession spark = SparkSession.builder \ .appName("Spark Architecture Demo") \ .config("spark.sql.shuffle.partitions", "200") \ .getOrCreate() -
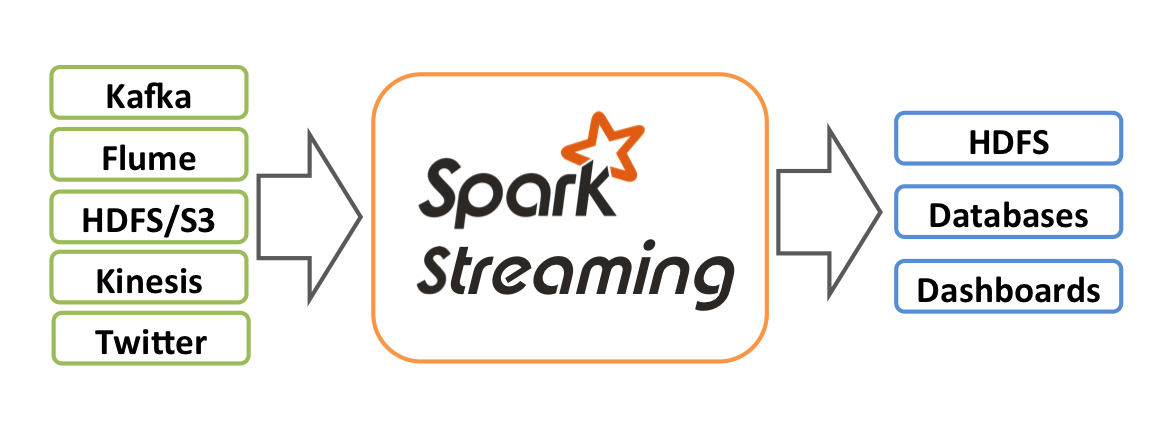
Взаимодействие со внешними системами и форматы данных. Spark поддерживает разнообразные источники: HDFS, S3, Kafka, JDBC. Основные форматы хранения для аналитических задач - Parquet и ORC благодаря колонной организации и эффективной компрессии. В контексте больших данных часто применяется lakehouse-архитектура с ACID-поддержкой и схемой Evolution для упрощения управления изменяющейся схемой.
-
Примеры интеграций. В реальных пайплайнах Spark применяется как движок ETL и аналитики, объединяя данные из потоков и батч-источников, снабжая их проверками качества и записью в хранилища, включая Delta Lake. Для некоторых сценариев применяется Spark на Kubernetes или в рамках существующего Hadoop/YARN-кластера.
Использование Spark в бизнесе требует грамотной настройки ресурсов, конвейера данных и форматов хранения. Эффективная архитектура обеспечивает предсказуемое время отклика для батчевых и потоковых задач, а также упрощает мониторинг и сопровождение пайплайнов.
Конвейеры ETL в Spark: конструирование устойчивых пайплайнов
Эффективный ETL-пайплайн в Spark строится на четком разделении стадий: ingest, cleanse, transform, enrich и load, с учетом требований к качеству данных и управляемости изменений. Особое значение имеют выбор источников, форматов хранения и стратегия обработки ошибок. В современных пайплайнах к задачам добавляются механизмы обеспечения идемпотентности и мониторинга, а также поддержка schema evolution и управление версиями.
-
Ингестия и источники. Источники данных включают файловые системы (HDFS, S3), базы данных (JDBC), очереди и потоки сообщений (Kafka). Для потоковой обработки характерна структура readStream: непрерывные микропакеты данных, которые последовательно обрабатываются и сохраняются. Важно обеспечить корректность временных меток и согласование форматов входных данных.
-
Очистка и нормализация. Типовые операции: фильтрация некорректных записей, приведение типов, стандартизация форматов дат и сумм, устранение дубликатов, коррекция кодировок. В рамках степ-бай-степ пайплайна применяются проверки и тесты на качество данных.
-
Обогащение и трансформации. Включает экономически значимые обогащения: присоединение к дополнительным справочникам, расчеты, расчеты агрегатов, создание признаков для аналитики и ML. Catalyst-оптимизация применима и здесь, что обеспечивает эффективная планирование запросов.
-
Загрузка и хранение. Данные пишутся в хранилища, например Parquet/Delta Lake. Delta Lake предоставляет ACID-транзакции на уровне файловой системы, что особенно полезно для консолидированной аналитики и устойчивых конвейеров. В качестве альтернативы - чистая запись Parquet/ORC с версионированием файлов.
-
Мониторинг качества данных и тестирование. Интеграция с инструментами контроля качества (Deequ, Great Expectations) позволяет задавать правила по валидности, согласованию типов и полноте. Автоматизированные тесты на этапе CI/CD уменьшают риск ошибок.
## Пример конвейера на PySpark: чтение Parquet, фильтрация, обогащение и запись в Delta Lake from pyspark.sql import SparkSession from pyspark.sql.functions import col, year, month spark = SparkSession.builder.appName("ETL-Pipeline").getOrCreate() raw = spark.read.format("parquet").load("s3a://data/raw/transactions/") clean = raw.filter(col("amount") > 0) enriched = clean \ .withColumn("year", year(col("date"))) \ .withColumn("month", month(col("date"))) ## Запись в Delta Lake enriched.write.format("delta").mode("overwrite") \ .save("s3a://lake/transactions/delta/") -
Управление потоками. При работе с Structured Streaming ключевым является обеспечение непрерывности конвейера: checkpointing, management of state, handling late data и выбор подходящего windowing для агрегатов. В некоторых случаях целесообразна гибридная архитектура: батчевые расчеты для больших исторических периодов и стриминг для реального времени.
-
Мониторинг и операционная устойчивость. Важные элементы - встроенный Spark UI и History Server для анализа задач, журнала ошибок и задержек. Для поддержки операционной устойчивости применяются подходы к повторяемости пайплайнов, контроль версий схемы, логирование операций и алерты в случае некорректной обработки.
Пример расширенного сценария: обработка потока кликов с Kafka в Delta Lake и последующая загрузка в BI-слой. Такой пайплайн обеспечивает минимизацию задержек и сохранение целостности данных за счет ACID-публикации в Delta Lake. В реальных системах добавляются этапы обогащения через внешние справочники и последующая агрегация для оперативной аналитики.
Аналитика больших данных и бизнес-метрики: KPI, окна и cohort-аналитика
Помимо подготовки данных, Spark активно применяется для бизнес-аналитики и аналитических расчетов. Основные направления включают построение KPI-метрик, анализ по времени, cohort-аналитику и подготовку признаков для моделей машинного обучения.
-
Агрегации и KPI. Простейшие показатели (выручка, количество транзакций, средний чек) получают в Spark через groupBy и агрегатные функции. Масштабируемость достигается за счет параллельной обработки и правильной разметки партиционирования. В реальных сценариях полезно предварительно агрегировать данные на уровне дня/регионa и затем добавлять более глубокие измерения.
-
Оконные функции и временные паттерны. Для анализа поведения пользователей и временных трендов применяются оконные функции, скользящие метрики и временные окны. Пример: расчет rolling-7d продаж по каждому продукту. Это позволяет видеть динамику и выявлять сезонные эффекты.
from pyspark.sql import SparkSession, functions as F, Window spark = SparkSession.builder.getOrCreate() df = spark.read.parquet("s3a://lake/transactions/delta/") ## дневная продажа по продукту daily = df.groupBy("date", "product_id").agg(F.sum("amount").alias("total_sales")) ## 7-дневное скользящее среднее w = Window.partitionBy("product_id").orderBy("date").rowsBetween(-6, 0) rolling = daily.withColumn("rolling_7d", F.sum("total_sales").over(w)) rolling.show(10) -
Cohort-анализ и поведенческие метрики. Cohort-анализ позволяет оценивать удержание и долгосрочные тренды по группам пользователей. В Spark это достигается через разметку пользователей по дате регистрации и последующим агрегациям по когортам. Такой подход хорошо сочетается с явной версией данных и возможностью повторной переработки в рамках lakehouse.
-
Подготовка признаков для ML. В аналитической среде имя Spark не ограничивается только BI: на этапе подготовки признаков для моделей ML можно использовать Spark MLlib для offline-тренировок и последующей интеграции в потоковую среду через примеры стриминга и онлайн-инференса. Это позволяет строить пайплайны, где данные проходят подготовку, валидацию и подаются на модель в пределах одной экосистемы.
-
Мониторинг и качество аналитики. Важно сочетать метрики качества данных и надежность аналитических расчётов. В качестве практики рекомендуется хранить промежуточные агрегаты и метрики в отдельном слое, поддерживаемом версионированием и совместимой схемой, чтобы BI-слой имел стабильные источники.
Эксплуатация и качества данных: мониторинг, интеграции и управление версиями
На практике для больших пайплайнов необходима комплексная инфраструктура мониторинга, качества данных и управления версиями. Основные направления включают:
-
Мониторинг и observability. Spark UI предоставляет детальную картину исполнения заданий: стадии, задачи, время выполнения, shuffle-объемы. History Server обеспечивает доступ к старым запускам. Для продакшена применяются внешние системы мониторинга и алертов, связывающие метрики выполнения с бизнес-метриками.
-
Качество данных. Инструменты типа Deequ позволяют автоматизировать валидацию данных: проверку полноты, диапазоны значений, согласование типов, уникальность ключей. Встраивание таких проверок в пайплайн упрощает раннее обнаружение ошибок и снижает риск испортить «чистый» набор данных.
-
Управление версиями схемы и данных. Применение Lakehouse-архитектуры с поддержкой ACID (Delta Lake) обеспечивает версионирование файлов и согласованность между батчевыми и потоковыми пайплайнами. Это особенно важно при эволюции схемы или добавлении новых столбцов.
-
Интеграции и оркестрация. В реальных проектах Spark интегрируется с системами оркестрации (Airflow, Kubeflow) и каталогами метаданных. Каталоги помогают документировать наборы данных, их источники, зависимости и версии. Пример 1-2 решений: Amundsen (open-source) или Apache Atlas (для корпоративной среды) - для управления метаданными и lineage. В связке с Delta Lake это поддерживает управляемость изменений и прозрачность процессов.
-
Контроль версий и развёртывания подменяют «медиа-связки» между кодом пайплайна и данными. Практика CI/CD для данных подразумевает хранение пайплайнов и конфигураций в системе контроля версий, автоматические тесты на тестовых данных и возможность воспроизводимого разворачивания.
Реальные кейсы и архитектурные решения
Рассмотрим два типичных кейса, иллюстрирующих применимость Spark на практике.
-
Кейс 1: онлайн-ритейлер. Задача** - собрать поток кликов и транзакций, их очистка и агрегация, формирование единых facts для BI и ML. Архитектура: ingestion через Kafka и файловые источники, батч-пайплайн на Spark DataFrame для очистки и нормализации, обогащение с помощью справочников (категории, бренды), запись в Delta Lake для консолидации и поддержки ACID, публикация агрегатов в BI-слой. Для реального времени применяется Structured Streaming для определённых оконных метрик и сигналов для рекомендации в реальном времени. Результаты пайплайна доступны через BI-инструменты или дашборды. Важные аспекты: идемпотентность записей, управление схемой, мониторинг и способность откатывать изменения на уровне файлов.
-
Кейс 2: банковская аналитика и мониторинг безопасности. Необходима потоковая обработка транзакций и извлечение событий для обнаружения мошенничества. Архитектура включает Kafka как источник событий, Spark Structured Streaming для обработки потоков, фоновую обработку и обучение на оффлайн-данных. В рамках проекта применяется MLlib для обучения моделей на исторических данных и последующая онлайн-инференс в потоке. Хранение результатов осуществляется в Delta Lake с версионностью и ACID-транзакциями, что обеспечивает целостность данных в BI и отчетности. Ключевым моментом является баланс между точностью моделирования и задержками обработки, выбор стратегии окон и настройка памяти.
-
Интеграции и операционная практика. В обоих кейсах применяются инструменты мониторинга, а также интеграции с каталогами и CI/CD. При необходимости внедряются решения по управлению качеством данных, чтобы обеспечить соответствие нормативным требованиям и бизнес-правилам.
Key takeaways
- Архитектура Spark с драйвером и исполнителями, а также роль Cluster Manager в масштабируемой обработке больших данных.
- Эффективная организация ETL-пайплайнов на базе DataFrame и Spark SQL: от источников к lakehouse с использованием Delta Lake.
- Важность выбора форматов хранения и применения оптимизаций Catalyst и Tungsten для производительности.
- Построение аналитических пайплайнов: агрегации, оконные функции и cohort-аналитика для бизнес-метрик и KPI.
- Практики обеспечения качества данных: тесты, валидации и автоматизация через Deequ и аналогичные инструменты.
- Значение мониторинга и операционных практик: Spark UI, History Server, метрики и алерты.
- Роль интеграций: каталоги метаданных, оркестрация и CI/CD для данных, устойчивые к изменениям схемы пайплайны.
FAQ
- Чем DataFrame отличается от RDD и зачем использовать DataFrame в Spark?
- DataFrame и Dataset предоставляют высокоуровневые абстракции поверх RDD, позволяют применять Catalyst-оптимизации и Tungsten-вычисления, что улучшает производительность и упрощает разработку. RDD полезны для низкоуровневых операций или когда нужна полная гибкость управления партициями и функциональностью.
- Какие форматы хранения оптимальны для аналитических пайплайнов и почему?
- Parquet и ORC являются колонными форматами с эффективной компрессией и поддержкой schema evolution. Delta Lake добавляет ACID-поддержку и версионирование файлов, что особенно полезно в lakehouse-подходах и для устойчивых пайплайнов.
- Как минимизировать переработку shuffle и улучшить производительность?
- Правильная партиционирование входных данных, настройка spark.sql.shuffle.partitions, использование broadcast join там, где размер небольшого дата-сета сопоставим с количеством Executors, и избегание лишних преобразований. Мониторинг сцепления задач поможет выявить узкие места и оптимизировать план выполнения.
- Как выбрать между батчевой и потоковой обработкой?
- Батчевые пайплайны хороши для больших исторических наборов с требованием высокой точности и согласованности. Потоковые пайплайны пригодны для реального времени и микро-аналитики. В реальных системах часто применяется гибридный подход: батчевые расчеты для долговременных агрегатов и потоковая обработка для критических бизнес-метрик.
- Как обеспечить идемпотентность записей в BI-сегментах?
- Использование транзакционных хранилищ (Delta Lake), уникальных ключей, применении ключевых ограничений на стороне источника или в преобразованиях, а также ведение журнала изменений для повторной публикации без дублирования.
- Как обеспечить качество данных на этапе ETL?
- Введение автоматических тестов и проверок через Deequ или аналогичные инструменты, контролируемые в CI/CD, а также хранение результатов валидности и метрик в доступном каталоге данных.
- Как выбрать кластерный менеджер и как это влияет на пайплайны?
- YARN хорошо интегрируется в существующие экосистемы Hadoop, Kubernetes обеспечивает гибкую оркестрацию и изоляцию, Standalone подходит для упрощённых кластерных сред. Выбор зависит от существующей инфраструктуры, требований к изоляции и масштабируемости.
- Какие подходы к мониторингу эффективны в продакшене?
- Мониторинг выполнения задач в Spark UI и History Server, интеграция с внешними системами мониторинга, сбор и анализ бизнес-метрик, настройка алертов и регулярные ретроспективы по корректности пайплайнов.
- Как организовать миграцию существующих ETL-процессов на Spark?
- Планомерный переход поэтапно: начинайте с критичных пайплайнов, применяйте lakehouse-архитектуру, внедряйте тестирование качества данных, используйте стандартные шаблоны конвейеров и CI/CD, документируйте зависимости и версионируйте схему. По мере роста уверенности переходите к более сложным сценариям и расширению команды.
- Какие риски стоит учитывать при внедрении Spark в бизнес-процессы?
- Неправильная настройка ресурсов может привести к задержкам и перерасходу кластера; недостаточное тестирование схем может вызвать расхождение данных; отсутствие мониторинга и контроля версий может усложнить исправления и аудит. Эффективные практики включают четко определённые конвейеры, качественный мониторинг, управление версиями и тестирование на тестовом окружении.


