

Практические кейсы и сценарии внедрения
В рамках данной главы рассматриваются concrete-пути использования Dagster для решения задач Data Engineer в больших организациях: как строить устойчивые данные пайплайны, как эффективно управлять вычислительными ресурсами и как интегрировать Dagster с аналитическими платформами и данными-хабами. Представлены практические сценарии от пилотных проектов до масштабирования, включая архитектурные решения, процессы внедрения и типовые риски, с которыми сталкивается команда на разных этапах.
Dagster предлагает набор паттернов, которые позволяют отделить логику обработки данных от инфраструктурной стороны, обеспечить повторяемость, мониторинг и прозрачность исполнения. В условиях корпоративной среды это означает не только выбор технических инструментов, но и выработку управленческих практик: архитектурную конвенцию, требования к безопасности, политики данных, процессы тестирования и миграции. В этой главе балансируется внимание к архитектурным решениям и практикам внедрения: от проектирования репозитория и схемы выполнения до реальных кейсов, которые демонстрируют, как именно применяются эти принципы на практике.
- Архитектура и паттерны Dagster в корпоративной среде
- Управление ресурсами вычислений и мониторинг
- Интеграции Dagster с аналитическими платформами и данными
- Практические кейсы: пилоты, масштабирование и управление изменениями
- Внедрение и миграционные маршруты
Архитектура и паттерны Dagster в корпоративной среде
Корпоративная архитектура данных требует четкого разграничения сфер ответственности, повторяемых пайплайнов и управляемого цикла изменений. Dagster позволяет реализовать это через четко структурированный репозиторий, паттерны повторно используемых компонент и продуманную стратегию мониторинга. Основные концепции, которые критично применяются в крупных организациях, следующие.
- Репозиторий как единая точка управления пайплайнами. В корпоративных условиях репозиторий (или набор репозиториев) служит фактом организации кода пайплайнов, их версионирования и окружений. Архитектура должна обеспечивать раздельную разработку и стабильную эксплуатацию, минимизируя пересечения между командами. В идеале репозиторий структурируется по доменам данных и бизнес-областям, с четкими границами между пайплайнами, которые принадлежат различным бизнес-единицам.
- Операции, графы и ресурсы как строительные блоки. Dagster строится вокруг операций (ops) и графов (graphs). В корпоративной среде целесообразно создавать повторно используемые наборы ops и графов для типовых задач: извлечение, очистку, обогащение, валидацию и загрузку данных. Ресурсы обеспечивают доступ к внешним сервисам, вычислительным кластерам и конфигурационным секретам. Важно выстроить конвенцию именования, чтобы понятие ресурса соответствовало конкретному внешнему компоненту (например, ресурс "warehouse_api" или "spark_cluster").
- Модели выполнения и запусков. Для контроля исполнения пайплайнов применяются паттерны “RunLauncher” и разные драйверы выполнения (KubernetesRunLauncher, CeleryRunLauncher, локальные запускеры). В крупных проектах рекомендуется внедрить KubernetesRunLauncher для динамического масштабирования и структурированного квотирования ресурсов. Такой подход позволяет отделить инфраструктуру выполнения от логики пайплайна и обеспечивает изоляцию задач.
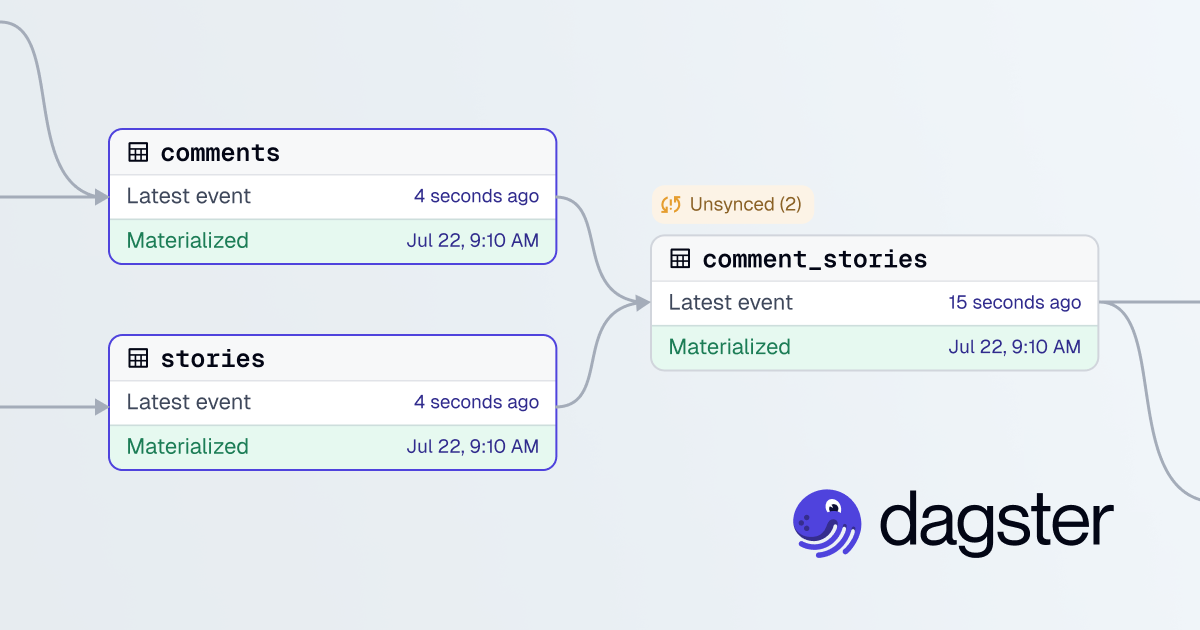
- Управление версиями данных: assets и lineage. Вложенная модель Dagster Asset Catalog позволяет отслеживать зависимости между активами данных, версионировать их и видеть lineage. Это критично для аудита, качества данных и регламентированного интегрирования с BI-платформами. В корпоративной среде активы часто разрезаются по доменам данных, и управление их жизненным циклом становится частью политики качества данных.
- Безопасность и соответствие. Архитектура должна поддерживать сегментацию доступа, секреты через системные хранилища и политики аудита. В Dagster это достигается за счет конфигурации ресурсов, интеграции с менеджерами секретов и внешними хранилищами параметров выполнения. Корпоративные требования по соответствию законно-правовым нормам и внутренним регламентам закладываются на уровне репозитория и пайплайнов.
Возможная схема архитектуры на уровне кода (псевдокод) демонстрирует, как связаны элементы:
-
репозиторий → графы и ops → ресурсы → запуск пайплайна
-
assets catalog → lineage → мониторинг
-
RunLauncher → инфраструктура выполнения (Kubernetes, контейнеризация) → метрики и алерты
// Простой пример структуры Dagster-пайплайна с ресурсами и графом
from dagster import resource, op, graph

@resource(config_schema={"endpoint": str})
def api_client(init_context):
    endpoint = init_context.resource_config["endpoint"]
    return create_client(endpoint)

@op(required_resource_keys={"api"})
def fetch(context):
    return context.resources.api.get_data()

@graph
def my_pipeline():
    fetch()

## Конфигурация и запуск будет определяться в окружении
Архитектурный подход к крупных пайплайнам требует дисциплины в проектировании, чтобы обеспечить повторяемость и минимизацию wijzigen между командами. В частности, рекомендуется:
-
отделять конфигурацию окружения от кода пайплайна;
-
строить повторно используемые опы и графы;
-
внедрять полный цикл тестирования пайплайнов: юнит-тесты ops, интеграционные тесты graph, регрессионные тесты с использованием тестовых данных;
-
поддерживать четкую карту зависимостей между данными и бизнес-процессами.
Управление ресурсами вычислений и мониторинг
Эффективное управление вычислительными ресурсами становится критическим в условиях ограниченных мощностей и большого объема данных. Dagster предоставляет модели и интеграции, которые позволяют планировать вычисления, управлять потреблением ресурсов и отслеживать эффективность выполнения пайплайнов.
- Планирование ресурсов. Ресурсы Dagster позволяют определить подключение к внешним системам, базам данным, API и вычислительным кластером. В корпоративной среде целесообразно задавать ресурсные ограничения и политики повторного использования, чтобы предотвратить перегрузку среды. Примеры включают ресурсы доступа к Snowflake, API-клиенты к решению для обработки данных и клиенты вычислительных кластеров.
- Распределенное выполнение и мульти-активы. Для масштабирования пайплайнов применяются различные подходы: запуск на Kubernetes через KubernetesRunLauncher, параллелизм задач и доли выполнения, обеспечение изоляции между задачами. В многопользовательской среде следует предусмотреть quotas и уровень вендорной поддержки для ресурсоемких задач.
- Мониторинг и наблюдаемость. Dagit предоставляет визуализацию выполнения, логи и метрики. В крупных инфраструктурах рекомендуется дополнительно интегрировать Prometheus и Grafana для сбора метрик выполнения, времени задержки, частоты ошибок, объема обработанных данных. Нормальная сборка метрик включает: время выполнения, загрузку CPU/память, потребление диска, количество обрабатываемых строк/объемов данных.
- Управление качеством и ретраями. В паттернах корпоративной эксплуатации важно реализовать устойчивые политики ретраев и backfill-режимов. Backfill позволяет безопасно переработать исторические данные без остановки текущего потока. В Dagster это поддерживается через нотификации о состоянии выполнения, управление планами выполнения и настройку поведения ретраев.
- Безопасность и секреты. В большой среде секреты и параметры доступа должны быть централизованно управляемыми. Для этого применяется интеграция с системами секретов (например, Vault, AWS Secrets Manager) и централизированное хранение конфигураций ресурсов. Это критично для соответствия требованиям к защите данных.
Практический подход к реализации мониторинга состоит в формировании набора KPI, например:
-
доля успешных запусков по пайплайнам;
-
среднее время выполнения для отдельных graph/ops;
-
задержки между стадиями (ETL, загрузка, валидация);
-
объем обработанных данных за единицу времени;
-
уровень использования ресурсов в пиковые периоды.
// Пример конфигурации ресурса KubernetesRunLauncher
## Это иллюстративный фрагмент; конкретная конфигурация зависит от версии Dagster и окружения
dagster:
  run_launcher:
    module: dagster_k8s.launcher
    class: KubernetesRunLauncher
    config:
      kubeconfig: ~/.kube/config
      job_template: |
        apiVersion: batch/v1
        kind: Job
        ...
Набор типовых практик по управлению ресурсами в корпоративном контексте:
-
деление пайплайнов на логически независимые подсистемы с ограничением на ресурсы;
-
применение квот на ресурсы для отдельных команд и доменов;
-
настройка уровней приоритета исполнений;
-
внедрение тестирования производительности в рамках CI/CD;
-
использование “asset lineage” и “dataset provenance” для контроля качества данных.
Интеграции Dagster с аналитическими платформами и данными
Универсальная интеграция Dagster с аналитическими платформами и системами данных обеспечивает прозрачную и управляемую цепочку создания ценности: от источников данных до бизнес-аналитики. В корпоративной среде это требует тесной связи между пайплайнами Dagster, складами данных и BI-инструментами, а также грамотной организации каталога активов и данных.
- Интеграция с источниками и целями данных. Dagster поддерживает коннекторы к популярным системам хранения и обработки: Snowflake, BigQuery, Redshift, Databricks, локальные базы данных. В рамках архитектуры следует определить стандартизированные схемы подключения и политики доступа, чтобы пайплайны могли свободно перемещаться между окружениями (dev, staging, prod) без потери безопасной конфигурации.
- Каталог активов и lineage. Активы представляют собой результаты вычислений и их зависимости. В корпоративной среде это позволяет отслеживать происхождение данных, обеспечивать аудит данных и поддерживать аудит, что особенно важно в регуляторно насыщенных условиях. В Dagster assets позволяют управлять жизненным циклом данных и обеспечивать связь между пайплайнами и BI-слоем.
- Интеграция с аналитическими платформами. Встраивание Dagster в BI-уровень обычно включает экспорт готовых наборов данных в BI-слой или предоставление конечных данных через API. В некоторых случаях возможно прямое подключение датасетов к BI-платформам через стабильный интерфейс загрузки данных или через репликацию в аналитическое хранилище.
- Контекстная наблюдаемость и качество данных. Набор метрик и сигналы Dagster можно связать с мониторингом качества данных (например, проверки валидности, полноты и консистентности). В крупных проектах это обеспечивает автоматическую проверку после каждого воркфлоу и поддерживает регламентированные SLA по качеству данных.
- Контроль версий и релизы. Совместимость пайплайнов и выпуск обновлений требует стратегии миграций - от тестирования на staging до безопасного продакшн-апгрейда. Dagster позволяет внедрить governance-процессы через контроль версий и миграцию схем активов.
Практическая рекомендация: прежде всего структурируйте ваш каталог активов по доменным владениям и создайте конвенции по именованию источников данных и целевых таблиц. Это облегчает поиск, совместную работу и интеграцию с аналитикой. Включите в инфраструктуру слои валидации и ретроверификации данных перед попаданием в BI-слой, чтобы снизить риск ошибок в дашбордах и бизнес-решениях.
// Пример простого описания ресурса и операции для интеграции с внешним API
from dagster import resource, op, graph

class ApiClient:
    def __init__(self, endpoint):
        self.endpoint = endpoint
    def fetch(self, path):
        ## псевдо-реализация
        return {"path": path, "data": []}

@resource(config_schema={"endpoint": str})
def api_client(init_context):
    return ApiClient(init_context.resource_config["endpoint"])

@op(required_resource_keys={"api"})
def pull_metadata(context):
    client = context.resources.api
    return client.fetch("/metadata")

@graph
def analytics_ingestion():
    pull_metadata()
Интеграция с инструментами анализа требует выработки схем данных, стандартов форматов и согласованных ожиданий по времени обновления. В качестве практических ориентиров можно применить:
- оформление и публикация контрактов данных между пайплайнами;
- использование дат и временных меток как части схемы данных;
- настройку оповещений в случаях отклонений от SLA обновления данных;
- создание автоматизированной документации о lineage и зависимостях.
Практические кейсы: пилоты, масштабирование и управление изменениями
Разбирая практические сценарии, следует рассмотреть ряд кейсов, которые отражают переход от пилотного проекта к масштабируемой системе. Ниже приведены три типовых кейса, которые часто встречаются в корпоративной среде.
Кейс
- Пилот по качеству данных и ELT-инициатива
- Проблема. Необходимо повысить качество данных в источнике и устранить болезненные артефакты на конечном этапе загрузки в хранилище.
- Подход Dagster. Реализация цепочки пайплайнов с четким разделением на этапы: извлечение, преобразование, валидация и загрузка. Введение проверок качества на каждом этапе, использование ассетов и lineage для полного контроля.
- Результаты. Повышение надежности загрузки, сокращение задержек на исправления ошибок, улучшение прозрачности для бизнес-подразделений.
Кейс
2. Интеграция с BI и аналитическим стеком
- Проблема. Необходимо обеспечить своевременную доставку обновленных наборов данных в BI-платформы и обеспечить прозрачность происхождения данных.
- Подход Dagster. Внедрение активов и графов, которые публикуют данные в аналитическое хранилище, и настройка оповещений на критические метрики. Организация контрактов между командами данных и аналитиками.
- Результаты. Повышение скорости обновления дашбордов, улучшение доверия к данным и ускорение цикла принятия решений.
Кейс
3. Масштабирование ETL для нескольких доменов
- Проблема. Не хватает единых правил для распределения ресурсов между доменами и необходимости параллельной обработки больших объемов.
- Подход Dagster. Введение нескольких изолированных веток пайплайнов, сегментация репозитория по доменам, внедрение мульти-аренды и использование KubernetesRunLauncher для масштабирования.
- Результаты. Эффективное распределение ресурсов, снижение узких мест, улучшенная устойчивость к перегрузкам и возможность независимого выпуска обновлений.
Ключевые практики из кейсов:
- проектируйте пайплайны с учетом повторного использования компонентов;
- применяйте активы и lineage для управления данными и аудита;
- внедряйте строгие контракты данных и регламенты качества;
- используйте адаптивное масштабирование и квоты на ресурсы;
- обеспечьте прозрачность через мониторинг и алерты.
Кейс-ориентированный подход помогает выработать конкретные правила и механизмы внедрения, которые можно адаптировать под разные домены и требования бизнеса. Важно поддерживать баланс между архитектурной чистотой и практической осуществимостью, чтобы пайплайны оставались устойчивыми к изменениям в требованиях и технологическом стеке.
Внедрение и миграционные маршруты
Внедрение Dagster в корпоративную среду требует поэтапной стратегии, строгого управления изменениями и подготовки команды. Ниже приведены основные принципы и решения, которые способствуют успешной трансформации.
- Этапы внедрения. Рефакторинг поэтапно: начните с пилотного проекта, который закрывает конкретную бизнес-цель, затем постепенно расширяйте объекты в репозитории, добавляйте новые пайплайны и активы, внедряйте мониторинг и тестирование, и только затем начинайте масштабирование.
- Управление изменениями. Внедряйте Governance-процессы: версионирование пайплайнов и активов, регламенты тестирования, документирование зависимостей и цепочек данных. Включение бизнес-стейкхолдеров в процессы принятия решений по миграции и новым функционалам.
- Тестирование и качество. Разработайте набор тестов для ops и graph, используйте staging-окружение для регрессионного тестирования, внедрите тесты на производительность и стресс-тесты. В корпоративной среде тестирование становится встроенной частью CI/CD-пайплайна.
- Миграция между средами. Внедрите стратегию миграции: параллельное существование старых и новых пайплайнов, безопасные режимы переключения (canary или blue-green), мониторинг и rollback-планы на случай неожиданных проблем.
- Обучение и организация изменений. Проводите обучающие сессии по новым паттернам, документируйте лучшие практики, создавайте center of excellence по Dagster, формируйте роли и ответственности в командах данных.
Инфраструктурные решения и инструменты поддержки внедрения:
- выбор RunLauncher (Kubernetes для масштабируемости, локальные запускеры для разработки);
- централизованный хранитель конфигураций и секретов;
- единый мониторинг и алертинг по пайплайнам;
- управление зависимостями между доменами данных и бизнес-юнитами.
Key takeaways
- Dagster служит основой для управляемых, повторяемых и наблюдаемых data pipelines в корпоративной среде благодаря архитектурным паттернам, таким как репозиторий, графы, ops и ресурсы.
- Эффективное управление ресурсами требует сочетания планирования, квотирования и мониторинга через RunLauncher и интеграцию с системами наблюдения и секретами.
- Интеграции Dagster с аналитическими платформами и данными достигаются через активы, lineage, стандартизацию контрактов данных и устойчивые конвенции по миграциям.
- Практические кейсы показывают движение от пилотных проектов к масштабированию, с фокусом на качество данных, интеграцию BI и мульти-доменную инфраструктуру.
- Внедрение требует планирования изменений, Governance-процессов, тестирования и обучения команд, чтобы обеспечить устойчивость и соответствие регуляторным требованиям.
- Архитектура должна поддерживать безопасную конфигурацию, многопользовательский доступ и строгий контроль изменений, что снижает риски и ускоряет принятие решений.
- Миграция и разворачивание должны строиться на поэтапной стратегии, с регламентированными этапами тестирования, мониторинга и rollback-плана.
FAQ
Что такое Dagster и чем он отличается от других оркестраторов?
Dagster представляет собой фреймворк для разработки, тестирования и эксплуатации data pipelines с акцентом на архитектуру операций (ops), графов (graphs) и ресурсов. В отличие от более монолитных систем он подчеркивает повторное использование компонентов, строгую типизацию зависимостей и тесную интеграцию с каталогом активов и линейк данных, что упрощает аудит и качество данных в корпоративной среде. Dagster поддерживает гибкие стратегии развертывания и интеграцию с указанными платформами, что позволяет адаптировать пайплайны под разные бизнес-требования.
Какие архитектурные паттерны полезно использовать на старте внедрения Dagster?
Рекомендуется начинать с четкой структуры репозитория по доменам данных, создания повторно используемых ops и graphs, ввода ресурсов для внешних сервисов и использования RunLauncher для инфраструктурной гибкости. Важно внедрить assets и lineage для трассируемости данных и заложить базовую мониторинговую схему. Это обеспечивает устойчивость к изменениям и упрощает масштабирование.
Как организовать управление ресурсами в Dagster на крупных кластерах?
В крупных кластерах применяется KubernetesRunLauncher для горизонтального масштабирования и квотирования. Ресурсы дают доступ к внешним системам и сервисам, а мониторинг выполняется через Dagit, Prometheus и Grafana. Необходимо определить политики ограничения, приоритетов и ретраев, а также внедрить безопасные конфигурации секретов и доступов.
Какие модели тестирования пайплайнов эффективны в корпоративной среде?
Эффективна смесь юнит-тестов ops, интеграционных тестов графов и регрессионного тестирования с использованием тестовых данных. Важно проверять контракт данных, корректность lineage и устойчивость к изменениям в окружении. CI/CD-пайплайн должен включать тестовые прогоны на staging и механизмы отката.
Какстроить миграцию пайплайнов из другого оркестратора (например, Airflow) в Dagster?
Начните с параллельной эксплуатации: дублируйте функционал в Dagster и ведите параллельный режим, чтобы сравнить результаты. Постепенно переносите логику графов, ops и ресурсы, сохраняйте совместимость входных и выходных данных. Внедрите агентство по документации и контрактам данных, чтобы минимизировать риск расхождений между системами.
Какие паттерны позволяют обеспечить качество данных в Dagster?
Включите проверки качества на каждом этапе, используйте ассеты и lineage для прозрачности происхождения данных, добавляйте метрики и сигналы в мониторинг, внедрите backfill-процедуры и ретраи для устойчивости к задержкам или сбоев в источниках данных.
Какие подходы эффективны для междоменного внедрения Dagster?
Разделите репозиторий по доменам, применяйте изоляцию пайплайнов, применяйте единые конвенции именования ресурсов и активов, внедрите governance-правила и междоменные соглашения по данным. Это позволяет сохранить автономию команд и одновременно обеспечить единое управление качеством данных.
Как минимизировать риски при масштабировании Dagster в организации?
Используйте ступенчатое масштабирование, внедряйте мониторинг и алерты, делайте rollback-планы и тестируйте миграции на staging, организуйте обучение сотрудников и создайте центр компетенций по Dagster. Важно держать баланс между архитектурной чистотой и оперативной реализацией изменений.
Каковы рекомендации по выбору инфраструктуры для Dagster в промышленной среде?
Для динамического масштабирования и устойчивости рекомендуется Kubernetes в связке с KubernetesRunLauncher, поддерживающей параллелизм и изоляцию исполнения. В качестве альтернативы можно рассмотреть локальные режимы разработки и ограниченное использование run-launcher для узко сегментированных пайплайнов. В любом случае следует обеспечить мониторинг, управление секретами и согласованную политику версий пайплайнов и активов.
Какие существуют варианты коммерческих и открытых решений Dagster?
Dagster имеет открытое ядро и коммерческие варианты, такие как Dagster Cloud и Dagster Enterprise, которые предлагают дополнительные функции для управления безопасностью, масштабируемостью и поддержкой. Важно внимательно оценивать соответствие требованиям безопасности, совместимости и затрат при выборе между открытым кодом и коммерческими возможностями.
Как начать внедрение Dagster в существующий стек данных?
Начните с пилотного проекта, который закрывает конкретную бизнес-цель, затем расширяйте репозиторий, внедряйте assets и мониторинг, и проводите обучение команд. Важно выстроить governance-процессы, определить роли и ответственности, а также подготовить план миграции с учетом требований к качеству данных и регуляторных норм.
Что считать успешным внедрением Dagster в рамках проекта?
Успех определяется не только функциональностью пайплайнов, но и степенью прозрачности работы, устойчивостью к сбоям, эффективностью использования ресурсов, качеством данных и скоростью цикла разработки. Важна интеграция с бизнес-процессами, способность команды быстро реагировать на изменения требований и наличие документированной инфраструктуры и практик управления данными.
Эта глава демонстрирует, как архитектура Dagster, принципы управления ресурсами и интеграции с аналитическими платформами объединяются в практические сценарии внедрения. Реальные кейсы подчеркивают, что успешная цифровая трансформация требует не только технического решения, но и управленческого подхода: ясных ролей, процессов, и устойчивой культуры качества данных.


